6.32毫米的精度革命:朗慧E6 SLAM测试报告揭示具身智能数据采集新标杆
6.32毫米的精度革命:朗慧E6 SLAM测试报告揭示具身智能数据采集新标杆
2026年,具身智能正站在一个历史性的十字路口。斯坦福大学发布的《AI Index 2026》报告揭示了一个令人震撼的数据:在仿真环境中表现优异的具身智能模型,其仿真成功率高达89.4%,然而一旦迁移到真实世界环境,成功率骤降至仅12%。这中间横亘着77个百分点的"迁移鸿沟"——一个足以让整个行业焦虑的数字。而造成这一鸿沟的根源,直指一个核心问题:高质量真实世界数据的严重匮乏。
据行业测算,要让具身智能真正实现通用化,需要至少1000万小时级别的多模态操作数据。然而截至今日,全球范围内可用的具身智能数据集总规模仅约50万小时,缺口高达20倍。这不仅是量的缺口,更是质的缺口。低精度、时间戳不同步、位姿漂移的数据,即便数量再大,也不过是"垃圾进、垃圾出"的原料。在这样一个数据为王的时代,SLAM(同步定位与建图)精度——作为衡量数据采集设备位姿追踪能力的核心指标——正成为决定具身智能训练数据质量的"第一性原理"。
正是在这样的行业背景下,朗慧科技最新发布的E6 EGO数采一体机的机内直出SLAM(VIO)精度测试报告,以6.32毫米的RMSE(均方根误差)数据,为行业树立了新的标杆。这一数字不仅代表了硬件能力的突破,更标志着"人类为AI提供高质量语料"这一理念在工程实践中的落地。
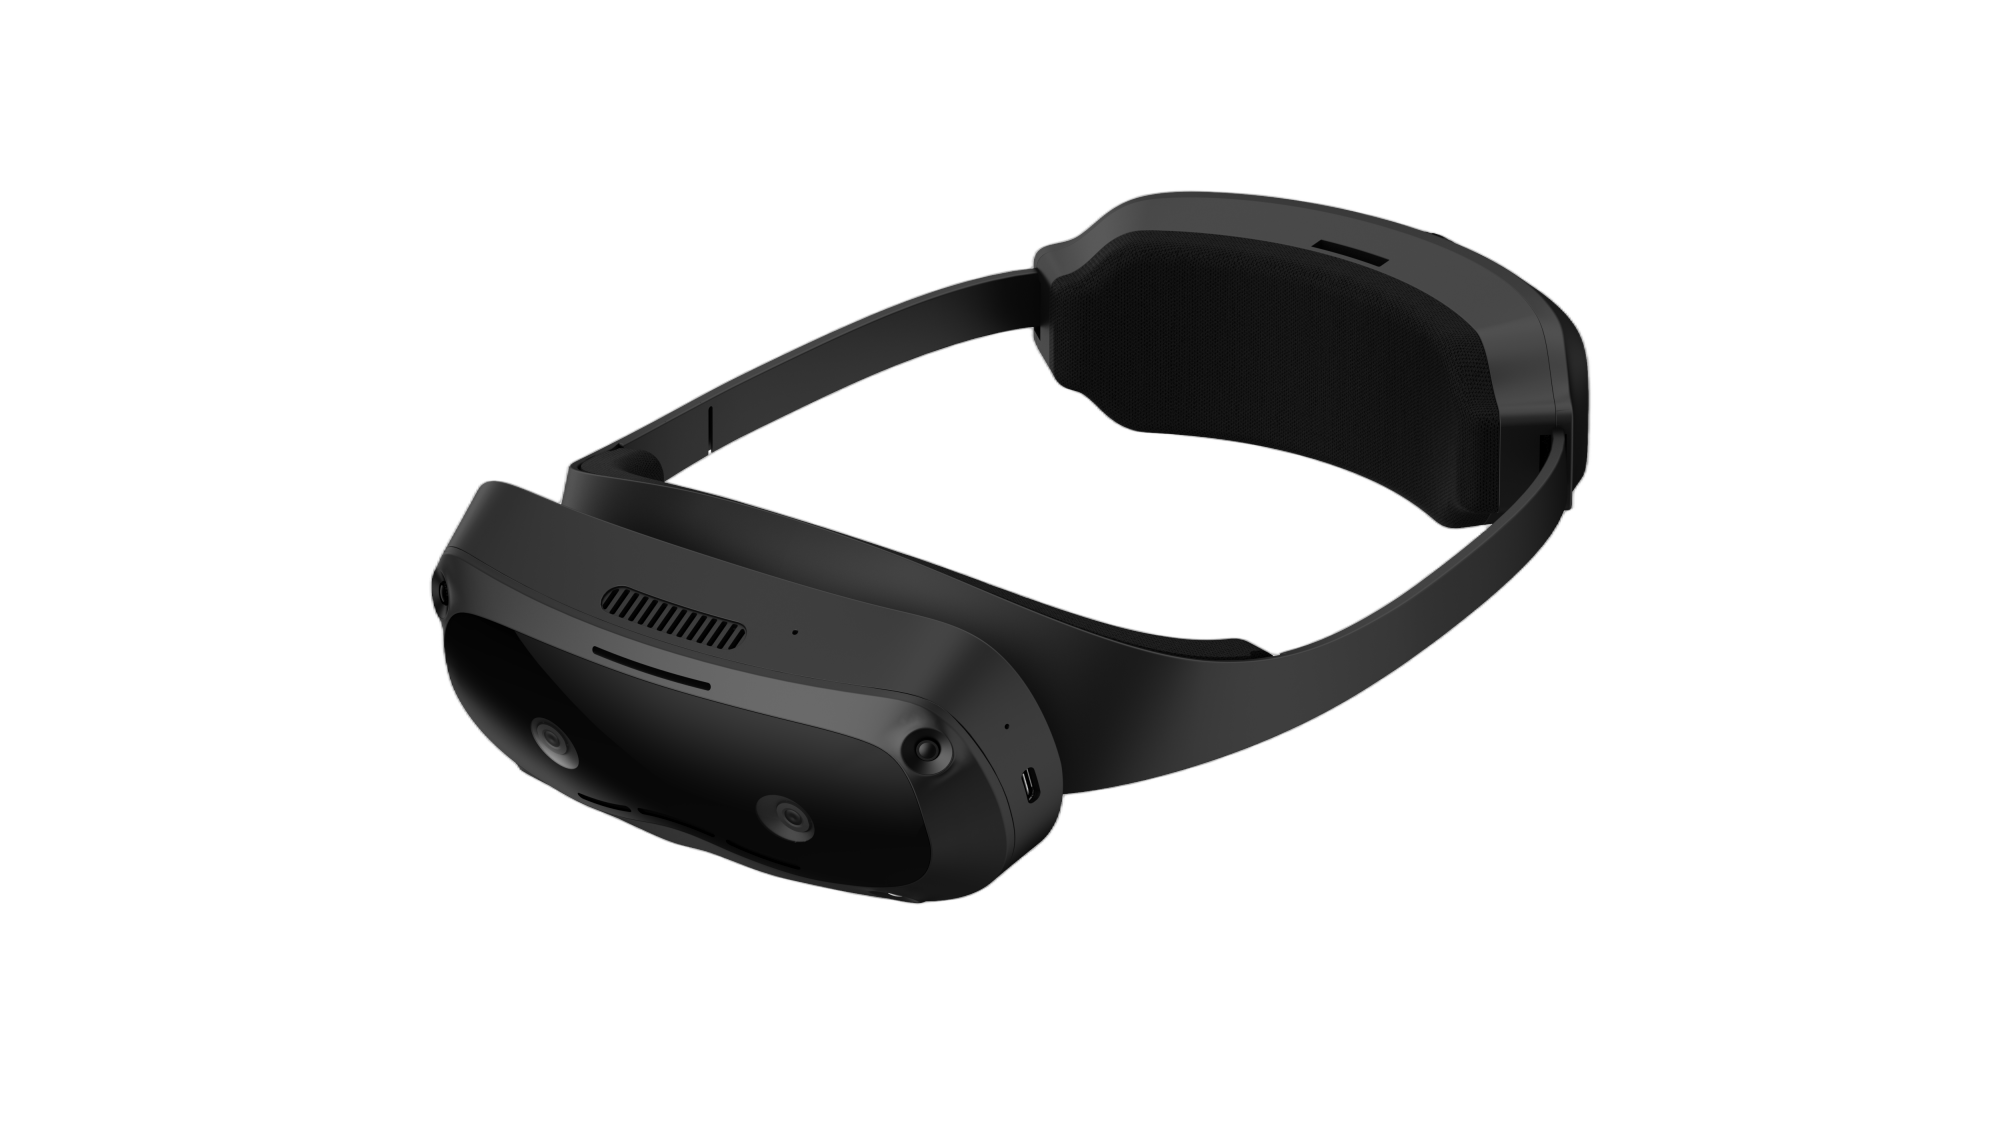
朗慧E6 EGO数采一体机——面向具身智能数据采集的高精度多模态感知设备
朗慧E6测试环境:OptiTrack动捕实验室的专业验证
要理解6.32毫米这一数字的分量,首先需要了解其背后的测试环境。朗慧E6的SLAM精度测试并非在普通实验室或办公环境中完成,而是在专业的动捕实验室内,使用美国OptiTrack红外光学被动式动捕系统作为真值参考。OptiTrack是全球公认的行业精度最高的六自由度(6DoF)位姿捕捉系统,其亚毫米级的追踪精度使其成为学术界和工业界验证SLAM算法的金标准工具。
动捕实验室的测试流程极为严谨。测试人员将E6设备搭载光学标记点后,在实验室空间内以不同速度、不同轨迹进行运动,OptiTrack系统以高帧率捕捉标记点的三维位置,从而重建出设备在每一时刻的真实六自由度位姿。与此同时,E6设备内部的VIO算法实时输出自身的位姿估计。两套系统的输出在统一的时间基准下进行对齐和比较,最终得到SLAM估计值与真实值之间的偏差统计量。
这种"以最高精度系统验证次高精度系统"的方法论,确保了测试结果的权威性和可重复性。更重要的是,整个测试过程中,E6设备以机内直出方式运行SLAM算法,即所有计算均在设备端实时完成,不依赖外部工作站或云端算力。这意味着6.32毫米的精度是在完全端侧部署条件下的真实表现,而非离线优化后的理论最优值——这一区别对于具身智能数据采集的实际应用场景至关重要。
6.32mm RMSE:数据解读与行业对标
测试报告的核心结论数据如下:RMSE(均方根误差)为6.32毫米,均值误差为5.80毫米,中位数误差为6.47毫米,第90百分位(P90)误差为9.14毫米,最大误差为11.17毫米。这组数据从多个维度刻画了E6 SLAM系统的精度特征。
首先,RMSE为6.32毫米意味着,在整个测试过程中,SLAM估计位姿与真实位姿之间的三维空间偏差的均方根仅为6.32毫米。作为一个直观的参照,一枚一元硬币的直径约为25毫米,6.32毫米大约是一枚硬币直径的四分之一。对于一款面向具身智能数据采集的便携式一体机而言,这样的精度意味着设备能够准确记录操作者在空间中的每一次移动、每一次旋转,为后续的模型训练提供高保真的位姿标注。
其次,均值(5.80毫米)略低于RMSE(6.32毫米),说明误差分布中存在少量较大的离群值,但整体集中度良好。中位数(6.47毫米)与均值接近,表明误差分布大致对称,没有严重的偏斜。P90为9.14毫米、最大值为11.17毫米,说明即使在最不利的情况下,误差也被控制在约1.1厘米以内。这种"低均值、窄尾部分布"的特征,正是高质量SLAM系统的典型标志。
此外,测试报告还提供了两组详细的轨迹级分析数据。组T1-11的测试条件为:580帧数据,持续19.3秒,轨迹长度4.48米,绝对轨迹误差(ATE)三维值为10.1毫米,ATE旋转误差为0.94度,1秒间隔的相对位姿误差(RPE@1s)为8毫米/1.33度。组C11的测试条件更为严苛:1225帧数据,持续40.8秒,轨迹长度19.77米,ATE三维值为19.3毫米,ATE旋转误差为1.25度,RPE@1s为28毫米/1.62度。两组数据呈现出清晰的规律——随着轨迹长度和持续时间的增加,误差有所累积,但累积速率极低。从4.48米到19.77米(轨迹长度增加约4.4倍),ATE仅从10.1毫米增至19.3毫米(增加约1.9倍),远低于线性增长比例,说明系统具备出色的长期一致性。
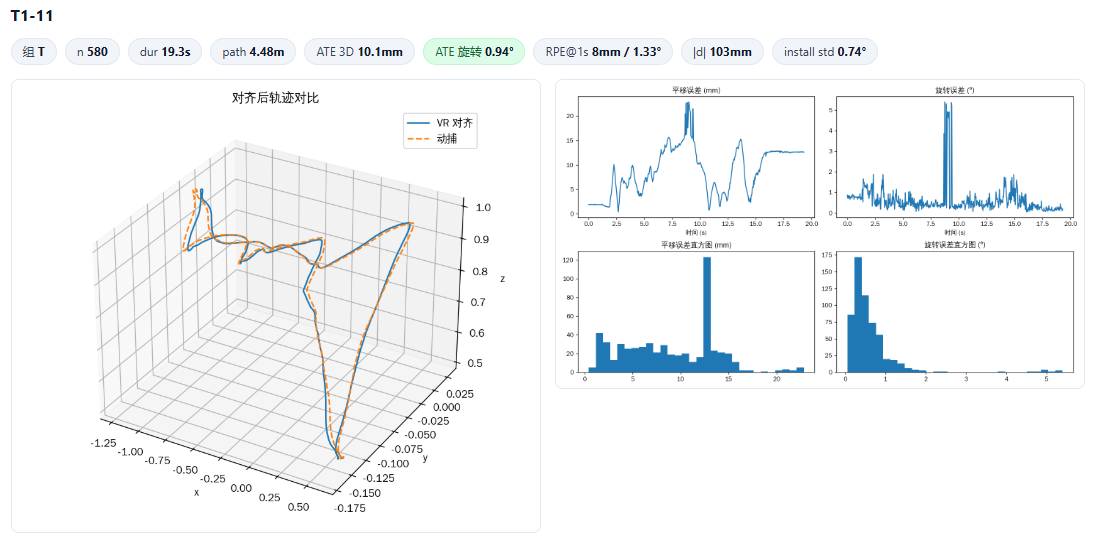
T1-11组:短轨迹(4.48m)SLAM估计与OptiTrack真值的轨迹对比及误差分布
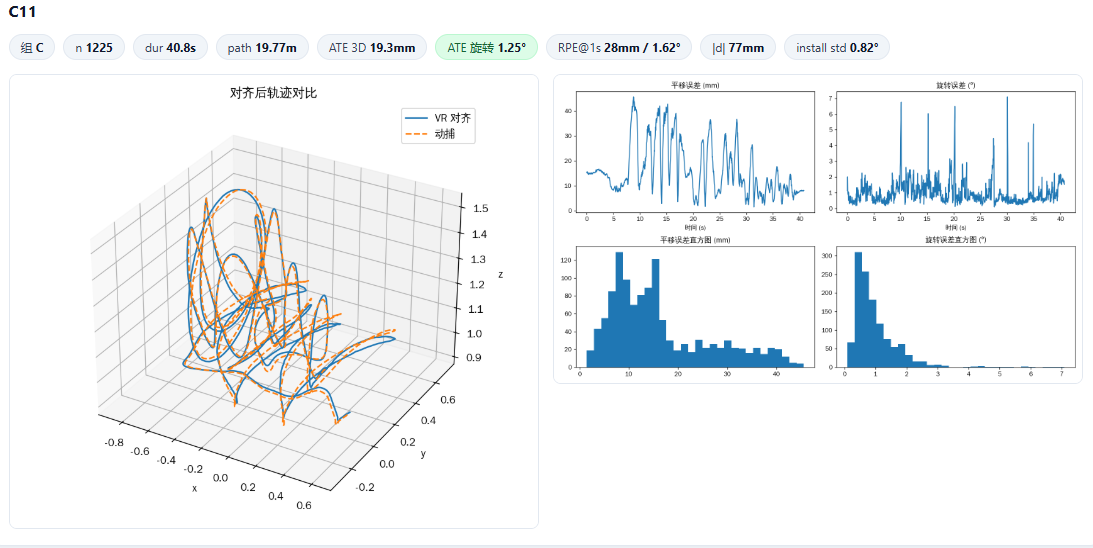
C11组:长轨迹(19.77m)SLAM估计与OptiTrack真值的轨迹对比及误差分布
更值得关注的是时间戳同步精度。测试报告确认,E6 EGO数采一体机机内各传感器的时间戳精度误差控制在1毫秒以内。当外部设备(如夹爪、触觉手套等)接入系统后,时间戳精度误差同样维持在1毫秒以内。对于多模态数据采集而言,时间戳同步是数据质量的"隐形基石"——视觉帧、IMU读数、力矩信号、关节角度如果存在毫秒级的时间偏差,在高速操作场景下就会导致严重的模态对齐错误,直接影响策略学习的训练效果。E6在内外部设备均实现1毫秒级时间同步,为多模态数据的精确对齐提供了硬件级保障。
Foundation-3D时代的SLAM前沿:MASt3R-Fusion、DB-VIO、cuVSLAM
将E6的6.32毫米精度置于2026年SLAM技术发展的宏观坐标系中审视,其意义更加深远。过去数年间,SLAM领域正经历一场从经典几何方法向数据驱动基础模型的范式转移。
在经典方法阵营,VINS-Fusion和ORB-SLAM3长期占据学术和工业应用的主导地位。然而,这两套系统自2021年以来已基本停止实质性更新。在快速变化的机器人与具身智能应用场景中,缺乏持续迭代的系统逐渐暴露出在低纹理环境、快速运动、动态场景下的局限性。经典方法依赖手工设计的特征提取和后端优化流程,其性能天花板已逐渐触及。
2025年9月,MASt3R-Fusion的发布标志着SLAM进入Foundation-3D时代。该方法将基于大规模数据训练的3D视觉基础模型与IMU进行紧耦合,在EuRoC和KITTI-360等标准数据集上,特别是在低纹理场景中,显著优于VINS-Fusion和ORB-SLAM3。MASt3R-Fusion的核心创新在于利用基础模型强大的跨场景泛化能力替代传统特征匹配,从而在传统方法失效的困难场景中仍能保持稳健的位姿估计。
DB-VIO(Dual-Branch Visual-Inertial Odometry,arXiv:2607.22123)则提出了双分支架构,将视觉惯性里程计分解为两个互补的估计分支,在KITTI数据集上提升20%,在EuRoC数据集上提升33%。这种架构设计的思路值得深思——通过分支解耦实现不同运动模式的专精处理,再在后端进行融合,有效缓解了单一分支难以兼顾不同运动特性的固有矛盾。
在工业部署层面,NVIDIA于2026年推出的cuVSLAM已成为VIO生产层的事实标准。cuVSLAM针对Jetson等边缘计算平台进行了深度优化,解决了长期困扰行业的"算法精度高但无法实时部署"的工程难题。朗慧E6选择机内直出SLAM策略,正是顺应了这一从研究到生产的部署趋势。
此外,ViDAR(arXiv:2506.13100)提出了一种集成VIEO(Visual-Inertial-Ego-Odometry)的新型设备,并结合深度强化学习(DRL)实现主动SLAM——即系统能够自主决策最优运动策略以降低不确定性。HDVIO2.0则将无人机飞行动力学模型融入VIO框架,通过混合动力学模型提升高速飞行场景下的状态估计精度。这些前沿探索共同推动着SLAM技术向更高精度、更强泛化、更广适应性方向演进。
在这一技术图景中,朗慧E6的6.32毫米RMSE不仅是当前端侧VIO精度的优秀成绩,更是在Foundation-3D方法尚未大规模产品化之前的工程最优解。它证明了经过精心设计的传统VIO流水线,在硬件协同优化和传感器融合策略的加持下,仍能达到接近动捕系统级别的位姿追踪精度。
从VIO到具身智能数据:SLAM精度如何决定训练数据质量
SLAM精度与具身智能训练数据质量之间的关联,远比表面看起来更为深刻。具身智能模型——无论是模仿学习还是强化学习——其训练过程本质上是从(视觉观测,本体感觉,动作)三元组序列中学习策略映射。其中,"本体感觉"和"动作"信息高度依赖于SLAM系统提供的位姿估计。
考虑一个典型的具身操作任务:机器人抓取桌上的物体。训练数据需要精确记录末端执行器在每一步的空间位置和姿态变化。如果SLAM位姿存在10毫米的误差,那么在策略学习时,模型将学习到"在位姿X处执行动作Y会导致位姿变化Z"的映射关系,但实际上位姿X本身就有10毫米的偏差。这种系统性误差会在训练过程中被模型内化,导致策略在部署时出现累积性的位置偏移——这正是仿真到真实迁移鸿沟的重要来源之一。
更关键的是,在模仿学习场景中,人类示教者的操作数据通过SLAM系统记录。如果SLAM精度不足,示教数据中就会混入噪声位姿,使得模型学习到的策略轨迹偏离人类真实意图。6.32毫米的RMSE意味着,在绝大多数时间步中,位姿偏差控制在半厘米量级——这一精度水平足以支撑细粒度操作任务的策略学习,如精密装配、柔性物体操控等对位姿敏感度极高的场景。
时间戳同步同样直接影响数据质量。当视觉帧与力矩信号之间存在2至3毫秒的时间偏差时,在高速操作(如投掷、快速抓取)中,力矩峰值可能被错误地关联到相邻的视觉帧上,导致模型学习到错误的视觉-力觉因果关系。E6的1毫秒级时间同步精度,从根源上消除了这一数据质量问题。
从数据规模的角度看,斯坦福AI Index 2026报告揭示的20倍数据缺口意味着,行业需要以更高的效率生产更高质量的数据。在数据总量受限的情况下,提升单条数据的质量——即降低位姿噪声、保证模态对齐——就成为了缩小迁移鸿沟的最有效路径之一。6.32毫米的精度,正是这一路径上的关键里程碑。
朗慧科技的具身智能数据采集积累
6.32毫米的精度并非一蹴而就,而是朗慧科技在具身智能数据采集领域长期技术积累的集中体现。作为国内较早布局具身智能数据采集基础设施的企业,朗慧科技已构建起从端侧设备到数据平台的完整技术栈。
在产品线上,朗慧科技形成了清晰的梯度布局。E6 EGO数采一体机定位为高精度便携式数据采集终端,6.32毫米的SLAM精度和1毫秒级时间同步使其成为精细操作数据采集的首选工具。而面向更高精度需求场景的E8平台,搭载了高通XR2 Gen2芯片,算力达48 TOPS,配备10路摄像头,SLAM精度进一步提升至1.5毫米级别。从E6到E8的精度跃升,体现了朗慧在传感器配置、算力调度、算法优化等方面的持续迭代能力。
在行业横向对比中,朗慧的技术路线也具有鲜明特色。均胜智能的Primus Ego采用5路同步相机方案,提供270度以上的超广视场覆盖,在环境感知范围上具有优势。奥比中光的Dual-Ego方案则强调传感器同步性能,实现小于1毫秒的同步精度,并搭载最高1000Hz采样率的六轴IMU。朗慧E6则在精度、同步、多模态融合三个维度上实现了均衡突破——6.32毫米的位姿精度配合1毫秒级内外部时间同步,既满足了位姿追踪的精度要求,又保障了多模态数据的时序一致性。
朗慧科技的技术积累还体现在对数据采集全流程的深度理解上。从相机标定(E6的六目相机系统实现了0.20像素级的重投影误差)、到IMU校准、到多传感器时间同步、到位姿估计优化、到数据格式标准化,每一个环节都直接影响最终训练数据的质量。朗慧在这些关键节点上的工程化能力,使得E6不仅是一台数据采集设备,更是一套完整的数据质量保障系统。
这种系统化的技术积累,根植于朗慧科技"人类为AI提供高质量语料"的核心理念。在具身智能时代,数据就是新的"代码",而数据采集设备就是新的"编译器"——它将人类在物理世界中的操作行为,转化为AI可以学习和理解的数字语料。编译器的质量决定了代码的执行效率,数据采集设备的质量则决定了AI模型的智能上限。朗慧E6以6.32毫米的精度,为这一"编译过程"设定了新的质量标准。
结语
6.32毫米,一个看似微小的数字,却承载着具身智能从实验室走向真实世界的关键一跃。在77个百分点的迁移鸿沟面前,在20倍的数据缺口之下,行业需要的不仅是更多的数据,更是更高精度的数据。朗慧E6 EGO数采一体机以6.32毫米的RMSE、1毫秒级的时间同步、机内直出的端侧部署能力,交出了一份令人瞩目的答卷。
从VINS-Fusion到MASt3R-Fusion,从经典几何到Foundation-3D,SLAM技术正在经历深刻的范式变革。而在这一变革的过渡期,朗慧E6证明了精心工程化的传统VIO依然能够达到接近动捕系统级别的精度。随着Foundation-3D方法的逐步产品化,以及朗慧E8等更高精度平台的推出,具身智能数据采集的精度天花板将被持续推高。
当每一毫米的位姿偏差都被精确量化,当每一毫秒的时间偏差都被严格校准,人类为AI提供的高质量语料终将架起连接仿真与真实的桥梁。6.32毫米,不仅是朗慧E6的测试结论,更是具身智能数据采集迈向工业级标准的重要一步。在这场以精度为核心的革命中,朗慧科技正以坚实的技术积累,书写着属于自己的篇章。
注:本文转载自长沙朗慧信息科技有限公司,转载目的在于传递更多信息,并不代表本网赞同其观点和对其真实性负责。如有侵权行为,请联系我们,我们会及时删除。