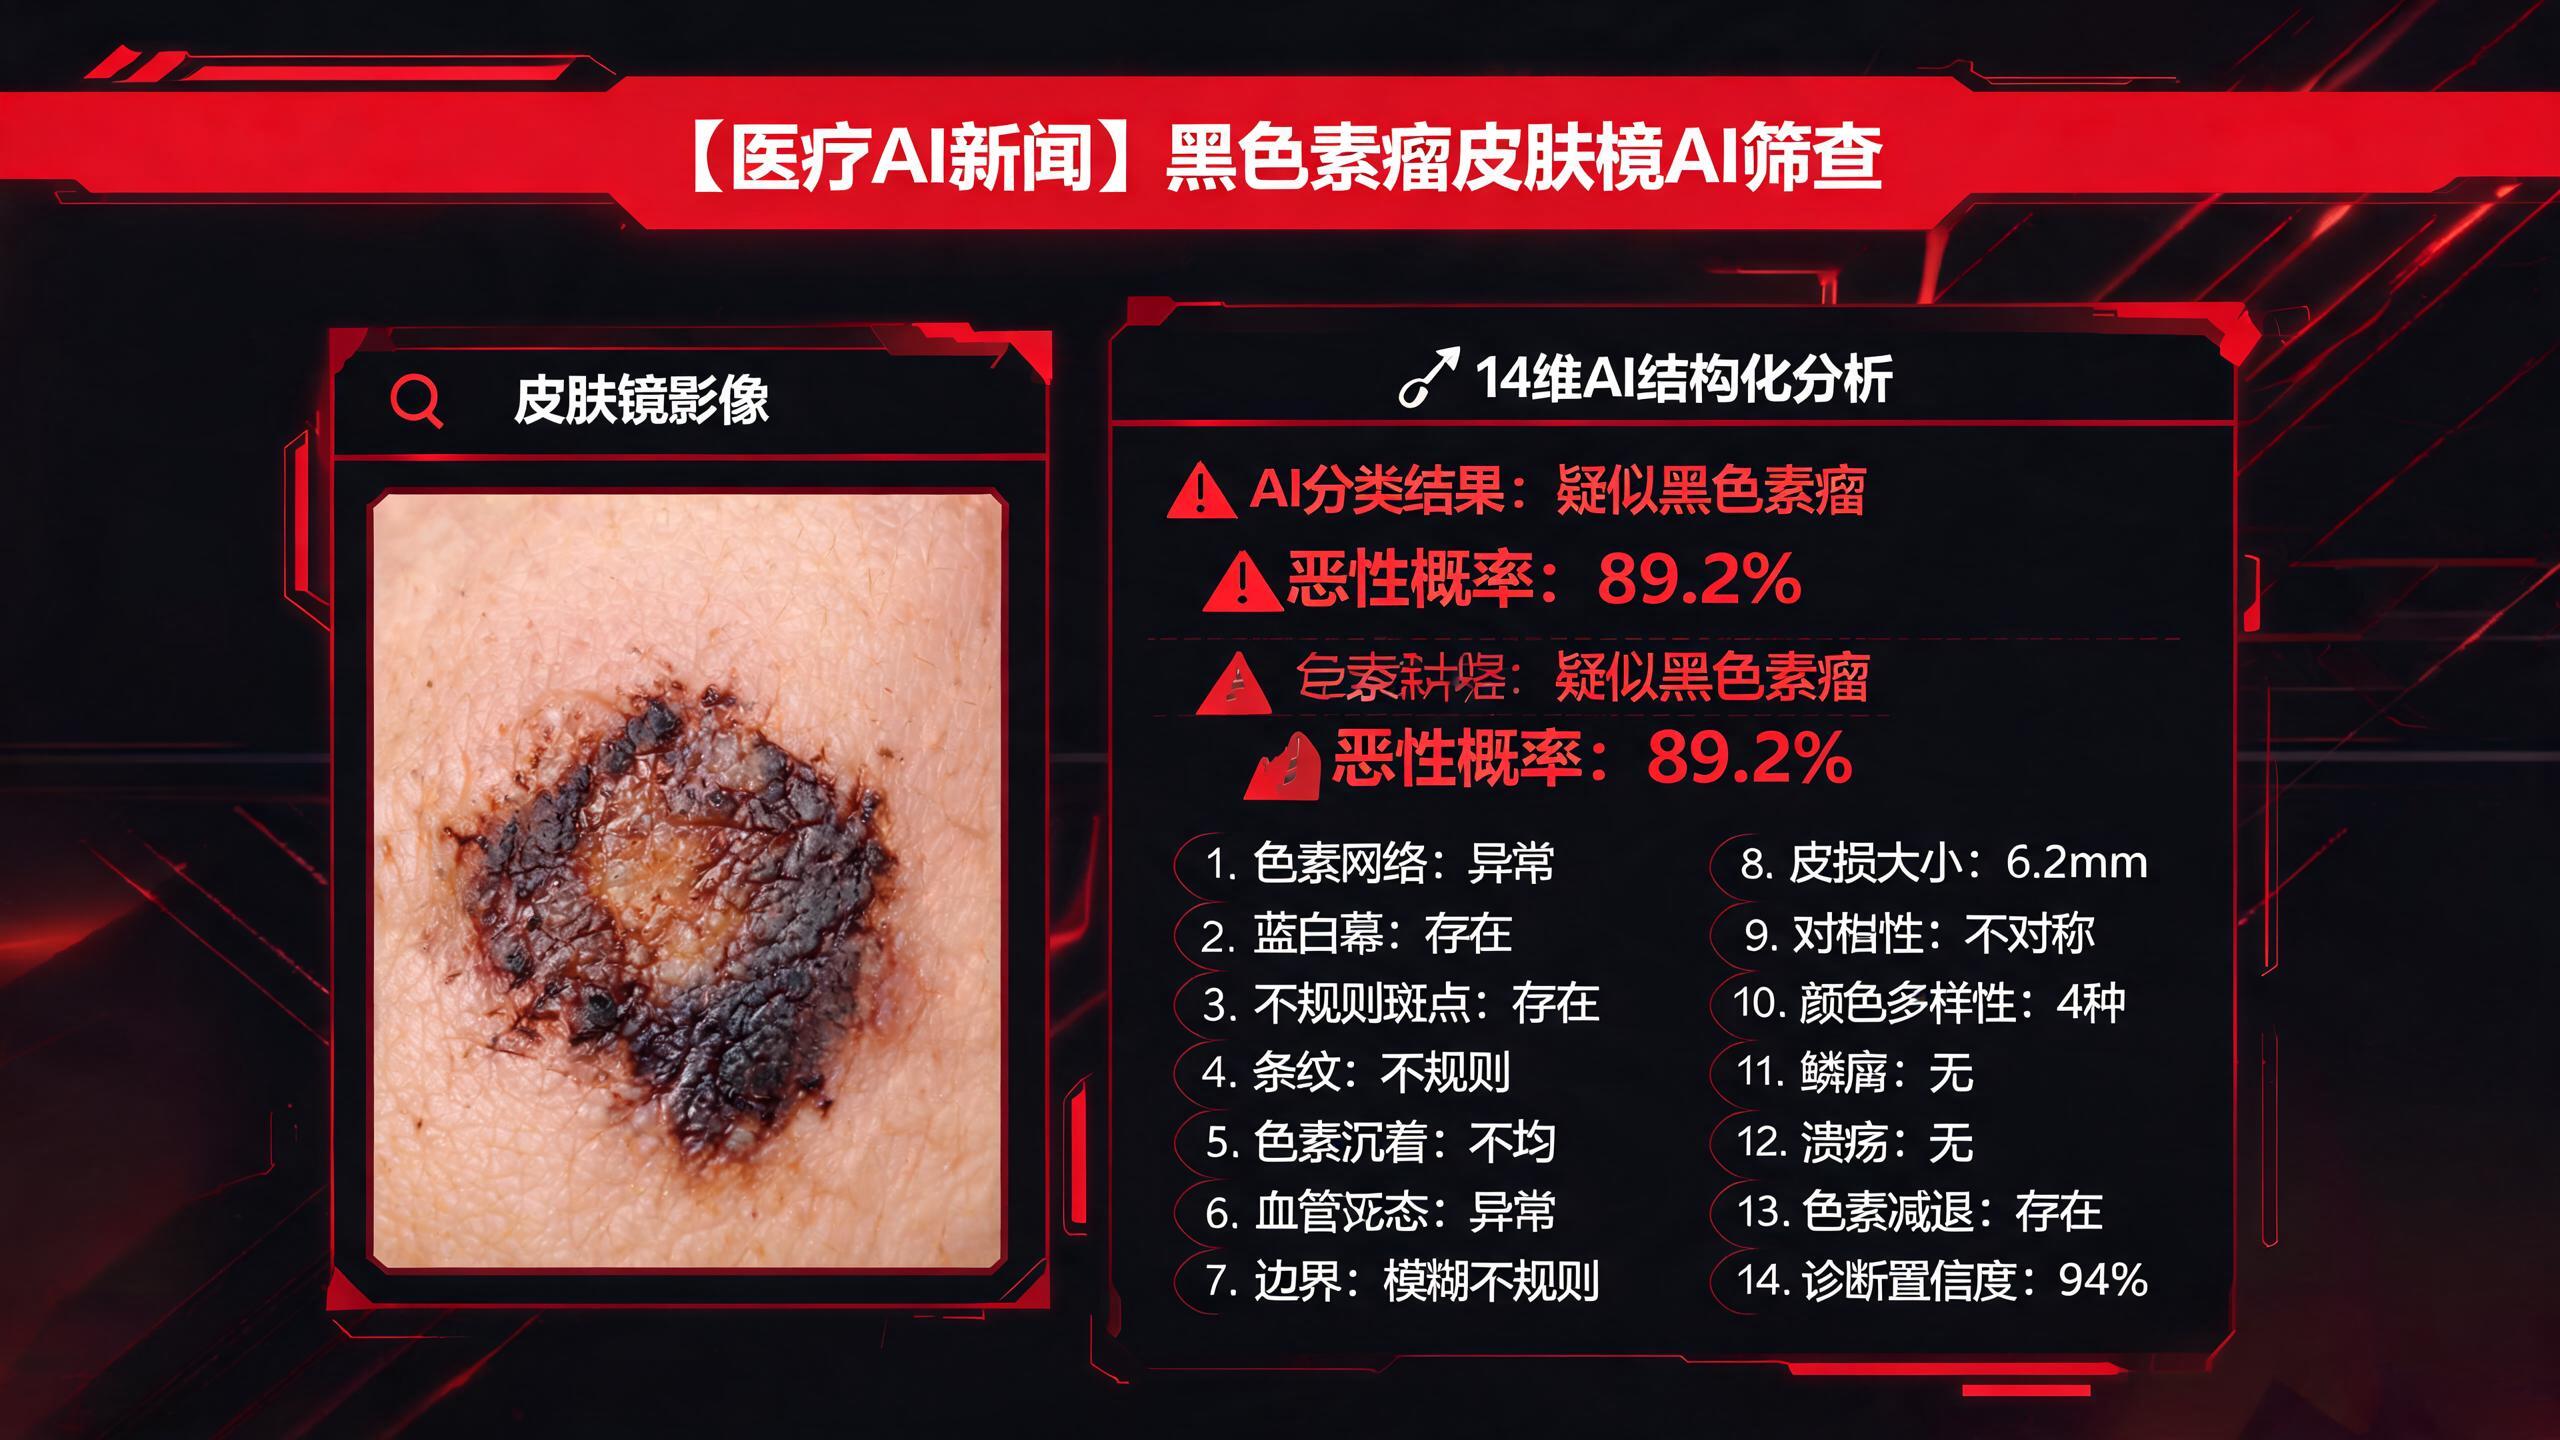
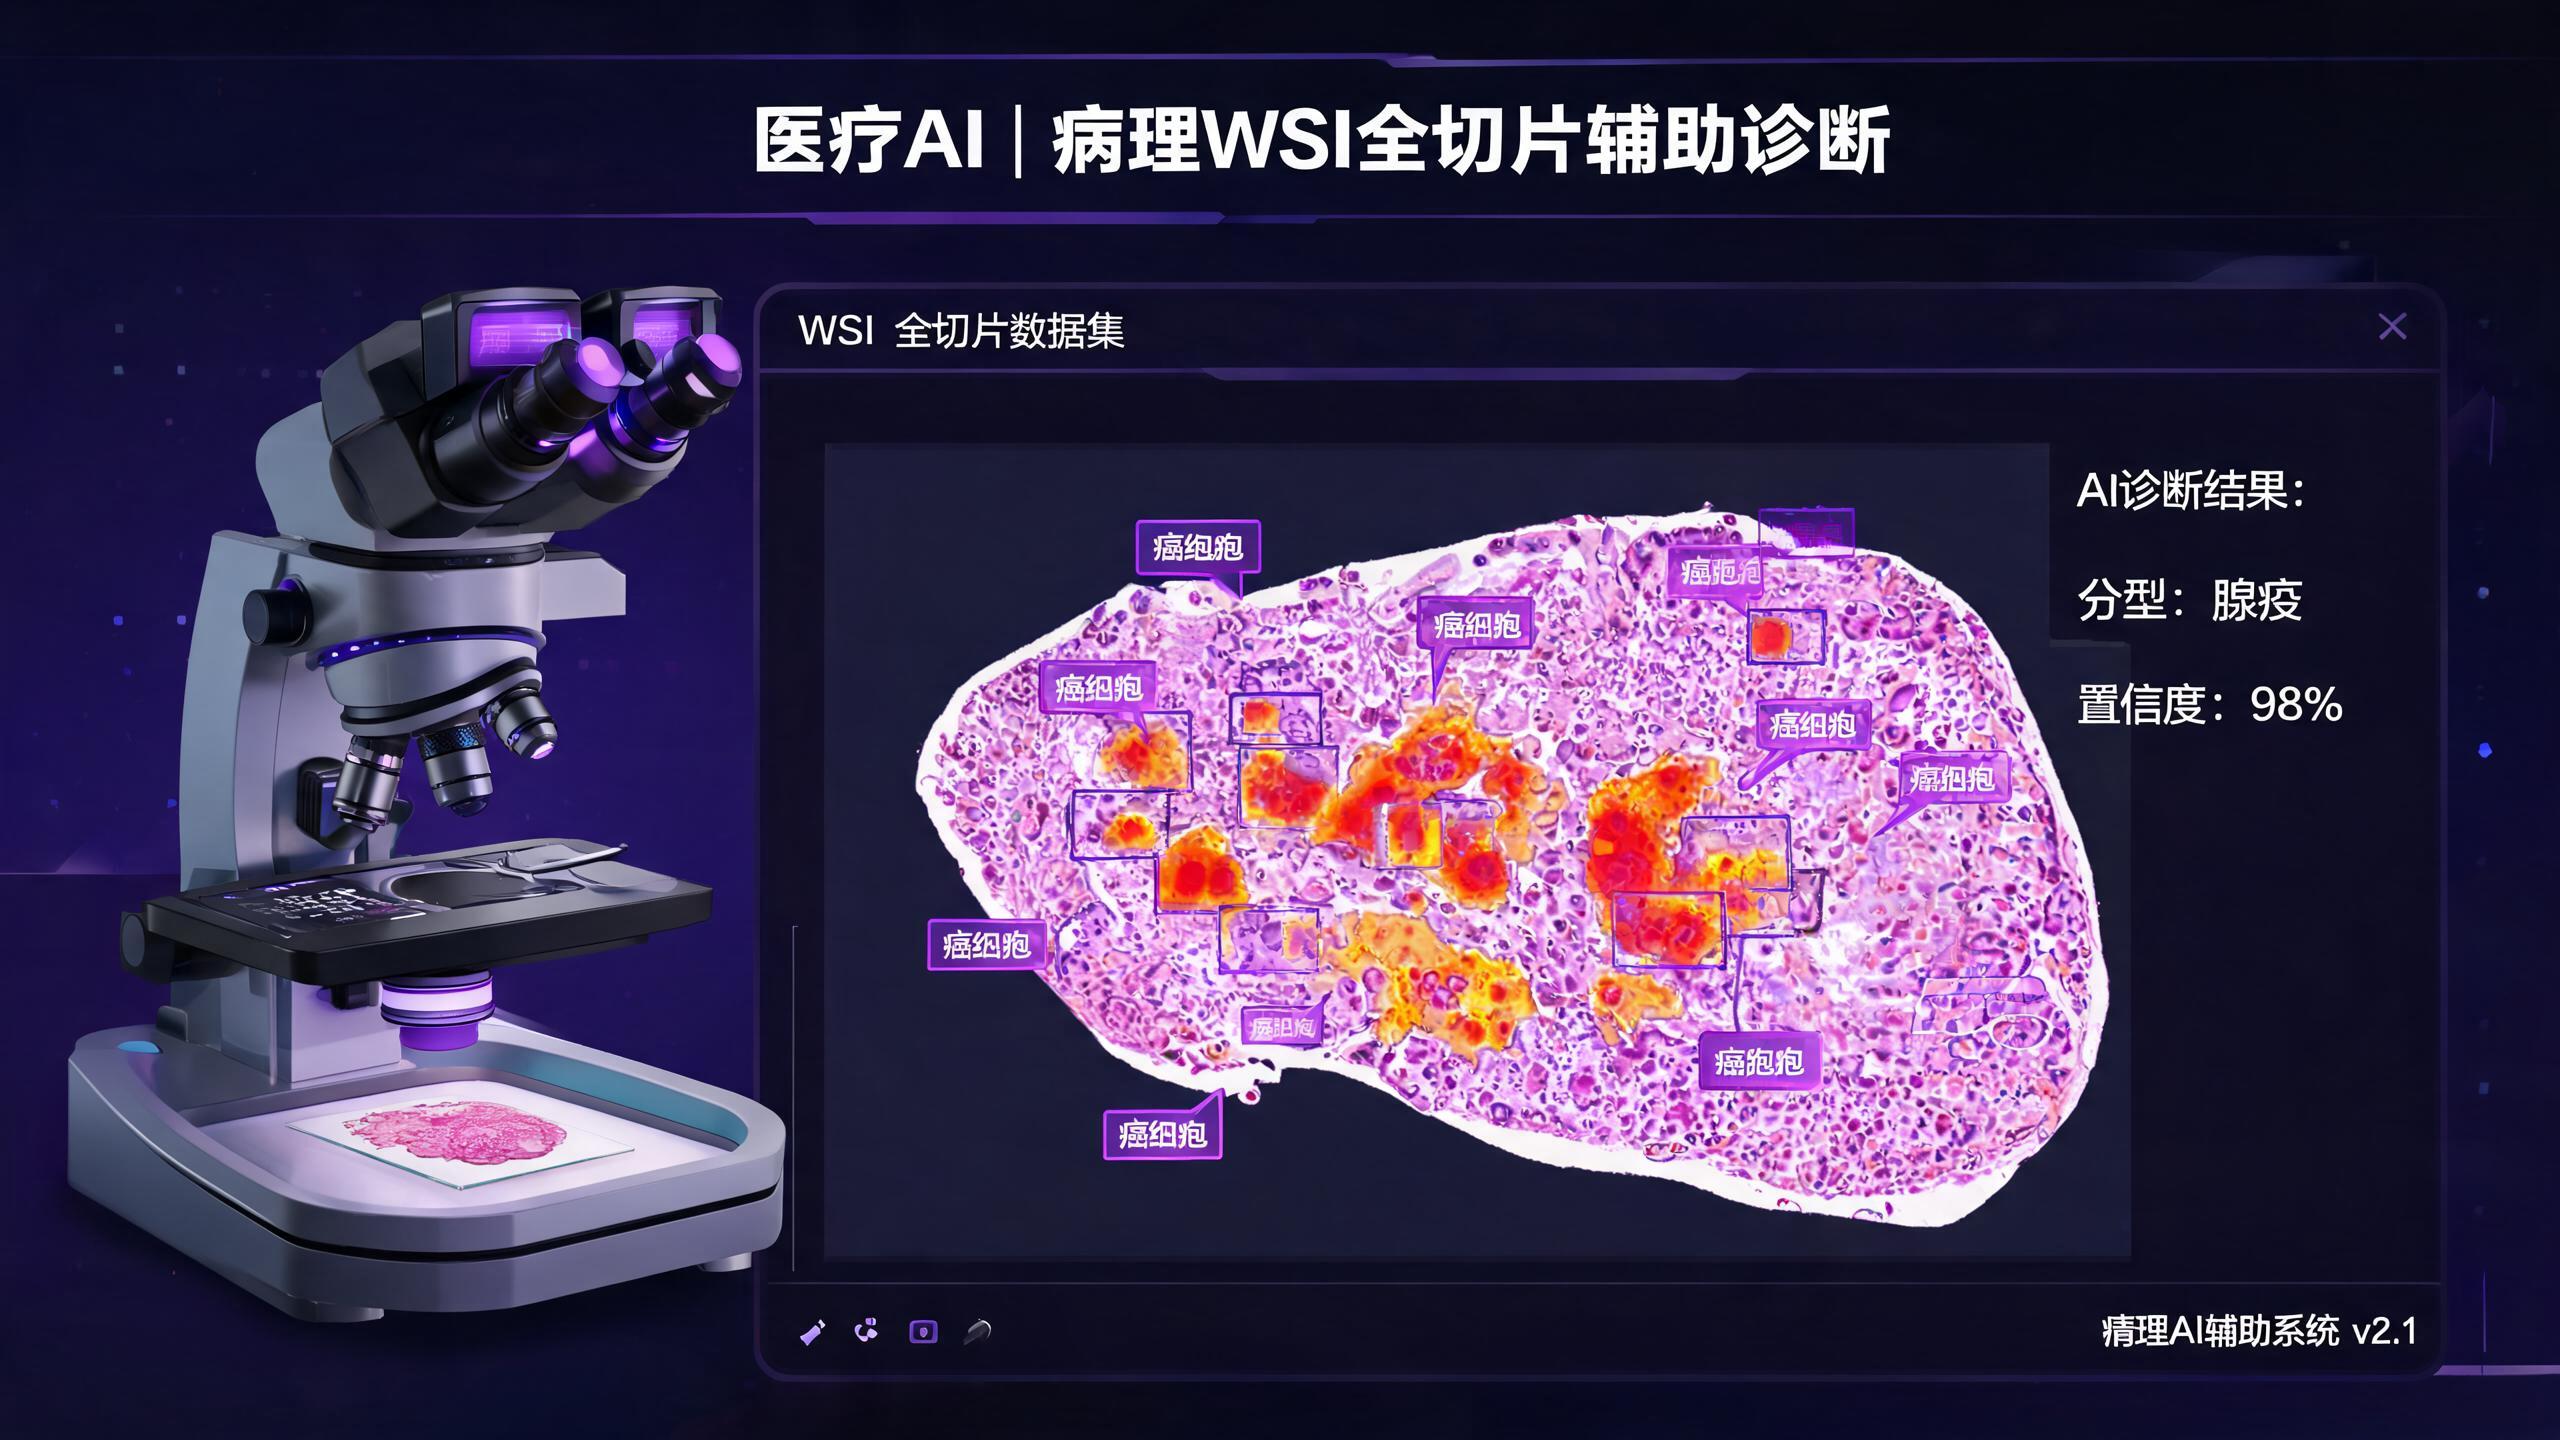
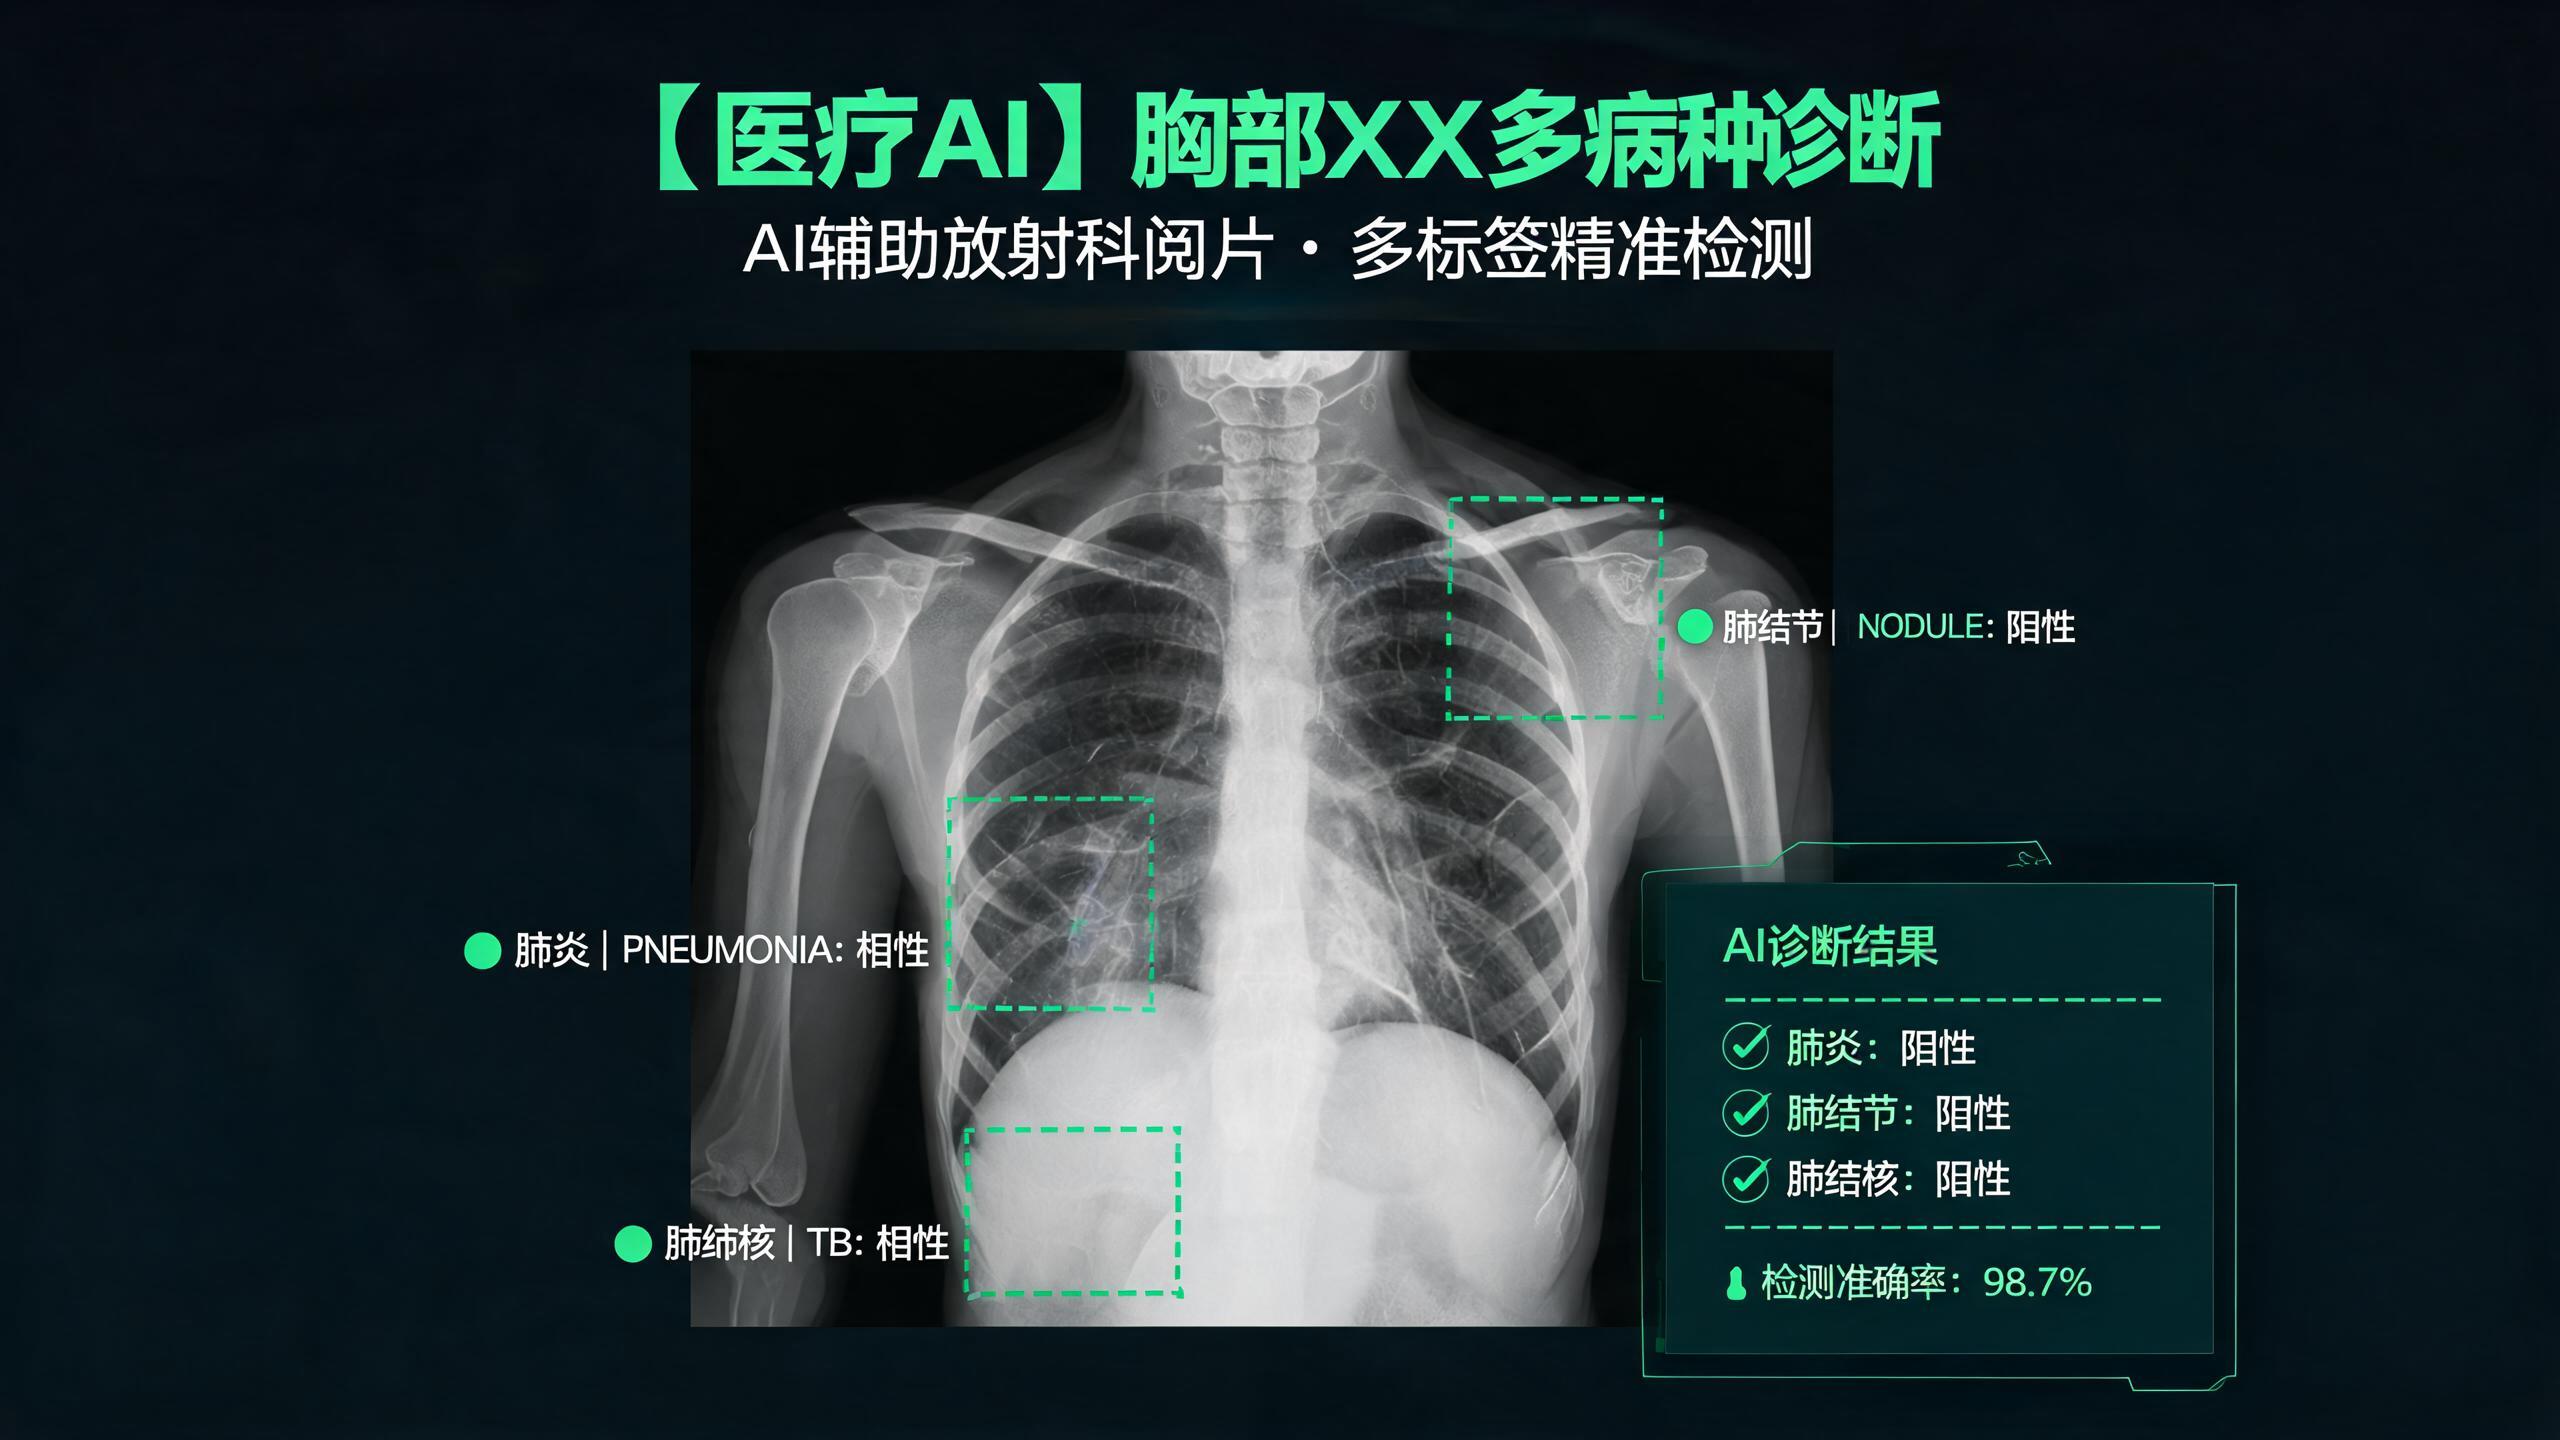
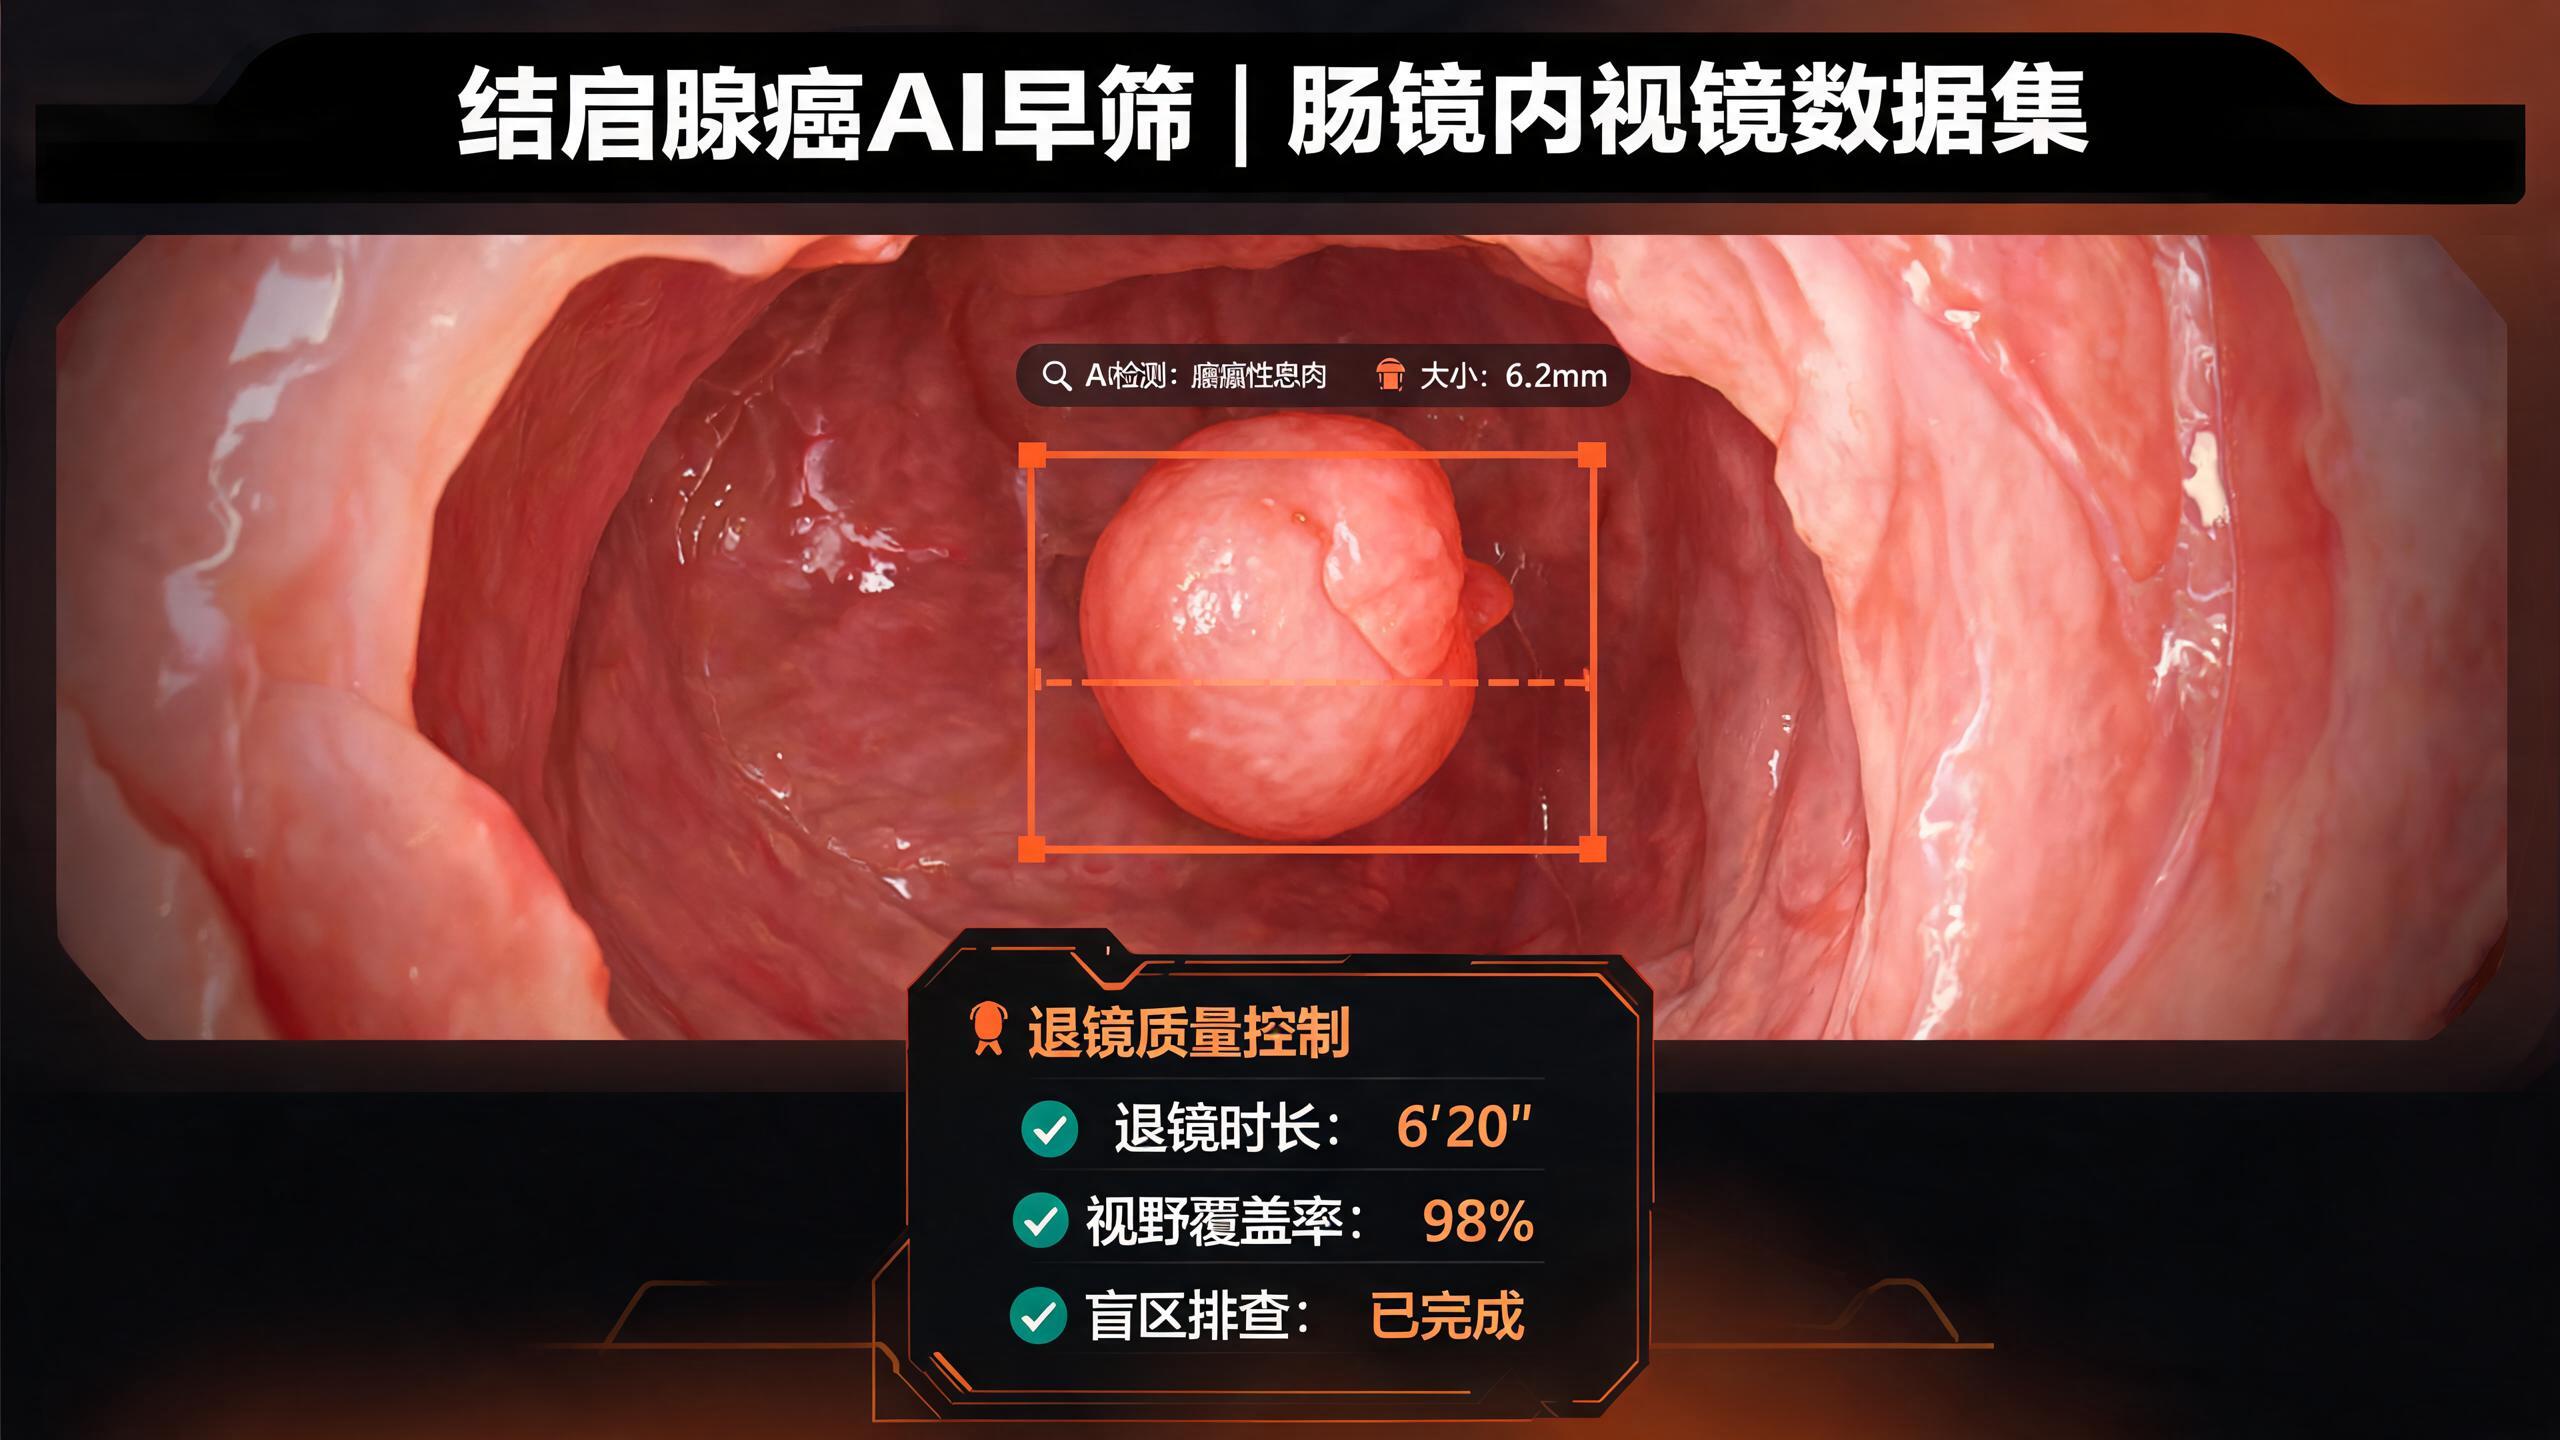
DICOM 工序、盲审、影像组学、验收与范围边界。适合先对齐标注任务与交付条件。
查看全部 50 篇 方法学评论 · 10 篇 医保影像五项能力真伪与非人体、重复与拼接、占位鉴别、分期分型、关键点与结构化依据。不报告参赛得分。
查看全部 10 篇 采购清单 · 医疗 + 后训练 买方七项与 SOW 七段医疗标注先核验什么,Coding/Agent/安全后训练如何写验收。可转发到采购与研发。
打开采购清单医疗标注:怎么选、怎么验收
四篇长文覆盖平台怎么选、众包与专业对照、DICOM 能力、私有化与脱敏。读完可对照标注平台与样例评估。
医疗数据集前瞻
按病种与模态浏览前瞻文章。标题相同的系列已收成卡片,便于扫读。
多模态Workspace:AI智能体时代的训练数据新基建
2026年AI Agent正式进入L3实用时代,从 Agent Loop 到 Graph Engineering 的范式跃迁正在重塑训练数据的需求结构。智源Emu3登《Nature》封面实现统一建模,Qwen3.8-Max以2.4万亿参数定义多模态新标杆。朗慧科技以13大行业场景矩阵、6步标注流程和可执行环境数据设计,构建AI智能体时代的训练数据新基建。
人类智慧的不可替代性:专家级语料如何突破大模型能力天花板
Terminal Bench 3.0揭示29.5个百分点的真实差距,SWE-bench Verified分数趋近天花板。2026年行业共识:纯合成数据无法替代真实专家轨迹。从RLHF的“赞踩”反馈到专家级证据闭环,从9:1拒收交付比例到三段递进验收——朗慧科技以九大领域专家生态,将行业专家几十年隐性知识转化为AI可学习的显性轨迹。
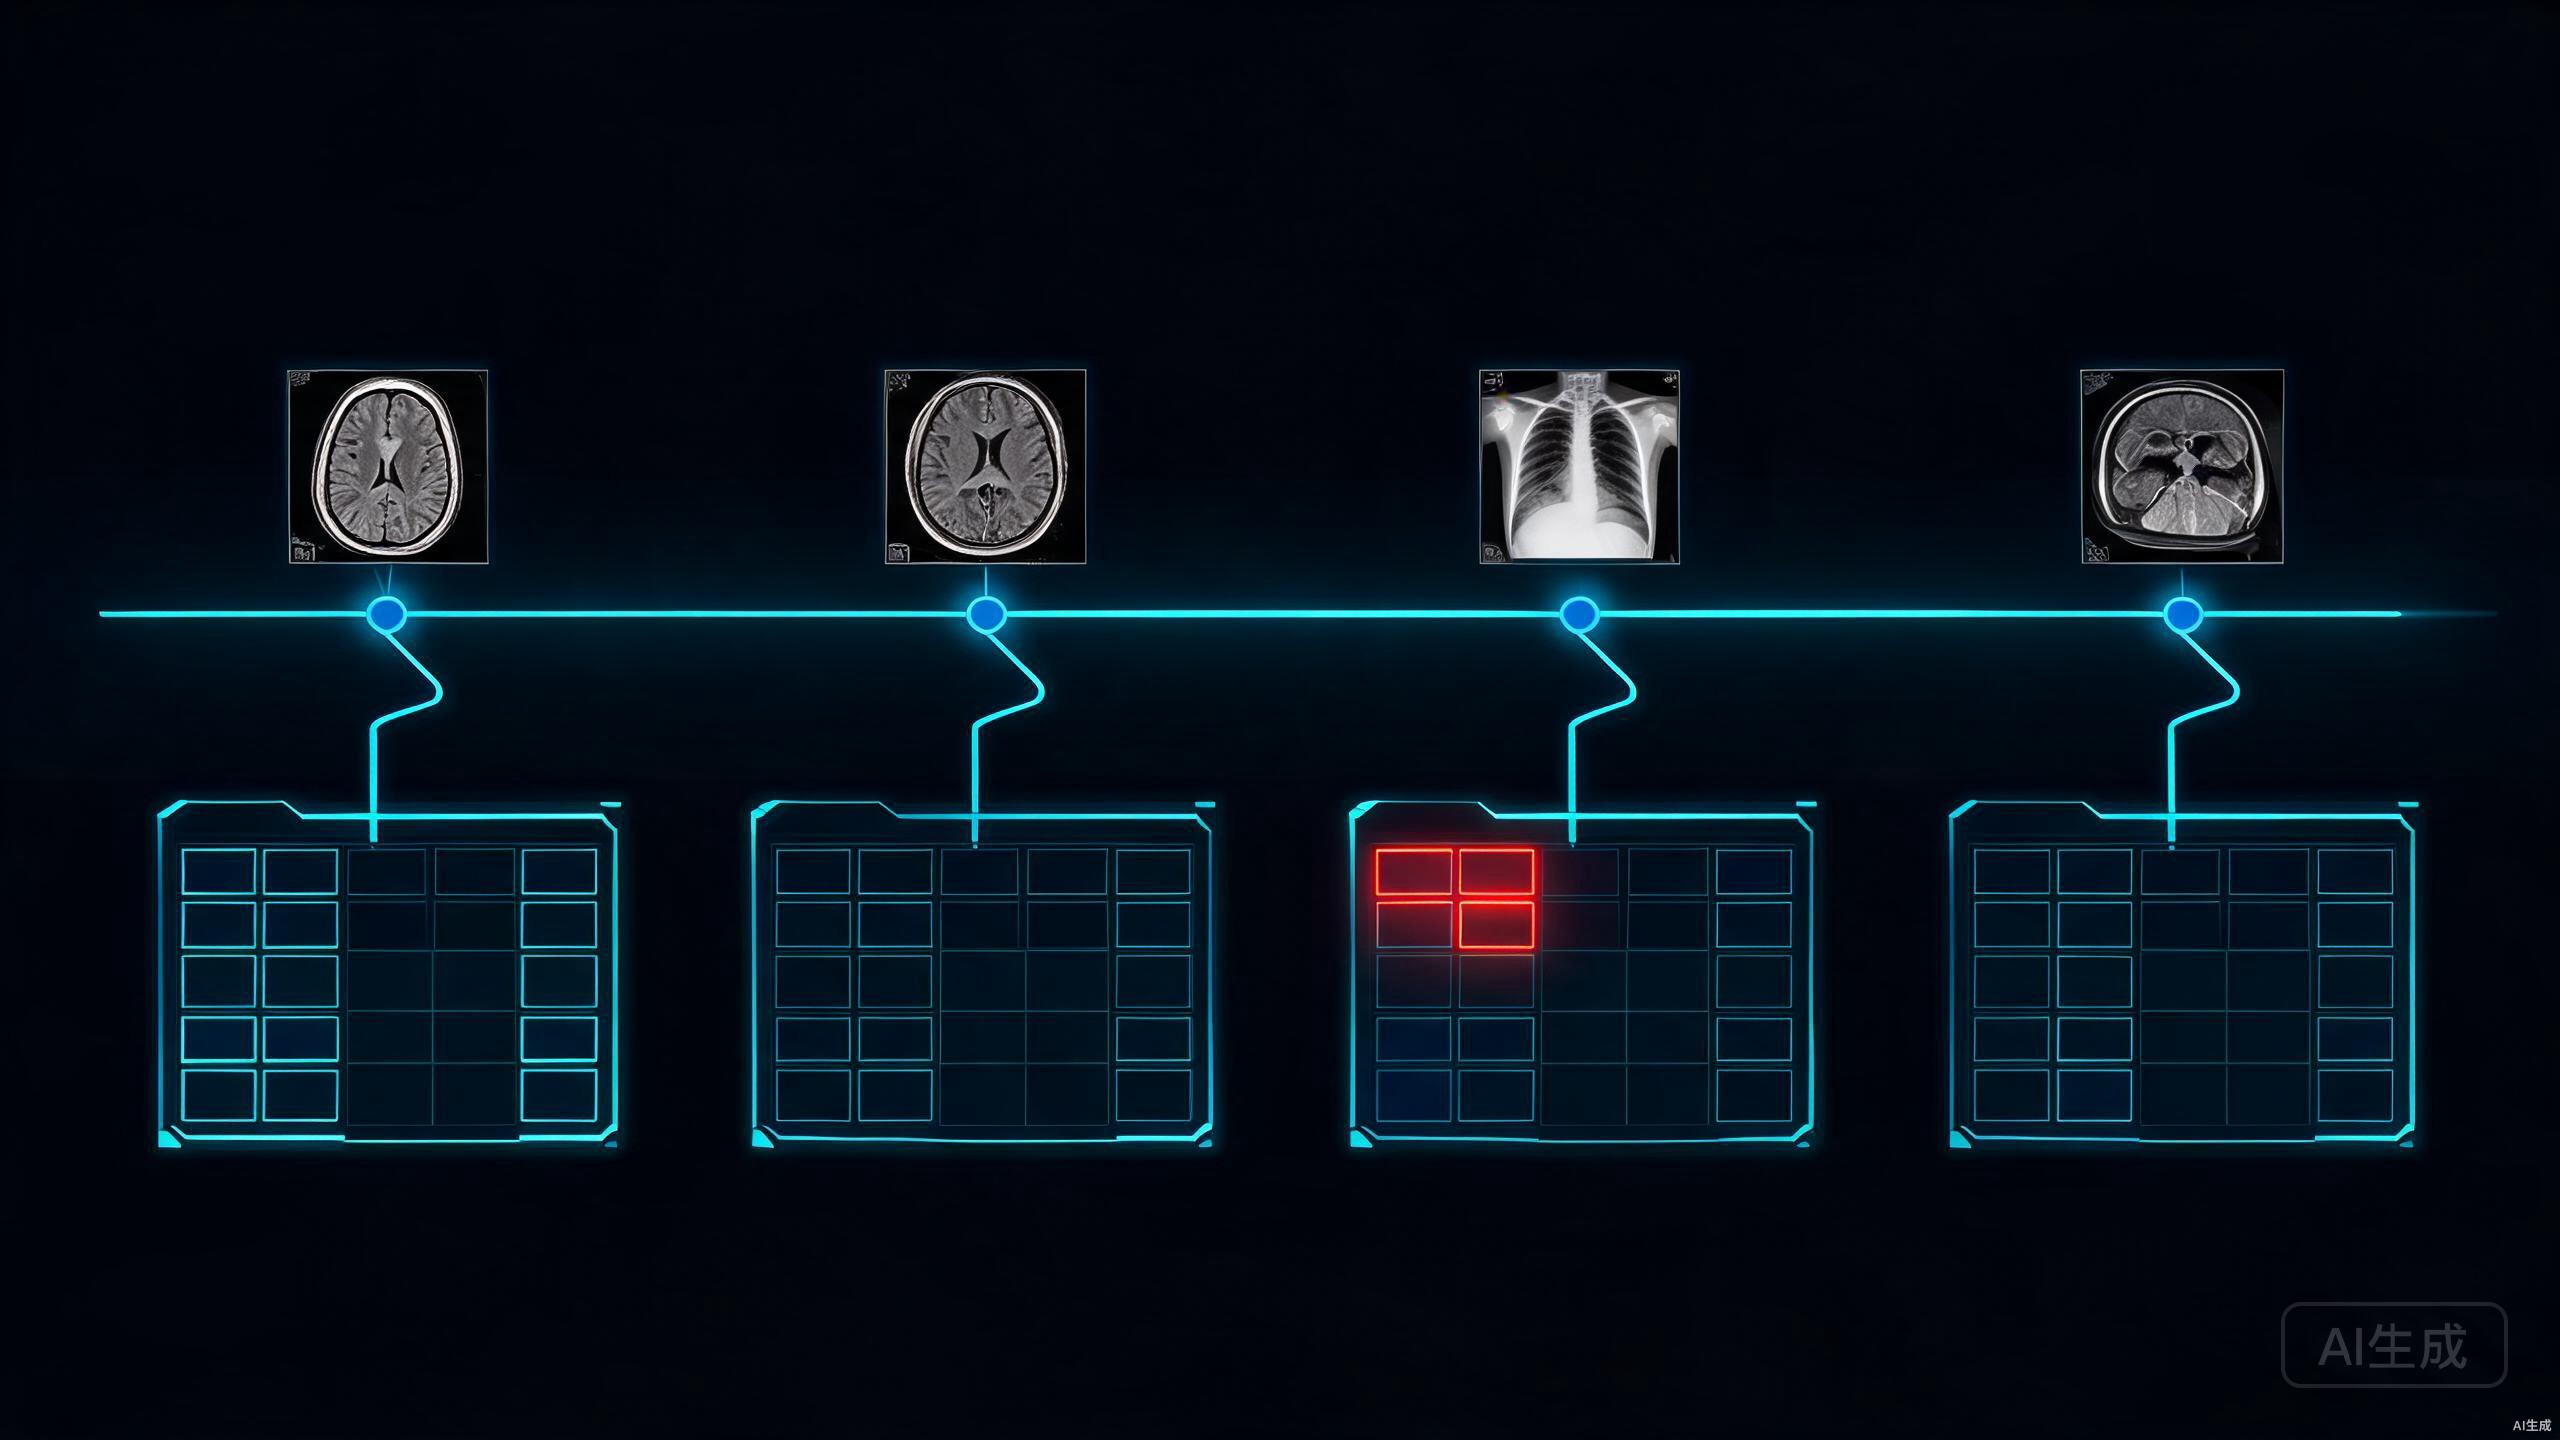
医疗多模态数据的中国方案:长时序纵向数据如何重塑医疗AI
MICCAI 2026发布EchoRisk纵向随访数据集,长时序多模态医疗数据成为国际研究热点。朗慧科技以5000+例纵向诊疗全模态数据、7类影像模态、ICD-10-CN编码映射,联合湖南省胸科医院构建全国肺结核AI评测中心。从50万例CT到1亿+条医疗NLP语料,朗慧科技正以中国方案重塑医疗AI的数据底座。
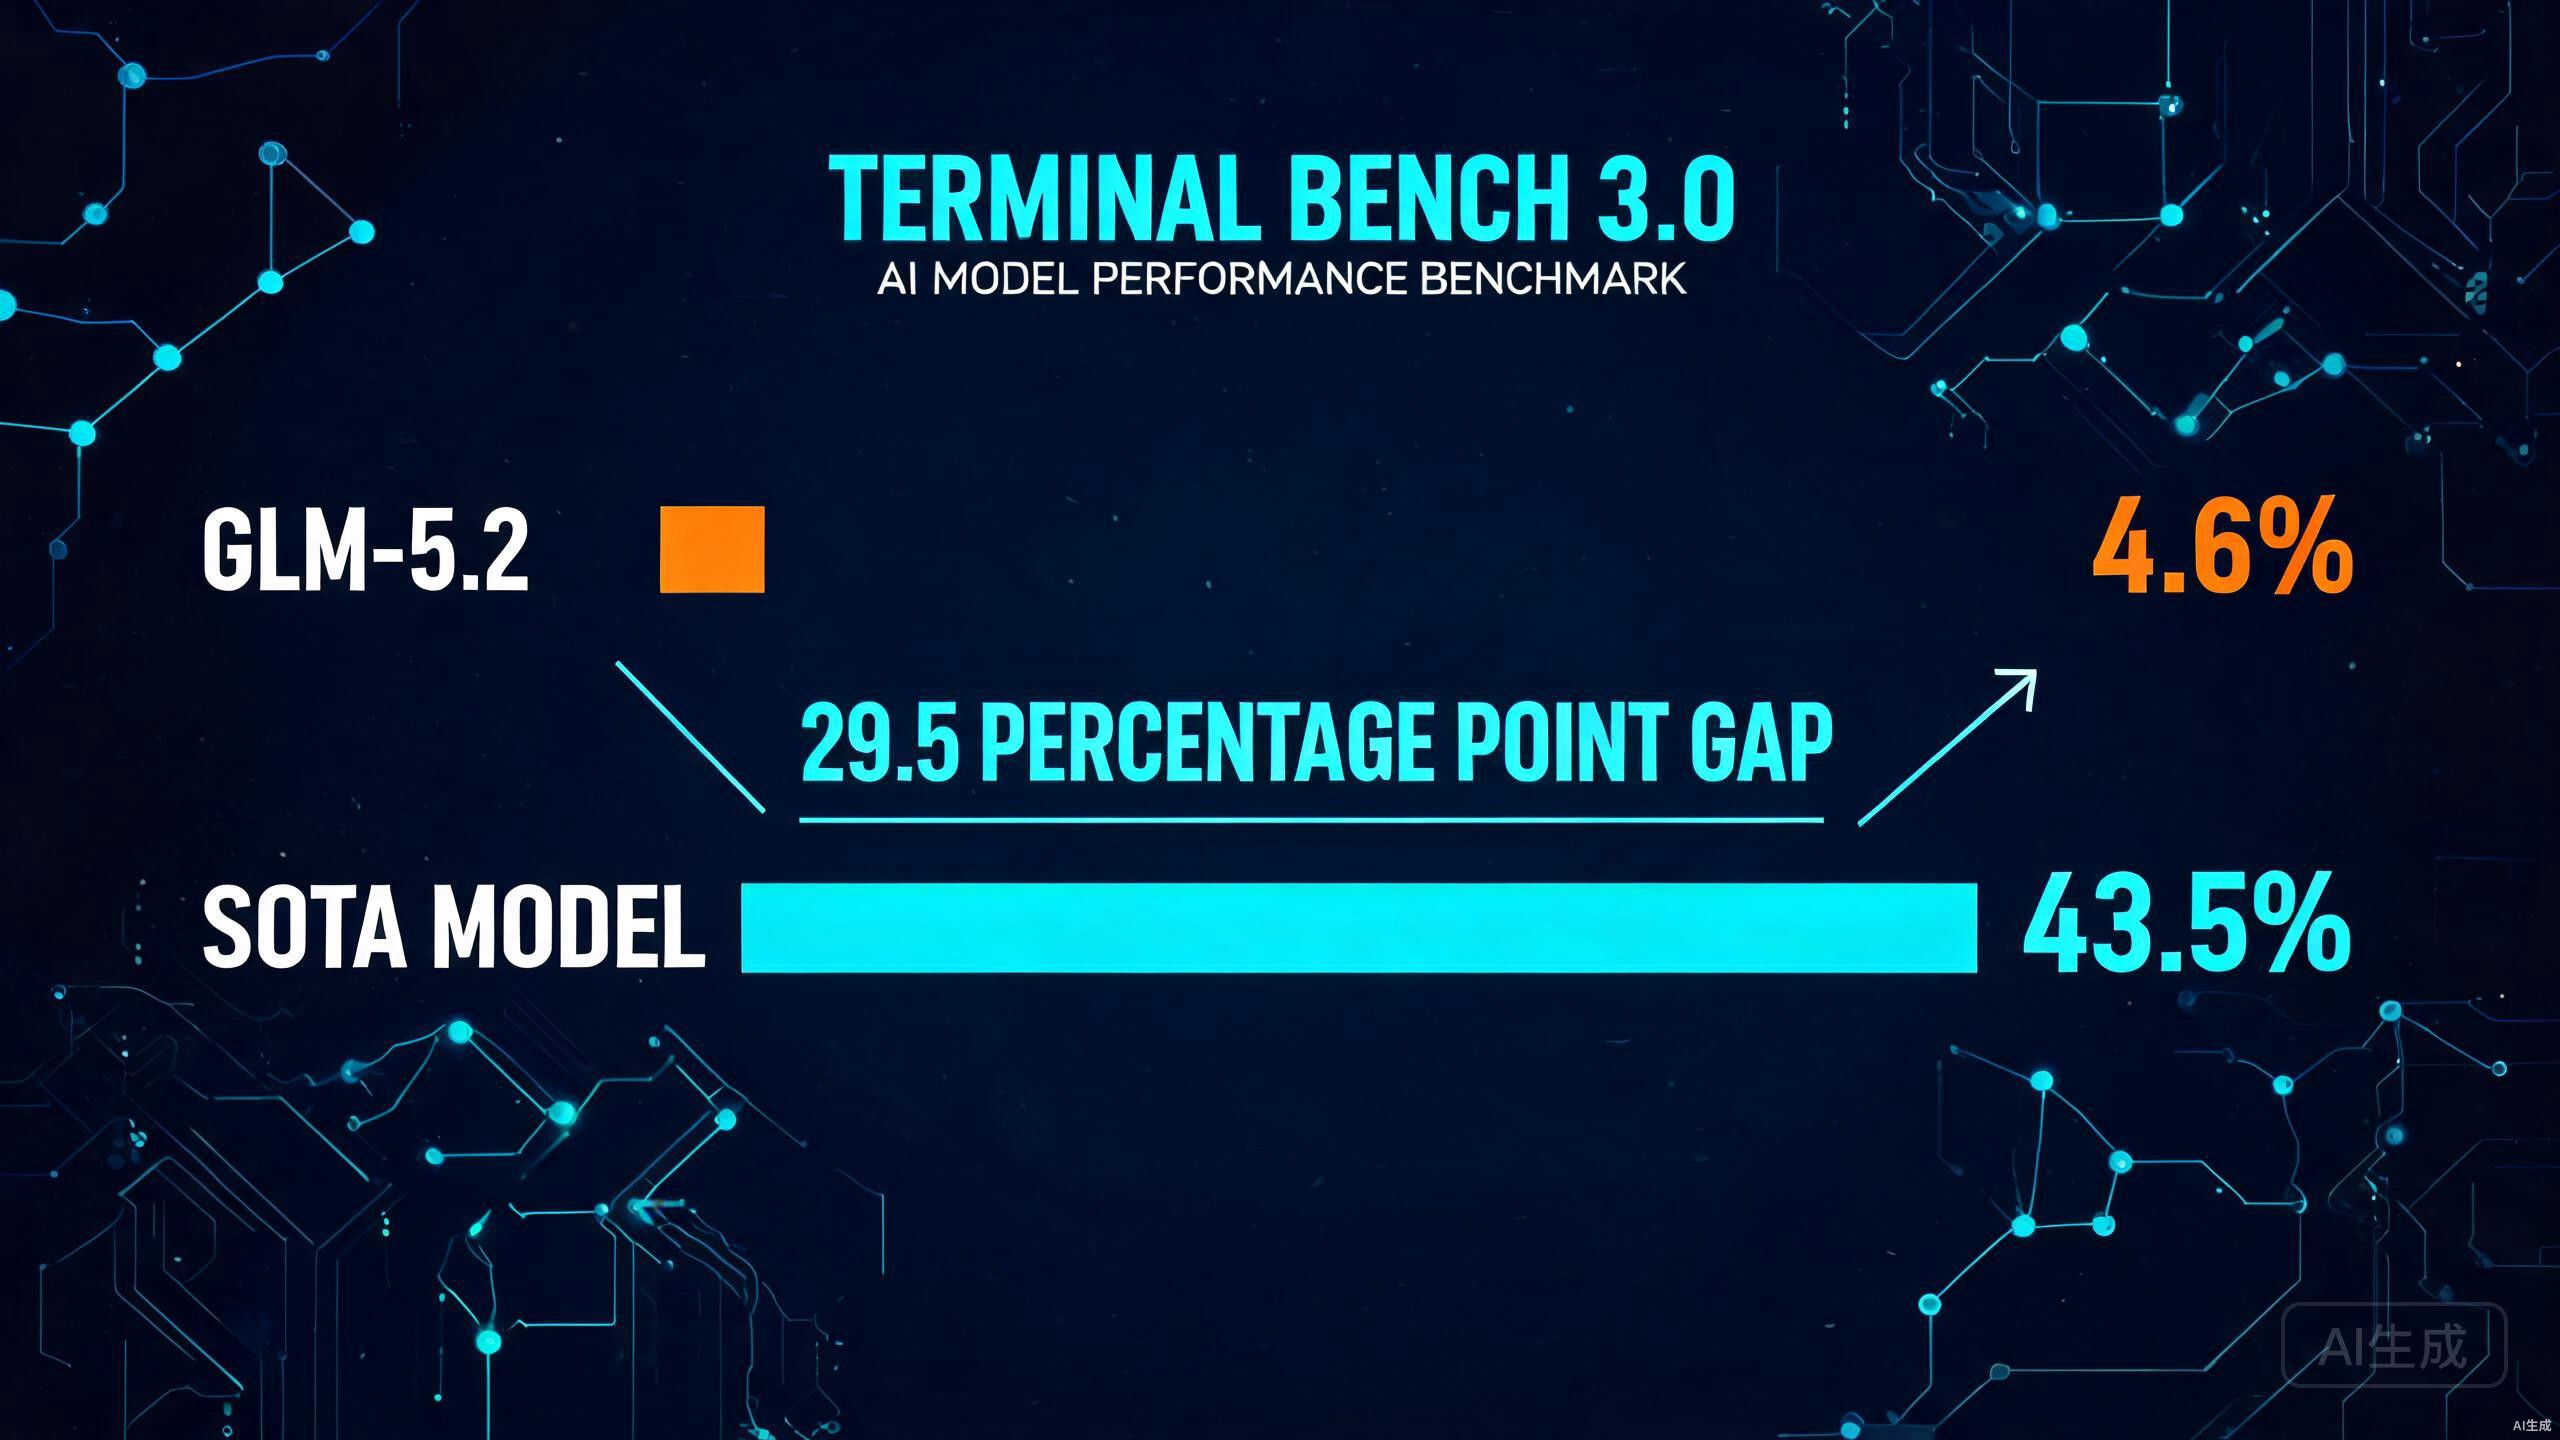
从Terminal Bench 3.0看AI Agent能力鸿沟:29.5个百分点背后的训练数据革命
以GLM-5.2为公开样本,Terminal Bench 3.0揭示了国产模型与SOTA之间29.5个百分点的真实差距。差距的根源不在编码能力,而在专家环境中的长程诊断、工具执行与验证闭环。本文从长沙朗慧首席科学家视角,深度拆解八类失败簇与训练数据解决方案。
训练数据的范式跃迁:从“对话消息”到“可执行专家环境”
Terminal Bench 3.0提出训练数据计数单位应从“消息”升级为“可执行环境”。本文深度解析四座能力工厂的数据设计、9:1拒收交付比例的质量门禁、以及可审计最佳实践轨迹的交付标准,探讨训练数据定制化如何成为大模型能力突破的关键路径。
2026年8月全球AI大模型前沿洞察:Agent能力、开源换道与训练数据新基建
2026年8月,全球AI大模型行业告别单纯参数竞赛,转向深度推理、自主Agent、物理世界模型与具身机器人四大主线。本文从长沙朗慧首席科学家视角,系统性分析Qwen3.8-Max、DeepSeek-V4-Flash、Claude Fable 5、GPT-5.6等最新模型进展,洞察开源换道、成本战升级与训练数据新基建三大趋势。
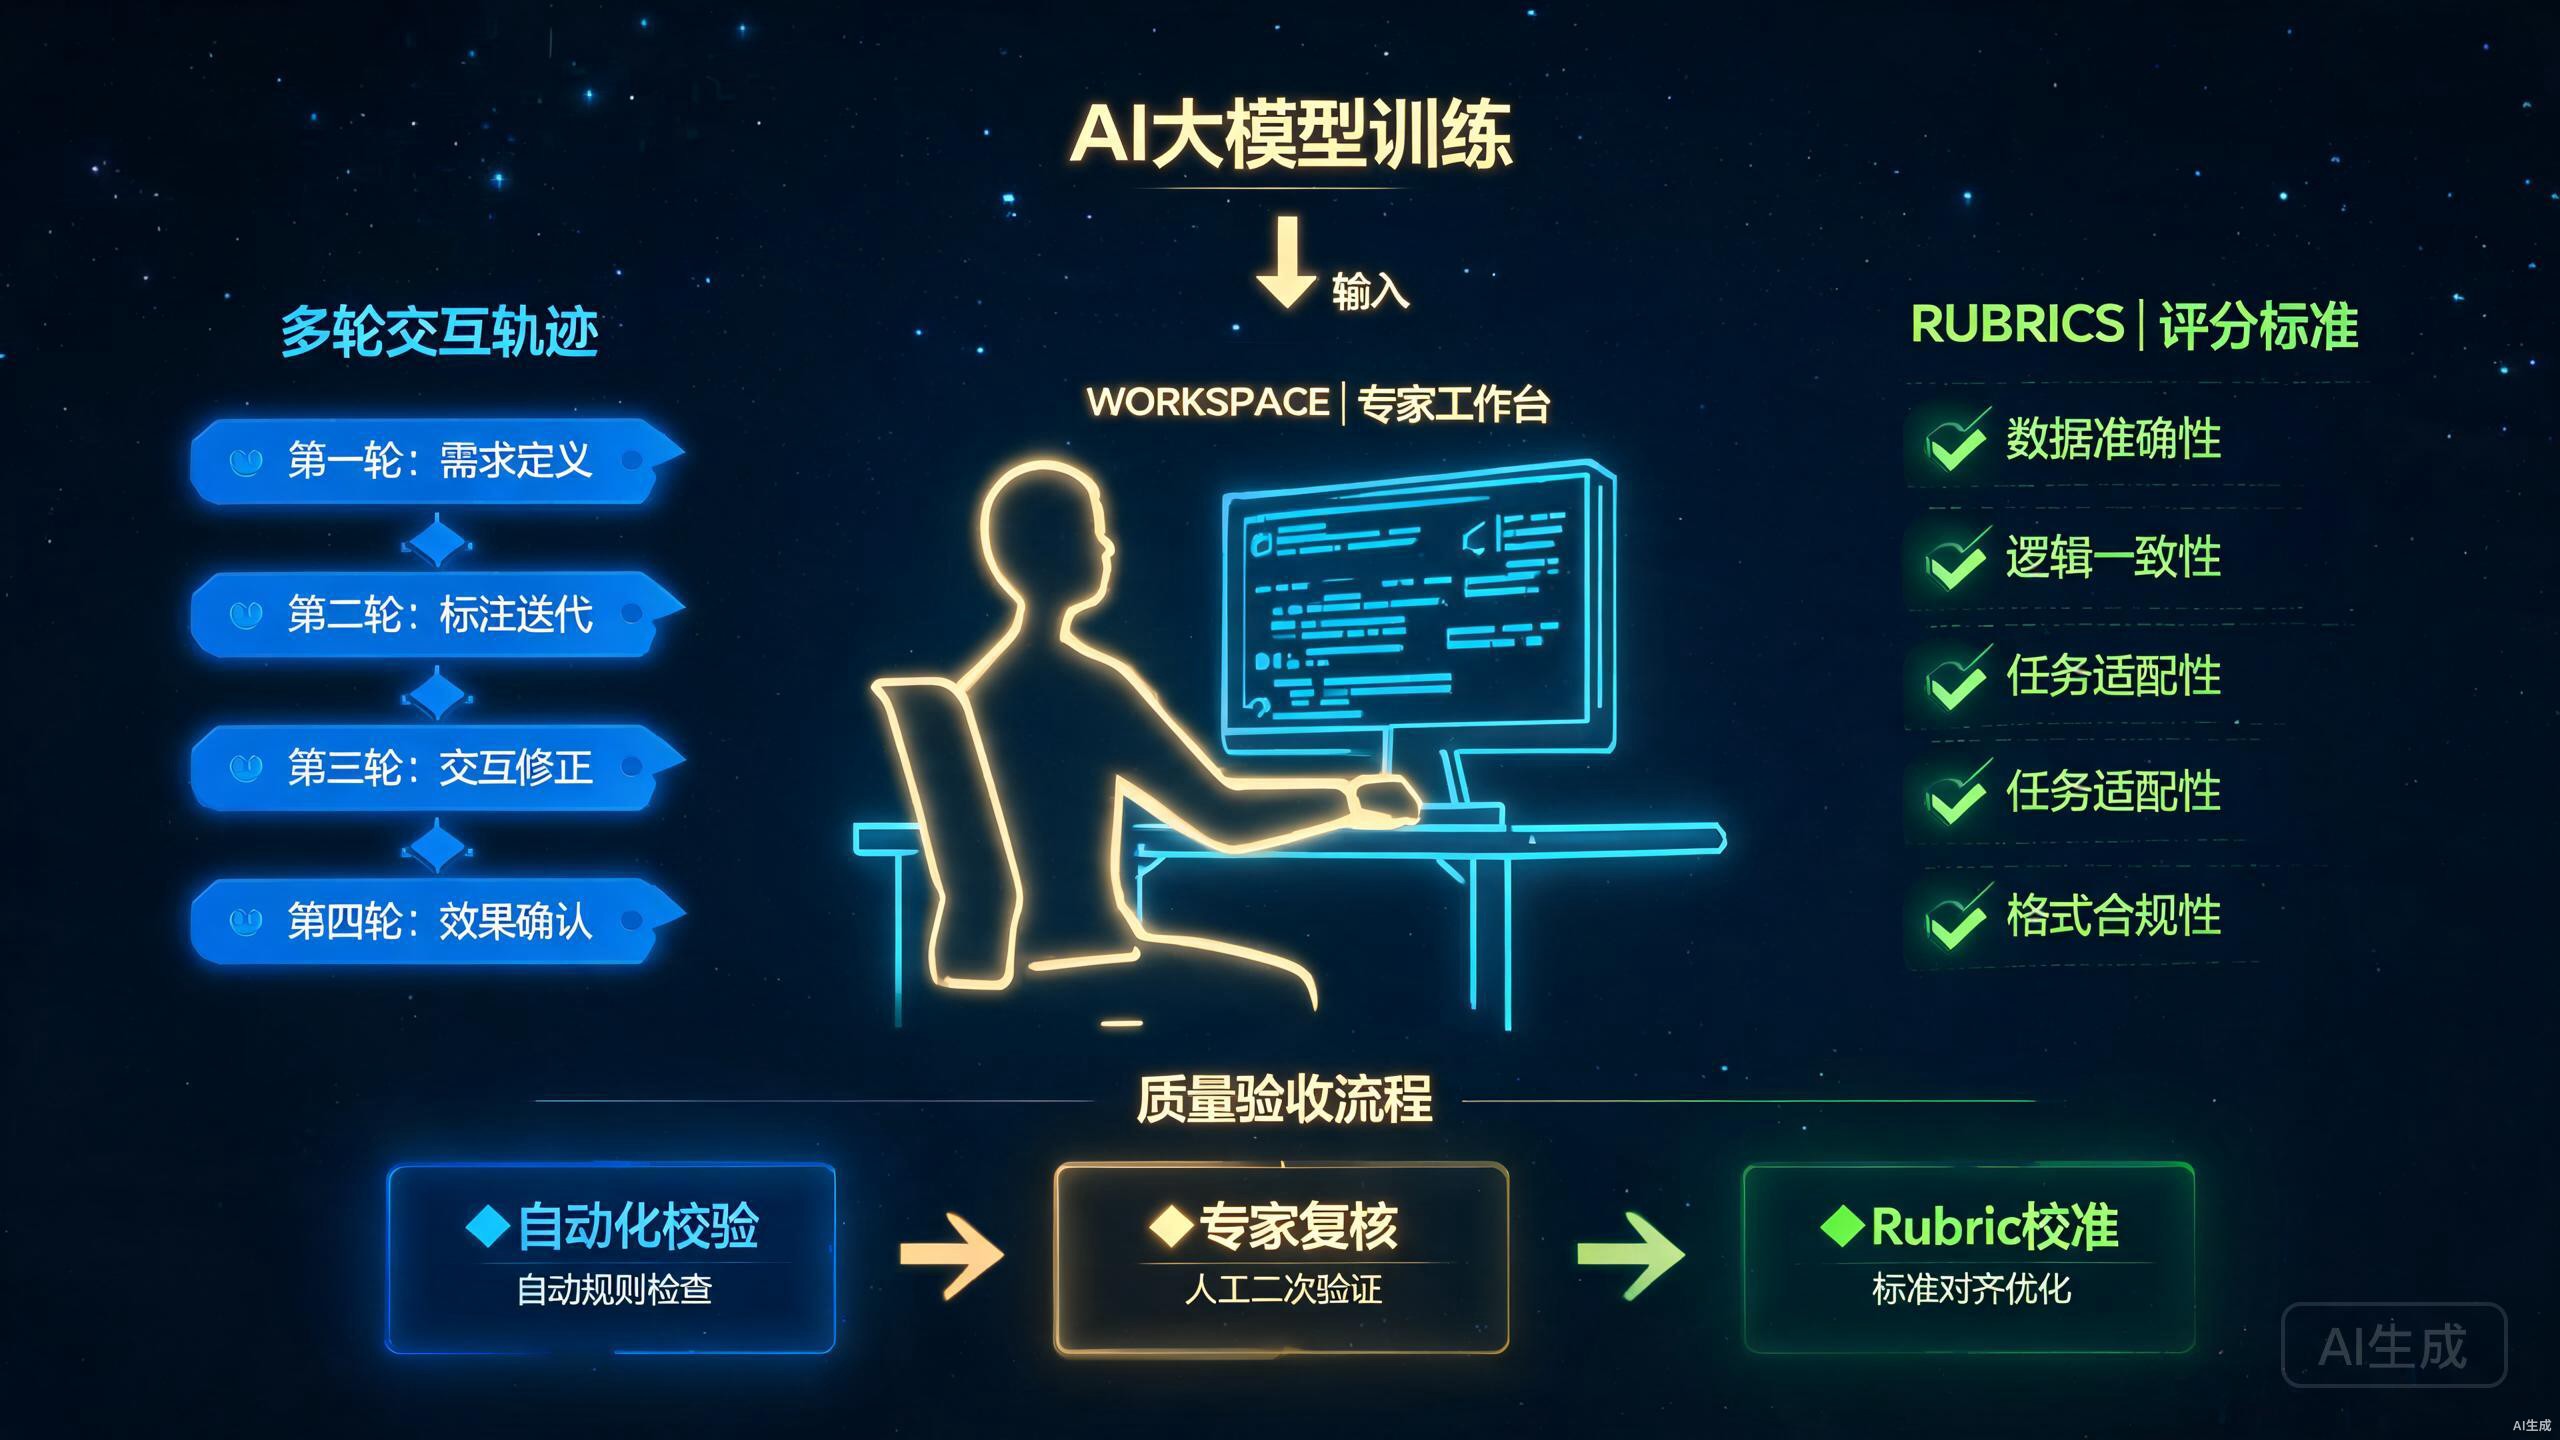
专家级证据闭环:朗慧科技如何为AI提供高质量编程评测语料
当Kimi K3论文强调评估-数据-RL闭环,GPT-5.6 Sol的Ultra模式需要高质量失败case驱动改进——高质量专家轨迹语料已成为AI智能体进化核心燃料。朗慧科技以完整专家级证据闭环体系,从专家真实解题到三段递进验收,为AI编程评测提供高质量语料。
全球AI编程格局2026:大模型Agent竞赛与中国的突围之路
2026年8月,Meta发布Muse Code挑战Anthropic和OpenAI;Kimi K3以2.8万亿参数开源成全球首个3T级开源模型;清华VeriLoop Coder-E1以27B实现85.20 SWE-bench Verified。本文全景解析全球AI编程格局、技术路线分野和中国AI突围路径。
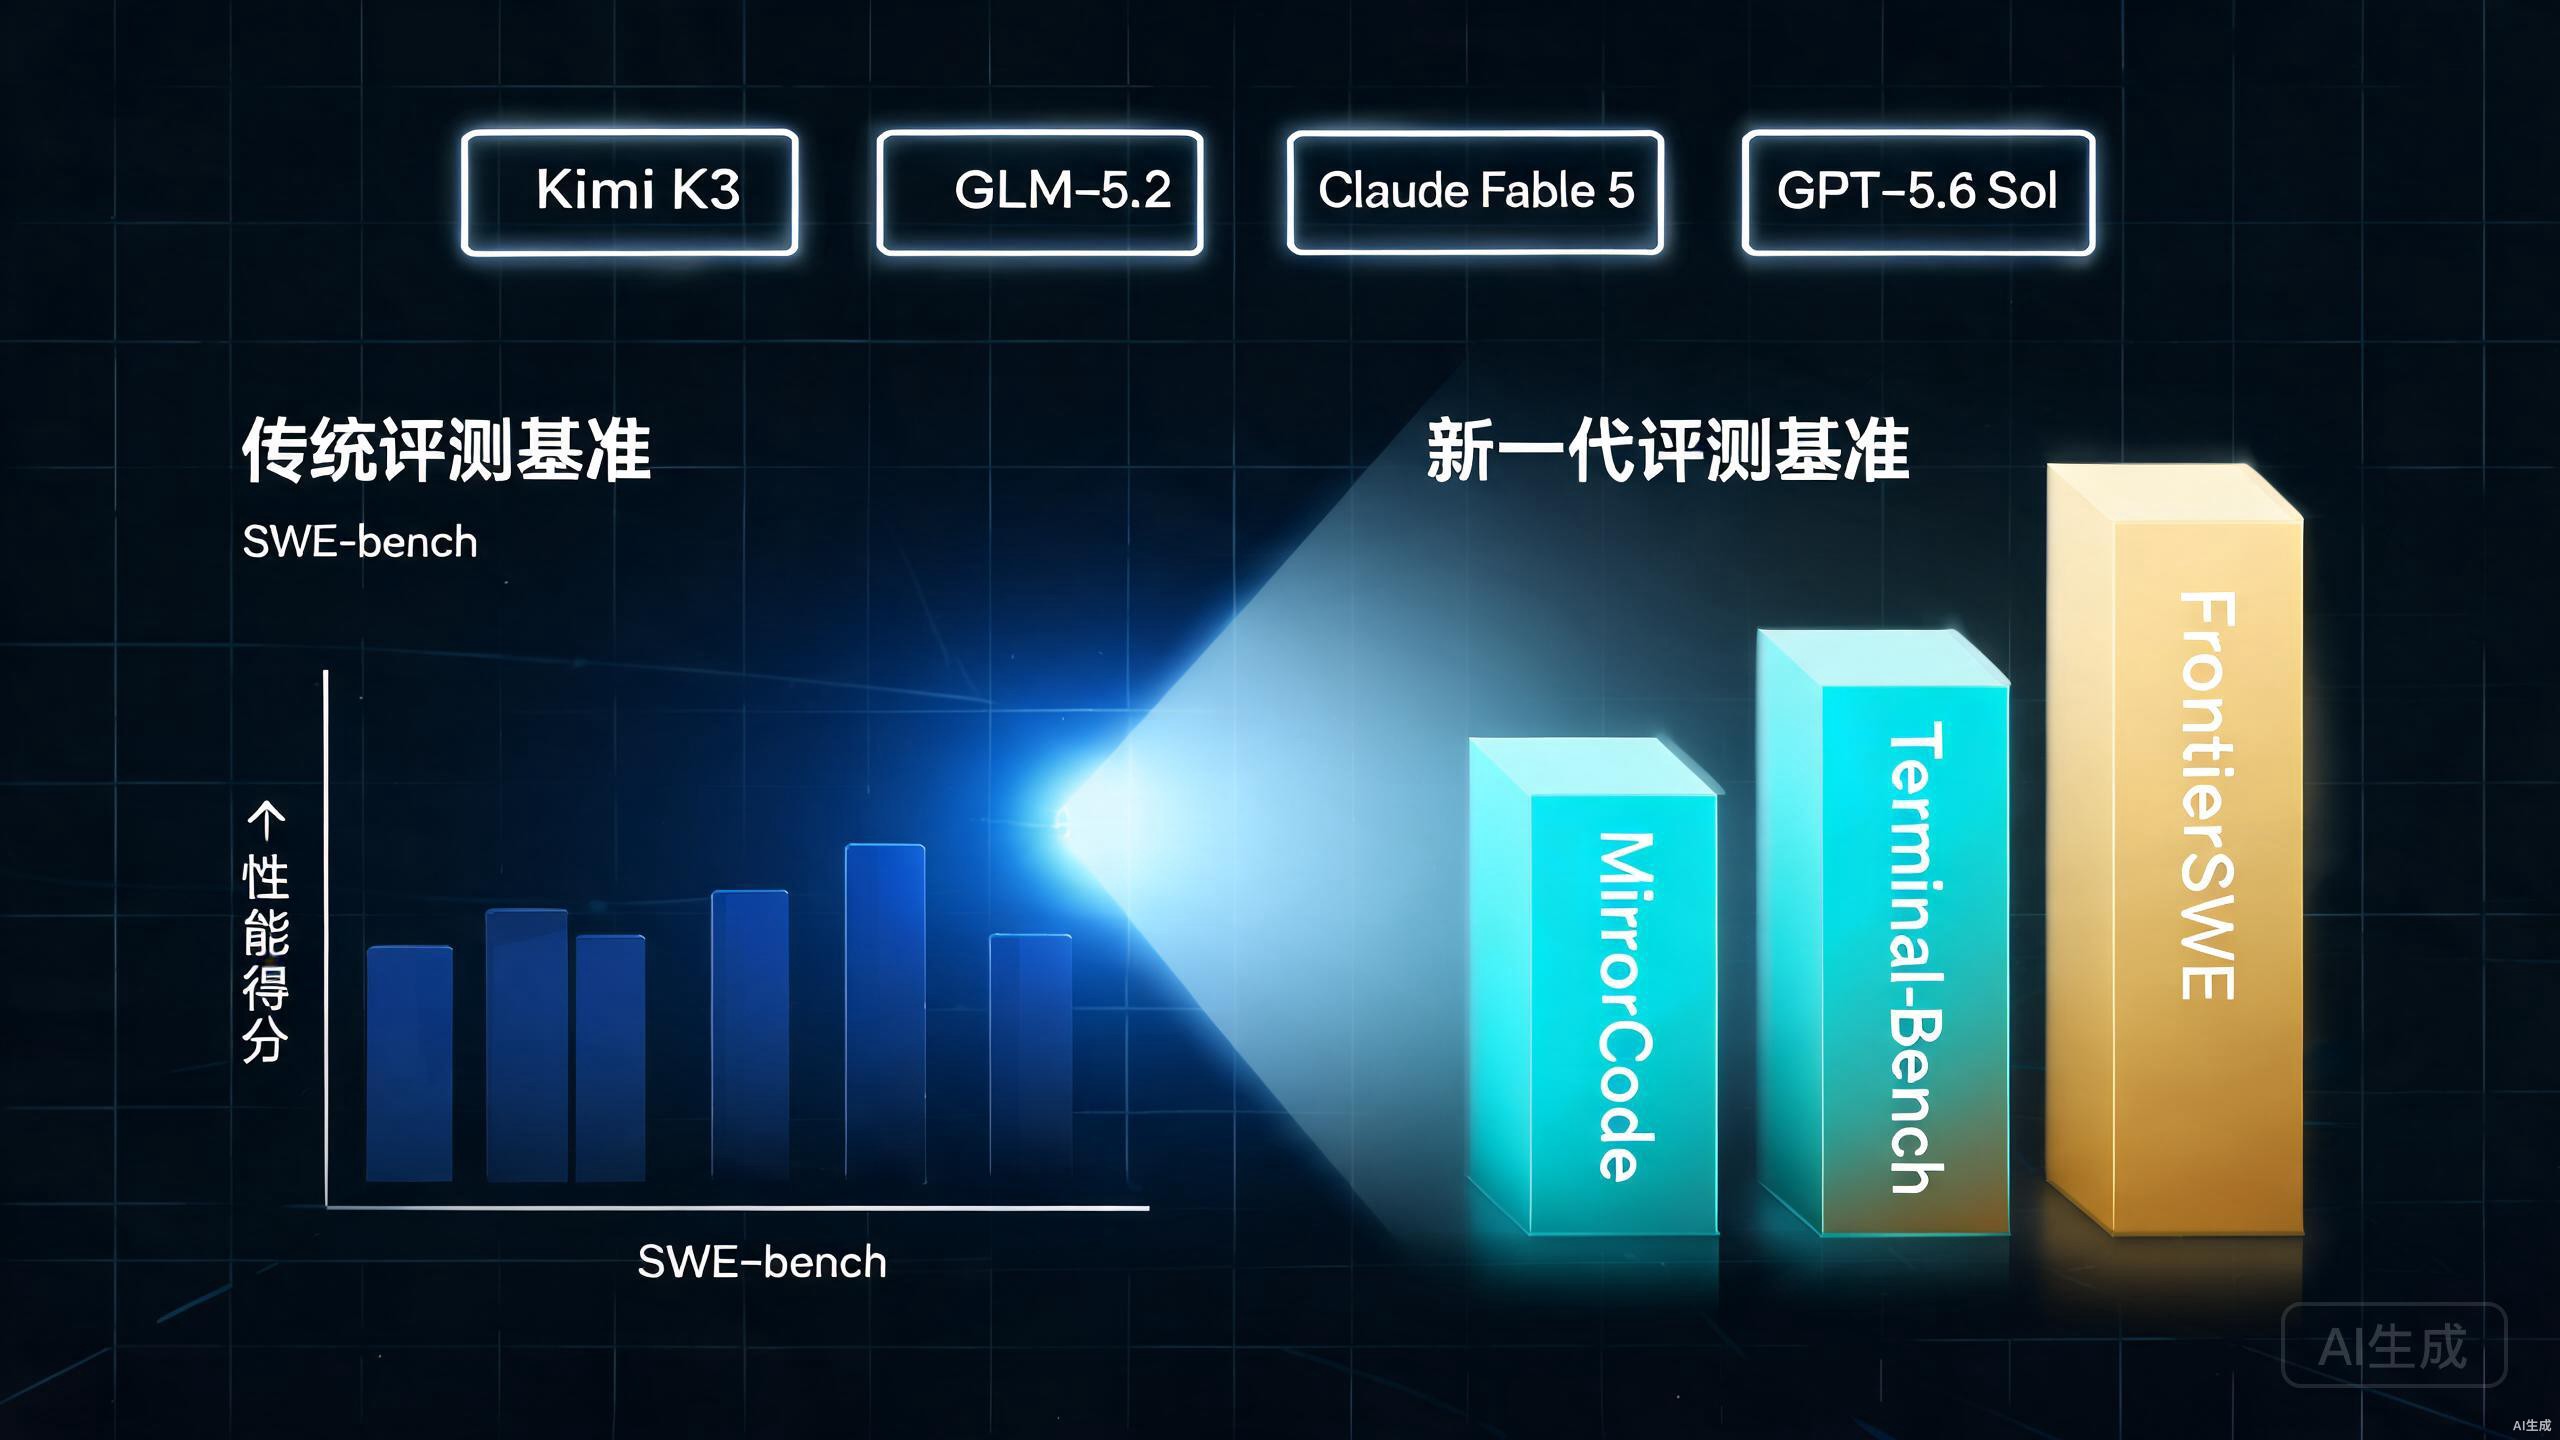
从SWE-bench到FrontierSWE:2026年AI编程基准评测的范式跃迁与差异化方向
当GPT-5.6 Sol在Terminal-Bench 2.1达88.8%,Claude Fable 5以80.3%领跑SWE-Bench Pro,VeriLoop Coder-E1以27B实现85.20 SWE-bench Verified——传统编程评测区分度正在消失。本文深度解析八大独特题型、实质差异判定和各领域差异化重点。