
MEDICAL DATA RESEARCH
运动损伤与重返运动数据集怎么建:动作视频、多模态对齐与分层验收
面向医疗AI研发与体育健康数据采购,拆解训练与比赛暴露、动作视频、生理信号、功能测试和康复记录如何按运动者与时间窗口对齐,并说明损伤标签、重返运动证据、专家仲裁、参考系统验证和分层外部验收的设计边界。
当训练负荷突然上升、睡眠和主观疲劳变差、动作视频出现落地不对称时,研发团队真正需要回答的不是“模型能不能给出一个风险分数”,而是:这些信号是否来自同一名运动者、是否处在同一个时间窗口、是否与一次被专业人员确认的健康事件有关,以及模型是否能在新的项目、设备和人群中重复工作。若动作视频、生理与训练记录只是分别存放,后续再用一个主键强行拼接,模型可能学到的是设备差异、队伍差异或记录习惯,而不是运动损伤或功能恢复的规律。
因此,运动损伤预警、康复过程评估和重返运动(return-to-sport,RTS)支持,首先是一个医学与运动科学数据设计问题,随后才是算法问题。一个可复用的数据集还可以向全民健身风险筛查、慢病运动管理、运动员长期发展和专项技术分析延伸,但这些用途不能共用一个含义模糊的“健康标签”。下文将把这类需求拆成可执行的数据规格,并说明如何把质量、偏差和验收写进数据产品本身。
先把“风险”“损伤”和“重返运动”分开
源需求通常同时提出四类任务。第一类是运动健康监测:以训练和比赛暴露为背景,关联外部负荷、心率或其他生理指标、睡眠、主观疲劳、功能测试和既往健康问题,识别需要进一步关注的时间段。第二类是康复阶段评估:把疼痛或症状记录、关节活动度、力量、动作对称性、跳跃或变向等功能任务,与康复阶段和随访结果按时间串起来。第三类是RTS决策支持:输出可核对的趋势、缺失项、异常动作和历史对比,供队医、康复师和教练共同判断,而不是自动宣布某人可以训练或比赛。第四类是专项表现与长期发展:标注比赛事件、动作阶段、骨骼点、关节角度和速度节律,用于教练和科研人员复盘;它与临床风险任务共享部分底座,却不应把“技术动作好”直接当成“医学上安全”。
损伤标签尤其需要先定义。国际奥委会共识建议,运动健康问题的记录应明确问题定义、严重程度、运动暴露、风险表达和数据采集方式,并区分更宽泛的健康问题、需要医疗关注的问题和导致无法完成训练或比赛的时间损失问题。1 这意味着“受伤”不能只是一个自由文本,也不能把一次自报不适、一次理疗、一次缺席和影像学确诊混成同一类。数据字典至少应保留问题类型、身体部位、组织或功能系统、发生机制、接触或非接触、首次事件与复发/加重关系、是否时间损失、医疗确认来源及观察窗口。对于慢性劳损或累积负荷相关问题,还要允许记录渐进性和混合机制,而不是被迫二选一。
RTS也不应被设计成单点二分类。运动物理治疗共识把重返运动视为与恢复和康复并行的连续过程,是临床人员、运动者和教练共同进行的风险管理,而非康复结束时的一次孤立决定。2 因此,较好的标签结构是“阶段+证据+决定”:阶段可包含日常活动、个体训练、部分训练、完整训练和比赛暴露等项目化定义;证据记录功能测试、动作质量、症状反应、心理准备、训练耐受及专业人员意见;决定记录当时的可参与范围、限制条件、复评时间和未满足项。在项目预先定义的观察窗内,模型可以尝试估计下一阶段风险或提示证据缺口,但不应取代专业人员的风险容忍度判断。
全民健康与慢病运动管理还要单独定义人群和结局。面向普通健身者或基层服务时,数据可以支持运动功能筛查、劳损关注提示和随访趋势展示;“适宜/不适宜某种运动”若没有明确医学规则和专业复核,不应作为自动标签。青少年和未成年人数据还涉及更高的隐私、授权和监护要求。选材育才则应以阶段性体测、训练经历、比赛表现和后续培养记录形成纵向档案,输出趋势和复盘材料,不把有限的历史记录包装成自动预测发展潜力的结论。
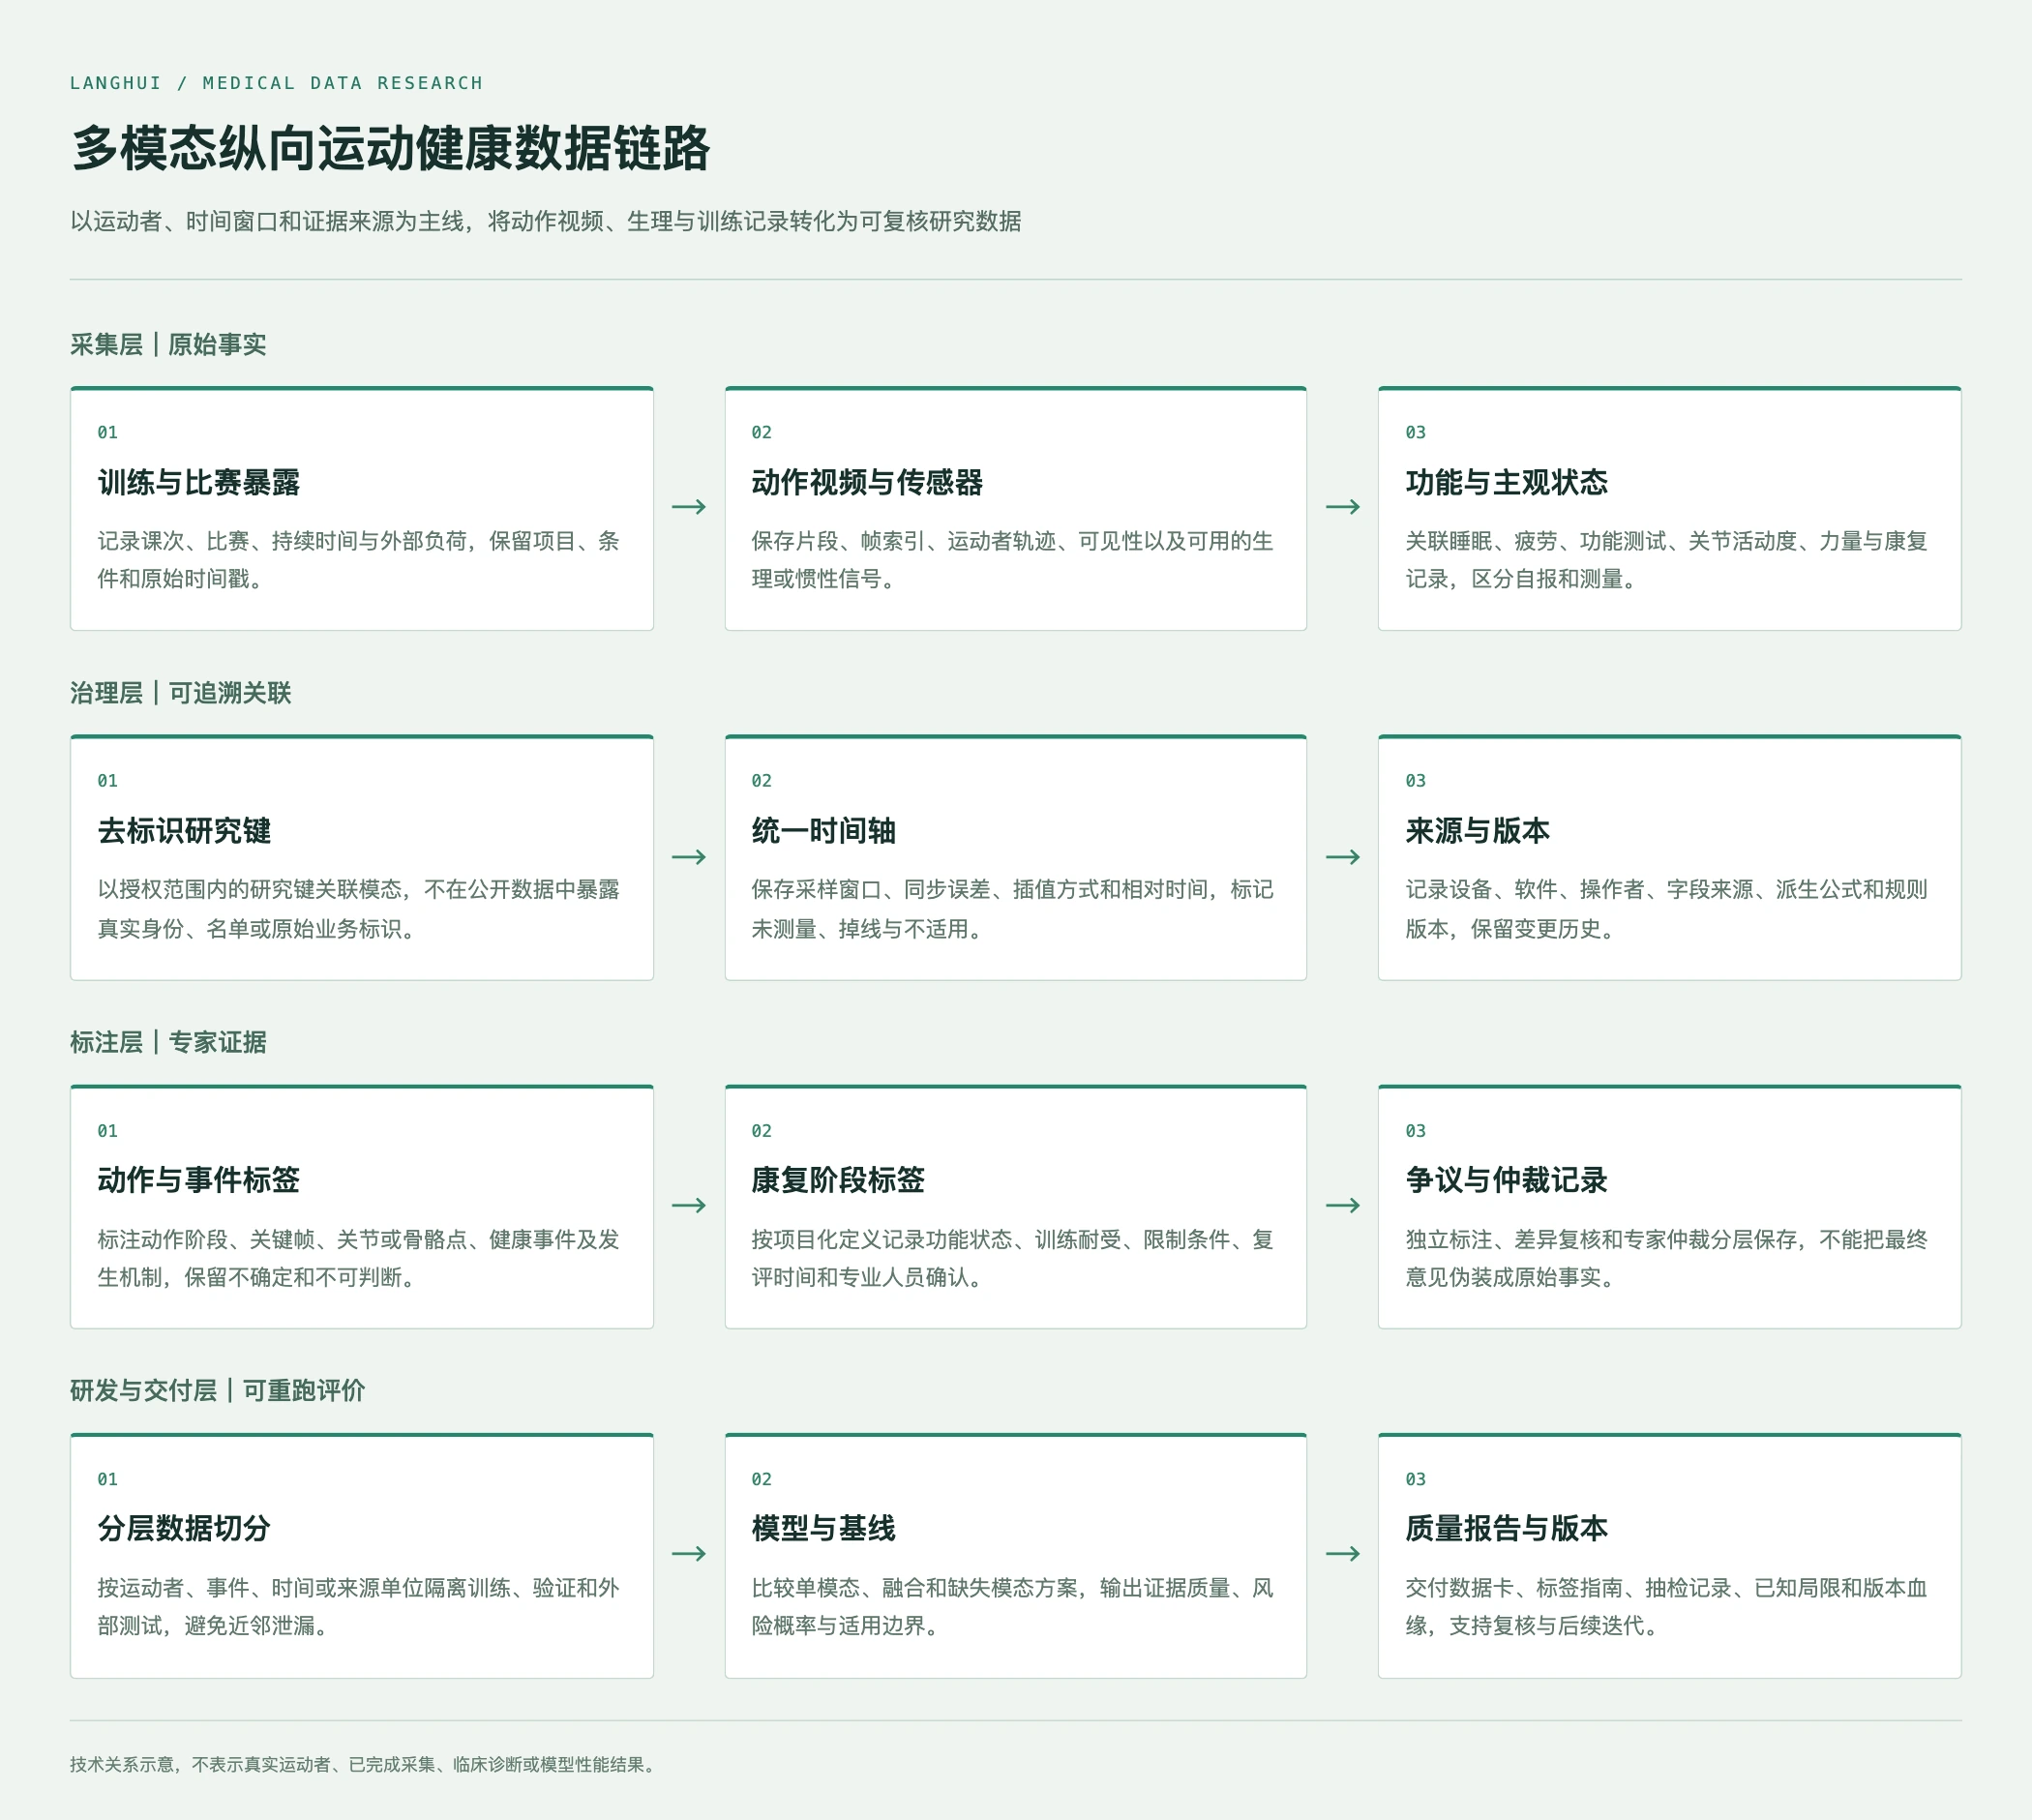
图1 技术示意:多模态纵向运动健康数据的对象、时间、标注和评价链路;不表示真实运动者、已完成采集或临床结论。
数据单元不是“一个视频文件”
这类项目最小数据单元应根据任务定义。对损伤监测,可以是“运动者—暴露日—观察窗口—健康事件”;对康复,可以是“运动者—康复阶段—功能评估时点”;对动作分析,可以是“运动者—动作试次—视频片段—事件或关节序列”。同一原始视频可能包含多个动作、多人或多个事件,不能只按文件计数。每个单元都需要一个去标识化的研究键、采集时间、运动项目、任务条件、设备与软件版本、操作者或来源类别、授权状态和数据质量状态。研究键应能在授权范围内关联不同模态,但公开交付的研究表不应暴露真实身份或可回溯的业务名单。
时间对齐是多模态数据的核心工程。训练负荷可能按课次或日累计,视频按帧或片段记录,惯性传感器按高频采样,睡眠和主观疲劳按晨晚问卷,血液或生理生化指标则只有少数采样时点。系统应分别保存原始时间戳、统一时间轴、采样窗口、时区或相对时间、同步误差和插值方式。任何由规则派生的急性/慢性负荷、滚动均值、动作对称性或阶段判定,都要保存公式、输入字段、窗口长度和版本。缺失不能简单填成零:未测量、设备掉线、受试者未完成、该时点不适用和数据被质量规则剔除,应有不同的缺失语义。
视频侧可包含原始片段、帧级时间索引、人物轨迹、动作事件、二维或三维骨骼点、关键关节角度、速度节律、遮挡和可见性标记。对于集体项目,还需要把运动者ID、比赛阶段、球或器械事件、攻防状态等上下文与轨迹分开存储,否则模型容易把镜头切换或队服颜色当成动作特征。生理与训练侧可包含外部负荷、心率相关指标、主观疲劳、睡眠、功能测试和康复记录,但必须写清测量单位、参考协议、设备校准和异常值处理。文本侧应保留来源类型和时间,而不是只保留一个经清洗的结论句;“专家确认”“运动者自报”“自动派生”和“研究者复核”应在字段层面区分。
纵向关联要防止两类错误。一类是身份错配,例如同名、换号、临时账号或跨系统重复建档导致把不同人的数据拼在一起;另一类是时间错配,例如把伤后测试当成伤前基线,把复训后的训练负荷泄漏到预测时点。工程上应使用可追踪的关联表,记录来源键、目标键、关联规则、匹配置信度、人工复核结果和变更历史。对同一运动者的多次事件,要保存事件之间的关系,区分首次发生、同部位不同组织、同类型复发和未完全恢复时的加重。这样做不仅服务训练,也让后续研究能回答“预测的是首次事件、复发,还是恢复过程中的波动”。
标注要分层,专家要对不同问题负责
动作视频标注和医学事件标注不是同一种工作。视频标注员可在培训后完成运动者框、轨迹、动作起止、关键帧、可见性和初步姿态标签;运动生物力学或专项专家负责动作阶段、技术事件和指标解释;运动医学或康复专业人员负责健康问题定义、功能状态、康复阶段、限制条件和RTS相关证据。教练或专项科研人员可以对技战术或表现事件给出语境,但不能替代医学人员作出伤病确认。不同层级的判断应在元数据中分开,避免把最终仲裁者的意见伪装成原始事实。
标注指南需要先固定对象、层级和边界。帧级标签适合可见关键点、遮挡、动作阶段和事件起始;片段级标签适合一次跳跃、变向、投掷或技术组合;试次级标签适合动作完成质量、是否有效和任务条件;时间点或事件级标签适合疼痛、功能测试、训练暴露和临床确认。若任务需要关节角度、骨骼点或对称性,必须约定左右侧、坐标系、参考姿势、单位、滤波方式和不可测区间。若任务需要风险标签,则应明确预测时点之后多长时间发生事件、事件是否允许多次、观察结束前失访如何处理。
质量控制不应只有一个总体一致率。可把一部分样本交给两名标注者独立完成,计算分类标签的一致性,并对连续量报告绝对误差、相关或一致性分析;对争议样本记录争议原因、专家仲裁和规则是否更新。需要保留“不确定”“不可判断”“画面不足”和“设备异常”类别,不能强迫标注者在证据不足时选择阳性或阴性。对于高风险事件,建议设置临床专家盲审和回看机制;对于视频,盲审时要避免让审核者看到可能泄漏标签的文件名、后续报告或模型输出。
算法路线:从可解释基线到多模态融合
第一阶段应建立可复现的基线,而不是一开始就训练一个不可拆解的大模型。视频侧可先做人物检测、跨帧跟踪和姿态估计,再从骨骼点或关节轨迹计算动作阶段、活动范围、速度、左右差异和可见性。多模态姿态研究表明,复杂运动中会同时遇到遮挡、多人交互、时序变化和不同数据流可靠性不一致的问题,视频与传感器融合需要显式处理这些问题,而不是默认每种模态同样可信。4
第二阶段再选择时序模型或图结构模型,学习“动作—负荷—功能—健康事件”的关系。对动作序列,时序卷积、循环模型、时空图网络或Transformer都可以作为候选,但模型选择应服从样本量、标签密度、计算资源和可解释性要求。对训练负荷、睡眠、主观疲劳、力量和既往事件,可以使用结构化特征与时间窗建模;对临床文本或专家规则,可先转为可追溯的结构化字段。所谓多模态融合,不应只是在最后一层把所有向量拼接起来,还要保留每个模态的时间范围、质量权重和缺失状态。
第三阶段加入模态缺失和不确定性设计。真实场景中,视频可能被遮挡,传感器可能掉线,问卷可能漏填,生理检测可能只在部分时点完成。模型应能在缺失模态下给出“证据不足”或降级输出,并同时报告输入完整性、关键模态质量和预测不确定性。可比较早期融合、晚期融合和带门控的融合策略,但每种方案都要设置“只用视频”“只用结构化数据”“去掉某一模态”等消融对照,判断增益是否来自真实互补,而不是数据泄漏或样本数量差异。
预测任务的标签不平衡尤其严重。运动者多数时间处于未受伤状态,同一事件也可能跨多个记录窗口。研究中可以使用加权损失或仅在训练集内进行过采样,但不能让同一运动者的近邻时间点同时出现在训练和测试中。精英青少年足球监测研究显示,多工具采集在实际训练环境中可以实施,但样本中伤病事件少时,模型可能出现较多假阳性,研究结果不能直接转换成保护运动者的自动指令。3 因此,风险模型应输出概率、预测窗口和触发原因,供专业人员复核;“高AUC”也不等于减少伤病或改善康复结局。
验收要看数据可用性,也要看临床外推
数据层验收应先于模型验收。第一项是来源与授权:每个文件、记录、标签和派生变量都应能回溯到允许的来源和处理版本。第二项是结构完整性:研究键、时间戳、模态关系、单位、左右侧和版本字段齐全,缺失原因可区分。第三项是对齐质量:抽样检查视频事件与传感器、功能测试、负荷记录是否在规定窗口内对应,不能只验证文件能否打开。第四项是标签质量:抽样回看专家确认、争议记录、仲裁结果和不确定标签。第五项是安全与交付:去标识化后的数据、派生骨骼点和视频截图仍可能包含生物识别线索,应按用途限制访问、留存和再分发。
动作数据要用参考系统验证,而不是凭“看起来顺滑”验收。2024年的OpenCap验证研究在有前交叉韧带重建史的运动者中比较无标记系统与光学动作捕捉,在矢状面膝髋关节任务上取得较高一致性,但额状面和横断面一致性较低,且研究报告了关节角度的平均绝对误差和均方根误差。8 2025年另一项高强度跳跃验证也提示,膝和踝的部分参数可以较好估计,但髋部参数仍需要进一步验证。5 这对采购规格的启示是:应按动作、关节、平面、设备和人群分别设定误差口径;不能把某个任务上的结果外推到所有项目,也不能把实验室参考的一致性写成临床有效性。
预测模型验收应包括区分度、校准、临床工作流相关的阈值表现和外部验证。运动损伤机器学习综述显示,不同研究在运动项目、队列规模、损伤定义、预测窗口和标签来源上差异很大,若只比较AUC,很难判断模型是否有实际临床意义;综述还指出,小样本和方法异质性是限制解释的重要原因。6 因而,项目应预先规定阳性事件定义、预测提前量、敏感度和阳性预测值的使用场景,并报告假阳性负担、阴性漏报、校准曲线和不同阈值下的决策影响。若主要目标是康复趋势,还需报告纵向误差、最小可检测变化和不同阶段的稳定性,而不是套用一次性分类指标。
数据划分必须在运动者、事件或来源单位层面隔离。随机按帧或按记录切分会把同一人的动作风格、同一场馆背景和相邻时间点泄漏到测试集,造成虚高结果。建议把内部验证、时间外验证、设备外验证、项目外验证和来源外验证分别列出;对性别、年龄段、竞技水平、运动项目、伤病史和动作条件报告分层结果。TRIPOD+AI要求预测模型研究完整、透明地报告数据、方法、评价数据和模型表现,并强调评估数据不应与训练或调参数据在参与者层面重叠。7 这套要求同样适合运动健康数据产品的验收记录。
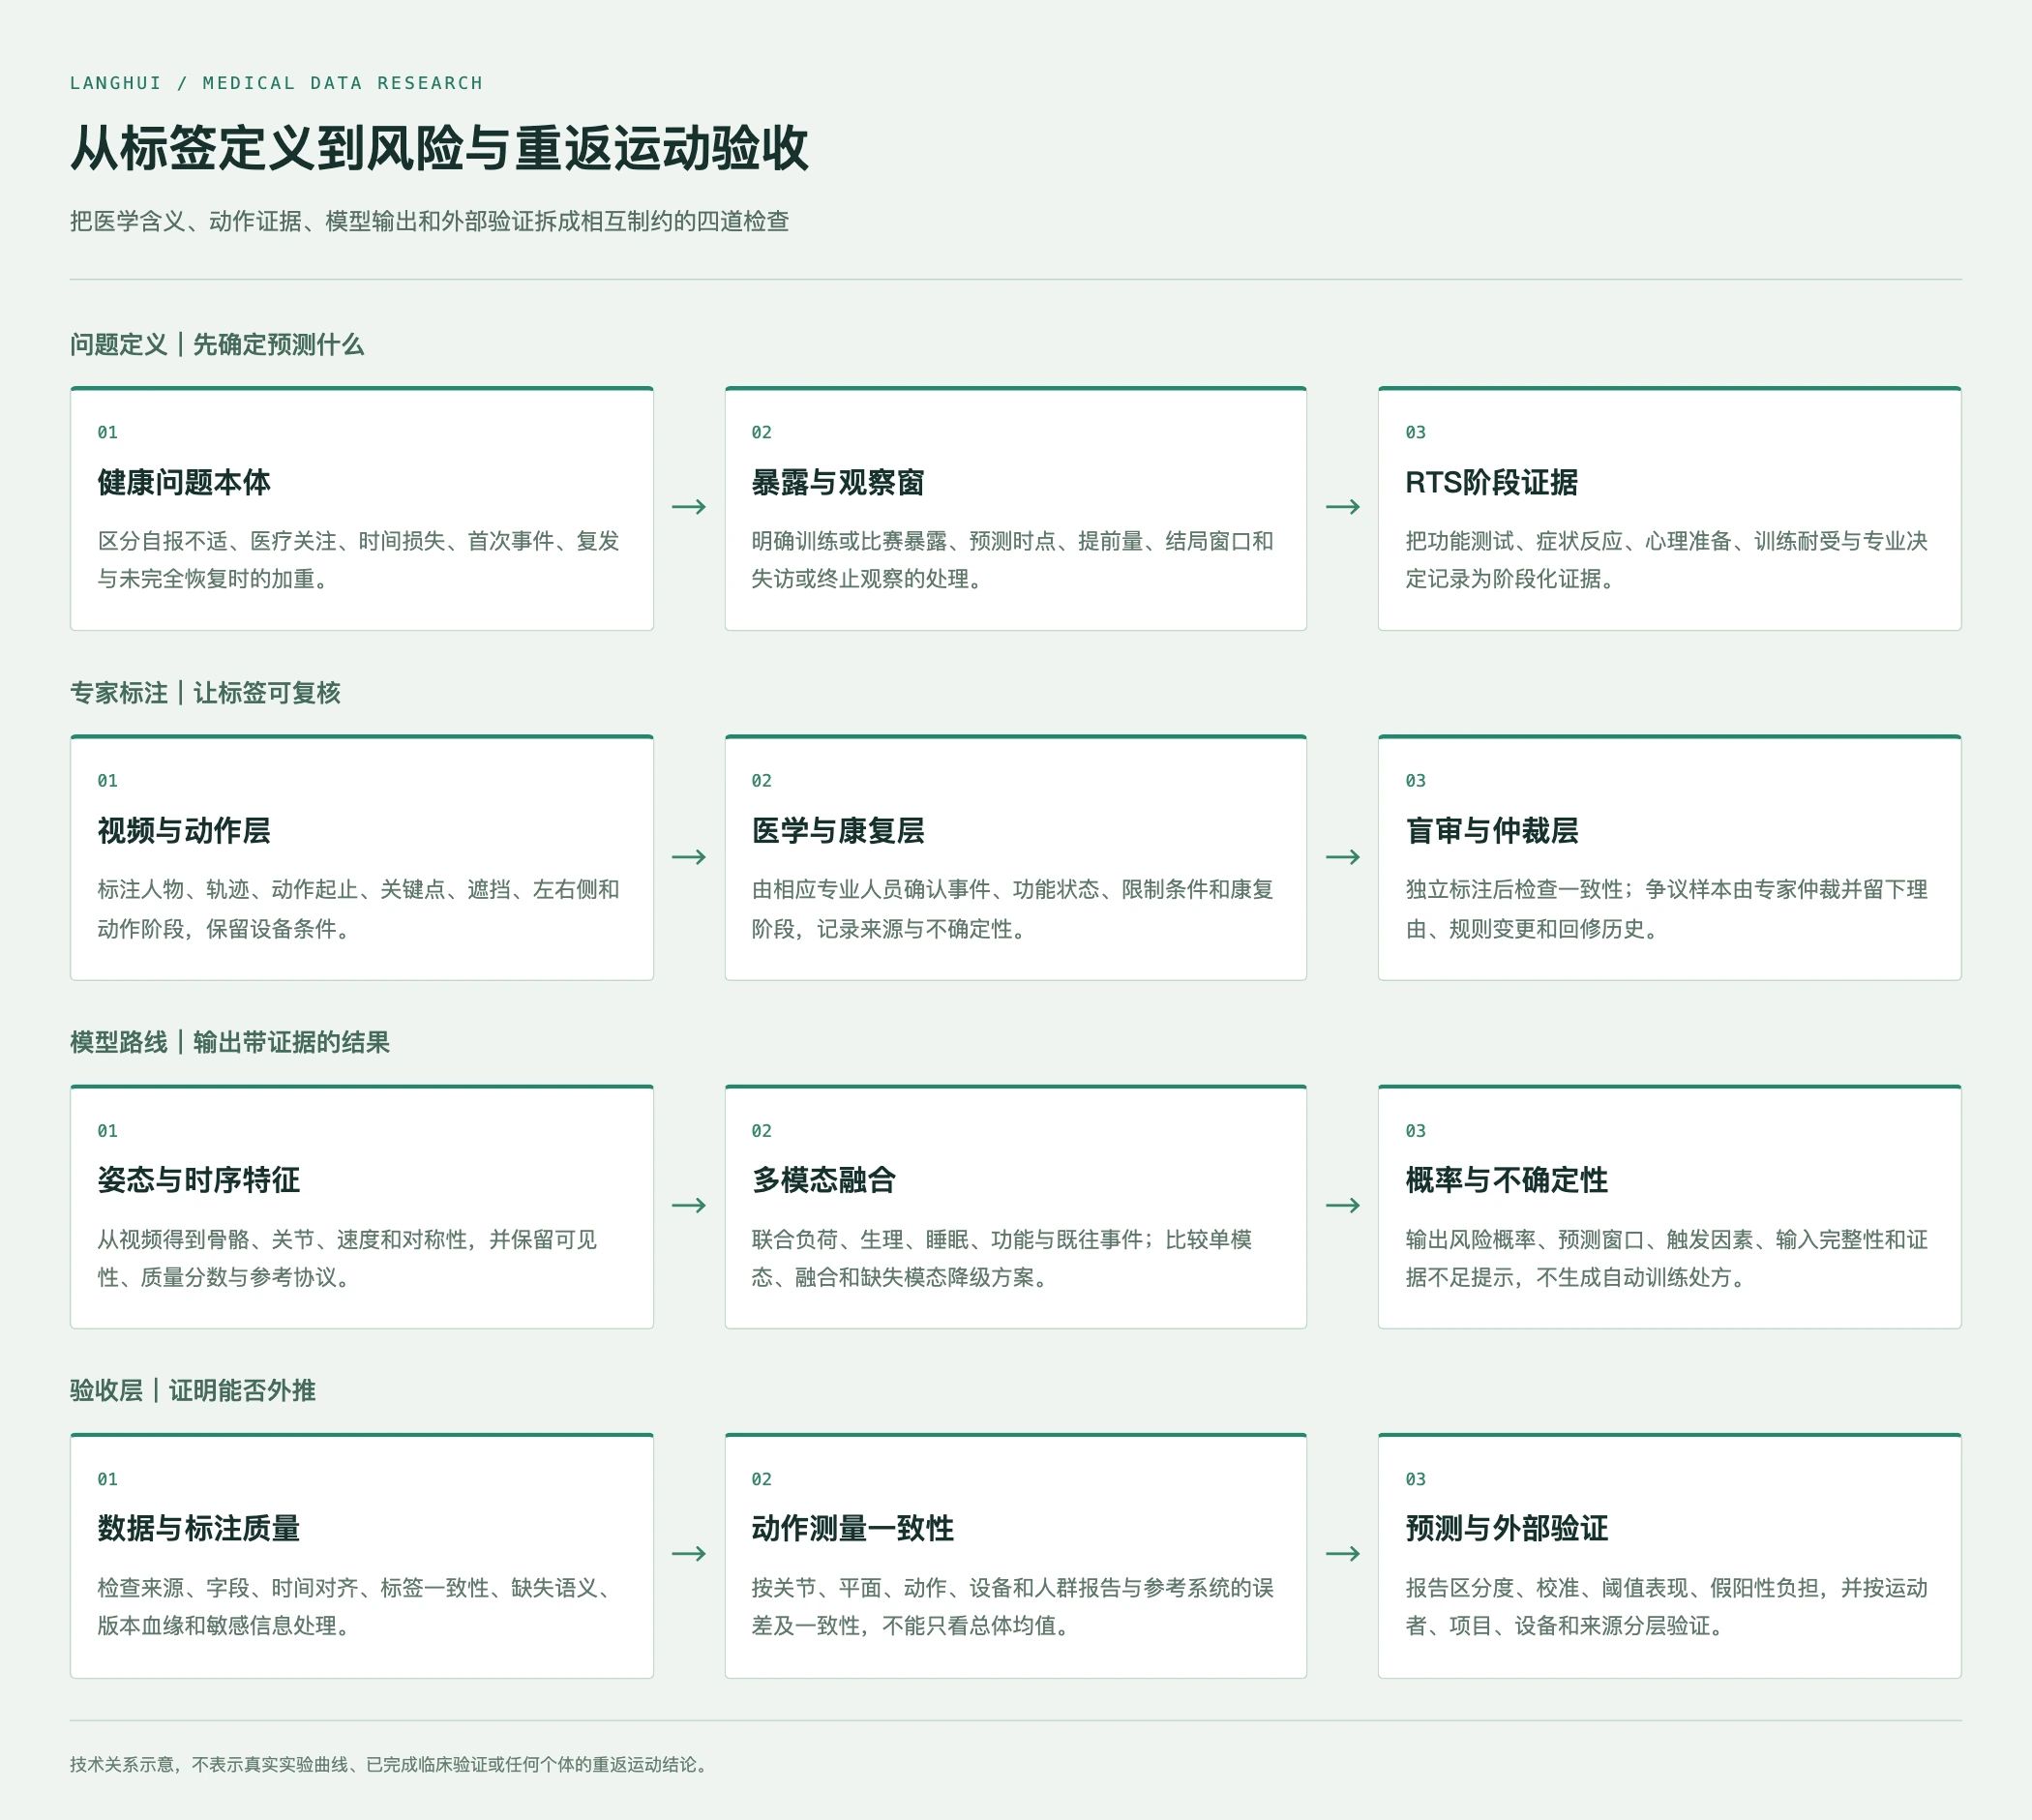
图2 技术示意:运动损伤与重返运动数据集的标签、融合模型和分层验收关系;不表示真实实验曲线或已取得的性能。
让业务逻辑服务于可复核的研发闭环
一个可实施的交付可以分成四个相互衔接的包。第一是数据产品定义包,包含任务边界、目标人群、样本单元、字段字典、标签本体、时间窗口、缺失语义、授权与使用限制。第二是试采和试标包,选择少量、脱敏且授权清楚的样本验证设备同步、视频质量、动作协议、专家可判定性和争议类型。第三是生产与质检包,记录预处理、标注、复核、仲裁、返工、版本和问题关闭;自动检查可以覆盖格式、时间戳、范围和跨表关联,专业抽检则关注边界病例和高风险标签。第四是研发与验证包,冻结训练/验证/外部测试版本,交付数据卡、质量报告、基线代码或可重跑说明,以及已知局限。
在此链路中,数据服务商的价值不是把“预测损伤”包装成现成产品,而是把需求转换为可执行规格和可审计数据。朗慧已核验的定位是AI数据基础设施与流程服务商,LangData覆盖采集、处理、标注、质检和数据交付;医疗栏目提供按部位、模态和任务组织的数据目录与样例评估入口。基于这些已核验边界,可以支持项目化的需求澄清、样例评估、医学标注流程、数据卡、质量记录和版本交付,但不能据此宣称已经拥有某一运动项目的现货数据、固定专家规模、临床验证结果或可直接部署的运动损伤模型。体育专业人员、队医和康复师的参与,应在具体项目中按任务和授权逐项确认。
业务上最稳妥的路径是先用一个窄任务试点闭环,例如限定一种动作协议、一个观察窗口和一个明确的功能结局,再逐步增加模态和人群。试点通过后,才讨论跨项目、跨设备或跨层级的扩展。每次扩展都应重新检查数据分布、标签可迁移性、同步误差和外部验证成本。对于动作分析、选材和全民健康,建议建立共享元数据和安全底座,但按应用分别冻结标签和验收集;这样既能复用采集与治理能力,也不会把表现评价、健康筛查和医学决策混为一谈。
结语:把“智能预警”还原成证据链
运动损伤与康复数据集的研发价值,不在于堆积视频、传感器和表格,而在于把一次运动暴露、一段动作、一项功能测试、一个健康事件和后续结局放在同一条可追溯时间线上。只有先定义标签的医学含义,再处理对象和时间关联,经过不同专业主体的独立标注与仲裁,最后用按运动者、设备、项目和来源隔离的测试来验证,风险提示才有可能成为可复核的研发工具。
对于RTS,系统最有价值的输出往往不是一个“可以/不可以”,而是哪些证据已经满足、哪些模态缺失、哪些动作或功能趋势发生改变、结果适用于什么人群,以及何时需要由专业人员重新判断。对于全民健康和慢病管理,提示应保持筛查与辅助边界,不替代诊疗或强制运动处方。本文讨论的是经授权的研究数据设计、标注与验收逻辑,不构成医疗器械性能声明、临床效果结论或个体重返运动决定。把这些限制写进数据字典、标注指南、模型输出和验收报告,既是医学严谨性的要求,也是多模态AI真正进入运动健康场景前必须完成的工程工作。
参考来源
- International Olympic Committee consensus statement: methods for recording and reporting of epidemiological data on injury and illness in sport 2020
- 2016 Consensus statement on return to sport from the First World Congress in Sports Physical Therapy, Bern
- Predicting Injury and Illness with Machine Learning in Elite Under-18 Academy Soccer Players
- Multimodal fusion approach for sports injury prevention and pose keypoint detection
- Comparison of lower limb kinematic and kinetic estimation during athlete jumping using marker-based and markerless motion capture systems
- Machine learning approaches to injury risk prediction in sport: a scoping review with evidence synthesis
- TRIPOD+AI statement: updated guidance for reporting clinical prediction models that use regression or machine learning methods
- Validation of OpenCap: A low-cost markerless motion capture system for lower-extremity kinematics during return-to-sport tasks