
MEDICAL DATA RESEARCH
乳腺 CT 模型如何做独立评测:从分层数据到版本上线门槛
围绕乳腺CT风险筛查模型的独立评测,拆解协议分层、病例级证据、DICOM脱敏、双模型公平比较、专家复核、外部验证与版本上线闸门,区分研究评测与临床诊断边界。
当两个乳腺风险筛查模型都声称“已经训练完成”,真正难的不是再找一个总分,而是回答三个可复核的问题:同一批病例是否真的对两个模型公平,层厚和剂量变化是否被单独测量,模型发布新版本前怎样证明它没有在某一类人群或某一种采集协议上悄悄退化?这要求测试集不再只是影像文件的集合,而要成为一套冻结、可追溯、能解释失败原因的评测系统。
本文围绕乳腺 CT 风险筛查的匿名技术需求,拆解独立测试集的任务边界、数据结构、证据分层、专家复核和上线验收。文中不复述任何具体项目的来源、病例或商业条款,也不把测试集上的研究结果写成临床效果。现有乳腺钼靶、乳腺超声文章主要讨论投照视图、病灶标注或一般性数据价值;乳腺 CT 的协议分层、病例级独立比较与版本闸门,需要另行建模。
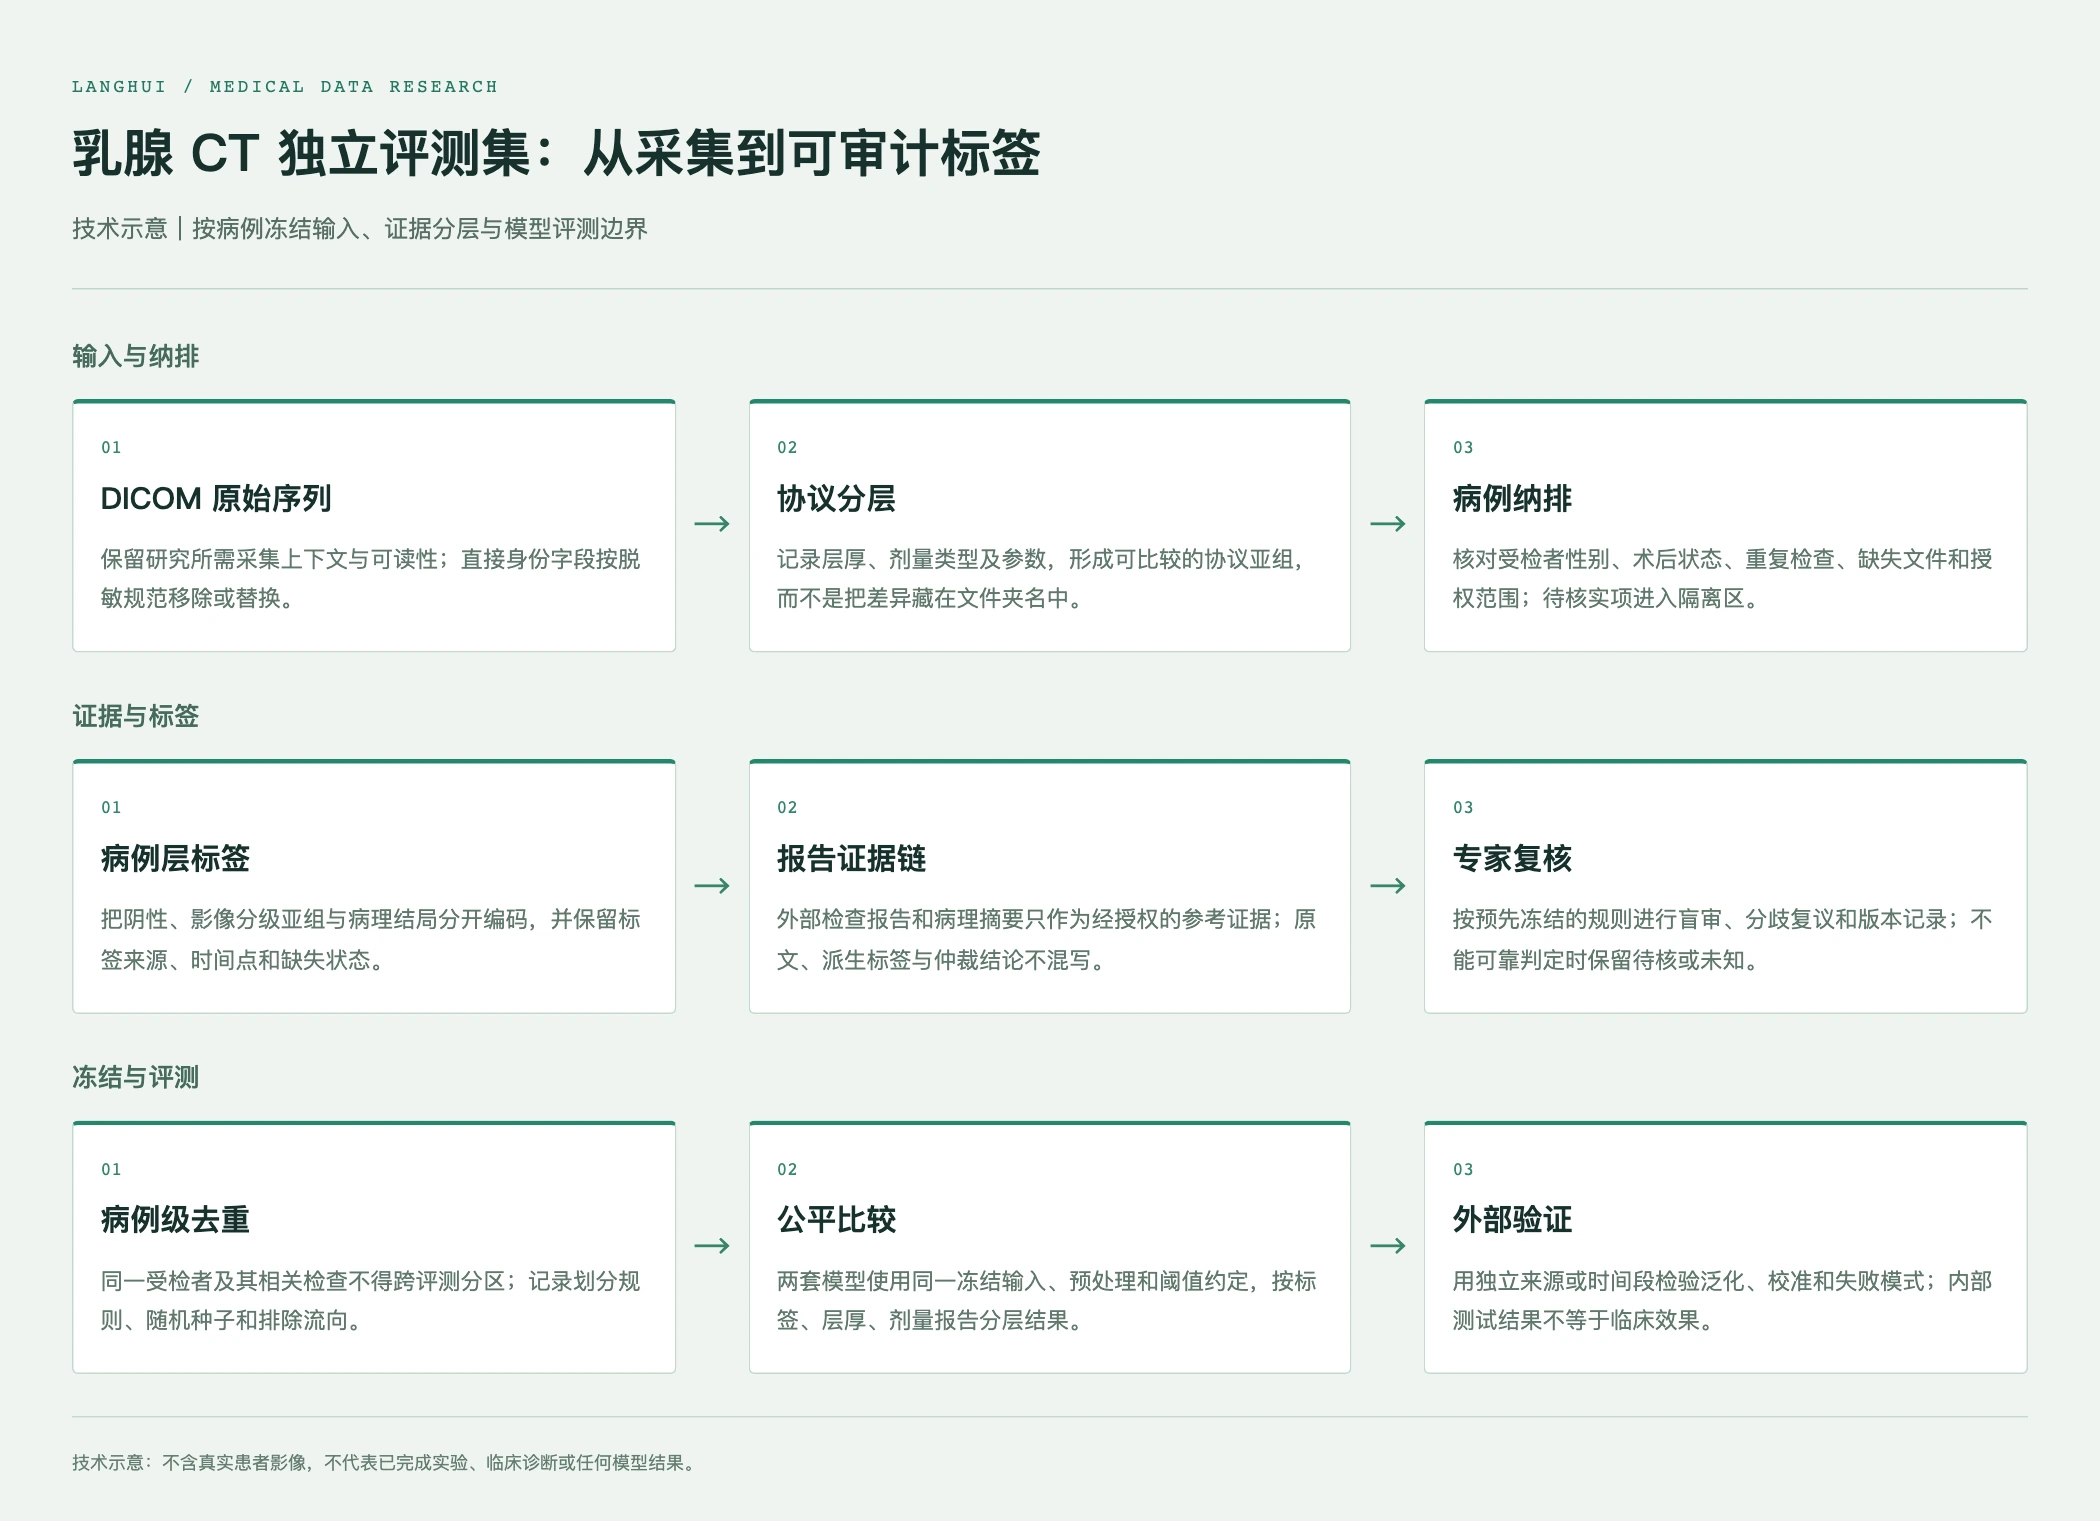
图1 技术示意:乳腺 CT 测试集从 DICOM 入库、证据分层到模型独立评测的关系;不含真实患者影像,不代表已完成实验或临床诊断。
一、先把“风险筛查”拆成可测的临床任务
需求中的“验证乳腺风险筛查模型”不能直接作为标签。首先要写清模型到底输出什么:是病例级的阴性/阳性二分类,是按影像分级划出的风险层,还是在一个病例中先定位病灶、再给出风险分数。三种任务的输入单位、参考标准和统计指标都不同。若模型输出的是病例级风险,评测主键应是受检者或一次预先定义的检查,而不是一张切片;若模型还输出病灶位置,位置字段必须明确是索引属性、矩形框、轮廓还是三维体素标注,不能把“左乳/右乳/双侧”误写成精确分割结果。
在这类测试集里,层厚与剂量不是附属信息,而是要被主动设计的挑战维度。较薄与较厚的重建、正常与低剂量采集,可能改变噪声、空间分辨率、部分容积效应和模型可见的纹理。如果只把所有病例混在一起计算一个总体准确率,模型对协议差异的脆弱性会被平均掉。更稳妥的做法是把每个病例的层厚分组、剂量类型和可核对的参数写入索引,并在总体结果之外报告各亚组的区分能力、校准、错误类型与置信区间。
“公平比较”还意味着两个模型不能拿到不同的预处理、不同的缺失处理或不同的阈值选择。评测前应冻结 DICOM 读取、重采样、窗位窗宽、裁剪范围、左右方向和无效序列的处理方式;若某模型必须使用额外字段,则应在方案中公开并允许另一模型获得同等输入。测试集不应在模型调参期间反复被查看,否则它会逐渐变成验证集,最终的上线分数不再代表独立评测。
二、队列设计:把病例构成和真实用途分开
需求将病例分成阴性、影像分级较高、影像分级较低以及病理确认等层级,这种设计适合检验模型能否区分不同证据状态,但不能直接当成真实筛查人群的患病率。人为平衡亚组有助于比较模型,却会改变阳性预测值、阴性预测值和决策阈值的解释。因此,数据卡应同时写出两件事:第一,评测集为何采用分层配额;第二,结果若要映射到某一筛查人群,还需要什么外部流行病学分布和独立验证。
这里还必须先解决“乳腺 CT”的模态定义。原需求没有说明它是专用乳腺 CT,还是覆盖乳腺的常规胸部 CT,也没有完整给出增强状态、扫描范围和重建方案;这两类影像的可见结构、剂量语境和参考证据并不等价。项目入组前应冻结设备类型、覆盖范围、是否增强、层厚与重建参数,并在索引中保留来源,不能因为都写作 CT 就把专用乳腺 CT 研究结果外推到常规胸部 CT,或反向使用。
阴性病例尤其需要谨慎。一次其他检查未见可疑发现,不等于已经排除了所有后续疾病;影像分级也不是病理真值。相反,病理确认能够为一部分阳性病例提供更强的参考标准,但它通常只覆盖接受进一步检查的人群,容易引入验证偏倚。测试集可以保留这些不同来源的证据层级,但不能把它们在入库时压缩为一个没有来源的“真值”。每个病例应记录标签来自何种检查、何时形成、是否经过专家复核,以及报告缺失、冲突或时间间隔过大时如何处理。
公开研究也显示,CT 评估乳腺组成时,与乳腺 X 线摄影之间可能出现中等一致性,而微小钙化在某些专用乳腺 CT 研究中并不如摄影清晰。1 这不意味着某一种模态必然优于另一种,而是说明参考证据的可比性不能靠名称推断。将其他模态报告作为标签依据时,应把“检查发现”“影像分级”和“病理结果”分开存储,并明确它们是输入之外的参考证据,不是模型可见的特征。
三、DICOM 完整性与脱敏并不是一回事
原始 DICOM 交付有助于保留层厚、剂量、重建、方向和 UID 关系,但“完整 Header”不能理解为保留所有身份字段。DICOM PS3.15 明确指出,属性保密配置并不能保证整个信息对象已经完成去标识化,脱敏还需要结合共享目的、接收者和再识别风险进行过程设计。3 因而,验收条款应改写为“研究所需采集上下文和引用关系完整,直接身份信息按批准的脱敏策略移除或替换”,而不是要求把患者姓名、检查地点或内部编号原样保留。
脱敏检查至少包含三层。第一层是结构化字段:患者标识、日期、机构、操作者、检查号和私有标签需要按规则清理,并保持同一病例内替换 UID 的一致性。第二层是像素和图形:烧录在影像中的姓名、检查号、工作站叠加文字或图形不能因为 Header 已清理就被视为安全。第三层是索引和报告:病例编号、StudyInstanceUID、报告文本和病理摘要之间的对应关系要可回溯,但回溯键不能暴露真实身份。DICOM 官方规范还提醒,像素中的识别信息需要专门的清理选项或人工核查;这应当进入机审和人审的责任分工,而不是只写在数据说明里。
性别、术后状态和剂量参数属于任务所需的临床或采集字段,可以在获得授权且有明确用途时保留为分层变量;但它们不应成为公开文章中的病例线索。术后影像是否排除、两侧乳腺是否都必须可见、重复检查如何去重,都应在版本化的纳排规范中冻结。对于缺失字段,不能用文件名猜测,更不能把“未记录”改成正常剂量或阴性。
四、标签工程要区分观察、证据和派生结论
一个可复用的索引至少需要影像级、检查级、病例级和审计级四层。影像级记录文件可读性、方向、层厚和剂量;检查级记录检查时间点、序列关系和是否重复;病例级记录阴性或阳性亚组、影像分级、病灶侧别及参考证据;审计级记录初审者、复核者、争议、修改原因、规范版本和导出版本。层级之间通过内部一致的病例—检查—序列关系连接,避免把一项检查的报告错误挂到另一项检查上。
标签字典要先规定语义,再规定格式。例如“阳性”可能是模型训练需要的二分类派生字段,也可能是某次影像检查中的异常观察;“BI-RADS 大于等于某级”是分层规则,不应伪装成组织学确诊;病理结果是另一类证据,不能覆盖原始影像报告。建议同时保留原始文本的脱敏版本、结构化字段、派生映射规则和专家最终采用的标签,并给每个字段加上“来源”“时间点”“证据强度”和“缺失原因”。这能让算法团队在更换终点时重新利用数据,而不是重新猜测标签如何形成。
专家标注的重点不是把所有争议强行改成确定答案。初审可以完成病例归类和字段提取,资深复核检查报告与标签是否一致,独立仲裁处理分歧;无法依据授权材料可靠判断的病例,应标为待核、未知或排除,并保留原因。若采用多数意见,也要记录参与者、盲审方式、规则版本和未达成一致的比例。CLAIM 2024 更新版把数据来源、纳排条件、脱敏、采集协议、参考标准、标注者资格、标注者间变异、数据划分和外部测试都列为可复现报告要素。4 这套思路比单独宣传“三级审核”更能解释质量从何而来。
五、从“两个模型比一比”到可解释的统计方案
公平评测不能只报一个准确率。对于二分类风险输出,至少应预先规定区分能力、灵敏度、特异度、阳性和阴性预测值、校准以及不同阈值下的混淆矩阵;对分级任务,还需要说明有序类别如何比较,是否允许相邻等级混淆。每个指标都要说明统计单位、置信区间和缺失处理,不能把病例层结果、切片层结果和病灶层结果混在同一张表里。若测试集为分层抽样,最好同时报告分层结果和按目标人群重加权的敏感性分析,避免把配额设计误读为临床发生率。
数据划分必须在受检者层面或更高层级保持互斥。同一人的多次检查、同一次检查的不同序列、左右侧或相关报告,不能一部分进入开发流程,另一部分进入最终测试。TRIPOD+AI 将评测数据定义为独立于训练、调参和模型选择的数据,并要求评测人群能够代表模型预期使用人群;它还强调区分能力、校准、亚组公平性和外部评估的报告边界。5 对乳腺 CT 来说,层厚和剂量正是需要预先定义的协议亚组,而不是评测结束后才临时寻找的“亮点”。
外部验证应尽量改变数据来源、时间段、设备或协议中的至少一部分,同时保持标签规则可比。如果只有内部冻结测试集,也要明确说它只能支持该队列和该版本的技术评估。专用乳腺 CT 的早期研究指出,非增强影像对微小钙化的显示仍有局限,且覆盖胸壁侧和腋尾也可能是工程挑战。1 因此,失败案例复盘应追问是病灶类型、覆盖范围、重建参数、剂量噪声、报告证据还是模型决策造成错误,而不是只按一个总分判定“通过”。
六、把验收写成两道门,而不是一次性收货
第一道门是数据门。每个批次先做机审:DICOM 是否可读,研究所需字段是否完整,UID 和索引是否一致,病例是否重复,层厚与剂量分层是否落在书面范围,标签构成是否满足预设配额。缺失文件、重复病例和待核实样本应进入分母或隔离清单,不能从统计中悄悄删除。机审通过后再做盲抽人审,核对标签与脱敏报告或病理证据、侧别、分级、术后状态及报告一致性;人审发现的错误要能回到具体文件、具体版本和具体修改记录。
第二道门是模型门。两个团队必须使用同一份冻结测试集、相同的数据读取规则和预先批准的统计脚本。版本号、权重哈希、预处理配置、阈值、运行日期、硬件或软件依赖都应写入评测记录。上线前要比较新旧版本的总体表现和关键亚组表现,检查置信区间、校准曲线、错误样本和异常输出。项目可以设定合格率、构成偏差、性能下限和回退条件,但这些阈值应由研发、临床和质量负责人在项目书面方案中共同确认,不能从某篇论文或供应商宣传中直接移植。
验收指标还应区分“数据是否合格”和“模型是否达到用途要求”。前者是文件、字段、标签和构成的硬门槛,后者是模型在冻结样本上的统计表现与风险边界。一个批次即使文件合格,也可能因为某一协议亚组样本过少、参考证据集中在单一来源或模型输出无法校准而不适合上线。反过来,模型在某一亚组表现不稳定,也不应通过删除困难病例来改善平均分。建议把每个失败样本分为采集质量、脱敏或解析、标签证据、预处理、模型输出和统计脚本六类,分别记录发现环节、责任角色、是否可修复以及是否需要重跑。这样,下一版数据规则可以针对真实失效链路修订,模型团队也能判断问题是数据分布改变还是算法退化,而不是把“未通过”留成一句无法行动的结论。
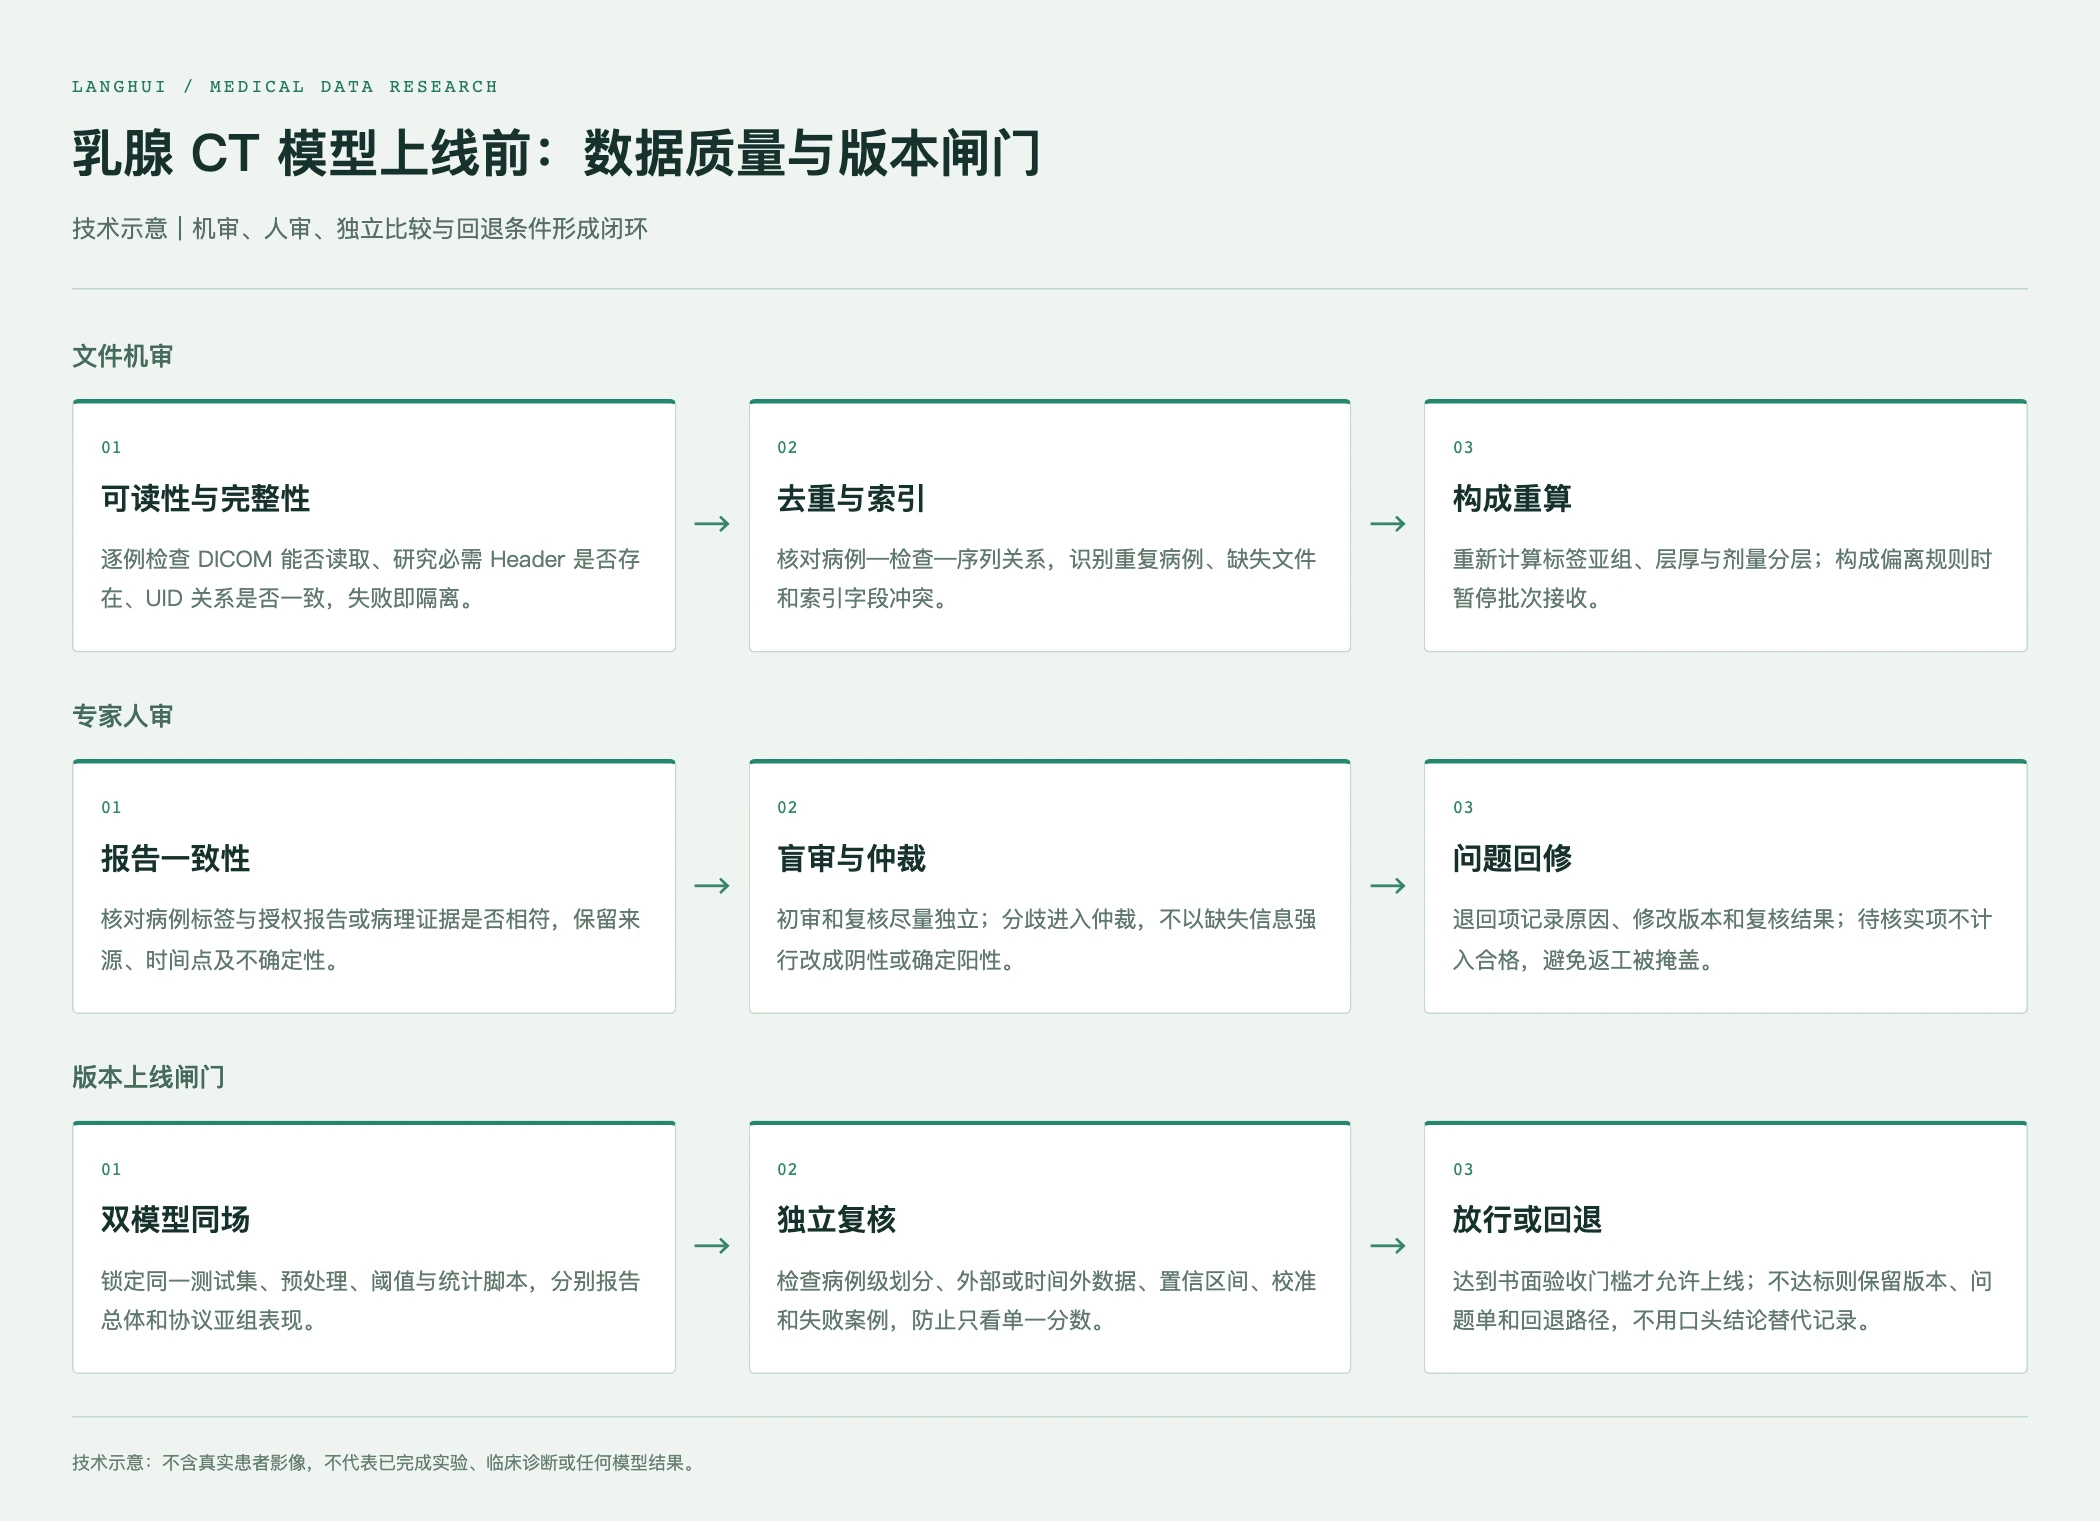
图2 技术示意:文件机审、专家人审、双模型同场比较和放行/回退构成版本闸门;不含真实患者影像,不代表已完成实验或临床诊断。
需求中“先交验证批、再决定是否进入完整交付”的业务逻辑是有价值的,因为它把大规模返工前移为小规模试标。但验证批不能只检查文件能否打开,还要覆盖每一种病例标签、关键层厚/剂量亚组和典型缺失或冲突场景。若首批不合格,应暂停扩量、修订规则并重新验证,而不是用后续样本的数量掩盖前一批的定义错误。最终接收也应以逐例合格、构成重新核算和版本冻结为条件,留下可审计的退回与替换记录。
七、从数据交付到持续版本治理
测试集一旦用于多个产品版本,就不再是一次性交付文件,而是一个需要保护的基准资产。每次模型更新都要记录测试集版本、规则版本、索引快照、文件哈希、标签修订、排除病例和新增病例。若标签规则改变,旧版结果不能直接与新版结果拼成一条趋势线;若出现数据泄漏、脱敏缺陷或参考标准错误,应保留撤回记录,并明确哪些历史评测需要重跑。版本治理的目的不是制造复杂文档,而是让团队能够回答“这次性能变化来自模型、数据、标签还是脚本”。
FUTURE-AI 共识指南把代表性数据、风险识别、鲁棒性、公平性、可泛化性、可解释性、文档和部署后监测放在同一生命周期中。6 对乳腺 CT 项目而言,这意味着上线门槛不能止于“测试集分数超过旧版本”。还要检查剂量变化是否改变错误分布,某些年龄或乳腺组成亚组是否缺失,外部数据是否出现校准漂移,以及版本回退和问题上报是否可执行。若产品用途发生变化,例如从研究评测转向真实筛查辅助,还需要新的临床评价、适用人群和合规审查,不能沿用一套内部测试结果。
在已核验的公司能力边界内,医疗数据基础设施和流程服务可以帮助把需求拆成数据卡、样例评估、标注规范、质检记录、导出检查和版本交付;这属于项目化数据治理支持,不等于已有某种乳腺 CT 现货库存、已完成临床验证或拥有统一模型性能。具体的专家配置、数据授权、设备覆盖、周期、格式和验收阈值仍应在项目书面确认后执行。对于采购方,最有价值的交付不是一张“合格”勾选表,而是能让算法、临床和信息部门共同复核的输入、证据和失败记录。
结语:独立测试集的价值在于让差异可解释
乳腺 CT 风险筛查模型的公平比较,核心不在于把病例数量做大,而在于把每一例为什么进入、标签依据是什么、层厚和剂量如何影响任务、两个模型是否看到同样的输入,以及不合格后如何回退,都写成可复核的流程。对于公开研究,专用乳腺 CT 的影像能力、参考模态差异和覆盖局限必须与模型结果分开理解;对于工程交付,DICOM 完整性、脱敏、证据分层、病例级划分和版本冻结必须同时通过。
当测试集能把协议亚组、参考证据、争议标签和失败案例连接起来,它才真正支撑模型上线前的决策。反之,即使文件数量和总分都很漂亮,也无法回答模型是否适用于新的采集条件,更不能替代独立临床验证。本文只讨论数据建设和模型评测工程,不构成医疗建议、筛查结论、诊断或治疗意见。
参考来源
- Dedicated breast computed tomography: the optimal cross-sectional imaging solution?
- Use of Low-dose Chest CT Scan in the Evaluation of Breast Composition
- DICOM PS3.15 2026d — Attribute Confidentiality Profiles (Normative)
- Checklist for Artificial Intelligence in Medical Imaging (CLAIM): 2024 Update
- TRIPOD+AI statement: updated guidance for reporting clinical prediction models that use regression or machine learning methods
- FUTURE-AI: international consensus guideline for trustworthy and deployable artificial intelligence in healthcare