
MEDICAL DATA RESEARCH
颈部CT数据怎么交付:把检查级计数、专项标签与可追溯验收写进同一条链
面向医学AI研发与数据采购读者,拆解颈部CT以Study计数、DICOM层级、报告与不确定标签、专家复核、去标识、外部验证和版本化验收的可追溯方法,适用于需求评估和研究数据治理;不代表现货、诊断或临床效果。
一次颈部CT数据建设,为什么“文件很多”仍然可能不适合训练、评测或科研复核?最常见的原因不是缺少某一个算法,而是从一开始就没有说清楚数据究竟以什么为单位、影像覆盖到哪里、报告中的不确定性如何保留,以及同一患者的不同检查能否被可靠地重新连接。对于头颈部这一解剖关系密集、协议差异明显、临床语义容易越界的场景,若把多序列、多期相、多重建拆成许多“样本”,再用一个“阳性”字段概括所有发现,数据表面上变大了,实际却更难审计。
这类需求适合被改写为一个匿名的医学数据工程问题:输入是经合法授权和去标识处理的颈部CT及其正式报告,输出是以CT检查/Study为核心、可回到Series和Instance、能够与报告和证据来源配对的数据对象。它可以服务于影像分类、征象检测、解剖结构分割、影像—文本建模和数据质量评测,但不应被写成对个体作出诊断的系统。本文讨论的重点,是如何把临床任务、数据颗粒度、标签证据、算法路线和验收逻辑拆开,再重新组织成可以被研发团队、医学专家和采购方共同检查的链路。
先定义“一个样本”到底是什么
颈部CT项目最重要的第一个决定,不是选用哪种网络,而是确定计数单位。更稳妥的做法是以一次CT检查或Study作为基础对象。一次检查中的多序列、多期相、多平面重建、多视图和重复导出,仍属于同一次检查,不能仅因为文件数量增加就被拆成多例。Series和Instance是影像层级,用于保持原始结构、检查完整性和下游读取关系;它们不是替代Study的计数单位。这样设计可以避免同一检查在统计时被重复放大,也让研究者知道模型输入究竟来自一个完整检查,还是来自其中经过筛选的序列。
解剖范围也必须以实际图像核对,而不是只看检查名称。颈部软组织任务通常关注从颅底到胸廓入口的诊断范围;头颈联合检查需要记录主要检查目的,并说明与头部CT如何去重。若某例只覆盖部分结构,或者伪影、运动、金属和低剂量噪声使目标区域无法评价,就应该标记为部分覆盖、无法评价或待核验。部分覆盖不能自动产生“未见异常”的范围外阴性标签。ACR、ASNR和SPR的头颈部CT实践参数把患者选择、颈部CT检查规格、文档记录和质量改进分别列为需要管理的环节,这说明“检查做过”与“检查满足某项研究用途”并不是同一个判断。1
输入模态可以按临床已有数据分层,而不应在交付时补造理想协议。基础输入包括颈部平扫和增强CT;薄层多平面重建、喉及下咽专项、血管CTA或CTV等,则应以实际存在的检查和项目任务为准。协议名称需要与原始文件、覆盖范围、期相和视图相互核对。设备厂商、型号、软件版本、层厚、重建核、像素间距、空间方向和HU转换信息,至少要区分已知、未知、缺失和不适用。保留这些字段不是为了让目录看起来复杂,而是为了在模型发生域偏移时能够追问:误差来自病变本身,还是来自设备、协议和重建条件的变化。
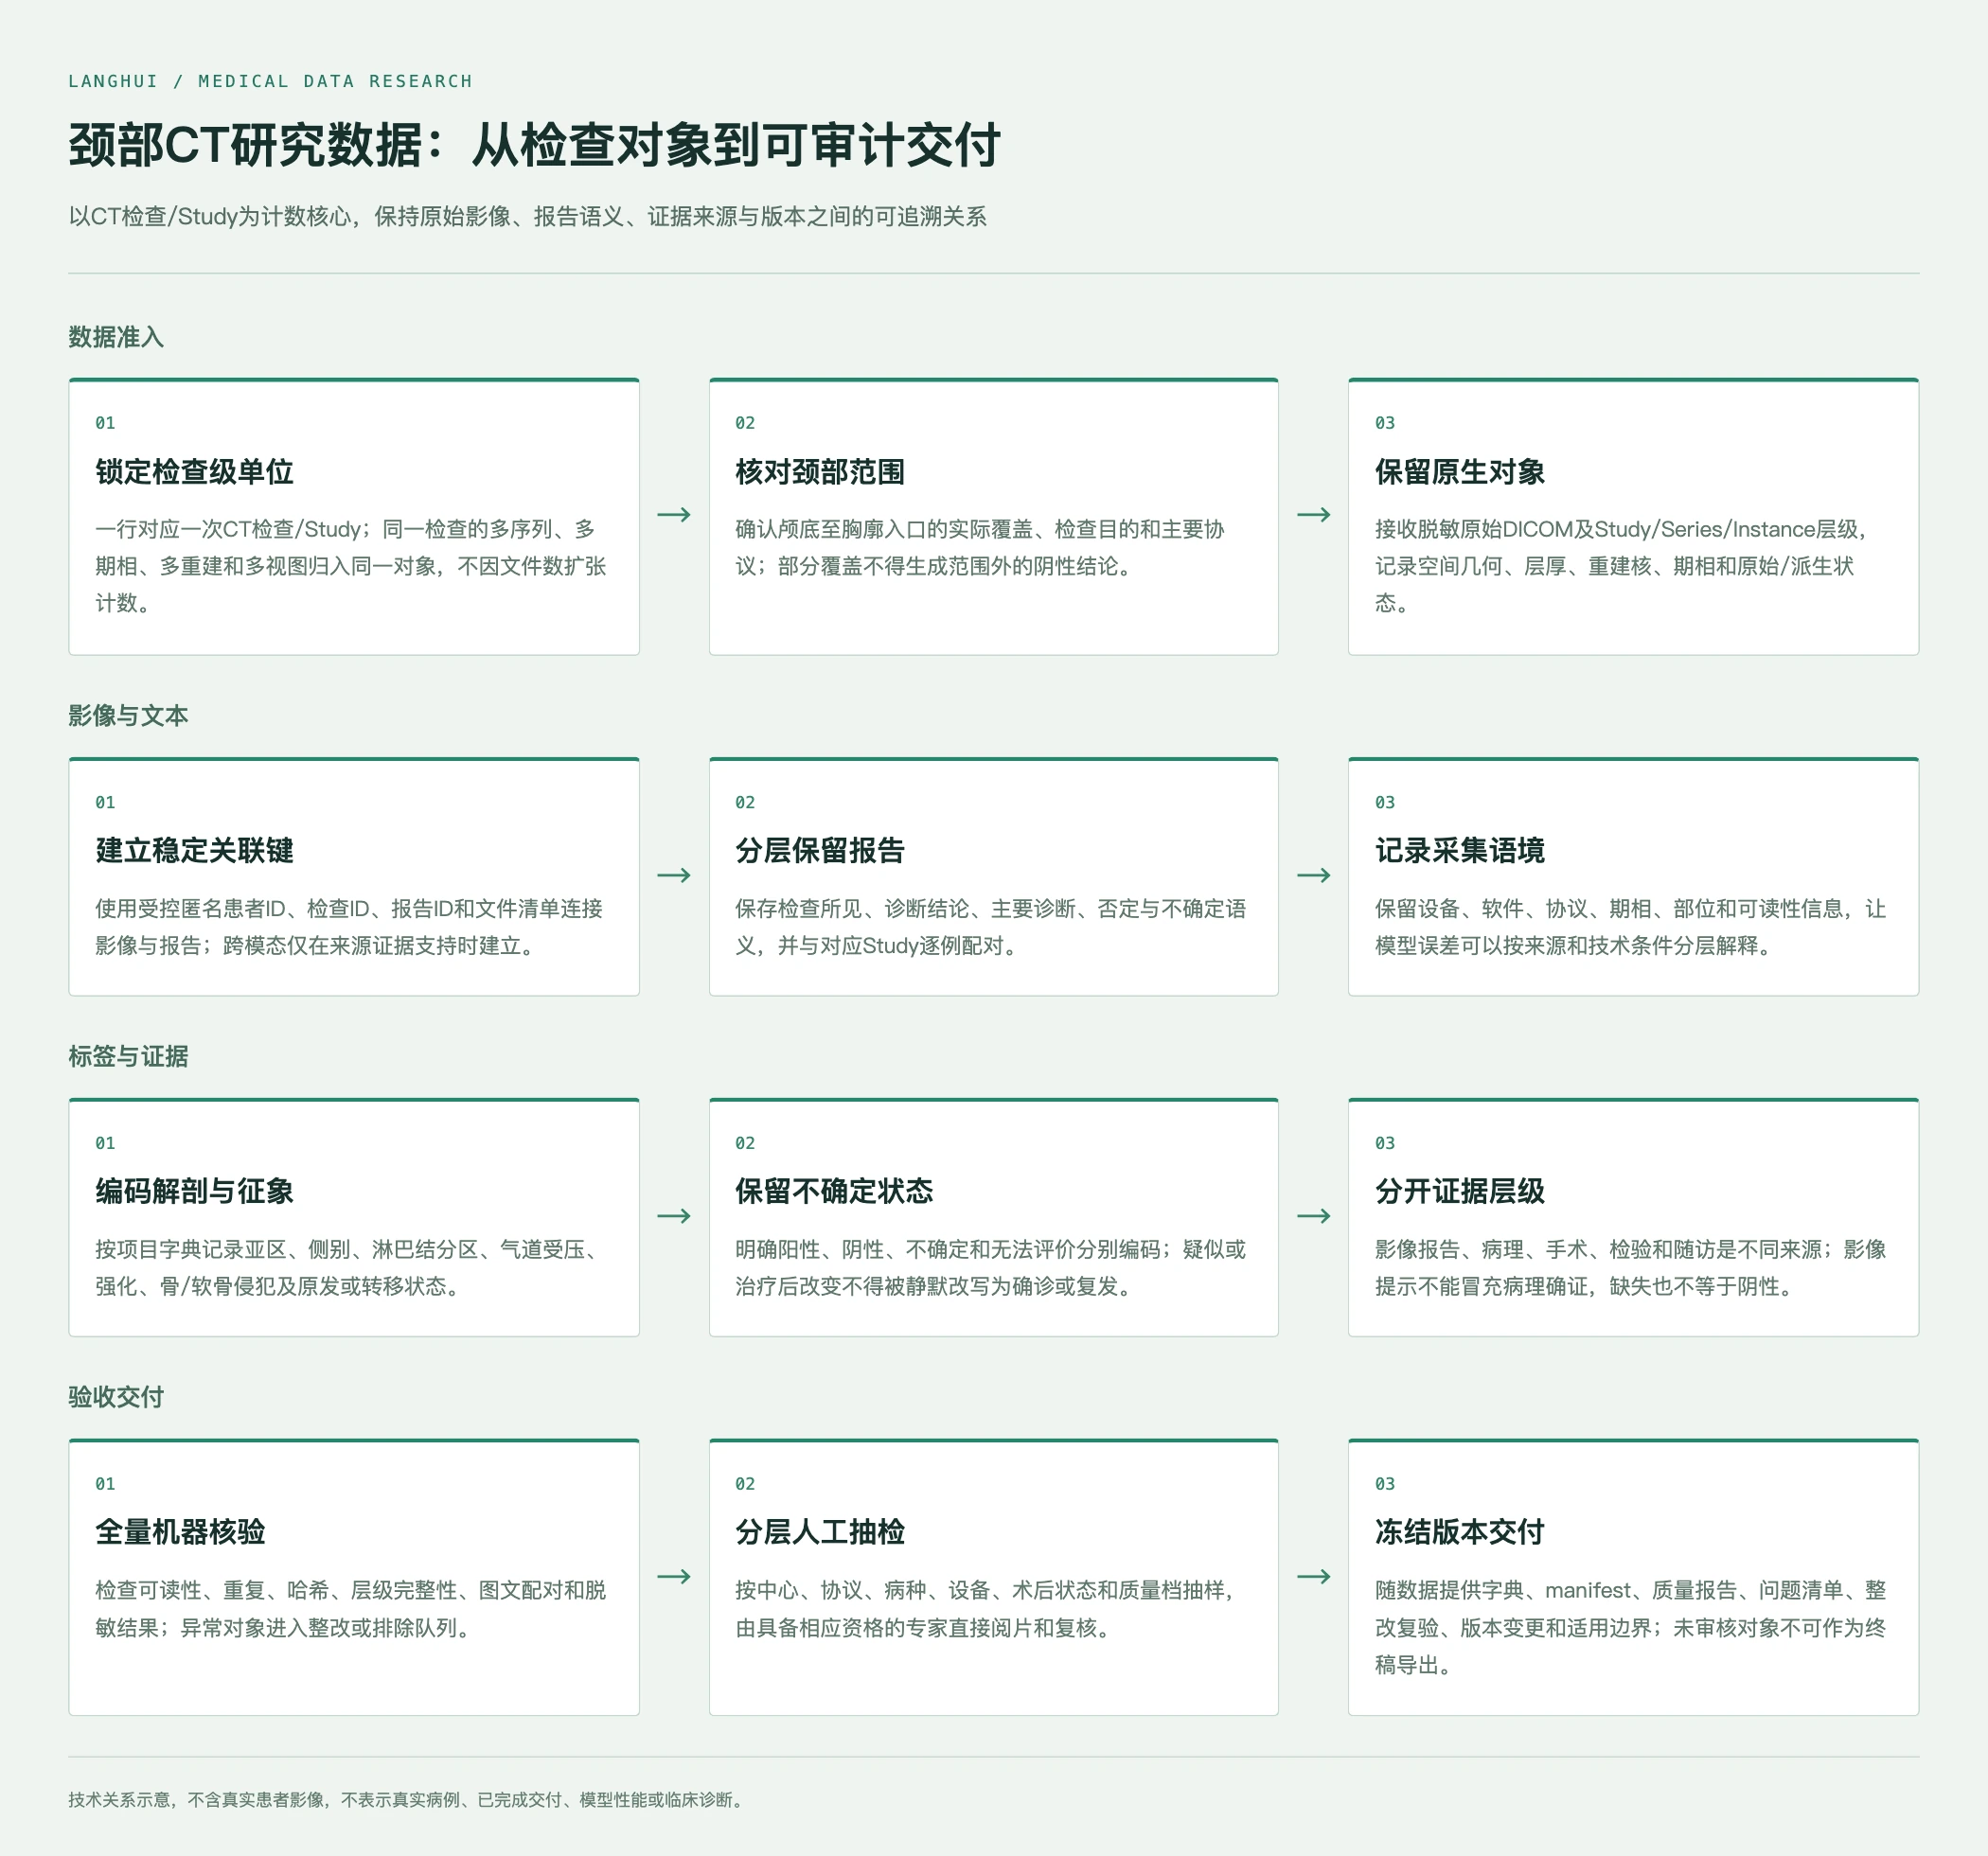
图1|技术示意:以CT检查/Study为计数核心,连接原始DICOM、报告语义、证据来源、质检和版本化交付;不含真实患者影像,不表示真实病例或已完成交付。
把颈部任务拆成不同粒度的标签
颈部CT并不是一个只有“有病”和“没病”的二分类问题。一个可复用的数据字典应至少区分检查层、序列层、报告层、疾病或征象层以及证据层。检查层回答“这是什么检查、覆盖什么范围、是否可读”;序列层回答“有哪些协议、期相和重建”;报告层保留原始所见、印象、主要诊断、否定语义和不确定语义;疾病或征象层用于任务所需的结构化编码;证据层记录该字段来自影像报告、病理、手术、检验、随访还是专家复核。
在解剖和病种范围上,标签可以按项目需要覆盖颈部淋巴结肿大、鼻咽及口咽—下咽区域肿块、喉部病变、甲状腺及邻近侵犯、深颈部感染和脓肿、唾液腺病变、囊性病变、血管异常、外伤以及术后或放疗后改变等类别。重要的不是把所有类别都强行做成确定性标签,而是把每一类的观察边界和证据要求写清楚。例如,淋巴结字段可以记录分区、侧别、短径、形态、坏死、融合和包膜外侵犯倾向;气道字段可以记录受压、狭窄或无法评价;肿块字段可以记录解剖亚区、强化表现、骨或软骨受累以及与原发或转移相关的影像语义。
这些字段不应越过影像证据的边界。CT可用于记录范围、密度、强化、骨质或气道关系,但不能仅凭CT把肿瘤组织学亚型写成病理确诊;影像提示的转移倾向也不能自动替代病理或临床结论。对甲状腺结节、喉癌、鼻咽癌和唾液腺肿块等标签,建议并列保留“影像观察”“报告结论”“病理或手术证据”“未知/缺失”和“待复核”,而不是压缩成一个没有来源的真值列。确诊、疑似、考虑、不能除外、治疗后改变和无法评价,应分别编码。这样做会使数据集看起来不那么整齐,却能避免模型把报告中的措辞强度误学成疾病事实。
输出的颗粒度还要与任务匹配。如果研究目标是检查级分类,核心输出是Study级标签和报告配对;如果目标是病灶检测,则需要病灶ID、位置、侧别和可复核的空间对象;如果目标是结构分割,才需要在明确坐标系和原始序列的前提下提供逐层轮廓或体素标签。跨模态关联至少应稳定到匿名患者或检查级。患者级关联并不意味着已经建立像素级、病灶级或病理确证关系;只有在来源材料和标注规则确实支持时,才能进一步下沉到病灶或空间层。
原始DICOM、报告和关联键要同时保留
医学影像数据常见的失败方式,是把DICOM转成图片后丢掉检查上下文,再试图用文件名把报告拼回来。更可靠的结构是同时保留脱敏后的原始DICOM、结构化索引和报告文本。DICOM文件应保持Patient、Study、Series、Instance等层级的稳定关系,并明确哪些字段是原始值、哪些字段是转换后值、哪些文件属于派生结果。文件清单应能够记录对象ID、相对路径、文件大小、格式、哈希、原始或派生状态、脱敏和转换工具版本。
DICOM去标识不能只做表头字段删除。DICOM PS3.15明确讨论了属性替换或移除、相关实例间UID和替代值的一致性,以及图像像素中烧录身份信息的清理责任;标准本身并不替处理方完成具体项目的再识别风险评估。2 颈部和头面部影像尤其要把私有标签、结构化序列、图形叠加和像素内文字纳入检查。日期偏移可以保留纵向间隔,但必须有版本化规则;UID重映射可以维护匿名关联,但需要验证引用链没有断裂。
公开头颈影像档案提供了一个值得借鉴的工程教训。Grossberg等描述的头颈鳞癌数据集在技术核验中发现过Study与Series不一致、数据集错误链接和结构集与源CT错配等问题,后续需要去重、重链、修正并反复复核。3 这说明“文件能打开”远远不等于“关系可用”。在颈部CT项目中,至少应自动核对Study/Series/Instance层级、空间方向、切片排序、重建参数、文件哈希、报告配对和跨批重复;对异常对象保留问题原因、处置状态和复验版本,而不是静默替换。
去标识后的可用性同样需要验证。Sahlsten等针对头颈肿瘤影像研究的结果提示,面部处理方法可能影响图像中的关键结构和自动分割表现,而且在其研究的CT数据上,所测试的去脸方法都未能可靠去除面部特征。4 这不是对所有工具或所有项目的统一结论,却足以说明:头面部影像不能把一个通用脱敏开关当作完成证明。应根据目标解剖、研究用途和数据访问方式设计专项检查,并记录图像可用性、残留风险和人工复核结果。TCIA的头颈PET-CT集合也明确提示,部分影像可能具有面部重建风险,需要受控访问;其日期处理保留序列间时间间隔,说明脱敏与纵向研究可用性需要同时设计。5
算法路线:先保证语境,再谈预标注和多模态
颈部CT数据的算法路线不宜从“训练一个大模型”开始,而应先把任务拆成不同的预测对象。对检查级疾病或征象标签,可使用三维CT编码器结合结构化元数据和报告语义的多任务模型;对淋巴结、气道或软组织结构,可使用检测、分割或实例级模型;对报告中的否定、不确定和部位关系,可使用医学文本抽取或规则与模型混合的方法。若项目同时利用影像和报告,融合层应保留输入来源和缺失状态,不能把没有报告误写成“报告阴性”,也不能让病理字段在没有授权证据时成为影像模型的隐式答案。
在数据准备阶段,建议先用确定性规则完成Study去重、序列识别、范围检查和基本质量门控,再将AI预标注引入人工流程。预标注的价值是产生待审核草稿,而不是绕过专家终审。模型输出应随任务记录模型或规则版本、输入协议、失败原因、人工修改幅度和最终审核状态。若模型只适用于某一设备、期相或解剖范围,就应在任务清单中显式限制,不宜因为图像“看起来相近”而跨协议批量套用。
头颈部自动分割研究已经说明,多中心条件下模型的收益并不对所有结构和机构相同。Pang等在七个机构评估头颈CT自动勾画时,发现不同器官和淋巴结层级的时间收益存在差异,并强调机构级调试和验证仍然必要。6 另一项针对异质CT中颈部淋巴结检测和分割的研究使用多医院数据和外部测试集,同时报告检测与分割指标,并指出灵敏度、专家间差异和少见区域仍是限制。7 对项目实施的启示是,预标注可以成为生产工具,但不能把某个公开研究的指标直接改写成供应商或项目的统一验收承诺。
模型训练和评测还要防止信息泄漏。划分应以匿名患者为单位,而不是以DICOM文件、切片或报告行随机打散。一个患者的多个时间点、平扫与增强序列、派生重建和同一病灶的不同对象不能跨越训练、验证和测试集合。外部验证应尽量保留未参与规则制定和模型训练的中心、时间段或设备组合,并分别报告常见病种、少见病种、阳性状态、不确定状态、术后状态和低质量病例的表现。平均准确率、平均Dice或单一最好分数都不能替代对失败模式的说明。
专家标注要处理“看不清”和“证据不够”
颈部CT的专家标注不是把所有异常都涂成同一种颜色。初标人员需要按冻结的标签字典记录可见结构和报告语义;第二位审核人员独立检查解剖位置、侧别、淋巴结分区、气道关系、骨软骨侵犯和术后改变;存在争议时,再由具有相应临床经验的专家依据原始影像、报告及项目允许的证据进行仲裁。不同角色的职责应分开记录,不能由同一人无痕地完成标注、修改和最终验收。
边界协议应写出可执行规则。对目标结构进入视野但边界受伪影影响的病例,使用“不可可靠评价”并保留原因;对没有做过某项检查,编码为“未做”而不是阴性;对报告明确否定的征象,记录为报告阴性,并保留报告来源;对报告写“考虑”“不能除外”的情况,维持不确定状态。治疗后改变、残留或复发倾向也必须分开,不得为了满足阳性比例而把术后纤维化和复发混为一类。
专家一致性不应被理解为所有人必须给出完全相同的像素边界。高风险字段可以设置更高复核等级,常见且规则明确的字段可采用抽样审核;少见病种、气道狭窄、血管异常、复杂术后解剖和图文冲突病例则应进入重点复核。交付记录中应同时保留原始意见、复核意见、争议点、采用依据和指南版本。争议不是需要被隐藏的噪声,而是后续修订标签字典和解释模型误差的重要材料。
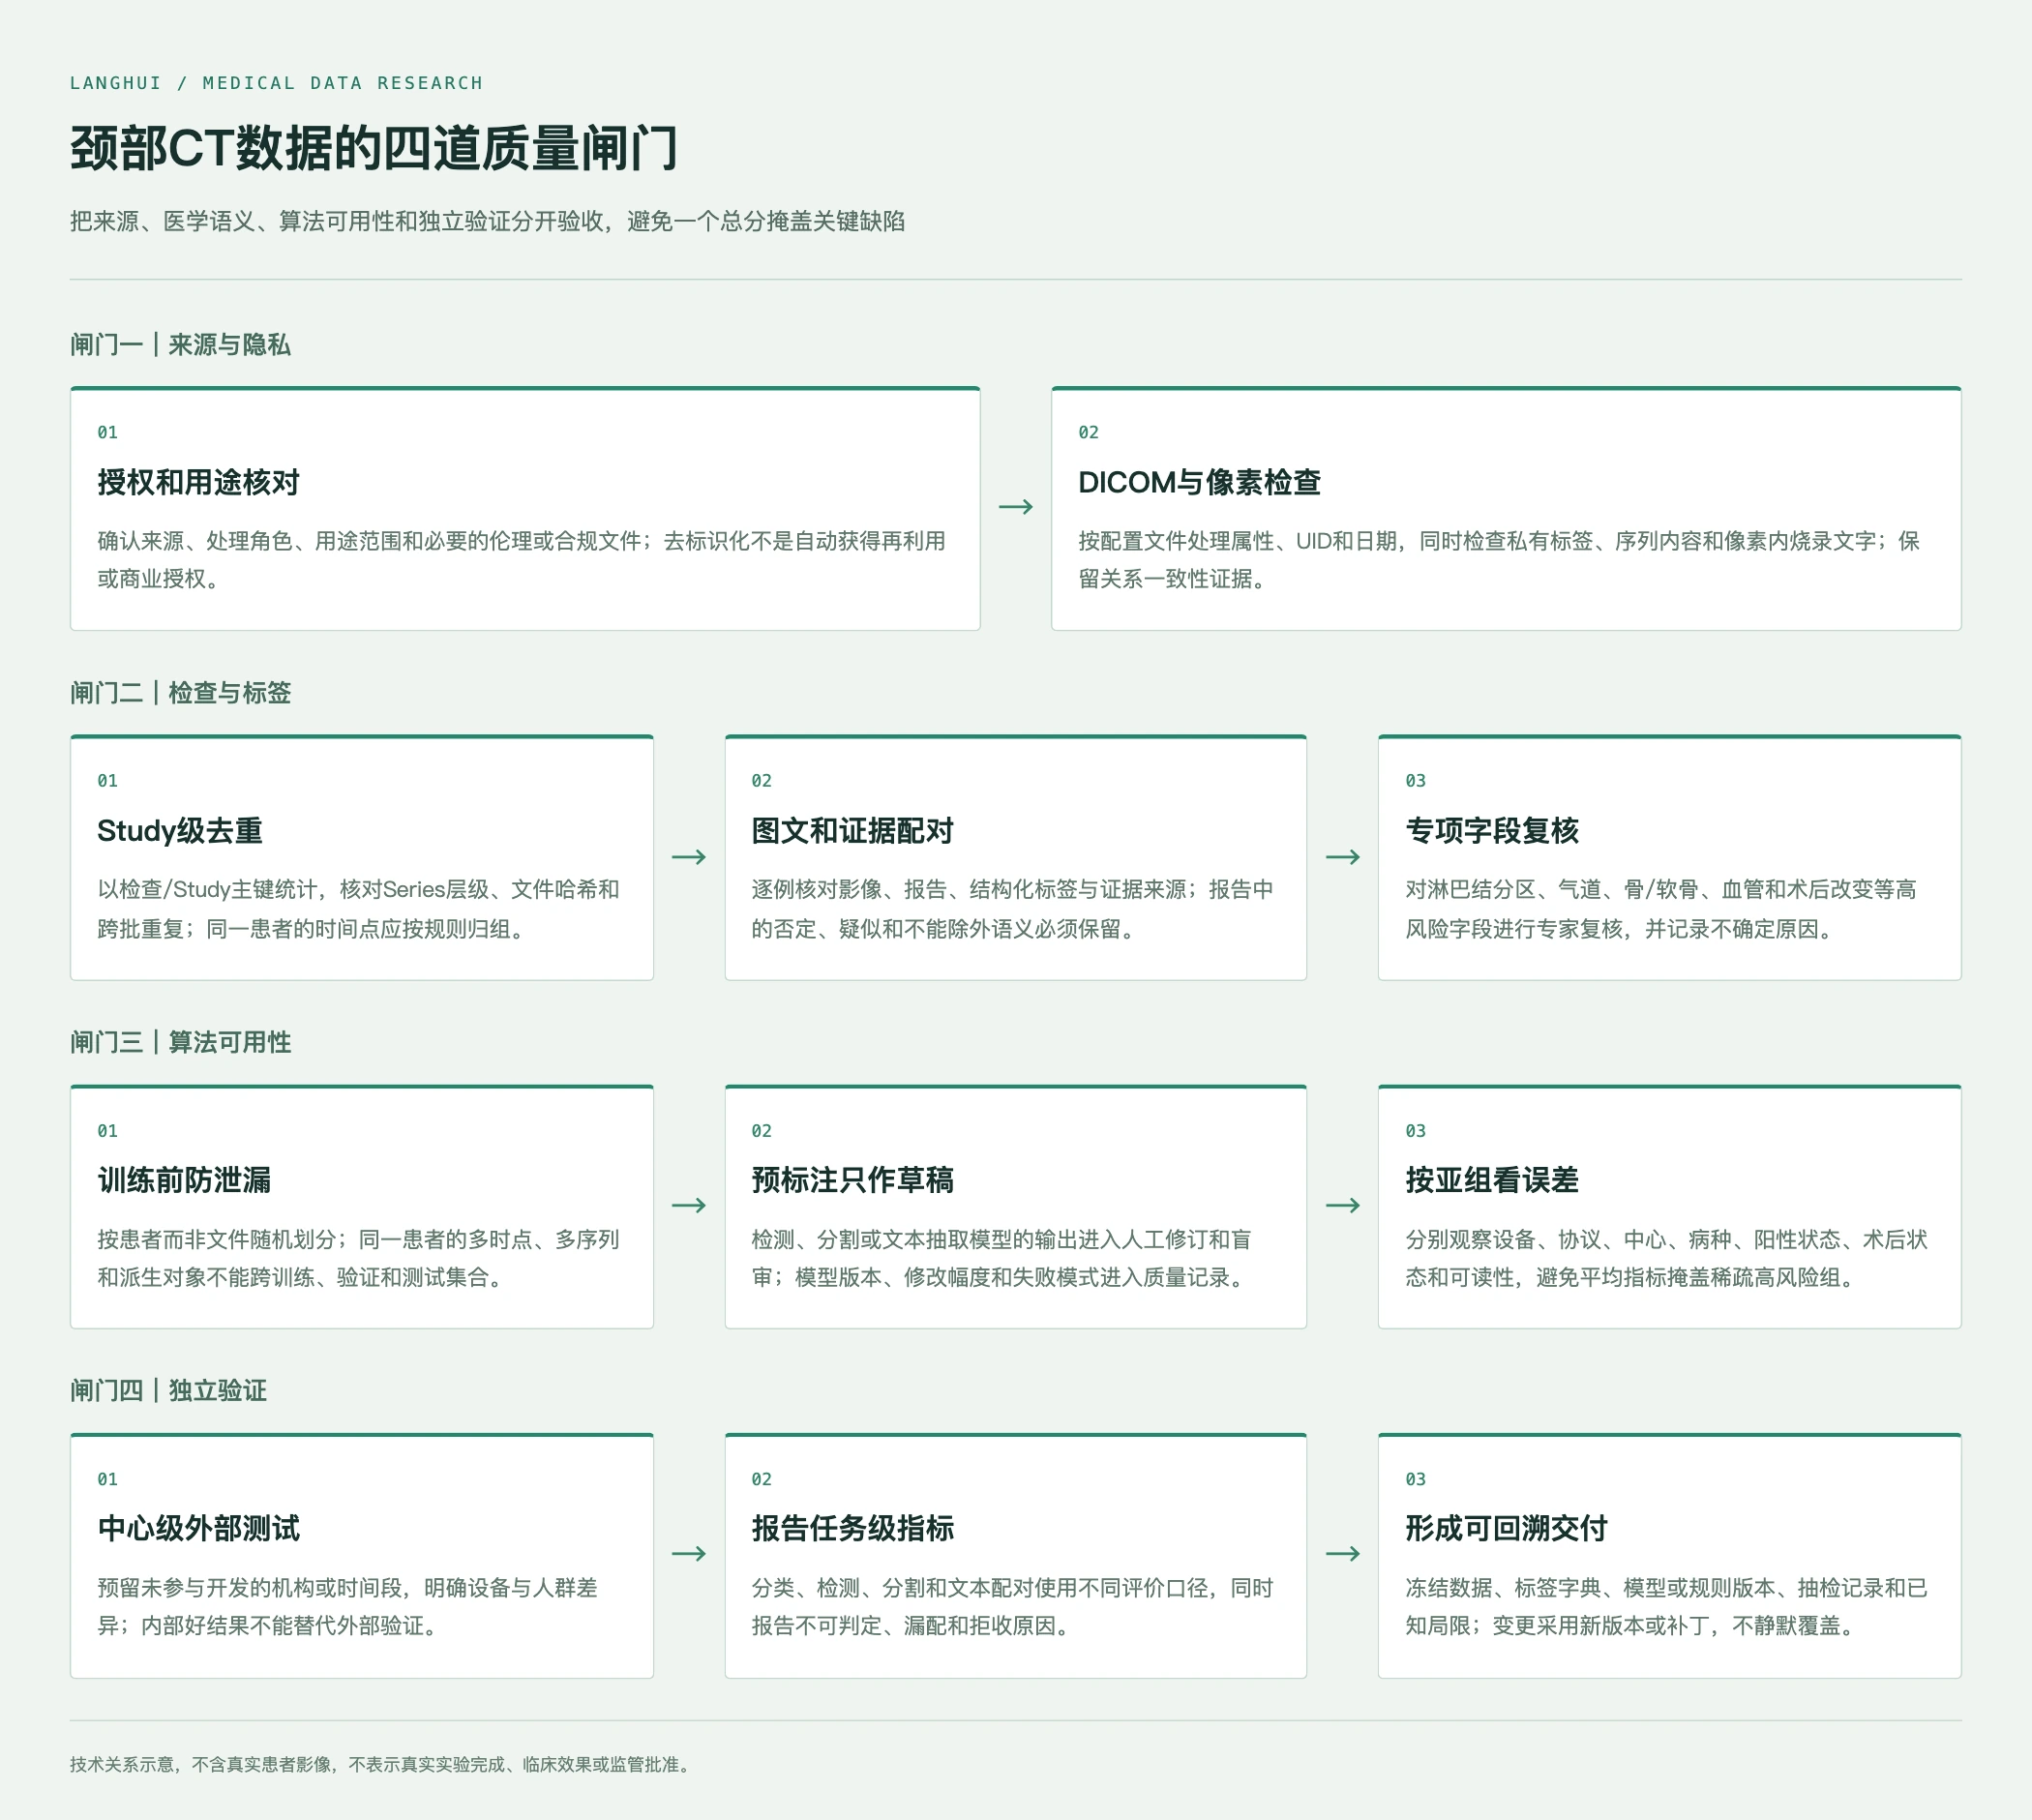
图2|技术示意:将来源与隐私、检查与标签、算法可用性、独立验证分开验收;不含真实患者影像,不表示真实实验完成或临床效果。
验收要验收“链”,而不是只验收数量
一个可执行的验收方案可以分成四道闸门。第一道是来源与隐私:核对数据来源、使用范围、处理角色、去标识方案、DICOM属性、UID关系、像素内文字和访问边界。去标识化不能自动替代伦理审查、授权确认或数据安全责任。第二道是检查与标签:按Study主键去重,核对影像可读性、覆盖范围、序列完整性、图文配对、核心标签、否定和不确定语义。第三道是算法可用性:检查训练前划分、字段可解析性、坐标和标签格式、预标注审核状态、缺失编码和异常样本处置。第四道是独立验证:用未参与开发的中心或时间段检查模型和数据规则在外部条件下是否仍然可解释。
验收统计应同时给出合格、整改、剔除和待核验,而不只是一个通过数量。中心分布、设备和软件代际、检查年份、平扫与增强比例、报告完整度、图文配对率、未知字段比例、重复主键、哈希重复和跨批重复都应可由逐例索引重算。阳性和阴性构成可以作为项目分布目标,但不能用强行改标签实现;罕见病种若自然分布不足,应提交检索范围、证据和处置说明。术后、跨模态和高质量抽检也应分别定义统计域,不能把不同对象机械相加。
交付包还应包含数据字典、文件清单、质量报告、问题样本、整改复验、标签指南、抽样方法和版本说明。每次修改都要标注版本号、日期、受影响对象、修改原因和对既有数据的影响。若已冻结的数据需要更正,宜采用新版本或补丁清单,明确旧对象是否撤回、哪些派生标签需要重算。对研究者来说,这些材料比一个未经解释的“总体质量分数”更有用,因为它们能让下游团队判断哪些任务可以直接开展、哪些任务需要二次清洗、哪些结论不应外推。
如果项目采用分档交付,建议把基础原始影像与报告、结构化元数据、临床字段、纵向关联和多模态证据分别定义为质量层级,并在数据字典中写清每一档的纳入条件。同一个Study只按最终实际达到的一个档次计入;跨档重复计算会把数据量和可用性同时夸大。任何核心条目、协议、阳性构成或例外口径的变更,都应形成有影响范围的新版本或差异包,而不是用备注静默覆盖既有结论。
把项目需求转成可持续的业务接口
对数据采购方,最值得在立项阶段写清楚的不是“要多少图片”,而是目标研究问题、计数域、输入模态、解剖范围、标签粒度、证据层级、跨模态关系、设备与协议分布、抽检机制和最终用途。对算法团队,需要提前确定训练、验证和测试的患者级划分,指定是否需要像素标签、报告抽取或仅检查级标签,并为未知、不可评价、未做和缺失保留不同编码。对医学专家,需要在试标阶段冻结高风险字段的边界和示例,避免批量生产后才发现同一术语在不同中心含义不同。
在已核验的能力边界内,朗慧科技的定位是AI数据基础设施及流程服务商,LangData覆盖采集、处理、标注、质检和数据交付。对颈部CT这类项目,能够形成的价值应表述为项目化的数据字典梳理、任务规格拆解、专业标注与复核组织、质量记录和版本化交付支持;具体样本来源、专家配置、交付规模、周期和格式,仍需以样例评估、书面规格、合法授权和项目验收为准。已核验的能力不等于某一批具体颈部CT现货,也不等于已经完成特定临床研究或模型验证。
项目管理上可以采用“样例评估—小批试标—规则冻结—分批交付—独立抽检—版本发布”的节奏。样例阶段要确认DICOM是否可读、颈部范围是否满足任务、报告能否稳定配对、标签字典是否能表达疑似和术后状态。试标阶段要统计争议类型、图文错配、缺失语义和模型修改模式。规则冻结后,新增标签、协议例外和质量阈值都应走变更记录。批次交付时,不仅核对数据量,还要验证清单、哈希、质量报告和整改闭环能否被接收方独立复算。
最终目标不是生产一套“看起来全部确定”的颈部CT标签,而是让每个检查都能回答几个基本问题:它从哪里来,覆盖了什么,属于哪一个Study,与哪个报告对应,标签由什么证据支持,哪些地方无法判断,谁在何时复核过,当前版本能支持什么研究,又不能支持什么结论。对于医学AI研发,这样的数据才有机会从一次性文件集合变成可重复使用、可解释和可审计的研究基础设施。
本文讨论医学影像研究数据建设、标注和验收工程,不构成医疗建议、临床诊断、筛查意见、风险预测、治疗方案或疗效承诺。任何具体个体的影像解释和临床决策,都应由具备相应资质的医务人员结合完整病史、原始影像、正式报告、病理及其他必要资料作出。数据共享、模型研发和实际部署还需符合适用法律法规、伦理审查、数据授权、隐私保护、信息安全、质量管理和必要的临床验证要求。
参考来源
- ACR–ASNR–SPR Practice Parameter for the Performance of Computed Tomography (CT) of the Extracranial Head and Neck
- DICOM PS3.15: Security and System Management Profiles
- Imaging and clinical data archive for head and neck squamous cell carcinoma patients treated with radiotherapy
- Segmentation stability of human head and neck cancer medical images for radiotherapy applications under de-identification conditions
- Head-Neck-PET-CT: The Cancer Imaging Archive collection
- Multicentre evaluation of deep learning CT autosegmentation of the head and neck region for radiotherapy
- Automatic cervical lymph nodes detection and segmentation in heterogeneous computed tomography images using deep transfer learning