
MEDICAL DATA RESEARCH
盆腔CT数据为何不能只按“病例数”验收:从检查级证据链到可复用标签
盆腔CT数据建设不能只看病例数量。本文从Study级去重、原始DICOM、解剖覆盖、报告确定性语义、影像与病理证据分层、专家标注、质量验收和独立验证出发,梳理面向医疗AI研发的可审计数据链路与实施边界。
盆腔CT数据建设最容易被低估的问题,不是能否收集到足够多的图像,而是能否证明每一个被计入的对象究竟是哪一次检查、覆盖了哪些解剖结构、对应怎样的报告语义,以及“阳性”“阴性”“不确定”和“无法评价”分别依据什么证据得出。一次CT检查可能同时包含平扫、增强、延迟期、多套重建和大量序列;如果把序列或导出文件误当成病例,数量会被放大,影像与报告也可能在不知不觉中错配。对需要支持医学人工智能研发的数据集而言,真正可复用的单位应当是带有空间、时间、语义和质量上下文的检查级对象,而不是一个脱离来源的数字。
本文围绕一类可匿名改写的盆腔CT数据建设需求,讨论如何把原始DICOM、检查报告、解剖范围、病种与征象、跨模态证据和质量记录组织成可审计的数据资产。文中不讨论任何具体机构、患者或合同条件;所有数量、比例、最低量和价格均应由具体项目在合法授权和书面规格中另行确定。文章也不构成诊断、筛查、分期、治疗或疗效建议。
一、先把临床任务拆开:同一批盆腔CT并不只有一种标签
这类需求表面上是“盆腔CT数据集”,实际至少包含四种不同颗粒度的任务。第一种是检查级任务:确认一项检查是否属于盆腔CT,原始DICOM是否完整可读,检查范围是否足以评价目标结构,协议和期相是否与文件一致。第二种是报告级任务:从正式报告中保留检查所见、诊断印象、主要诊断、否定语义和不确定语义,并将其映射到可统计的标签。第三种是征象或病灶级任务:记录肿块部位、侧别、大小、侵犯关系、淋巴结分区、梗阻、积液、腹膜种植或骨质改变等属性。第四种是纵向和跨模态关联:把同一匿名患者的前后检查、盆腔MRI、内镜、病理、手术和随访连接起来,但不把患者级关联误写成像素级或病灶级确证。
这四种任务不能用一个“阳性/阴性”字段替代。以直肠、膀胱、前列腺、子宫附件和盆腔淋巴结为例,CT可以支持发现异常、描述形态和提供部分分期线索,但不同病种对检查协议、膀胱充盈、增强期相和目标结构完整性的要求并不相同。报告中“考虑”“疑似”“不能除外”“治疗后改变”和“病理确诊”也不是同义词。若研究目的是训练报告抽取模型,就应保留这些语义层次;若研究目的是训练分割或检测模型,则还需要明确像素、体素、病灶或器官轮廓是否真的存在,不能从一份文字报告推导出没有被标注的精细边界。
盆腔的“覆盖”同样是标签的一部分。完整进入诊断视野、部分进入、未做、缺失、图像质量不足和无法评价,应分别编码。只有在目标结构实际可见且质量支持判断时,阴性结论才具有相应含义。比如检查未覆盖输尿管下段,不能据此生成“未见结石”;膀胱充盈不足时,壁厚评价应标记受限;术后或放疗后改变与复发倾向需要分开记录。这样的设计看似增加字段,实际上是在减少错误的确定性。
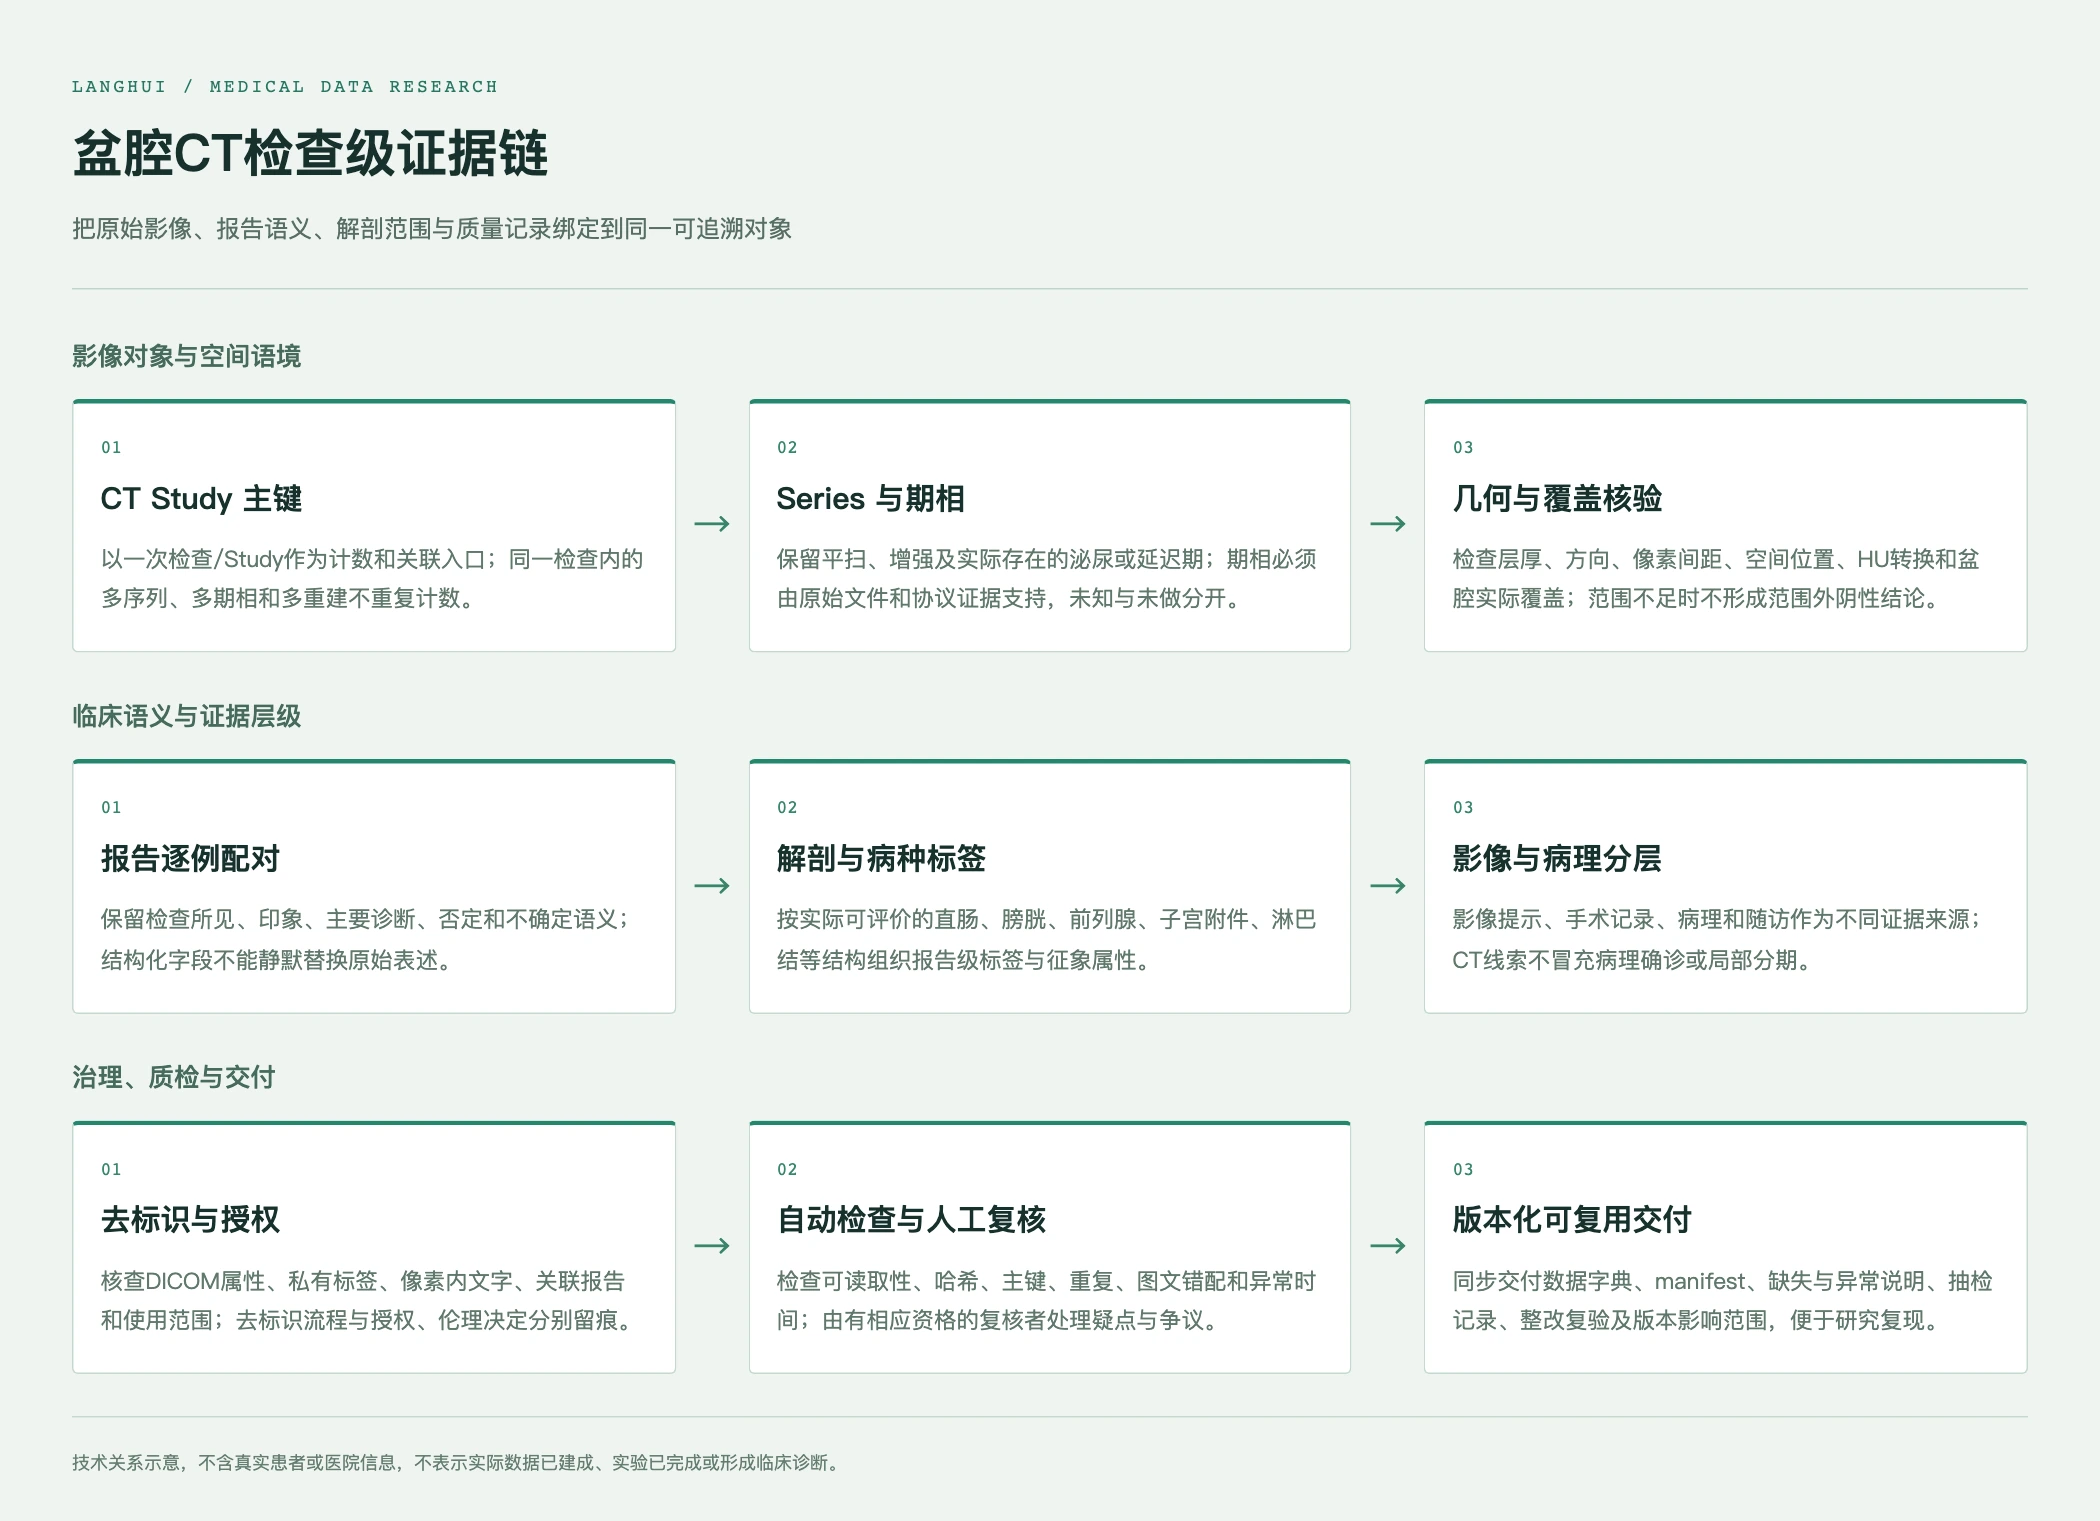
图1 盆腔CT检查级证据链技术示意;不含真实患者或医院信息,不表示实际数据已建成或形成临床诊断。
二、计数单位必须先于算法:用Study保护影像语境
研究数据的第一层主键建议从匿名患者、检查/Study、Series和Instance四层关系开始。患者级ID用于纵向关联,Study级ID用于一次检查的去重,Series用于区分平扫、增强、延迟期、骨窗或其他实际存在的序列,Instance用于核对文件完整性和层面关系。一次检查中存在多序列、多期相、多重建或多视图时,应在索引中完整保留,但不能把它们拆成多个病例。相反,不同日期、不同临床目的或不同检查协议的Study,即使文件夹名称相似,也不能因为患者ID相同就合并成一次检查。
原始影像交付不能由截图、胶片照片、报告PDF或关键帧拼图代替。研究者至少需要核对DICOM对象的像素数据、Study/Series/Instance层级、空间方向、层厚、像素间距、层面位置、重建核、期相和必要的HU转换信息。DICOM标准为属性保密、UID处理和相关安全配置提供了技术框架,但标准本身也提醒,清理属性不等于完成了整个信息对象的去标识化;使用场景、接受者、像素内文字、私有属性及重识别风险仍需在流程中独立判断。2
盆腔CT项目还应把检查协议写成可核对的事实,而不是依赖文件名臆测。平扫、增强、全腹盆联合检查、泌尿期和延迟期应按实际存在的序列与主要临床目的分层。设备厂商、型号、软件版本和关键采集参数可以作为偏差分析字段,但未知不应被静默填补。ACR关于腹部和盆腔CT的实践参数将检查规格、文档记录、设备要求及质量控制列为同一检查质量框架的组成部分,这对研究数据的入库也有启发:只有在成像上下文保留下来之后,后续模型结果才有可解释的适用边界。1
数据字典中还应保留“原始值”和“规范化值”两套信息。例如报告写的是某种期相原名、原始单位或原始分级体系,规范化字段可以方便统计,但不能覆盖原文。对于病种标签,建议使用“类别—亚类—征象—证据来源—确定性状态”的层级结构;对于时间字段,则分别标记实际日期、受控相对时间、日期缺失和时间不确定。这样既能支持算法使用,也能在规则修订后回溯哪些对象受到影响。
三、盆腔标签不是疾病清单,而是一套证据分层
盆腔CT常见任务涉及肿瘤、感染、结石与梗阻、淋巴结异常、腹膜病变、疝和盆底异常、术后或放疗后改变,以及少见的软组织和骨性病变。数据建设的重点不是把每一种名称都变成确定诊断,而是把影像可见征象、报告判断和更高等级的临床证据分开保存。直肠或膀胱的壁内异常、宫颈或附件肿块、盆腔淋巴结形态和骨盆破坏可以作为影像层标签;病理类型、恶性分级、局部精确分期和复发结论则应在有相应病理、MRI、手术或随访依据时单独关联。
对每个条目,都应先问三个问题。第一,目标结构是否完整进入视野,当前协议是否足以支持该判断。第二,报告中的表达是明确阳性、明确阴性、疑似、不能除外、治疗后改变,还是无法评价。第三,标签依据是影像报告、直接阅片、病理、手术、检验还是随访,证据日期和来源ID是什么。三个问题缺一不可。把“报告写了占位”直接转成某一种癌症,或者把影像提示的转移倾向写成病理确诊,都会让数据在训练和验收阶段产生不可见的标签污染。
跨模态关联也要遵守证据边界。患者级或检查级的关联可以帮助研究者分析CT与MRI、内镜或病理之间的互补性;它不等于已经建立像素级配准,也不等于每个病灶都能找到一份病理真值。若影像与病理的时间相隔较长,需记录手术或治疗是否发生在两者之间;若一个检查包含多个病灶,病灶ID、报告描述和标本ID不能仅凭相似名称自动拼接。没有稳定来源证据时,宁可标记“待核验”或“未建立关联”,也不应使用推测填补空缺。
治疗后数据尤其需要单独处理。手术、造口、淋巴结清扫、放疗后纤维化、积液和吻合口改变,可能与残留或复发在影像上产生重叠。标签体系应同时保留治疗状态、影像表现和证据来源,避免建立一个把术后改变与复发混合的二元真值。对于少见病种和复杂病例,不宜用过度简化的类别强行增加数量;研究者更需要知道其来源、确定性和可评价范围。
四、算法路线:先把可复用数据做稳,再决定是否建模
这类项目的算法路线可以分为数据工程、语义辅助和可选影像标注三个层次。数据工程层负责DICOM解析、Study去重、协议与范围核验、报告配对、哈希校验、元数据标准化和版本管理,这是所有下游模型的前置条件。语义辅助层可以使用规则、词典或自然语言处理模型,从报告中抽取器官、征象、否定和不确定表达,但自动抽取结果应被视为候选标签,需经过规定的人工审核后才能进入金标准。影像标注层则根据明确任务决定是否需要器官或病灶的二维/三维轮廓、框、点或测量值;报告级数据不能替代像素级标注。
如果项目需要分割或检测,输出颗粒度必须在试标前锁定。器官分割、病灶分割、病灶检测、报告分类和征象抽取分别需要不同的标签文件、阴性定义和评价指标。半自动工具、插值或模型预测只能生成草稿,不能在审核前直接进入训练集。对于标注边界不清、病灶与邻近结构相连、术后解剖改变或期相不足的病例,应允许“证据不足”“需复议”或“无法评价”等状态,并规定它们在训练和测试中的处理方式。
队列划分要以患者为单位,而不是以图像文件或Series为单位。同一患者的前后检查、重复导出、多个期相和派生标注不能被拆散到训练集和测试集,否则模型可能通过患者特征、设备习惯或重复影像获得不当信息。除了随机内部划分,还应设计按中心、设备、协议或时间保留的独立测试集。一个多期相CT研究曾在内部数据和另一来源的外部数据上评估腹部多器官分割;该研究报告内部平均Dice为0.847、外部平均Dice为0.823,且外部样本由医生重新勾画。这个结果只能说明该研究设置下存在跨来源性能差异,不能被解释为盆腔CT数据集的普遍临床表现或任何产品效果。5
五、专家标注与争议处理:一致不是把差异抹掉
报告级标签、影像征象、器官边界和病理证据需要不同的专业角色。放射科标注者适合处理影像范围、协议语境、报告所见和影像征象;若标签涉及病理类型或组织学分级,需要由相应专业人员核对原始证据;数据工程人员负责主键、文件、版本和审计链,不能替代医学判断。项目开始前应以脱敏样例共同冻结标签定义,明确哪些字段由报告直接保留,哪些字段需要阅片,哪些字段只能在病理或手术材料支持时填写。
标注说明不应只有几句抽象文字。研究显示,医学图像标注说明中加入具有代表性的示例图,比单纯延长文字说明更能改善标注表现;该研究还观察到专业标注者与非专业众包标注者之间存在差异。6 对盆腔CT而言,示例应覆盖完整与部分覆盖、阴性与不能评价、疑似与确诊、正常生理表现与炎症、术后改变与复发倾向等边界情形。示例图只能作为脱敏培训材料,不应直接替代项目实际数据或作为临床结论。
多标注者并不一定会给出完全相同的轮廓或语义。针对医学图像分割的研究提出,可结合一致性热图、Kappa类指标及STAPLE等方法理解标注者之间的差异,但不同指标反映的是不同层面的可靠性,不能用一个总分取代争议记录。4 近年的多标注者腹部CT数据集也显示,胰腺等较难结构的标注差异可能明显高于肝脏和肾脏,并提出保留多份独立标注、软标签或不确定性表示的研究价值。3
因此,项目应在规范中写清初标、复核和仲裁的关系。单盲或多盲审核要说明复核者是否能看到前一版标签;争议要记录发生在哪个结构、哪个层面、哪个期相和哪条规则;最终修订要有版本号、时间和原因。对报告语义来说,保留原文、结构化标签和复核意见三层信息,比强行生成一个看似整齐的真值更有利于后续研究。
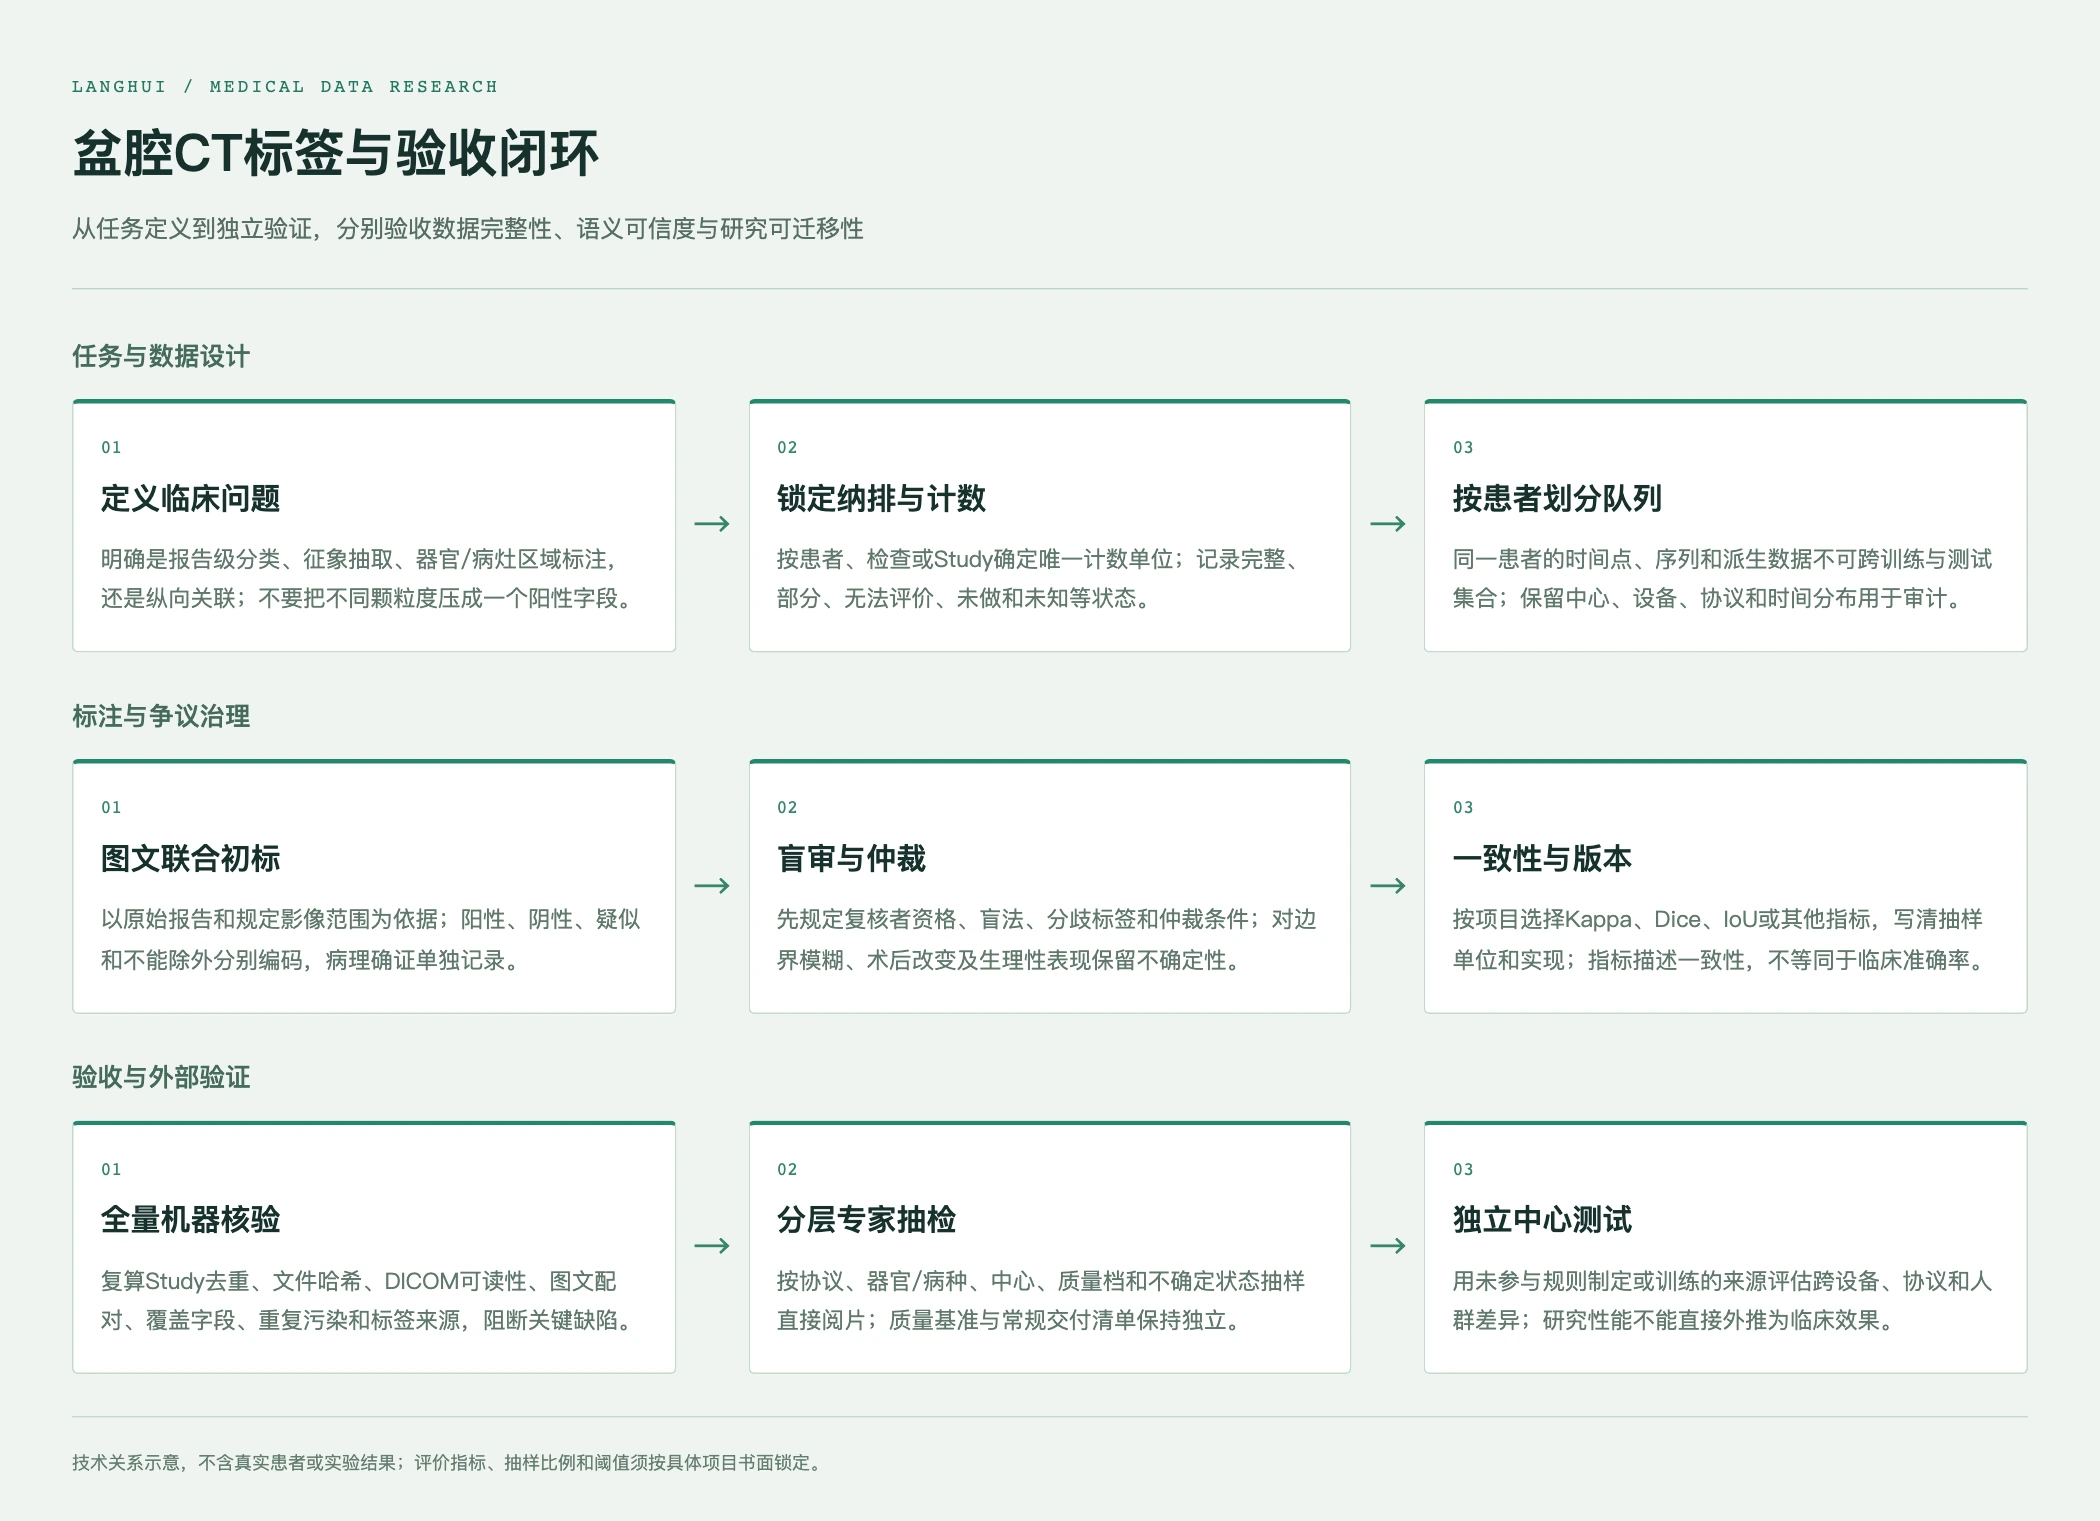
图2 盆腔CT标签与验收闭环技术示意;不含真实患者或实验结果,具体指标和阈值需按项目书面确定。
六、偏差与外部验证:把“覆盖广”变成可检验的问题
盆腔CT数据的偏差通常来自四个方向。第一是人群和疾病谱偏差:阳性病例过多会限制阴性场景,罕见病种只从单一来源收集则无法代表自然分布。第二是设备和协议偏差:层厚、重建核、增强时相、膀胱充盈和扫描范围会改变结构可见性。第三是标签偏差:不同中心的报告习惯、术后记录和病理回填方式不同,统一词典可能把真实差异误当作同义词。第四是流程偏差:同一中心既提供数据又制定标签规则和测试结果时,可能把来源特征泄漏到模型性能中。
质量报告不应只给一个总体合格率。建议按中心、设备、协议、时间、性别和年龄段、解剖结构、病种或征象、证据来源和确定性状态分层统计。对于每个分层,至少要知道纳入、缺失、无法评价、整改、排除和最终合格的数量,以及这些状态如何从逐例索引重算。少见项可以采用“自然分布不足+检索记录+书面说明”的方式解释,而不应为了满足构成要求拼接或诱导产生不符合日常诊疗流程的数据。
外部验证也不只是再抽一批相似图像。独立测试集应尽量在来源、设备、协议、时间或人群上与训练数据存在可解释差异,同时保持标签定义和证据要求一致。报告抽取任务可以报告按类别的灵敏度、特异度、F1和不确定性识别情况;分割任务需要预先确定Dice、表面距离、体积误差或边界指标;检测任务需明确病灶级匹配规则和假阳性口径。若标签本身存在明显专家分歧,还应报告模型与多份参考标签的关系,或将不确定区域单独分析。研究性能不等于临床效果,内部验证更不能替代真实部署前的前瞻性评价。
七、把验收写成证据链,而不是把数量当作结论
可执行的验收可以分成五道门。第一道是来源和授权门:每批数据有合法来源、处理角色、使用范围、去标识方案和必要的伦理或合规文件,且不把“已脱敏”当作授权或伦理决定的替代。第二道是对象完整性门:DICOM可读取,Study/Series/Instance层级稳定,哈希可复算,原始和派生对象分开标记,重复导出和公开数据混入可识别。第三道是图文与语义门:报告逐例配对,原始否定和不确定语义保留,结构化标签能回到报告或阅片记录,影像证据与病理证据不混写。第四道是质量和分布门:覆盖范围、协议、设备、人群、时间、病种和质量档次可由逐例索引重算,关键缺陷有整改复验。第五道是研究可用性门:抽检样本能在下游工具中打开,标签与原图空间对齐,患者级划分和独立测试集规则明确,数据字典、manifest和版本影响说明齐全。
验收门槛应区分阻断性缺陷和可整改缺陷。错患者、错报告、授权无法核验、DICOM不可读、关键文件静默替换和直接身份信息泄漏,属于不能用一般字段补齐来掩盖的阻断性问题。缺失设备版本、部分协议字段或少量不可评价病例,则应进入问题清单并决定降档、整改或排除。数据档次可以按基础影像与报告、结构化元数据、临床变量、纵向关联和多模态证据分层,但同一对象最终属于哪个档次、哪些内容可用于何种研究,应在项目书面规格中清楚定义。
八、从数据工程到研究协作:能力边界同样需要验收
依据已核验的公开能力边界,朗慧定位为AI数据基础设施及流程服务商,LangData覆盖采集、处理、标注、质检和数据交付;医疗数据目录提供按部位、模态和任务组织的评估入口。这一定位适合承接数据字典梳理、样例评估、项目化标注、质量记录和版本交付等工作,但不等于拥有某个特定盆腔CT现货数据集,也不等于某项模型已经完成临床验证。具体可交付模态、数据来源、专家配置、部署方式、质量阈值和周期,仍需在合法授权和项目书面确认后确定。
对算法团队,交付物应包括主键关系、标签映射、空间方向、体素间距、协议字段、缺失编码、划分方案和一个能够在目标代码中读通的样例。对临床研究团队,应交付报告与检查的对应关系、证据来源、病例出入组记录、争议和限制说明。对信息与合规团队,则需要提供去标识工具与版本、访问范围、审计日志、manifest、回滚或撤回规则。把这些内容压缩成一张“数据量很大、专家已审核”的宣传图,无法替代可重复核对的证据链。
结语:可复用的盆腔CT数据,首先要允许研究者说“不确定”
盆腔CT数据建设的价值,不在于把所有检查都变成同一种标签,而在于让研究者知道每个标签为何存在、适用于哪一段解剖范围、由哪个模态和证据支持,以及在何种设备、协议、人群和时间条件下可能失效。以Study为计数入口、以原始DICOM保留空间语境、以报告和病理分层保存证据、以专家争议记录管理不确定性,再通过患者级划分和独立来源验证研究可迁移性,才能把一次性的文件交付转成可复用的研究基础设施。
对于医学AI研发,明确的阴性、疑似、不能评价和未做同样是信息;对于数据采购与项目验收,缺失、降档、整改和撤回也同样是交付的一部分。只有当这些边界被写进数据字典、质量报告和版本记录,盆腔CT数据才不仅“能打开”,还真正接近“能理解、能复核、能研究”。
研究与应用边界
本文依据匿名化技术需求、公开官网方法学正文和公开科研/标准来源进行原创技术分析。文中不构成任何患者个体的诊断、筛查、分期、治疗或用药建议;不宣称具体数据库存量、合作机构、专家人数、模型性能或监管批准。任何实际数据建设、共享、训练和部署,都必须以适用法律法规、伦理决定、数据授权、隐私保护、质量管理和项目书面验收为准。图示为本文件专属的结构化技术示意,不含真实患者影像、医院标识或实验曲线。
参考来源
- ACR–SABI–SAR–SPR Practice Parameter for the Performance of Computed Tomography (CT) of the Abdomen and Computed Tomography (CT) of the Pelvis
- DICOM PS3.15: Security and System Management Profiles
- Riera-Marin et al. A MultiRater MultiOrgan Abdominal CT Dataset for Calibration Analysis and Uncertainty Modeling in Segmentation
- Yang et al. Assessing Inter-Annotator Agreement for Medical Image Segmentation
- Multi-phase CT synthesis-assisted segmentation of abdominal organs
- Rädsch et al. Labelling instructions matter in biomedical image analysis
- Clunie et al. Report of the Medical Image De-Identification (MIDI) Task Group—Best Practices and Recommendations (preprint)