
MEDICAL DATA RESEARCH
头部 MRI 数据集建设:把序列、病种与证据链组织成可验收对象
围绕头部MRI数据集建设,拆解Study计数、DICOM层级、序列与病种标签、报告证据、专家复核、去标识化、独立验证和交付验收,帮助医疗AI研发与数据采购建立可追溯、可复核的数据链路。
当研究团队拿到一批头部 MRI 时,最先需要回答的往往不是“有没有足够多的影像”,而是“这一行数据到底代表什么”。它是一次 MRI 检查、一个序列、一个病灶,还是一次带报告和随访关系的病例事件?如果同一检查的 T1、T2、FLAIR、DWI/ADC 被拆成若干条记录,或者增强序列、设备参数和报告语义在整理中丢失,后续模型即使能够读取文件,也未必知道自己学习的对象和临床语境。对于面向神经影像研究的大规模数据建设,真正需要采购和验收的不是一个“图片数量”,而是一条可以从检查对象追溯到序列、报告、证据、复核和版本的链路。
本文围绕头部 MRI 研究数据的项目化建设,讨论临床任务、模态组织、病种标签、标注主体、质量偏差、外部验证和交付逻辑。内容是面向医疗人工智能研发与数据采购读者的方法性分析,不构成个体诊断、筛查、治疗或疗效判断。文中所述样本范围、数据来源、标注层级、专家配置和验收阈值,都应在具体项目中结合合法授权、伦理要求、数据字典和书面规格进一步确认。
一、先确定计数单位:头部 MRI 不是“按文件数采购”
头部 MRI 的第一个工程问题是计数。对于研究数据,较稳妥的主计数单位通常是一次 MRI 检查或 Study,而不是序列文件、切片张数或导出的截图。同一次检查里可以包含多个 Series、多个 Instance、不同期相、不同重建或重复导出;若把这些都当成独立样本,表面数量会增加,实际却引入重复和信息泄漏。因而,数据字典应先定义全局唯一的匿名检查主键,再记录患者级匿名主键、检查时间的受控表示、检查目的、序列清单和报告关联。交付统计应由逐例索引重算,而不是由不可追溯的汇总表替代。
原始数据层建议优先保留可读取的脱敏 DICOM 及其 Study、Series、Instance 关系,同时把原始文件与研究转换文件分开标记。空间方向、位置、像素间距、层厚、磁场强度、线圈、序列名称、TR、TE、TI、b 值、对比剂和动态期相等信息,不能因为下游习惯转换成 NIfTI 就从数据血缘中消失。DICOM 的文件格式和媒体存储规则提供了影像对象交换的技术基础,但文件“能打开”并不等于层级、空间几何和采集语义都正确。Rorden 等人的研究以多个制造商和软件版本的 DICOM 测试数据,展示了采集参数在公共标签、私有标签和厂商专有结构中的差异,并将已知参数与 BIDS 风格的元数据对照,用于验证转换工具和提高可复现性。1 这提示采购方:原始对象、转换日志、元数据字典和已知缺失项,都应成为交付内容的一部分。
头部 MRI 的协议也不能只填写一个“脑 MRI”大类。常规结构序列、扩散成像、磁敏感序列、增强成像、血管成像、灌注、波谱和功能 MRI 所回答的问题不同,数据颗粒度也不同。ACR、ASNR 与 SPR 的脑 MRI 专业参数将检查的适应证、序列与技术规范、文档记录、设备、质量控制和人员责任放在同一检查框架中。2 对研究队列而言,实操上应把协议名称、实际覆盖部位、序列是否完成、序列是否可评价和“未做/未知/不适用”分开记录。一个没有 DWI 的检查不能被悄悄当成完整的急性卒中协议;一个只有派生激活图而没有原始 BOLD 时序的功能 MRI,也不能按完整功能数据计入同一层级。
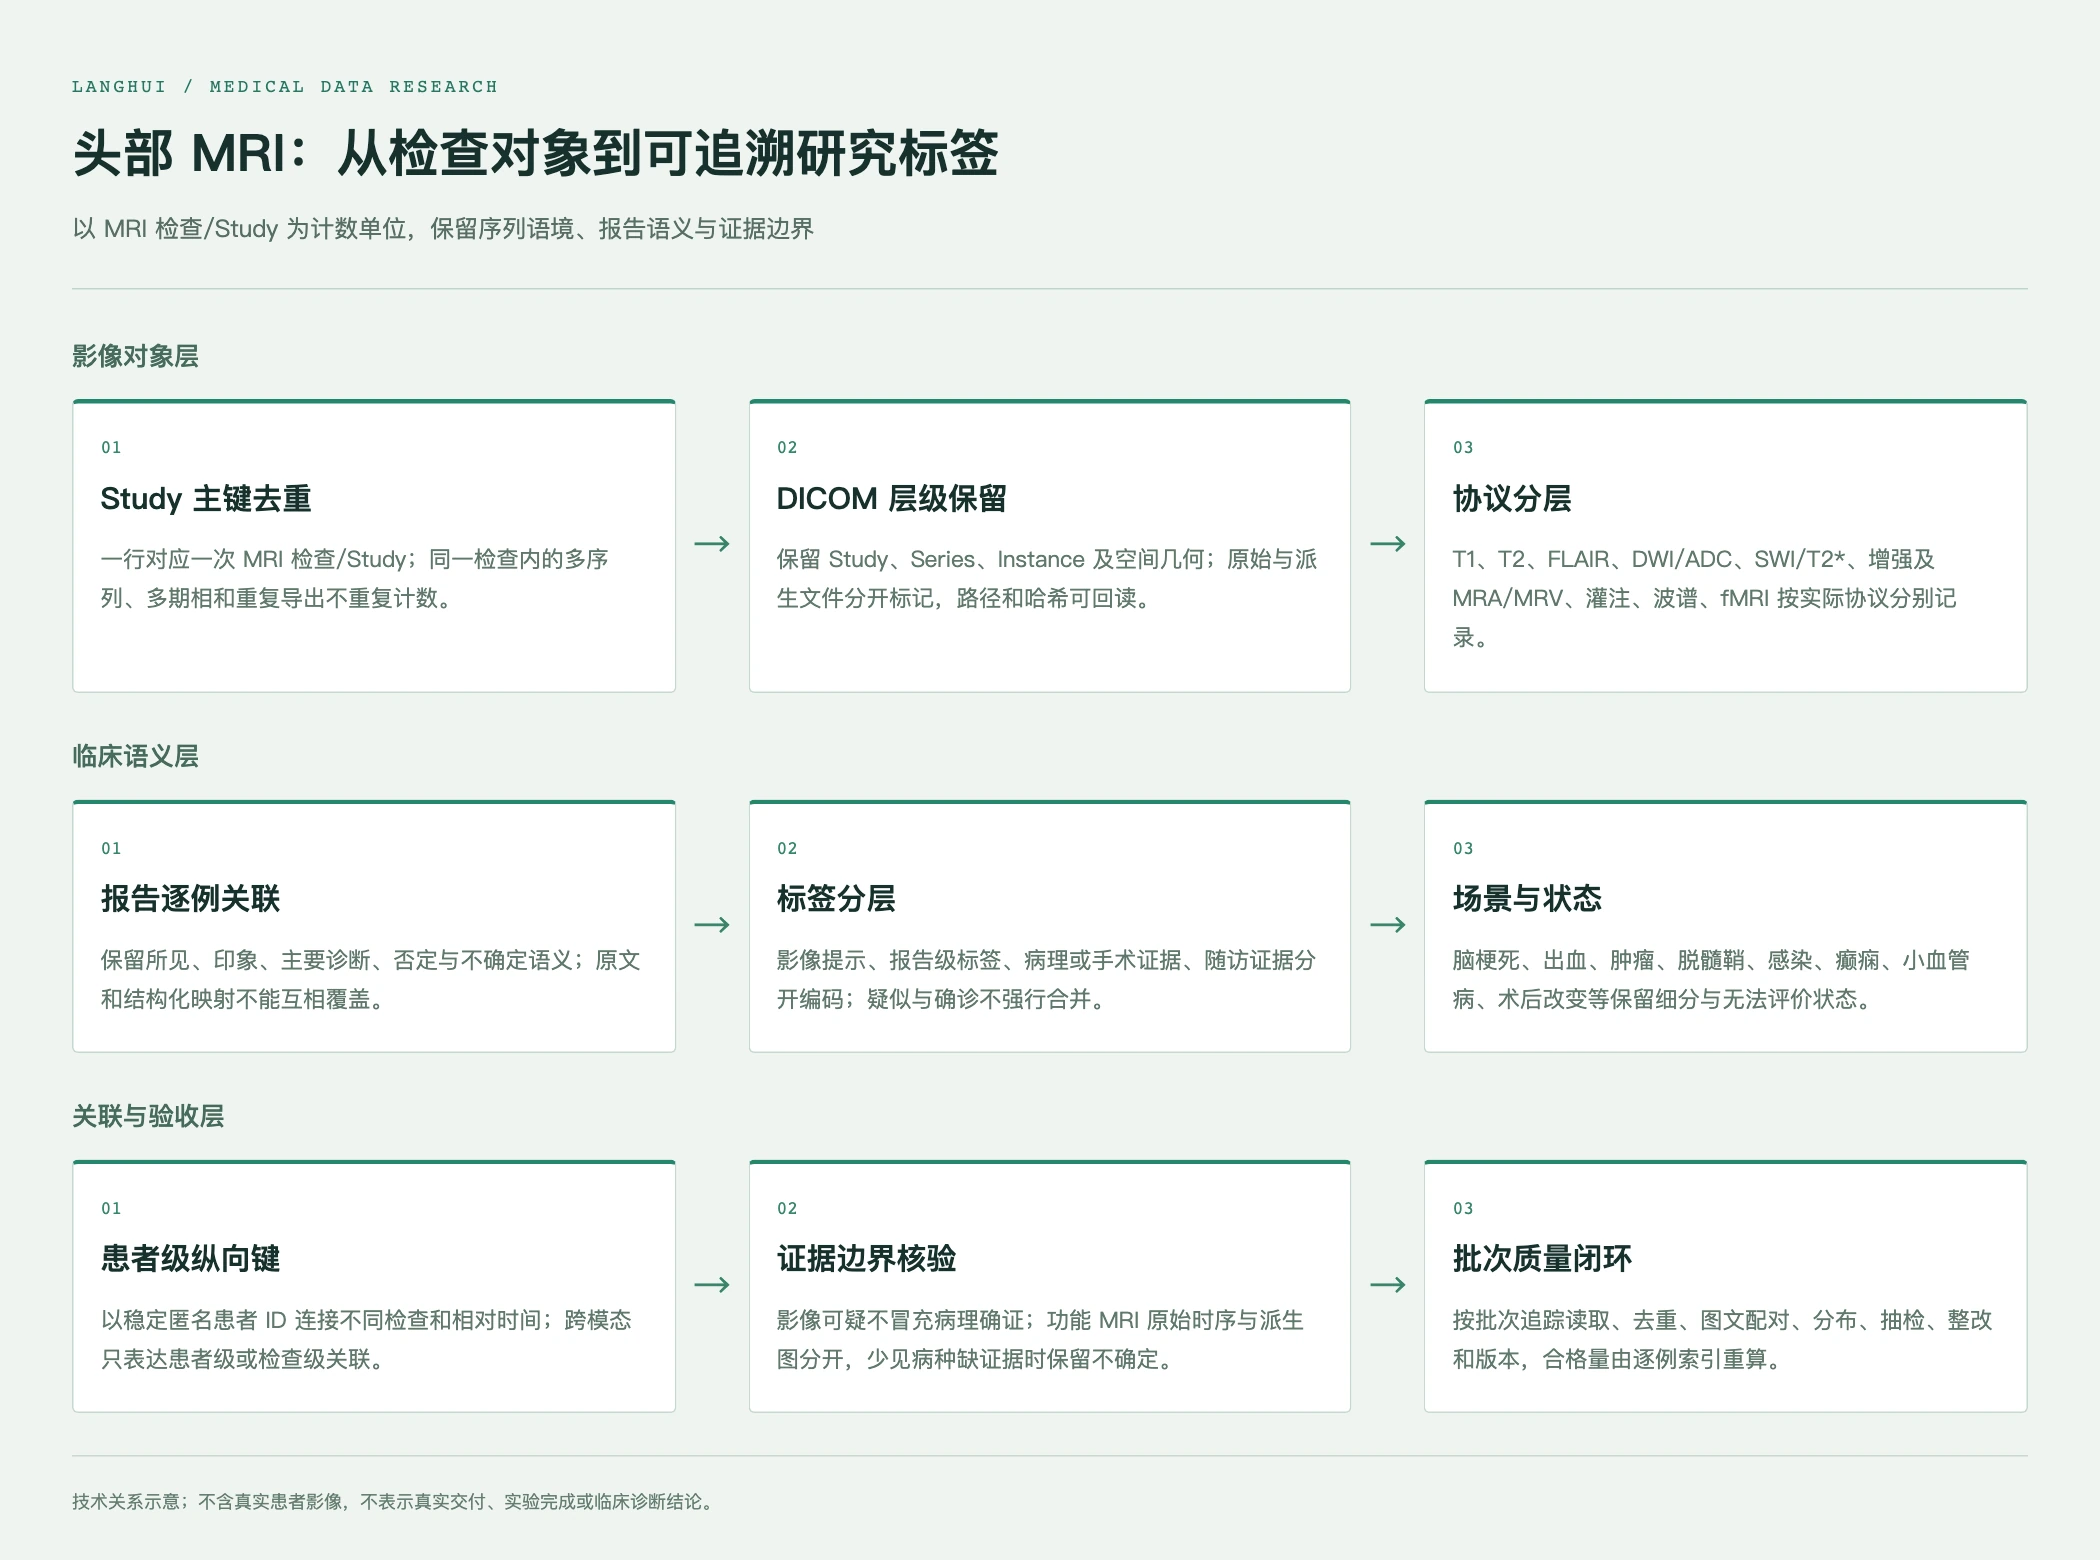
图 1 技术关系示意:以 MRI 检查/Study 为计数单位,依次连接 DICOM 对象、协议分层、报告语义、证据来源和批次质量闭环;不含真实患者影像,不表示真实交付或临床诊断。
二、把临床任务拆成标签层级,而不是把所有异常压成一个类别
头部 MRI 需求常同时包含影像检索、报告结构化、病灶检测、分割、疾病分类和纵向变化分析。它们的输入输出不同,不能共用一个笼统的“阳性/阴性”字段。对检查级任务,输入可以是一次完整的多序列 MRI,输出是协议完整性、可读性、检查目的或报告级状态;对序列级任务,输入是一个 Series 或一组配对序列,输出是序列类型、参数质量或缺失状态;对病灶级任务,输入是同一次检查内具有空间关系的序列集合,输出才可能进一步包括病灶位置、范围、数量、形态或分割掩膜。每个输出都应写明对应的颗粒度和证据来源。
疾病导向队列可以覆盖脑梗死、陈旧性梗死或软化灶、脑出血与微出血、胶质瘤、脑膜瘤、脑转移瘤、脱髓鞘疾病、感染、癫痫相关结构异常、脑小血管病、脑积水或脑脊液循环异常、血管畸形、神经退行性改变和术后或治疗后改变等场景。这里的意义不是把一份采购清单原样搬进文章,而是说明每种场景都要有自己的最小证据条件。急性梗死需要关注 DWI 与 ADC 的成对可用性,并防止 T2 shine-through 被误写成弥散受限;磁敏感序列上的低信号不能单独把钙化和出血分开,必要时需要跨模态证据;胶质瘤的分级和分子类型不能从 MRI 外观直接替代病理;术后、放疗后改变、假性进展和真进展也不宜在没有来源依据时合并为一个标签。
因此,“明确阳性”“明确阴性”“疑似或考虑”“不能除外”“治疗后改变”“无法评价”和“真正缺失”应是不同的状态。报告中的不确定语气是临床语义的一部分,不是等待算法清洗掉的噪声。影像报告、病理、手术、检验和随访都可以作为证据来源,但它们的医学含义不同,数据表应保留来源类型、日期或关联对象,而不是只留下一个没有解释的最终类别。对没有病理或充分随访支持的病例,可以保留影像倾向与不确定性,不能为了满足类别比例强行改成确诊。
纵向和跨模态关系也要限定边界。稳定的匿名患者 ID 可以连接不同时间点的 MRI,检查级关联可以指向同一患者的 CT、病理、手术、检验、治疗或随访,但这种关联并不意味着像素级配准、病灶级对应或病理证实。若项目没有提供可复核的空间配准和病灶 ID,就应明确写成患者级或检查级关系。对于功能 MRI,静息态或任务态的原始时间序列、任务范式、运动参数、预处理版本和派生激活图应分层保存;正常对照和功能成像子集也应独立统计,避免与普通脑 MRI 混成一个协议。
三、标注不是“找一个专家看一遍”:需要证据、分歧和版本共同组成真值
头部 MRI 数据的标注主体,应由任务风险和输出类型决定。基础的检查级字段可以由经过培训的数据标注人员按照字典转录和核对,报告级语义、序列归类和关键病种应由具备相应影像专业能力的复核者审阅,涉及病理关联、复杂治疗后改变、少见疾病和争议病例时,则需要在项目范围内安排更高层级的医学仲裁。标注职责、复核职责和仲裁职责应相互区分,不能用“有专家审核”一句话代替人员资格、可见信息、盲法设计和分歧处理规则。
专家工作首先应确认检查范围和序列是否满足任务前提,再判断报告语义与影像是否一致。对需要病灶空间标签的项目,初标与复核应回到原始序列和多平面空间,而不是只看截图或报告文本。对多发病灶,应使用稳定的病灶 ID 区分对象,并记录不同序列和不同时间点之间的对应是否有来源支持。对无法可靠确定边界的区域,可以使用“不可判定”“待复议”或项目约定的其他状态;不应为了让掩膜闭合而由标注人员自行补画。自动或半自动算法生成的区域只能在审核通过前作为草稿,不能直接进入金标准、特征提取或测试集。
CLAIM 2024 更新版要求研究者明确数据来源、预处理、去标识化、缺失数据处理、真值定义、人工标注者数量和资格、标注软件版本、观察者间差异处理,以及训练、验证和测试数据的划分方式。3 这些要求同样适合倒推数据采购。对于头部 MRI 项目,交付方至少应提供标签字典、培训样例或规则说明、标注与复核状态、争议记录、版本号、软件或转换工具版本和必要的回溯关系。质量指标如一致性、Kappa、Dice 或 IoU,必须先约定抽样单位、参考勾画、计算实现和适用标签;它们是特定流程的质量证据,不是公司统一准确率,也不能直接转换为临床效果。
四、算法路线要服务于数据结构,不能用模型名称掩盖输入不一致
当任务是序列识别或协议质检时,可先采用规则、DICOM 元数据和图像内容相结合的路线。Gauriau 等人的脑 MRI 研究指出,临床协议会因机构习惯、设备限制和现场调整而产生差异,序列命名并不可靠;研究因此利用 DICOM 元数据对脑 MRI 序列进行分类,并讨论了厂商、型号、软件版本和采集参数变化带来的挑战。4 这类研究的启示是,采购数据时应保留可解释的元数据,而不是把所有序列先转成外观相似的图像再让模型猜类别。序列分类模型的输入、人工确认范围和“未知”出口,都应写入试点验收。
当任务是报告结构化时,应把原始报告、结构化字段、否定和不确定语义分开。规则抽取、自然语言处理或多模态模型都可以作为研发路线,但模型输出不能覆盖原始报告,派生标签应写明规则版本和证据位置。对于病灶检测与分割,路线可以从多序列配准、质量筛选、候选区域检测、三维分割、专家修订到独立评估展开;但是否能够跨序列配准、是否保留体素几何、是否存在明显运动或缺序列,都必须在数据门控阶段处理。对于肿瘤、梗死或出血等任务,模型评价应按病种、协议、病灶大小、设备和来源分层,不应只报告一个混合平均分。
公开的纵向脑转移数据集提供了一个具有参考意义的组织范式:研究者保留了多种标准脑 MRI 序列、治疗前后随访、病灶子区域分割和采集参数,并在纳入前检查序列完整性与运动伪影,在技术验证中由专业人员复核自动或半自动结果。5 另一个公开的长期脑转移影像资源则同时提供序列影像、扫描仪和采集参数,并通过规则化的序列选择和命名维护纵向一致性。6 这些公开资源的病例规模、来源和任务设定不能外推为任何项目的库存或临床效果,但它们说明:纵向 MRI 的关键不是把多个时间点放在一个文件夹,而是让时间点、治疗状态、序列条件、影像对象和标签版本保持可解释关系。
训练、验证和测试应按患者级或项目明确的独立单位划分,不能把同一患者的不同时间点、同一次检查的相邻序列或高度相关的派生文件拆到不同集合。需要外部验证时,应在开发阶段之外留出不同来源、设备、协议或时间段的数据,并预先规定不重新调参的评估流程。外部验证的价值在于暴露分布变化和失败模式,而不是自动证明临床可用。模型结果还应区分研究性能和临床性能:在冻结数据集上的敏感度、特异度、Dice、F1 或 FROC,只描述该任务、样本构成和评估口径下的实验表现,不能替代前瞻性临床验证或监管评价。
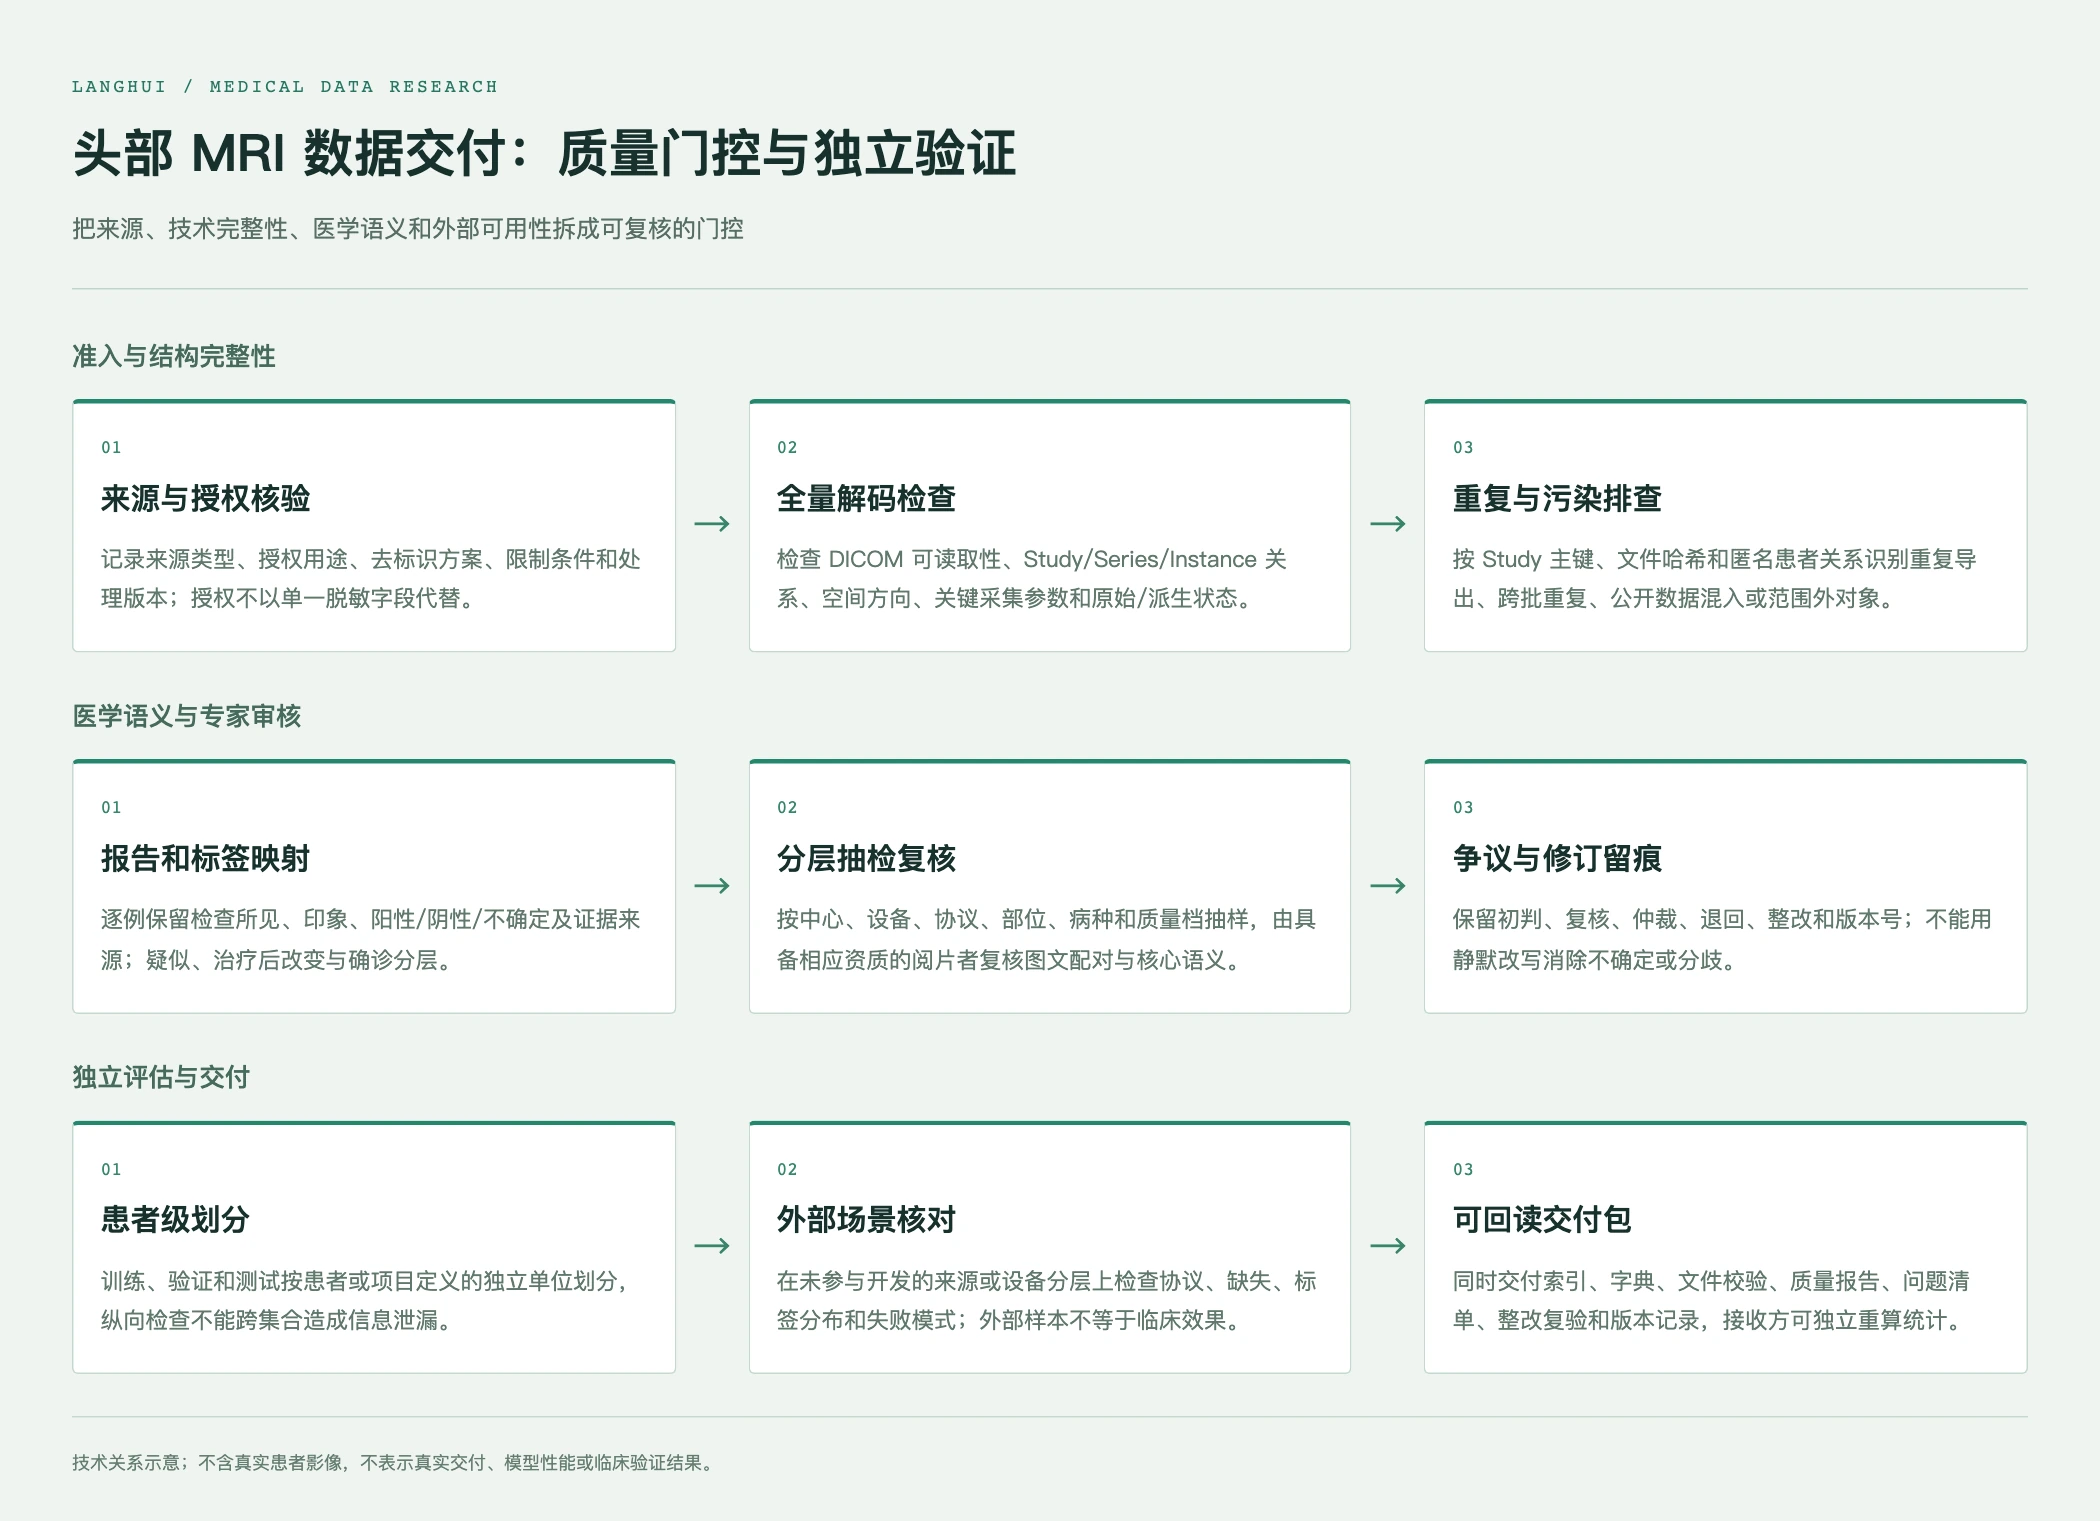
图 2 技术关系示意:从来源与结构完整性,到医学语义复核、患者级划分、外部场景核对和可回读交付;不含真实患者影像,不表示模型性能或临床验证结果。
五、把质量写成门控:来源、技术、医学和外部有效性不能互相替代
头部 MRI 数据质量至少有四个不同层面。来源质量关注授权用途、处理角色、去标识方案、访问边界和撤回或更正记录;技术质量关注 DICOM 可读取性、Study/Series/Instance 关系、空间几何、序列完整性、采集参数和原始/派生状态;医学质量关注检查范围、报告配对、标签定义、证据层级、专家一致性和不确定状态;研究质量则关注患者级划分、设备和中心分布、时间分布、外部验证以及错误分析。它们不能压缩成一个总分,也不能用“影像看起来清楚”替代授权和来源审计。
DICOM 的保密配置文件明确提醒,属性层面的去标识并不保证整个信息对象已经完成去标识化,去标识方案还需要结合共享目的、接收者、适用规则和再识别风险评估。7 对头部 MRI 而言,文件头并不是唯一风险来源,像素内烧录文字、私有标签、检查日期、UID 关系和面部特征都可能影响数据安全与纵向关联。项目应记录使用的工具、版本、私有标签处理、UID 重映射策略、像素检查、抽检结果和限制条件;去标识后仍需验证患者级关系未被错误合并、同一检查的引用没有断裂、原始与派生对象的关系能够解释。
技术抽检应按来源、设备、协议、年份、部位、病种和质量档分层,而不是只抽取最容易读取的病例。抽样可以包括原始 DICOM 全量自动解码、Study 去重、文件哈希核对、序列完整性、报告逐例配对、空间方向、关键参数缺失以及标签和证据一致性。对高风险少见场景,不能用常见病种的抽检结果替代;对功能 MRI、灌注、波谱或特殊血管成像,也不能按普通结构 MRI 的标准直接判定合格。
外部验证还要检查数据分布是否合理。某一来源、设备、协议、年龄段或疾病构成过度集中,可能让模型把采集条件而不是疾病特征当成线索。需求中提出的中心覆盖、阳性构成、独立抽检和设备多样性,应在项目中转化为可重算的统计维度,并同时报告未知值、未做、不可评价和剔除原因。跨模态关联率也要谨慎解释:能在患者级挂接 CT 或病理,并不等于每一次影像都存在病灶级对应,更不等于某个影像标签获得病理证实。
六、验收要验收“研究能否复现”,而不只是文件能否打开
头部 MRI 数据交付可以采用“试点—冻结—批量—复验”的节奏。试点阶段用一组脱敏样例验证计数单位、主键规则、序列分层、报告配对、标签字典、缺失编码、导出格式和下游回读;如果发现“同一检查被拆成多个样本”“疑似被写成确诊”“派生图找不到原始序列”或“纵向时间顺序不明”等问题,应先修订规则再扩大批次。冻结后,任何字段、病种、协议、最低量或例外口径变更,都应生成新版本并说明对既有批次的影响,不能在原交付包中静默覆盖。
正式验收应至少包括五类证据。第一是逐例索引,能够按 MRI 检查/Study 去重,列出送检、合格、整改、剔除和累计数量。第二是文件级和序列级质量报告,包括可读性、完整性、哈希、原始/派生状态和空间信息。第三是医学语义和报告配对抽检,明确阳性、阴性、不确定和无法评价的判定依据。第四是来源、设备、协议、人群和年份的分布统计,以及独立抽检子集与常规交付的去重关系。第五是问题清单、整改记录、复验结果、版本号和可回滚或撤回说明。接收方应能使用逐例索引重算主要统计,而不是只能相信一页汇总数字。
采购和业务逻辑也应围绕可核对对象展开。数据提供、医学标注、平台工具、部署接口、存储、算力和培训是不同工作包;是否需要原始 DICOM、转换格式、报告结构化、病灶分割、纵向关联或外部验证,应在需求确认时分别列出。按检查数、序列数、切片数、病灶数或标注工时计量,会对应不同的质量和验收风险,不能在项目中途互换。对于较高质量档的数据,增加完整序列、结构化报告、临床背景和跨模态关联时,也应同步增加证据、复核、隐私和版本要求,而不是只把字段数量写进交付清单。
七、公司能力如何与项目边界对齐
从已核验的公司定位看,朗慧科技是 AI 数据基础设施及流程服务商,自研 LangData 平台覆盖采集、处理、标注、质检和数据交付;医疗栏目提供按部位、模态和任务组织的数据目录与项目化评估入口。这些事实支持围绕头部 MRI 项目开展需求梳理、数据字典设计、样例评估、标注与复核流程、质量记录和版本化交付讨论,但不证明存在可直接交付的固定库存、某一病种的现货比例、统一专家规模或已经完成的临床验证。
在实际项目中,可先将研究问题拆成“检查入库、序列分层、报告结构化、病灶或征象标注、跨模态关联、独立评估”中的一个或多个工作包,再由专业审核人员和项目负责人确认标签、证据和质量口径。平台或工具可以帮助记录对象、状态、权限、版本和导出关系,但平台能力不等于数据已经合法取得,也不等于某个模型已经对该病种有效。涉及医疗用途的软件还需要独立确认研究设计、临床验证、监管边界和最终使用责任。
对研发团队而言,最有价值的交付物不只是一个目录,而是能够回答“某条标签为什么存在”“它来自哪一次检查和哪一组序列”“它是否被独立复核”“哪些病例不能用于某个任务”“如果规则改变,哪些结果需要重算”。对数据采购方而言,最重要的也不是被一个总量数字吸引,而是能否在授权、元数据、医学语义、独立抽检和下游回读之间建立证据闭环。只有这样,头部 MRI 数据才可能从一次性交付的文件集合,变成可复用、可审计、可迭代的研究基础设施。
结语:让每一个 MRI 样本都带着自己的适用边界
头部 MRI 的价值来自多序列互补、疾病谱差异、纵向变化和临床证据之间的关系,而不是来自一张孤立的图像。面向医学人工智能的数据建设,应以检查/Study 定义计数单位,以 DICOM 层级和空间参数保留影像语境,以报告、病理、手术和随访分层表达证据,以患者级划分防止泄漏,以专家复核和争议记录管理不确定性,以外部来源和设备分层检验泛化风险,最后把索引、字典、校验、质量报告和版本记录一并交付。
这样的流程不会自动产生临床效果,也不会把复杂的神经影像问题简化成一个模型分数;它的研发价值在于让数据使用者知道模型输入是什么、标签从何而来、哪些结论不能推出,以及当新序列、新病种或新验收要求出现时,数据应如何扩展而不破坏已有血缘。对于医疗 AI 团队和数据采购方,这种可追溯的边界管理,往往比单纯增加文件数量更接近真实的研究生产力。
参考来源
- DICOM datasets for reproducible neuroimaging research across manufacturers and software versions
- ACR–ASNR–SPR Practice Parameter for the Performance and Interpretation of MRI of the Brain
- Checklist for Artificial Intelligence in Medical Imaging (CLAIM): 2024 Update
- Using DICOM Metadata for Radiological Image Series Categorization in Brain MRI
- A longitudinal MRI dataset of brain metastases with tumor segmentations and radiotherapy data
- Yale-Brain-Mets-Longitudinal: Yale longitudinal dataset of brain metastases on MRI with associated clinical data
- DICOM PS3.15: Attribute Confidentiality Profiles
- The Brain Imaging Data Structure (BIDS) specification