
MEDICAL DATA RESEARCH
胎儿超声多模态数据如何可验证交付:从一次检查主键到外部验证
面向医疗AI研发与数据采购读者,说明胎儿超声如何按Study去重,关联原始影像、动态图、报告和证据层,区分未评价与阴性,并通过专家复核、版本治理和独立外部验证形成可复核交付。
胎儿超声人工智能研发中,一个容易被忽略、却直接决定模型能否复现的问题是:交付的究竟是一张“看起来像胎儿”的图,还是一项可追溯、可解释、可重新核验的临床检查。前者可以支持演示,后者才可能支撑标准切面识别、生物测量、质量控制、异常提示或报告语义建模。对于胎儿超声而言,临床任务跨越早孕筛查、中孕系统筛查、晚孕生长评估和复查;输入既有静态图,也可能有连续扫查视频、测量信息、设备参数及结构化报告;输出还必须区分正常、异常、疑似、不能评价和后续确证。若这些层级在入库时被压扁,模型训练得到的可能是设备水印、报告模板或中心习惯,而不是可迁移的医学信号。
因此,胎儿超声数据项目的关键不在于先承诺一个庞大的病例数字,而在于先冻结对象、模态、标签和验收关系。本文围绕一个可匿名改写的技术需求,讨论如何把一次检查组织成稳定的数据单元,如何把可评价解剖结构和不确定语义交给专家标注,如何把质量控制从“交付后抽查”前移到采集与建模全过程,以及如何用独立中心、不同设备和真实工作流检验外推边界。文章讨论的是研发数据与交付设计,不构成对任何个体的诊断或治疗建议。
一、从临床任务开始,而不是从文件格式开始
胎儿超声不是单一分类任务。最基础的任务是识别检查阶段、标准切面和可评价结构;进一步的任务包括头围、腹围、股骨等生物测量,羊水、胎盘和脐带的记录,生长受限或生长过快等征象的分层,以及脑、心脏、颜面、胸腹壁、泌尿和骨骼等系统异常的提示。多胎还需要胎儿级编号、绒毛膜性与羊膜性等关系字段。每个任务对应的输入和输出粒度不同:切面识别常以帧或短片段为输入,测量可能需要标准平面与标尺,结构异常提示可能需要完整检查与报告上下文,纵向研究则需要同一胎儿在不同时间点的稳定关联。
一个实用的需求拆解可以先回答五个问题。第一,临床对象是什么:一次产前超声检查、检查中的某一胎儿,还是一个结构或测量项目。第二,输入模态是什么:二维灰阶静态图、彩色或频谱多普勒、三维或四维派生数据、设备原始动态图,还是结构化报告与其他临床信息。第三,输出要达到什么粒度:检查级、胎儿级、序列级、帧级、结构级、测量级还是文本语义级。第四,标签由谁给出:采集者、受训标注员、产科超声专家、胎儿医学专家,或由出生、手术、病理和遗传检测提供后续证据。第五,哪些状态必须保留:明确阳性、明确阴性、疑似、考虑、不能除外、未做、未评价、图像质量不足和未知。
这里尤其要避免把“未见异常”和“没有评价”混为一谈。某个结构没有进入诊断视野,或者因胎位、遮挡和图像质量无法判断,不能被编码为阴性。相反,正常发育对照是模型学习筛查边界所必需的,不能为了追求阳性样本比例而排除。对异常病例,也不应把影像提示直接升级成出生后或病理确证;产前影像、遗传结果、分娩结局、手术和病理应作为不同证据层分别关联。这样做会增加字段和审核工作,却能避免标签泄漏、过度诊断和错误的“金标准”。
AIUM的产科超声实践参数把高质量检查的执行与记录作为最低质量依据,同时明确其并非法律标准或所有病例的固定流程2。这对数据项目的启示是:专业指南可以帮助定义完整检查、标准切面、生物测量和检查局限,但不能未经项目书面确认就自动变成统一硬阈值。数据字典应把指南术语、原始报告用语、实际采集范围和项目验收口径并列保存,允许后续研究者知道“这个标签为何存在”。
二、以一次检查为主键,重建完整的多模态上下文
胎儿超声数据的第一层治理是计数和关联。一次产前超声检查或Study应作为主要计数单位;同一次检查中包含的多序列、多期相、多视图和重复导出不应被拆成多例。多胎可以在该Study下建立胎儿子记录,但必须保留检查级与胎儿级的关系。这样既避免数量被重复导出放大,也为同一检查中的不同胎儿保留可计算的对象边界。后续的模型划分、抽检和结算都应围绕这个主键执行,而不是围绕文件数量执行。
主键稳定以后,才能设计模态层。原始静态图应保留标准切面、测量游标、单位、胎儿编号、孕周依据、探头、设备型号和关键采集参数;原始动态图或cine应保留帧顺序、时间信息、必要的采集范围及原始/派生状态。DICOM的超声多帧信息对象把Study、Series、Equipment、Acquisition、Image、Cine、Multi-frame和US Image等模块纳入同一对象结构1,说明动态图不能简单当作一组无顺序的截图。若设备实际只产生静态对象,就应明确记录“未获取动态数据”,而不是用拼接图制造一种不存在的连续性。
报告关系也需要逐例设计。检查名称、检查所见、结论或印象、主要诊断、细分条目、否定语义和不确定语义应与影像稳定关联;报告截图或PDF可作为证据文件,但不应替代结构化字段。影像和文字发生冲突时,应建立冲突状态,保留两者的来源和版本,由专业复核者处理,而不是静默地选择其中一方覆盖另一方。对“未做”“不可得”“未知”“阴性”使用不同编码,能让模型在缺失数据下学习真实边界,而不是把缺失误当成正常。
纵向与跨模态信息必须按证据等级组织。产前筛查或诊断、遗传检测、分娩、新生儿结局、手术和病理可以通过患者级、检查级或事件级关联键连接,但这种连接不等于像素级、病灶级或病理级标注。时间顺序、比较检查和随访状态应可追溯;治疗后改变、失访和无事件也要与“未发生”分开。对研究者而言,这些字段使模型可以回答不同问题:一个模型可能只学习图像质量,另一个模型研究生长轨迹,还有一个模型利用出生后证据评估产前提示。若所有证据被压缩成一个“阳性/阴性”列,后续再拆分几乎不可能。
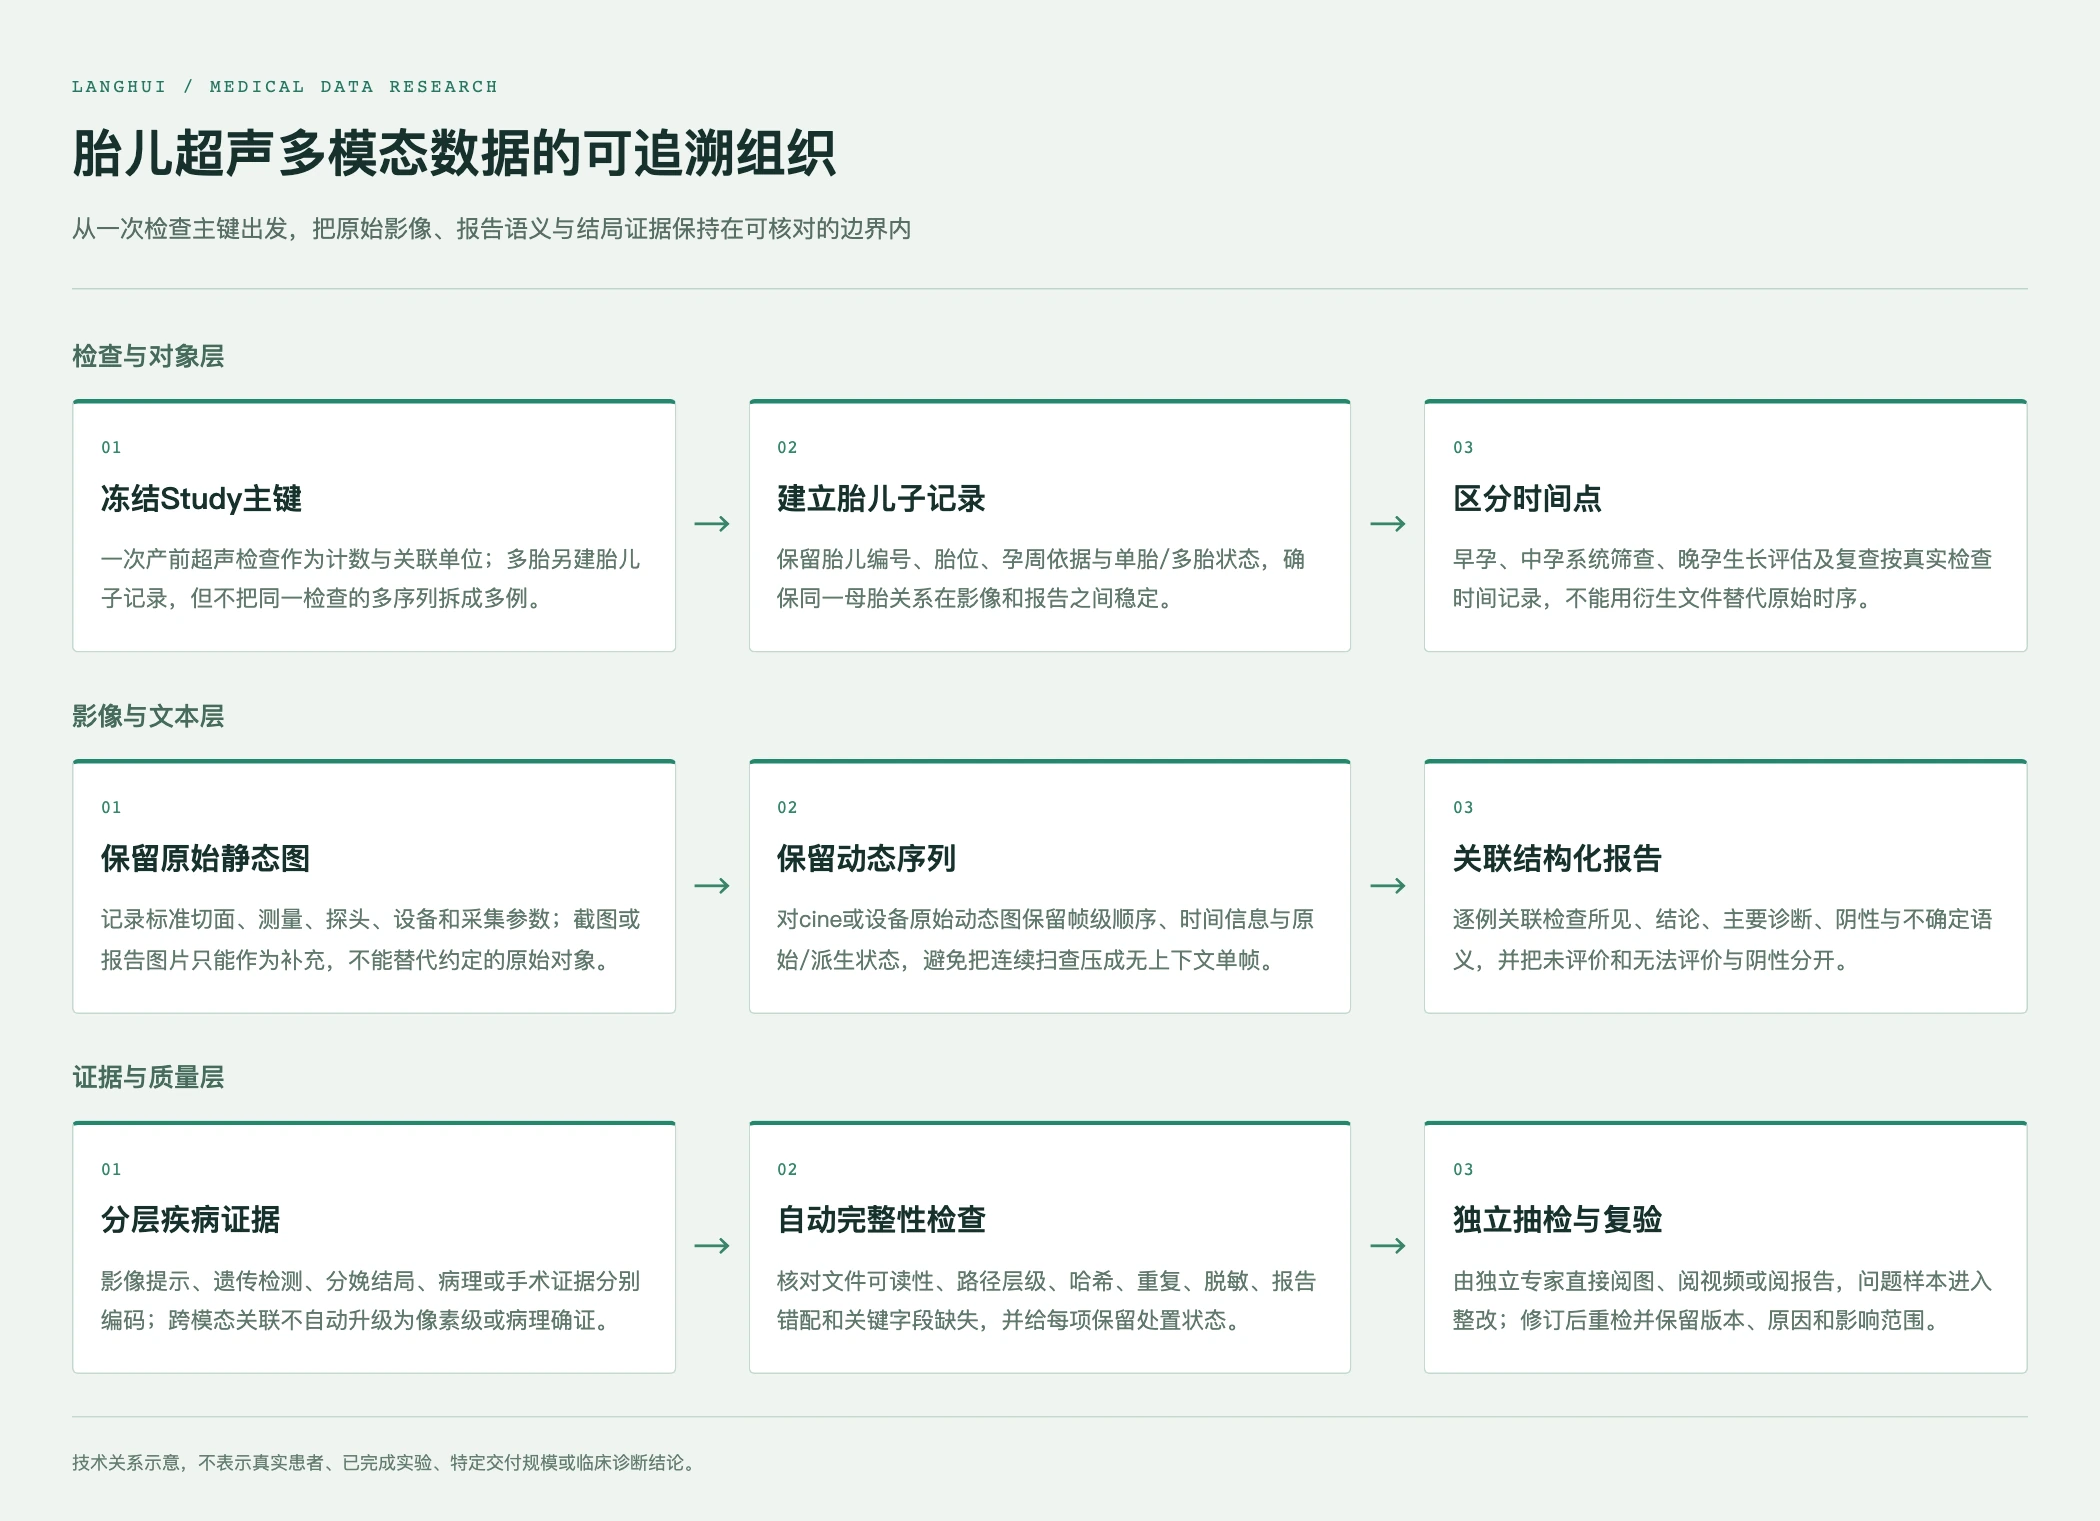
图1|胎儿超声多模态数据的可追溯组织。技术关系示意,不表示真实患者、特定交付规模或临床诊断结论。
三、原始数据优先,但原始不等于天然可用
保留原始DICOM或设备原始动态图的价值,不只是图像分辨率更高。原始对象携带检查层级、设备、采集和时间信息,能够帮助研究者识别设备域偏移、不同预设造成的视觉差异,也能在发现错配时重新定位问题。对于标准切面识别和测量任务,连续帧提供了“操作者如何扫查到目标平面”的上下文;对于质量控制任务,非标准帧同样重要,因为模型需要学会拒绝不完整或不可评价的图像,而不是只在精选好图上工作。
但原始文件不能替代质量定义。每个项目仍需明确可接受的视野、方向、图像占比、结构可见性、测量点放置、遮挡、伪影、增益和未到达约定切面的处置。设备厂商、型号、软件版本、探头和协议应与文件头或设备导出信息核对;未知值要显式记录,不应用推测值补齐。对动态数据,帧率和时间范围应作为实际属性记录,不能把“有视频”当作“视频完整”。对三维或四维派生数据,也要注明其来源与派生过程,不能把它与二维原始检查混在同一模态标签下。
数据完整性还包括文件和关系完整性。每个文件需要有相对路径、对象层级、大小、格式、原始/派生标记和摘要;接收端能够重算这些信息。匿名化要同时检查DICOM头、私有属性、自由文本、图像内文字和可重识别的日期关系,稳定的匿名ID要让影像、报告、标本与派生对象能够重新关联。若项目需要跨时间点关联,应在保护身份的前提下保存受控的相对时间,而不是随意打乱时间顺序。任何更正都应形成新版本或差分包,记录旧新摘要、影响对象和回滚方式,禁止静默覆盖。
质量检查可以按三个层次布置。机器层检查可读性、完整性、格式、哈希、重复、路径和字段缺失;关系层检查Study、Series、Instance、报告与胎儿编号是否错配;专业层由经过相应训练的专家直接阅图、阅视频和阅报告。三层检查必须分别留痕,因为“文件能打开”不等于“标准切面可评价”,“报告能读取”也不等于“报告与图像属于同一检查”。
四、算法路线:把检查质量、测量和疾病标签拆开验证
算法路线不应从“上一个大模型”开始,而应从任务之间的依赖关系开始。第一步可以是输入质控和对象识别:检测文件是否可解码,识别检查阶段、胎儿编号和候选标准切面,区分可评价与不可评价帧。第二步是结构与测量:在符合切面条件时识别头部、腹部、股骨、心脏或其他目标结构,输出测量点、单位、置信度和质量原因。第三步才是异常提示或报告语义抽取,并且要把影像提示和后续确证分开建模。多模态融合可以把报告文本、孕周、设备和纵向信息作为附加输入,但每个字段的可用时间点和缺失机制都要明确,不能把出生后信息泄漏到产前预测任务。
动态图需要与静态图不同的建模思路。连续扫查中大多数帧并不是标准平面,模型需要先筛选候选帧,再聚合多帧证据,或直接对短片段进行时序建模。一个在20周超声上进行的全检查研究使用神经网络对每一帧进行平面分类和生物测量,并用贝叶斯方法聚合整个检查的测量、拒绝离群值,同时在1457段记录和约4800万帧上进行回顾性评估3。这一研究说明,完整视频能提供比单帧更多的测量证据;但它的实验设置、样本来源和评价指标属于该研究,不能直接转化成任何数据供应商的临床效果承诺。
质量模型也应单独验收。质量评分不是疾病诊断,不能用异常检出率替代。2025年的一项孕早期研究基于多中心数据开发图像质量审计系统,并在567例临床病例上比较AI反馈前后标准图像比例,报告了与专家评价的一致性和不同经验操作者的变化4。这类结果支持把“是否达到可评价标准”“哪一项质量原因不满足”“反馈后是否改善”作为独立任务,而不是用一个总体准确率概括所有能力。对于数据项目,更重要的是把专家参考标准、反馈版本和失败样本一起交付。
报告生成或多模态问答需要更严格的约束。模型可以提出结构化候选,但不应自动生成超出影像证据的确诊、预后或治疗结论。对阴性与不确定语义,应保留原文语气和证据来源。模型训练时,来自同一患者的报告、随访、出生结局不能跨训练、验证和测试集合,否则模型可能通过模板或后续结局获得不当线索。建议分别报告切面识别、结构检测、测量误差、质量分类、报告字段抽取和异常提示的指标,并按孕期、中心、设备、图像质量、单胎/多胎和疾病构成分层。
五、专家标注不是把意见“平均”掉
胎儿超声标注的主体应与任务匹配。受训标注员可以完成文件级清点、字段录入和明确的结构定位;涉及标准切面、可评价边界、生物测量、异常倾向和不确定语义时,需要产科超声或胎儿医学领域的专家制定规则并参与审核。若任务要求将产前影像与出生、手术、病理或遗传证据关联,后续证据的来源、时间和适用范围也要由具备相应知识的人员复核。不同角色的工作应在记录中区分,避免把“录入完成”误写成“临床确认”。
标注流程应先写规范再做样例。规范要给出正例、反例、边界例和不能判断的例子,明确结构是否必须进入视野、切面质量到何种程度才能测量、测量单位如何保留、疑似和确诊如何编码。标注者独立工作后,再进入盲审或交叉审核;对不上时进入裁决,而不是用多数票抹平少见但重要的专业分歧。裁决记录需要说明争议字段、依据、结论、标注指南版本和是否影响既有数据。规则发生变化时,应重新评估受影响样本,并在版本差分中列出变化。
参考标准也要分层。正常对照应确认约定结构和切面实际可评价,而不能仅凭报告中一句“未见异常”。疾病标签应保存原文表达、标签来源、时间和证据强度;影像提示、疑似和后续确证不得混成一个标签。对于多胎,每个胎儿必须有独立记录和稳定编号,不能把某一胎的测量或结局借给另一胎。对治疗后改变、未检测、失访、无事件和无法评价,应分别编码,这些状态对于训练缺失机制和评估模型安全性很重要。
前瞻性或跨机构验证还应评价解释是否真正帮助操作者。一个2025年的研究使用回顾性标注数据开发胎儿生长扫描的可解释模型,并在多个机构的前瞻性视频上让临床使用者评价标准平面质量、结构分割和解释的正确性与有用性5。这类研究提醒我们,模型给出热图或分割并不自动等于可解释;解释必须由目标用户检验,且要观察低质量图像、不同经验操作者和跨机构使用时的失败模式。对于项目验收,应该把“模型输出能否被复核”和“复核者能否据此发现问题”纳入验收设计,而不是只验收一个离线分数。
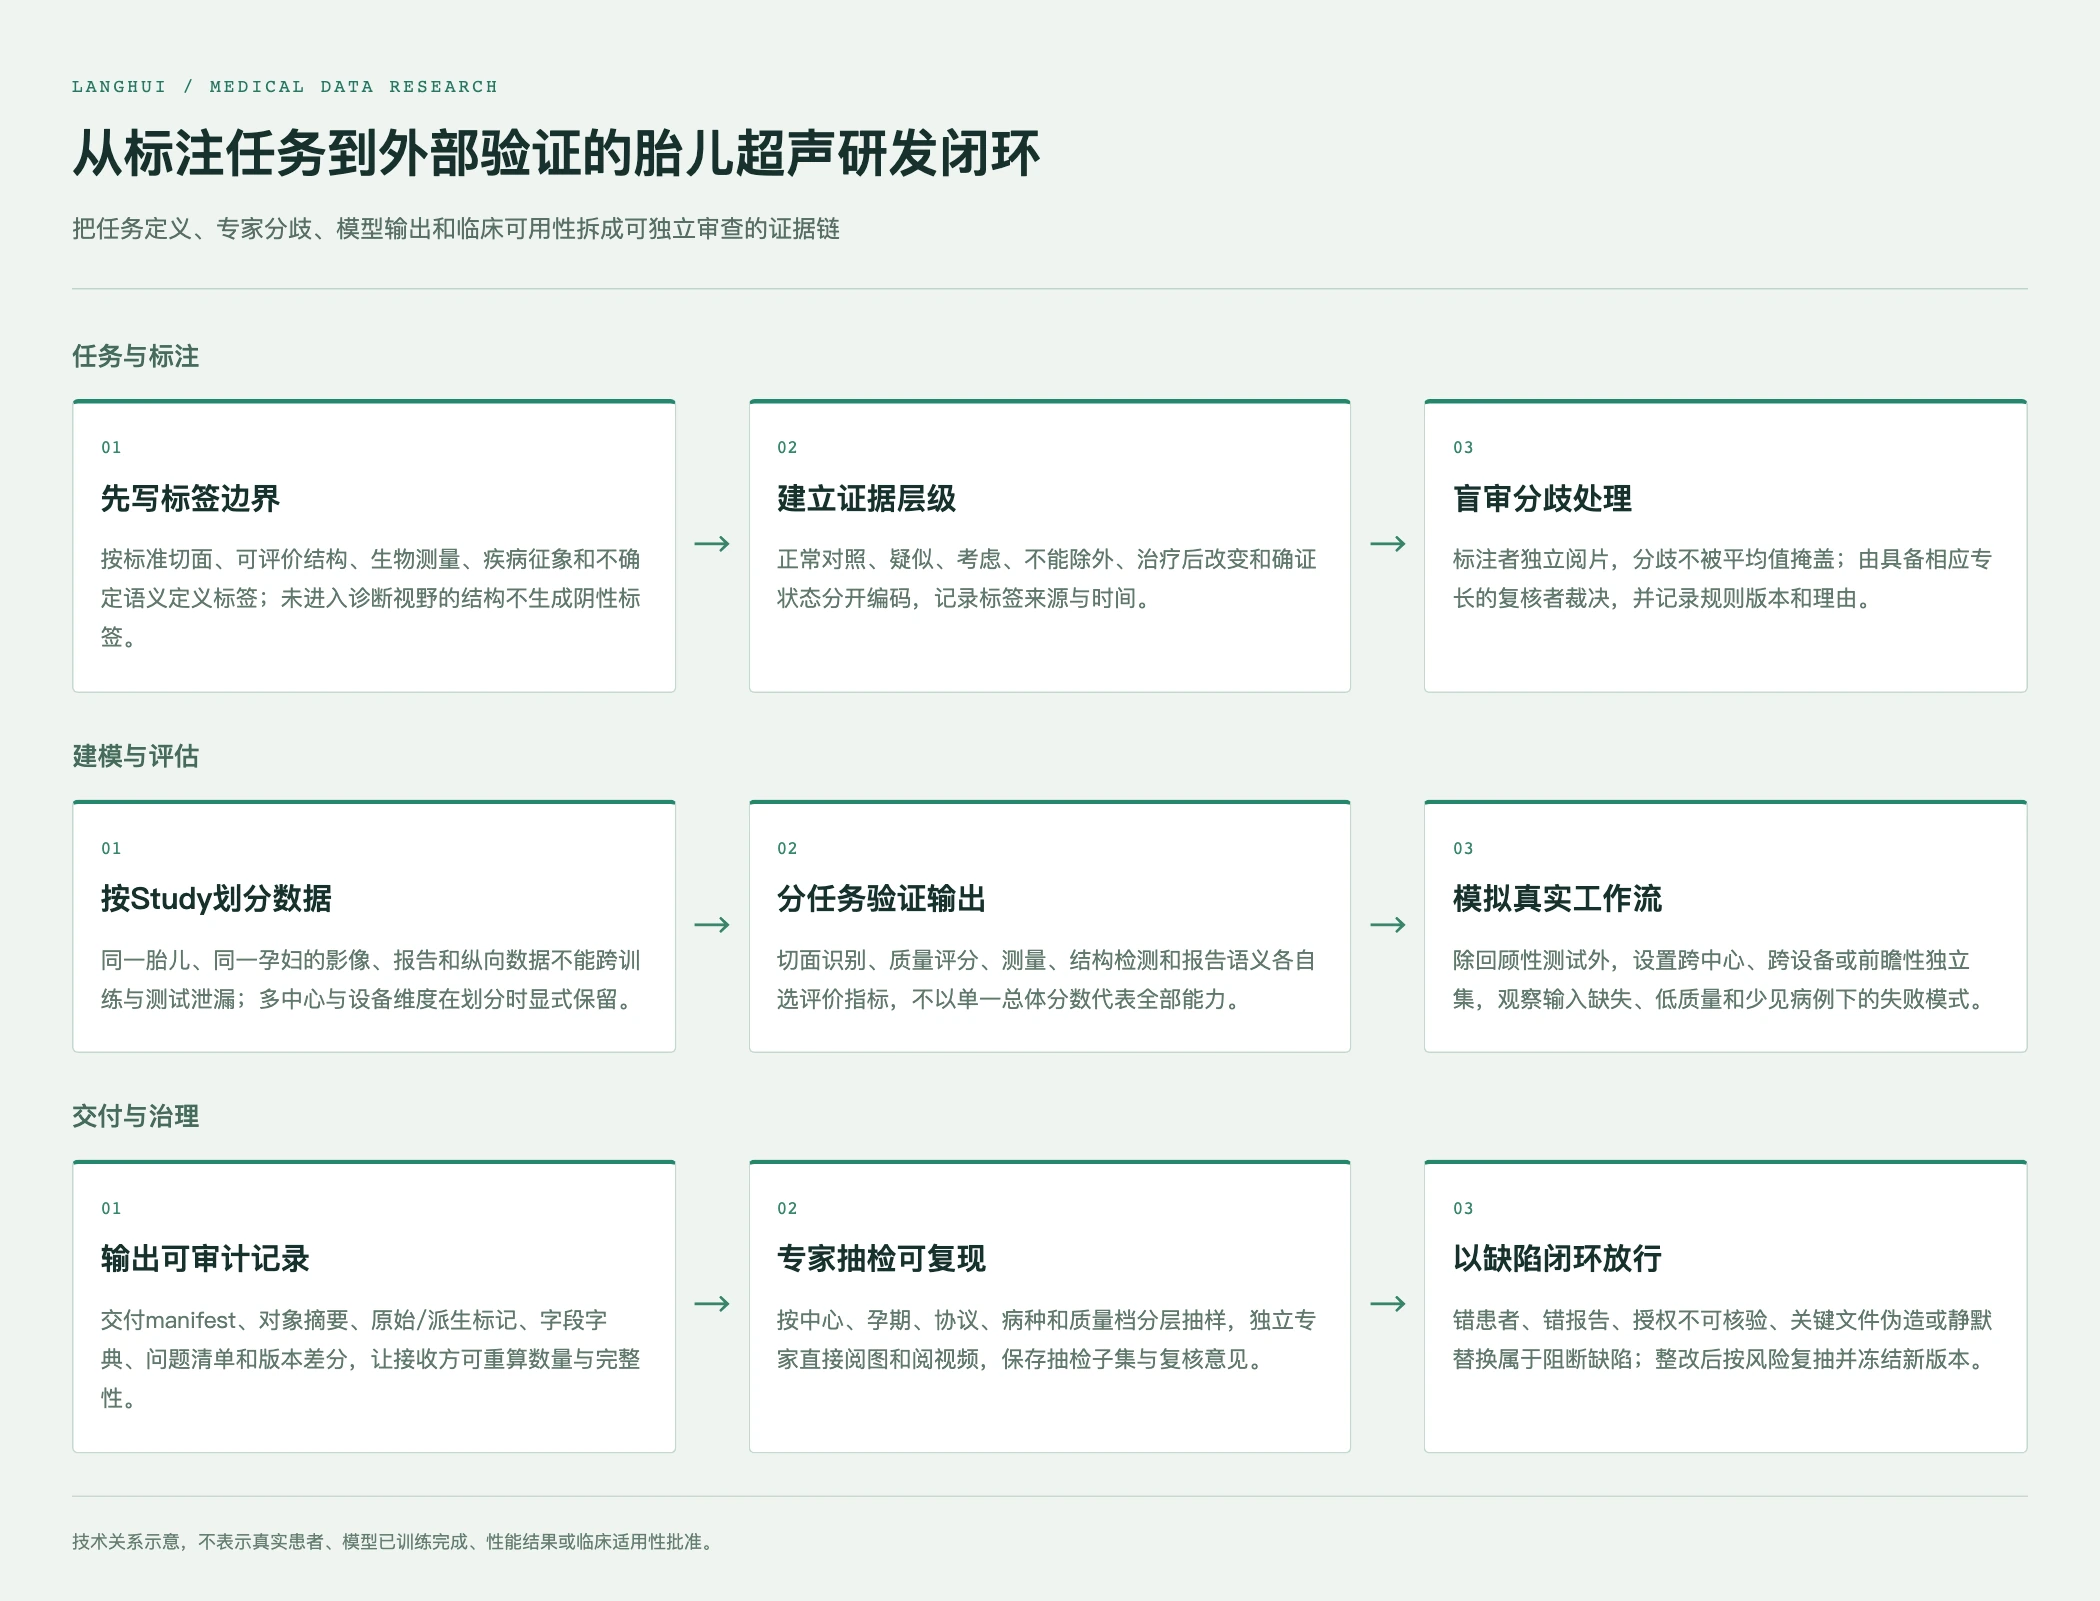
图2|从标注任务到外部验证的研发闭环。技术关系示意,不表示模型已训练完成、性能结果或临床适用性批准。
六、外部验证与偏差控制:把“多中心”变成可检查的设计
多中心不只是把不同机构名称写进数据卡。中心、设备、操作者、孕周、人群构成、协议和报告模板都可能成为模型的捷径。数据划分应以Study或患者级别执行,同一胎儿的不同时间点和同一次检查的派生文件不能分散到训练和测试集合。若多个中心的数据在采集、脱敏、标注和报告上高度相似,也不能仅凭中心数量宣称泛化。应在独立集上分别报告各中心、设备、孕期、质量档和重点病种的表现,并列出无法评价和缺失输入的比例。
外部泛化研究已经显示,胎儿平面分类模型从一个高资源中心迁移到不同国家、设备和资源条件时会出现域偏移;研究者通过小样本迁移学习进行重新校准,并强调真实环境中的设备和图像质量差异7。这意味着采购或研发阶段应把设备代际、探头、预设、图像压缩和操作者差异作为设计变量,而不是等模型训练结束后才寻找“外部测试集”。如果目标是跨地区使用,外部验证集应在项目开始时独立冻结,且不能与常规交付清单或训练标注反复混用。
前瞻性工作流验证与回顾性性能研究也必须区分。PROMETHEUS随机试验在单中心比较AI辅助与标准胎儿畸形筛查,纳入78名孕妇和58名超声操作者,研究了标准切面保存、生物测量、扫描时长、认知负荷和诊断表现6。这类试验可以回答AI是否改变真实工作流,但样本、中心、设备和研究流程都有限,不能被改写成普遍临床收益。对数据交付项目而言,更稳妥的验收是:先检验文件与标签的可用性,再检验模型在独立数据上的任务性能,最后才在具备伦理、流程和监管条件时评估临床工作流影响。
验收应围绕可复算的事实组织。接收方需要能够从逐例索引重新计算合格量、去重结果、报告配对率、核心条目覆盖、设备与年份分布、问题状态和版本影响;随机抽检要按中心、协议、孕期、胎儿数、病种和质量档分层,避免只抽“容易通过”的样本。独立专家应直接阅图、阅视频或阅报告,而不是只看供应方汇总表。错患者、错报告、授权无法核验、关键文件伪造、重复导出冒充新例、静默替换和直接身份泄漏都应作为阻断缺陷。整改后需要重新自动检查,并按风险复抽,问题关闭前的数据不应进入最终合格量。
七、从数据交付到研发业务:能力边界要和需求边界分开
在业务逻辑上,胎儿超声项目可以拆成四个阶段。第一阶段是需求澄清:冻结模态、部位、孕期、主键、字段字典、标签层级、授权范围和质量档。第二阶段是样例评估:用少量真实、合规、可审计的样例确认切面、测量、动态与静态、报告关系和不可评价状态。第三阶段是小批量试标与独立抽检:双人或多角色执行,分歧进入裁决,形成版本差分和问题清单。第四阶段才是规模化交付与复验:每批提交manifest、质检记录、分布统计、核心条目清单和整改闭环。
这种分阶段设计有两个现实价值。对于研发方,它把模型失败提前暴露在数据定义阶段,避免用算法掩盖主键错配、报告错配和标签漂移;对于采购方,它把“是否能做”转换成“哪些对象能按什么口径交付”,可将试标、返工准备、独立抽检和最终放行分别核算。数量、病例构成、协议、最低覆盖或例外口径发生变化时,应由授权人员书面确认并形成新版本,而不是依靠口头备注或供应方单方公式改变验收口径。
就已核验的公司定位而言,朗慧的公开能力边界是AI数据基础设施与流程服务,覆盖采集、处理、标注、质检和数据交付;这支持围绕项目规格、样例评估、专家审核、质量记录和版本化交付讨论合作路径,但不等于某个胎儿超声数据集已经现货存在,也不等于已有独立临床验证或产品获批。具体的机构来源、授权、专家配置、规模、周期和验收阈值,都应以项目书面确认和合规材料为准。公开科研论文可以帮助设计任务和验证方案,但不能替代公司的现货证明,也不能把论文中的研究性能换算成服务承诺。
真正可用的胎儿超声数据,不是把更多图像堆进文件夹,而是让每一项输入都能回答“来自哪一次检查、属于哪个胎儿、由什么设备在什么阶段采集、能评价什么、不能评价什么”,让每一项输出都能回答“由谁依据什么规则标注、与哪份报告或结局关联、经过怎样的独立复核”。当这些问题被写入数据字典、模型划分、专家流程和验收记录时,多模态数据才从一次性采购对象变成可重复使用的研发基础设施。
参考来源
- A.7.4 Ultrasound Multi-frame Image IOD Module Table
- Obstetric (Standard)
- Whole examination AI estimation of fetal biometrics from 20-week ultrasound scans
- Effectiveness and clinical impact of using deep learning for first-trimester fetal ultrasound image quality auditing
- Clinical validation of explainable AI for fetal growth scans through multi-level, cross-institutional prospective end-user evaluation
- Artificial Intelligence to Assist in the Screening Fetal Anomaly Ultrasound Scan (PROMETHEUS): A Randomised Controlled Trial
- Generalisability of fetal ultrasound deep learning models to low-resource imaging settings in five African countries