
MEDICAL DATA RESEARCH
把舌诊术语变成可复核的数据标签:舌面与舌下脉络视觉AI的设计要点
围绕舌面12个维度42个标签与舌下脉络3个维度11个标签,本文拆解视觉表型、区域与几何测量、不可判定状态、专家复核、受检者级划分及外部验证,帮助医疗AI研发团队把舌诊数据做成可复核、可审计的研究资产,不替代诊断或辨证。
传统舌诊要进入计算机视觉研究,真正的难点并不是把一张舌头照片交给分类器,而是先回答一个更基础的问题:同一处颜色、苔质或脉络变化,怎样被不同标注者稳定地识别、记录并在新设备和新来源的数据上复核?如果“花剥苔”“光剥苔”“染色苔”只作为自然语言描述,模型学到的可能是拍摄光线、饮食残留或标注者习惯,而不是可重复的视觉特征。近期综述也把图像采集、预处理、数据集构建、特征提取和疾病检测视为连续链路,并将标准化和定量化列为舌图像分析走向临床支持的关键挑战。1
本文讨论一类可匿名化的技术需求:围绕舌面和舌下脉络建立结构化视觉标签,服务于中医视觉数据研究、特征提取和模型评估。需求本身不等同于疾病诊断,也不应把标签直接转换为处方或个体化医疗建议。更稳妥的做法是将“看到了什么”与“如何辨证”分开。前者是可以被复核的视觉表型,后者需要由合格医生结合望、闻、问、切及病史作出判断。数据集可以支持前者的自动化研究,但不能仅凭一张图像宣称完成后者。
先固定任务边界:53个标签不是一个诊断结论
源需求把任务拆成舌面12个维度、42个标签,以及舌下脉络3个维度、11个标签。舌面部分包含剥苔、苔色、苔腻腐、苔薄厚、苔润燥、舌形状、舌质色、点刺、裂纹、齿痕、老嫩舌和舌神。舌下部分包含脉络长度、脉络颜色和脉络形态。这个结构比单一“舌象分类”更接近实际数据工程,因为它把颜色、纹理、形状、局部结构和可见性拆成了不同字段。
这53个标签不能简单地当作53个互相独立的类别。剥苔中的“无剥离、花剥苔、光剥苔、类剥苔、鸡心舌”是同一维度内的候选状态;苔色中的淡白、白、黄、黑和染色苔也具有互斥关系,但不同维度之间可以同时成立。例如一张图像可能同时是厚苔、黄苔和腻苔,也可能因光照、反光或外源着色而无法可靠判定。数据字典应明确每一维是单选、多选、连续测量还是“不可判定”,不能把“没有观察到”与“图像无法观察”混成同一个零值。
舌质色的定义还包含空间信息:舌尖红是局部颜色标签,而淡白舌、红舌、绛舌和紫舌可以描述全舌或主要区域。点刺、裂纹和齿痕也不是纯粹的整图分类,它们涉及数量、位置、面积或形态。若只保留图像级标签,后续模型很难解释“哪里导致了标签”。因此建议同时保留区域级坐标或分割掩膜;在暂时无法精确勾画时,也至少保存舌尖、舌中、舌边、舌根等预先约定的区域索引,并记录区域是否被遮挡。
舌下脉络更不能与舌面标签混为一谈。需求中的长度规则以舌下肉阜至舌尖的连线为参照,正常长度不超过该参照距离的五分之三,超过则进入“较长”类别。这类比例标签依赖基准点和拍摄姿态,不能把像素长度直接当作生理长度。脉络颜色分为淡红、淡紫或浅蓝紫、青紫或蓝紫、紫暗或暗紫、青黑或紫黑;脉络形态则区分细直、粗张、怒张和瘀斑。每次标注都应保留参照点、可见脉络范围和测量状态,否则比例规则无法被第三方重算。
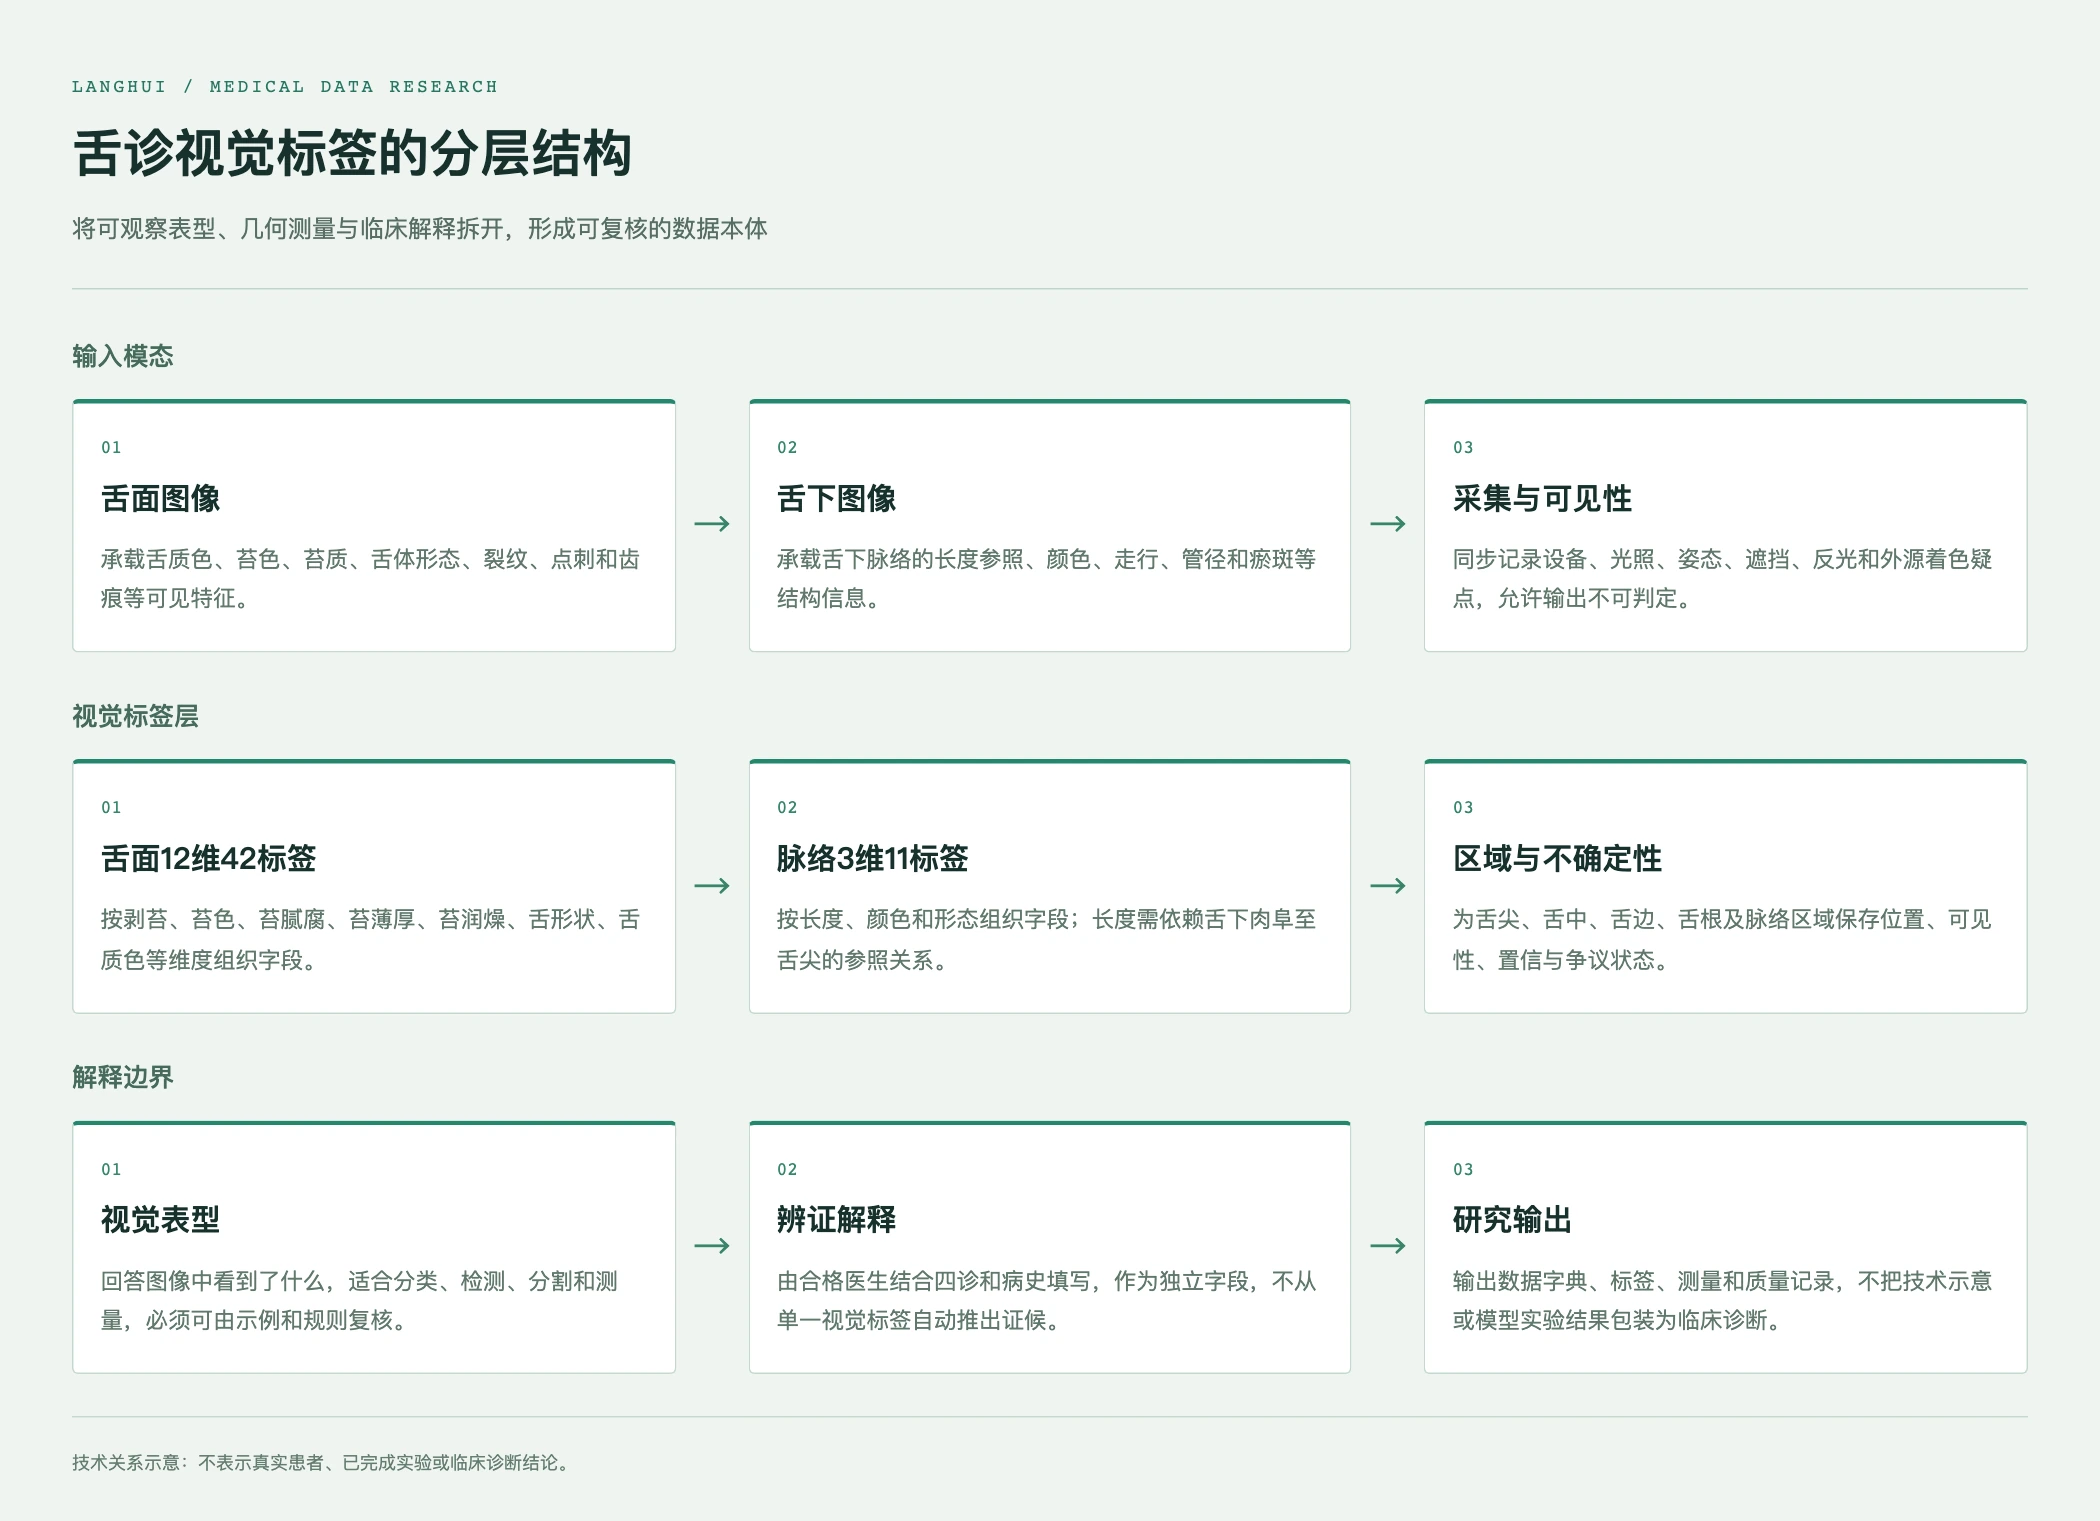
图1|技术示意:将舌面表型、舌下脉络测量和辨证解释分层,避免把视觉标签直接等同于临床诊断。图中关系用于数据设计,不表示真实患者、已完成实验或临床结论。
输入设计决定模型能否学到可迁移的特征
舌面与舌下脉络应当视为相关但不同的输入模态。舌面图像主要承载舌质色、舌苔覆盖、裂纹、点刺、齿痕和舌体形态;舌下图像需要更好地呈现脉络的走行、管径、颜色和边界。两者若由不同角度或不同设备采集,必须用样本级标识关联,而不能在文件名中依赖人工猜测。源需求没有提供设备型号、光源、色温、拍摄距离、分辨率、白平衡、是否同一受检者多时间点等采集字段,这些应在试采前补齐,而不是在模型训练后用算法补救。
已有研究说明,采集条件会直接改变标签的可见性。一个多标签舌象研究使用统一的舌诊设备、标准D50光源和固定色温,并让10名中医专家在统一显示条件下筛选和确认标签;其研究对象包含裂纹、齿痕、点刺、瘀滞、腻苔、剥苔和腐苔等视觉类别。2这类设置有助于减少颜色漂移,但它的训练、验证和测试划分仍属于单一研究数据环境,不能自动证明跨设备泛化。另有移动端研究把舌下图像纳入数据集,指出手机图像质量和数量会影响特征提取;轻量模型适合部署探索,却不能替代对采集标准和外部数据的验证。5
因此,数据入库至少应保留原始图像、设备和软件版本、采集时间、光源或色卡信息、拍摄方向、舌面/舌下模态、裁剪与增强记录、遮挡和反光标记。脱敏应覆盖文件元数据、可见的脸部或口腔外信息,以及可能携带身份的图像边缘。对外只交付研究所需字段,不保留能反推出个人、机构或项目来源的内部标识。对于外源染色,不能仅依据颜色深浅判断。应增加“疑似食物、饮品、药物或局部残留”的观察字段,并允许标注者给出“无法排除”,在分析时作为独立质量层,而不是强制归入白、黄或黑苔。
数据的颗粒度也应提前决定。单张舌面图像是图像级样本;舌苔、裂纹和点刺是区域级或实例级目标;脉络长度与颜色是结构级测量;舌面与舌下图像的配对则是检查级样本。如果同一人的多张图像被随机分到训练集和测试集,模型可能记住个体纹理、设备或拍摄习惯,造成信息泄漏。医学影像AI的通用检查清单明确建议在患者或更高层级保持划分互斥,并报告划分比例、类不平衡和测试集设计理由。6
标注方案:把“看到的表型”与“解释的证候”分开
源需求的辨证逻辑被注明为参考,实际由医生填写。这一边界非常重要。数据团队可以依据已确认的视觉定义建立标注界面,但不应把“花剥苔对应某类气阴状态”自动写成模型真值。视觉标注的主任务是记录表型,医生的辨证记录属于另一个层次,必须有独立字段、独立授权和独立复核流程。如果研究目标是辨证模型,还需要重新定义目标人群、临床参考标准和完整四诊信息,不能从舌面标签直接推导。
标注协议应把每个维度改写为可执行的判定规则。以剥苔为例,需要说明“裸露区”的最小可见范围、边界是否清楚、残留苔质如何处理,以及多处剥脱是否必须达到某种分布才进入花剥苔。以舌质色为例,需要规定观察的是舌体肉质而非苔面,如何处理反光、曝光不足和局部阴影,舌尖红与全舌红能否并存。以裂纹为例,生理性浅纹、深沟、分叉网状结构和被反光遮挡的纹理应有示例。以齿痕为例,要区分自然边缘起伏、牙齿压痕和舌体伸展不充分造成的假象。
舌下脉络的标注需要一份独立的几何协议。标注者应先标出舌下肉阜和可用的舌尖参照,再勾画可见脉络或其中心线,最后记录长度比例是否可测。若图像只拍到部分舌下区域、舌体姿势偏斜、反光覆盖脉络或颜色无法区分,就应进入不可判定,而不是由标注者凭经验补齐。脉络颜色与形态可以并存,且颜色受黏膜厚度、光源和曝光影响,标注界面应支持“颜色可信度”和“形态可信度”分别记录。
专家配置不能只写“由专家审核”。建议设定经过同一份术语手册和示例集培训的初标人员,由至少两名具备中医舌诊经验的专业人员独立完成关键字段;对争议样本由更高资历的中医专家盲审,并保留原始分歧、最终结论和修改原因。2025年的一项舌图像研究采用两位中医从业者独立标注、资深教授处理分歧的三人质控机制;另一项多标签研究用专家筛选和复核排除不一致样本。3这些做法可以作为流程参考,但不能把论文中的专家配置直接宣称为本项目的现货能力。
一致性评价要按标签类型选择指标。互斥分类可报告类别级一致率、Cohen或Fleiss kappa,并给出置信区间;多标签可报告逐标签的F1、宏平均与微平均,但标签稀有时还要报告阳性样本数和漏标情况;区域分割需要Dice、IoU或边界误差;脉络长度则需要绝对误差、比例误差及重复测量一致性。若一个标签的低频导致kappa受边际分布影响,应同时呈现原始一致率和混淆矩阵,不能只挑选一个看起来较高的综合分数。
算法路线:先做质量门,再做多任务学习
这类数据不宜直接把整张图输入单一分类器。较稳妥的路线是先建立图像质量门:检查模态、完整性、清晰度、曝光、白平衡、反光、遮挡、舌面或舌下区域是否足够,以及是否存在外源着色疑点。质量门输出可用、需复核和不可用三态,并保留具体原因。这样做不是为了把难例删除,而是为了将“模型没有看到”与“模型判断为阴性”区分开来。质量失败样本应进入独立的鲁棒性评估,避免训练集只留下清晰、典型和容易分类的图像。
第二阶段是舌体和舌下区域定位。舌面可以先分割舌体,再生成舌尖、舌中、舌边和舌根等分析区域;裂纹、点刺、瘀斑和齿痕适合在区域或实例层面检测。舌苔颜色、厚薄、润燥和腻腐可以采用多任务分类与局部纹理特征结合的路线,但必须避免在增强过程中改变颜色语义。舌下脉络则应优先解决边界分割、中心线提取和参照点定位,再计算长度比例、管径和颜色。早期研究已经提出针对可见对比和低对比舌下图像的不同分割方法,并对脉络宽度和色彩进行量化;其结果说明技术可行性并不等于跨设备、跨人群的临床有效性。4
多任务模型可以共享低层视觉特征,同时为不同维度设置独立输出头:颜色头、苔质头、形态头、局部病灶头、脉络几何头和不可判定头。对于标签之间存在层级关系的情况,可在损失函数中加入约束,例如舌下长度比例必须基于可用参照点,染色苔应保留外源着色标记,舌尖红不能被迫解释为全舌红。训练时要关注标签共现和类别不平衡,不能只用总体准确率。稀有的紫黑脉络、鸡心舌或枯舌可能对宏平均影响很大,也可能因样本少而产生不稳定估计。
如果后续要做多模态融合,应先完成单模态基线,再比较早期融合、晚期融合或跨模态注意力的增益。舌面图像和舌下图像缺失率可能不同,模型必须能在只有舌面、只有舌下或两者配对时给出明确的输入状态。不能把缺失模态静默填充成“正常”。同样,专家辨证文本如果被纳入视觉语言模型训练,需要单独说明文本来源、授权、脱敏和标签泄漏风险。对于只有表型标签的数据,模型输出应限于表型,不应生成未经验证的证候或疾病结论。
验收不是一个总准确率:建立分层、可追溯的质量门
交付验收应至少分为数据完整性、标签一致性、几何可重算性、模型性能和外部验证五层。数据完整性检查样本是否包含规定模态、原始图像是否可读、元数据是否齐全、脱敏是否通过、重复样本和近重复样本是否清除。标签一致性检查每个维度的字段约束、互斥/并存关系、不可判定原因和分歧记录。几何验收检查舌下脉络参照点、中心线、长度比例和测量单位能否从交付文件重算。
模型验收要按标签和场景展开。对互斥类别报告每类的敏感度、特异度、精确率、召回率、F1和混淆矩阵;对多标签报告每个标签及宏/微平均;对分割报告Dice或IoU并按图像质量分层;对长度比例报告误差分布和重复测量一致性。每项指标都应给出测试集样本数和不确定性区间,不能只给一个汇总数字。模型失败分析要覆盖反光、低照度、色偏、遮挡、外源着色、低对比脉络和标签边界不清的样本。
内部测试和外部测试必须分开。内部测试可用于确认模型是否学会了既定标签;外部测试应来自未参与标注规则制定的新来源,并尽量包含不同设备、光源、拍摄姿态和人群结构。若无法取得真正外部数据,应如实写明缺失,而不是用随机切分替代。CLAIM 2024更新强调了参考标准、标注者资质、测试集标注、标注者间变异、数据分区和外部测试的可复现报告要求。6STARD-AI进一步要求交代数据来源、设备和软件版本、采集及预处理、训练/验证/测试用途、测试集代表性以及外部审计或评估。7这些条目可以转化为项目的数据卡和验收记录。
在舌诊研究中,参考标准本身也需要透明。若目标只是视觉表型,参考标准可以是按术语手册完成的专家共识标签;若目标是证候或疾病关联,则不能把单一专家意见视为无误真值,应说明四诊资料、临床诊断、随访或其他依据,以及参考标准可能存在的偏差。近期一项以舌图像预测五脏状态的研究使用4645张图像,由三位中医从业者结合就诊资料和四诊信息形成标签共识,并采用固定的训练、验证和测试集;作者也报告了不同目标标签之间的样本不平衡。3这项研究可提示“视觉输入—综合参考标准”的方法路线,但其标签并不是本需求的纯视觉表型真值,研究结果也不应被移植为本需求的临床效果,更不能替代跨中心验证。
业务交付:用小规模试标验证规格,而不是先承诺大库存
对于数据服务项目,最有价值的第一步通常不是承诺一个未经核验的库存规模,而是把53个标签中最容易产生歧义的字段做成小规模试标。试标应覆盖典型、边界、低质量和不可判定样本,优先检查染色苔与黄苔、花剥苔与类剥苔、裂纹与自然纹理、齿痕与边缘起伏、粗张与怒张脉络等相邻类别。试标结束后,双方确认术语、示例、字段关系、复核机制、回修规则和验收指标,再决定是否扩大数据范围。
交付包应同时包含数据字典、标签本体、标注指南、示例集、质量记录、版本号、修订日志、训练/验证/测试划分说明和可重算的测量字段。若存在未解决的标签争议,应在数据卡中标记,而不是在最终文件中强行给出一个确定类别。对于同一受检者的纵向图像,是否允许进入纵向研究、是否需要时间间隔字段、是否需要保持检查级隔离,都应在规格中书面确认。这样才能把一次性标注交付转成可以复用和审计的数据资产。
已核验的企业能力边界适合支持项目规格梳理、样例评估、标注流程、质量记录、版本管理和数据交付等工作;这并不等于该企业已经拥有本需求的现货数据、固定专家配置或临床验证结果。实际授权范围、可用样本、专家角色、交付周期和验收阈值仍需通过项目书面确认。公共数据集也只能作为方法对照,不能替代目标任务的授权与外部验证。例如2026年发布的TMC-Tongue数据集公开了20类舌象目标及训练、验证和测试划分,具有研究复现实用价值,但其发布页将数据描述为设备采集并按医生意见标注,不能据此推断其已完成临床诊断验证。8
从研发价值看,这项需求的关键产出不是一个宣称“能辨证”的黑箱,而是一套可追溯的视觉表型层。它能让研究团队分别回答:图像是否可用,舌面或舌下区域是否被正确定位,哪个标签由哪些视觉证据支持,哪些样本存在专家分歧,模型在什么设备和人群上失效,以及改版后标签是否保持可比。只有这些问题都有记录,后续的分类、分割、多模态融合或知识推理才有可解释的输入。
舌诊视觉AI的下一步不应是把更多传统术语堆进标签表,而是逐项验证定义能否被稳定观察、能否被可靠标注、能否在独立来源上复核。把舌面42个标签和舌下11个标签做成层级化、带不确定性的标注体系,并以设备、光照、区域、参考标准和外部验证为约束,才能让中医视觉数据从“可读的描述”走向“可计算、可审计、可迭代的研究基础”。
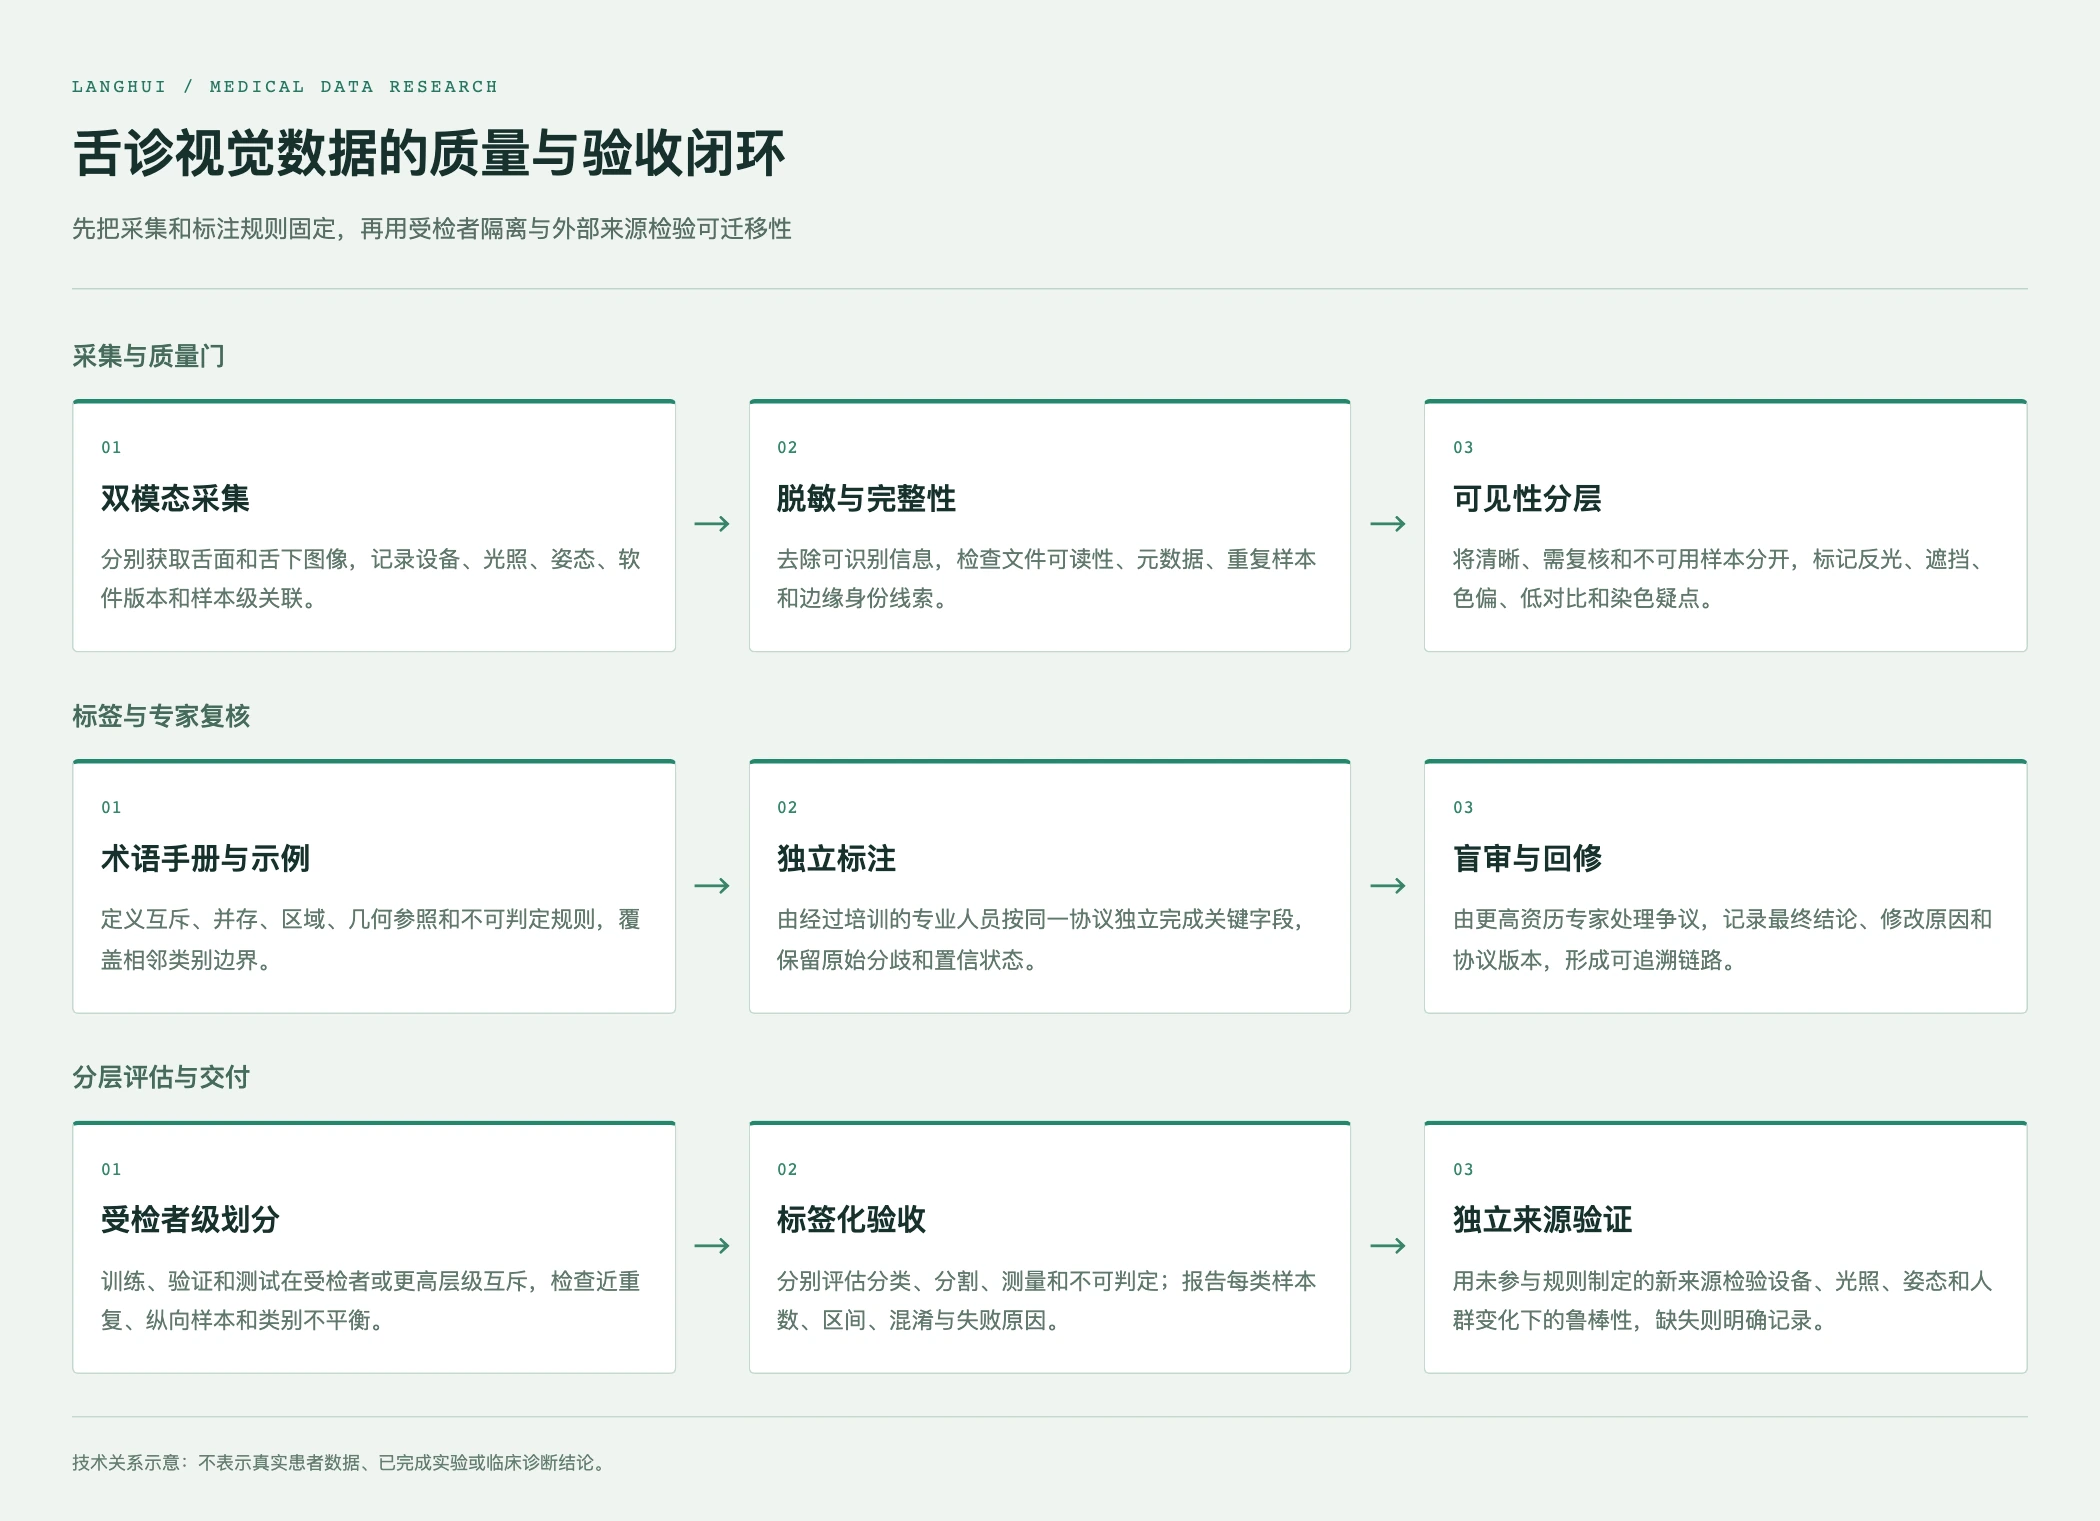
图2|技术示意:从双模态采集、质量门和专家标注,到按受检者隔离的数据划分、分层验收与外部验证。图中流程用于研发规划,不表示真实患者数据、已完成实验或临床诊断。
参考来源
- Computerized tongue image analysis for non-invasive disease screening: a review
- Deep Learning Multi-label Tongue Image Analysis and Its Application in Disease Diagnosis
- Visceral condition assessment through digital tongue image analysis
- Computerized feature quantification of sublingual veins from color tongue images
- A novel tongue feature extraction method on mobile devices
- Checklist for Artificial Intelligence in Medical Imaging (CLAIM): 2024 Update
- The STARD-AI reporting guideline for diagnostic accuracy studies using artificial intelligence
- TMC-Tongue: A standardized tongue image dataset with pathological annotations for AI-assisted TCM diagnosis