
MEDICAL DATA RESEARCH
长时序多模态病历数据:把患者轨迹变成可复核的研究对象
面向医疗AI研发与数据采购,本文拆解长时序多模态病历的临床任务、患者级时间线、文书与影像对象、终点证据、专家复核、质量分层、泄漏控制和外部验证,说明如何把采购规格转成可复核的研究数据交付。
当同一位患者在多年间留下检验、用药、病历文书、影像、量表和随访记录时,研究团队真正需要回答的并不是“文件够不够多”,而是某个结果究竟发生在什么时间、由哪一份证据支持、与哪次诊疗事件相连。如果这些记录只是按文件类型分开堆放,模型看见的可能是彼此孤立的片段,无法判断一次实验室变化发生在治疗前还是治疗后,也无法分辨报告中的“与前片比较”是否确实有对应的既往检查。长时序多模态病历数据建设的核心,因而不是扩充目录,而是把患者级时间线、证据来源、缺失状态和不确定性同时变成可审计的数据对象。
本文讨论一类可匿名化的医学数据建设需求:围绕多科室、多病种的临床研究与人工智能方法开发,组织患者的全轨迹就诊记录,保留结构化与非结构化证据,并把明确的临床结局或末次随访状态纳入验收。这里的“数据集”是研究基础设施,不是诊疗系统;建设范围、授权边界、真实可用病例和质量档位都应以项目书面确认及验收记录为准。
先把临床问题写成数据任务
这类项目的第一步不是选择 Transformer、图网络或大模型,而是先确定模型要支持什么样的临床研究问题。一个可操作的任务定义至少要说明观察起点、观察窗口、候选输入、目标输出和允许的缺失范围。例如,研究者可能关心疾病状态随时间的演变,治疗或操作后的结局变化,复发、进展、死亡或再入院等终点的时间关系,也可能只需要一套用于队列检索、方法验证和数据治理的可复核病历样本。上述任务都需要纵向数据,但它们对时间锚点、结局证据和可用模态的要求不同,不能用同一个“有病历”标签代替。
需求中的输入不是单一的“电子病历”。患者层可以保留经过规则处理的基本人口学信息和稳定的匿名标识;就诊层需要区分门诊、住院、急诊和转科等事件;记录层包含诊断、检验、用药、手术、病程和随访;影像层既包含报告文本,也可能包含 DICOM 序列目录或项目约定的影像本体;病理层需要把报告、标本和可提供的全切片对象区分开;量表层应保留量表名称、版本、总分、条目分和时间;结局层则记录事件类型、日期、证据来源或末次状态。某种模态缺失时,缺失本身应被编码,而不是被默默当作阴性或正常。
输出也要分层。对数据工程而言,输出是可排序的患者轨迹、带关系键的记录表、文件清单、数据字典、质量报告和版本差分。对算法研究而言,输出可以是事件级标签、时间到事件的分析对象、按任务冻结的训练/验证/测试划分,以及带有适用边界的研究指标。对临床专家而言,输出必须能回到原始文书、影像报告、检查序列或量表来源。只有把这三种输出同时写进规格,数据才不会在“可交付”与“可研究”之间出现断层。
数据颗粒度尤其重要。患者、就诊、文书、检验结果、医嘱、影像检查、影像序列、标本、量表条目和结局事件不是同一层级的行。把一份患者的所有信息压成一行,会丢失时间和来源;把每个文件都当成独立样本,又会破坏患者级划分。长时序项目应在数据字典中显式区分主键、外键、记录时间、事件时间、来源时间和派生时间,并说明哪些字段是原始记录、哪些字段由转换规则生成。
用关系键而不是文件夹重建时间线
一个稳健的数据模型通常从匿名患者键出发,再建立就诊、文书、检查、序列、标本和结局之间的受控关系。患者键需要跨门诊与住院保持稳定;就诊键要能把检验、用药、影像和文书挂到具体事件;影像报告中的检查编号、序列标识和对比检查标识要能追溯;量表记录要能回到评估时间及原始文件;病理报告要能与标本编号和可用切片建立关联。若不同系统使用不同编号,应保留映射逻辑和转换版本,不能只在交付说明里写一句“已关联”。
时间字段不应只保留一个粗粒度日期。诊疗时间、采集时间、报告时间、入院和出院时间可能分别代表不同事实;对于用药,还需要区分医嘱开始和结束;对随访结局,需要区分事件发生时间与记录时间。原始时间若因项目合规需要进行相对化处理,也要保留可计算的间隔关系和处理规则。占位日期、无法解释的时间逆序、同一记录多版本而没有版本号,都会让后续的暴露窗口、基线定义和结局分析变得不可靠。
文书数据应保留完整文本与文书类型。入院记录、出院小结、首次病程、日常病程、手术记录、会诊意见、门诊记录、急诊记录、转科记录和随访记录承担的证据功能不同。若只交付从文本中抽出的主诉、诊断和计划,研究者无法复核否定句、鉴别诊断、时间语境和证据冲突。因此,结构化字段可以作为便利层,但不应替代 full text;字段拆分也需要标记抽取规则、版本和可疑状态。对影像报告,“检查所见”和“诊断意见”应分别保存,不能为了统一表头把二者拼成一段不可定位的文本。
影像和病理的对象化需要更细。CT、MRI、PET-CT、超声和 X 线的模态、部位、期相、检查时间、报告和序列目录应相互对应;若报告提到与既往检查比较,应有被比较检查的可追溯关系。DICOM 的意义不仅是“一个文件格式”,还包括研究所需的序列、UID、一致性和相关元数据。NCI Cancer Research Data Commons 将多模态影像与基因组、蛋白组等癌症研究数据作为可查询、可连接的资源组织,说明影像对象和伴随数据应作为可连接的资源管理,而不是只交一张截图或一张影像清单。4
病理数据也应区分病理报告、标本实体、染色类型、扫描倍率、全切片文件和免疫组化对象。若项目只提供报告,不应把它描述为全切片数据;若只提供切片而没有报告与标本关系,也不能直接支撑病理语义分析。组学对象同理:原始文件、比对或变异结果、表达矩阵、质量控制和参考版本要分开记录。研究者真正需要的是“这个结果来自哪个样本、哪一次处理、哪一版流程”,而不是一个没有来源的数值表。
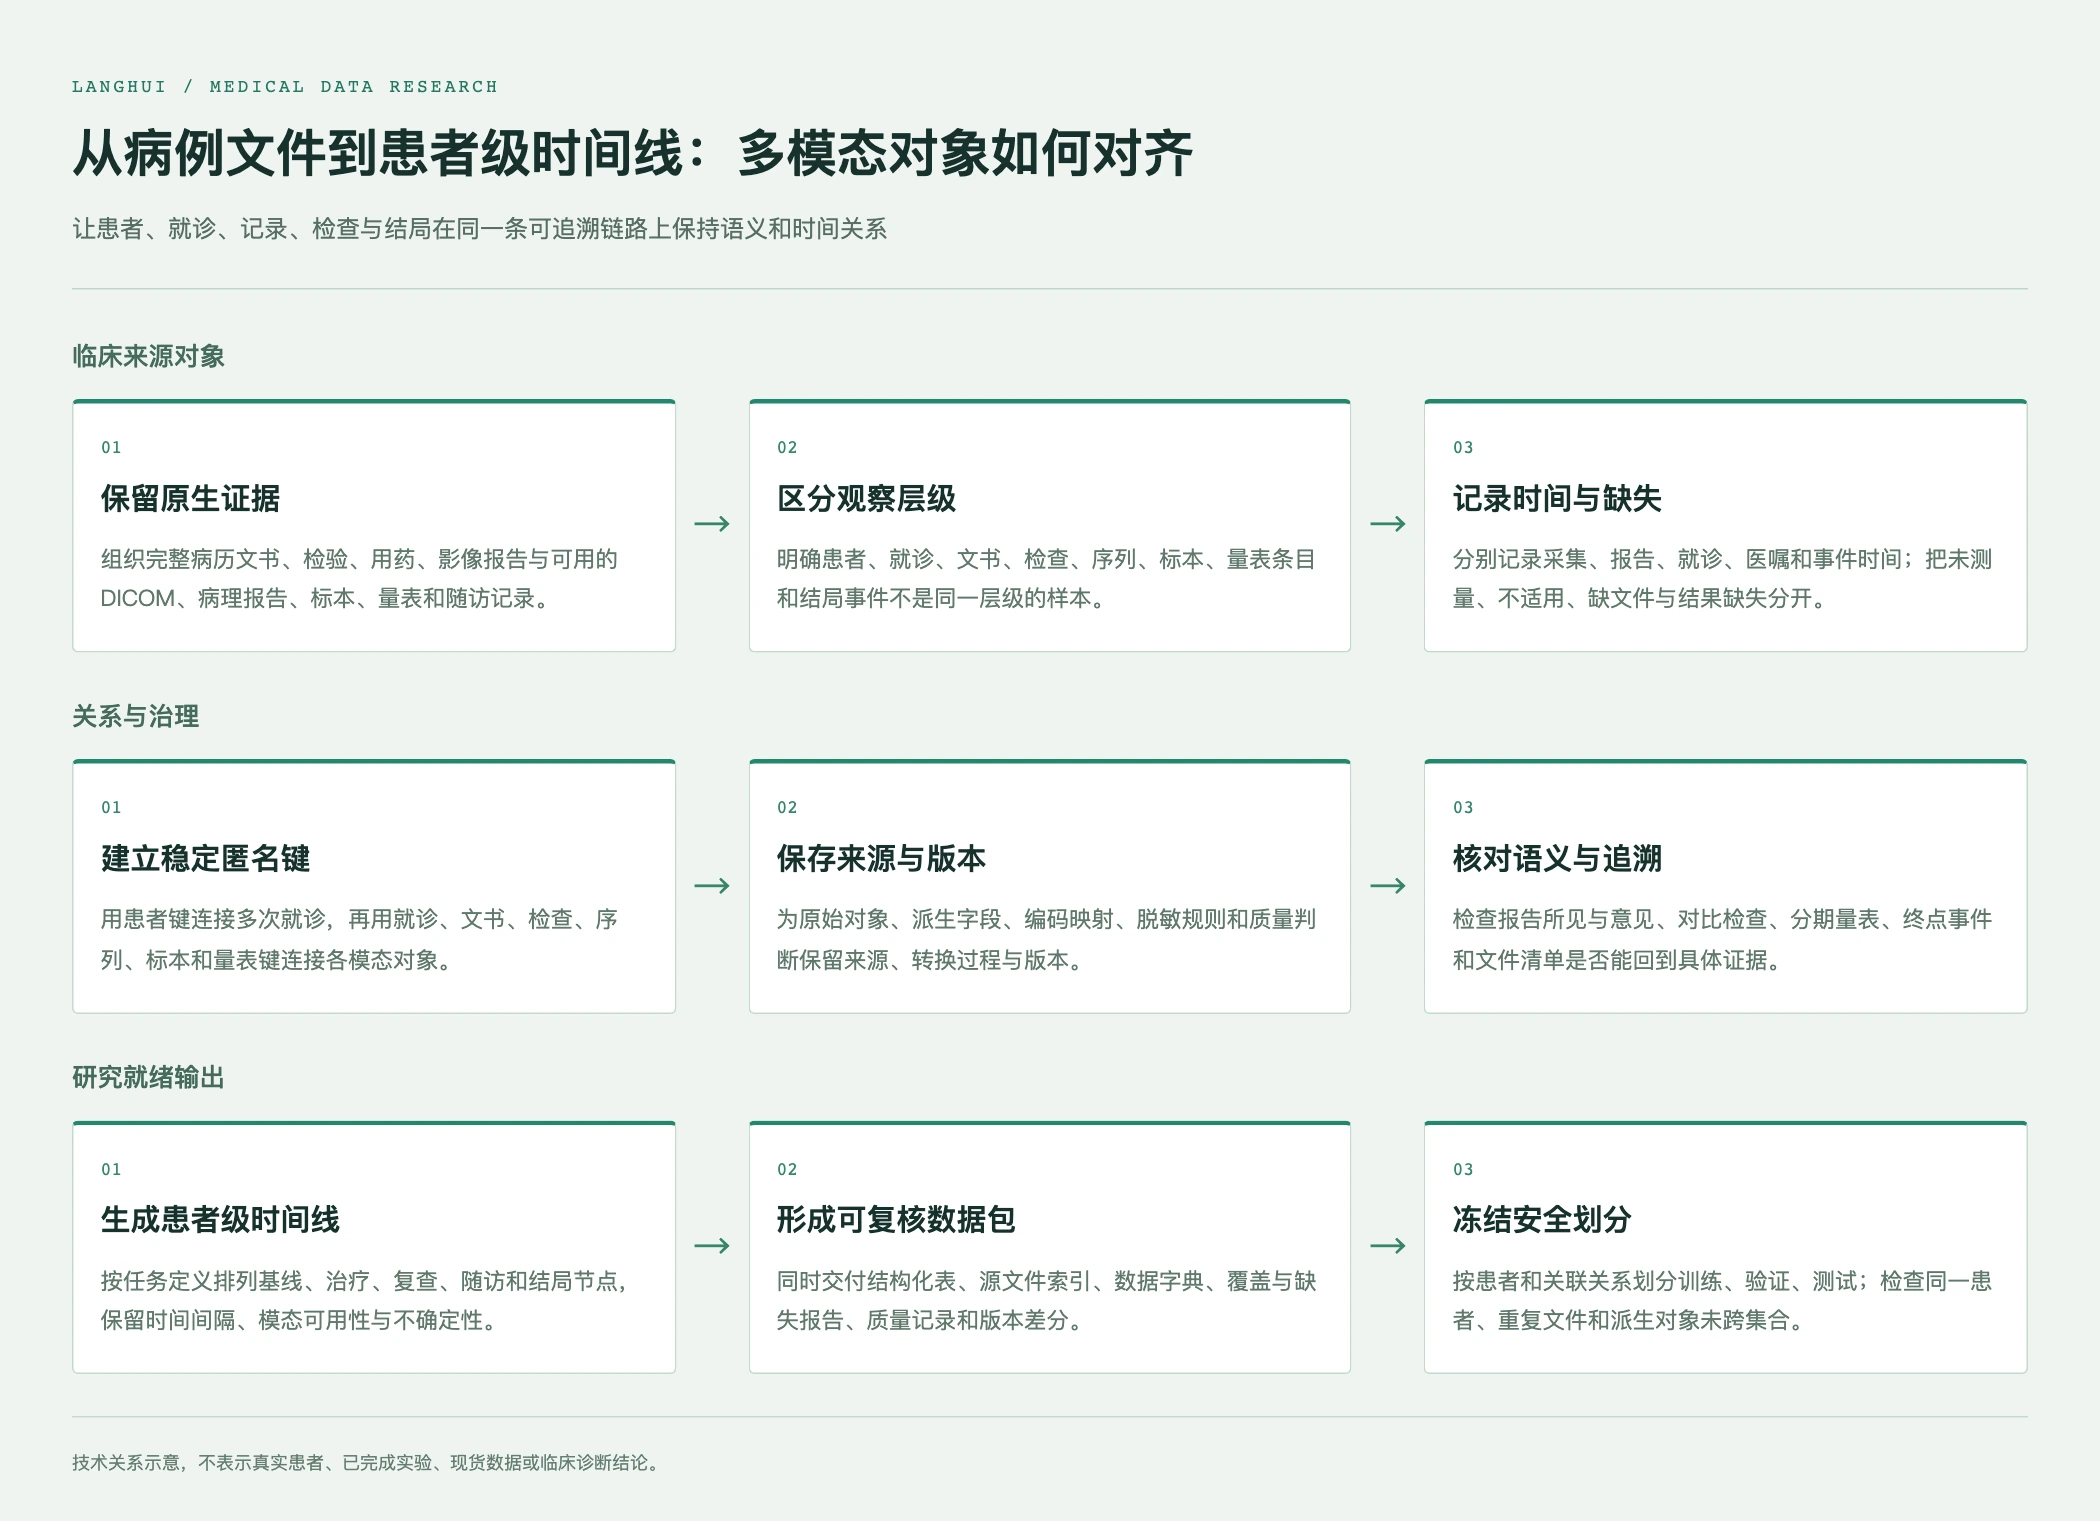
图1|从患者、就诊、记录到研究输出的技术示意;不表示真实患者、现货数据、已完成实验或临床诊断结论。
FHIR Provenance 将来源追踪表达为目标资源、产生或修改该资源的活动、相关实体与责任代理之间的关系,并强调来源信息对真实性、可信度、完整性和可复现性的作用。6 这不意味着每个项目都必须直接采用某一套互操作标准,而是提示数据字典至少要能回答:记录从哪里来、经过什么转换、由什么版本生成、谁或什么系统负责、研究者如何回到原始证据。
算法路线要服从观察窗口与缺失机制
在数据层完成患者级时间线后,算法路线可以按任务逐步增加复杂度。第一层是可解释的基线:以诊断、检验趋势、用药暴露、量表变化和报告文本构造事件序列,使用逻辑回归、梯度提升或生存模型检查标签是否可用、时间窗是否合理。第二层是模态专用编码器:文本用临床语言模型或词片段编码,影像用经过适当预处理的二维、三维或序列编码器,检验和用药用数值与类别嵌入,量表保留其测量结构。第三层再考虑跨模态注意力、时间感知 Transformer、状态空间模型或图结构,把就诊和证据关系纳入表示。
不同模态的采样频率通常不一致。检验可能在一次住院内密集出现,影像可能隔数周或数月,病理和组学可能只有一个基线时间点,病程文书则按临床工作流产生。把所有输入强行重采样到同一时间网格,容易将“没有检查”误当作“没有异常”,也可能造成未来信息泄漏。更稳妥的路线是同时保留事件时间、时间间隔、模态可用性和缺失原因,并在模型中区分“未测量”“无法获得”“不适用”和“结果缺失”。对于需要补全的数据,补全结果必须与原始观测分开,并在输出中携带不确定性和来源说明。
2026 年发表的 PULSE 研究把不同模态视为随患者生理状态共同变化的观测,并将上一访视的历史状态与当前访视的稀疏观测对齐,再进行跨模态重建或预测。该研究在多个任务中使用患者级训练与测试划分,并将同一测试患者的访视全部排除在训练之外;它提示长时序建模的关键不是把历史记录简单拼到当前输入,而是让时间上下文、当前观测和缺失模式各自有明确的位置。1 研究团队可以借鉴这种“历史状态—当前状态—缺失模态”的设计思想,但不能把论文中的重建效果直接转换为任何新项目的临床效果。
模型目标也要和终点类型匹配。如果输出是某一时间点是否出现事件,需要明确预测窗口和删失处理;如果输出是时间到复发、进展或死亡,应采用适合删失数据的生存分析或时间到事件模型;如果只是做队列检索,输出可能是证据齐备性、时间线完整性或纳入排除状态,而不是疾病概率。每一种输出都应保留标签来源、定义版本和不确定状态。模型产生的“风险分数”是研究结果,不是对个人的诊断、治疗或用药建议。
专家标注不只是“把字段填满”
长时序病历项目的专家工作至少有四个层次。第一层是临床任务定义:明确疾病组、基线、纳入和排除、终点与随访状态的含义。第二层是记录语义核对:确认诊断、分期、分级、量表和报告中的关键事实是否来自可追溯文书。第三层是关系核对:确认一次检查、一个标本或一次用药是否确实属于相应的患者和就诊。第四层是质量与隐私核查:确认脱敏没有损伤临床语义,也没有让影像像素、文件头或附带文本残留直接标识。
标注规则应把“确实存在”“未提及”“不适用”“无法判断”和“记录冲突”分开。以结局为例,报告提到进展不等于已经有可核对的进展日期;病历写“考虑复发”也不应被自动改成复发阳性。对分期、量表和治疗反应,应记录证据来源和判断时间。若不同文书之间存在冲突,项目应预先约定优先级或保留冲突标签,不能由标注员凭经验静默合并。
质量审核适合采用分层双人复核与升级裁决。第一位人员按照当前版本的字典完成判断,第二位人员在尽量不了解前一判断的情况下独立复核;分歧进入临床或数据治理裁决,裁决理由写回样例编号和规则版本。这个过程既适合结构化字段,也适合“是否存在完整对比检查”“终点是否有原始依据”“全文本是否截断”等关系型问题。审核员的角色、资质范围、抽检比例和不可判断时的退出规则,都应进入项目记录,不能用一个总体一致率替代具体争议。
如果后续研究要做影像病灶勾画、病理区域标注、文本实体关系抽取或量表条目级标注,应另立任务说明。全轨迹病历建设的最低目标是让证据可追溯、字段可复核、缺失可解释,并不意味着所有模态都已经完成专家级像素标注。把未约定的细粒度标签悄悄加入交付,既会扩大隐私暴露面,也会让验收主体、标注规范和外部验证失去清晰边界。
质量、偏差与外部验证要同时设计
医疗数据质量不应压缩成一个没有解释的总分。对长时序多模态数据,至少要分别检查完整性、格式有效性、时间合法性、跨表链接、临床语义、模态质量、来源与转换记录,以及缺失和异常分布。完整性回答“该有的记录是否出现”;一致性回答“患者、就诊、报告和文件是否指向同一个对象”;时间合法性回答“事件顺序和时间窗是否可解释”;临床语义回答“脱敏、抽取或映射有没有改变原意”。这些维度的失败原因不同,补救动作也不同。
缺失不是一个统一概念。某项检查从未被安排,与安排后没有结果,与影像存在但报告缺失,与报告存在但原始序列不可得,都会导致不同的研究风险。缺失报告需要按患者、病种、时间阶段、机构系统和模态分层;如果某类患者因为病情严重或治疗路径不同而更容易产生缺失,模型可能学到的是医疗资源或记录流程,而不是疾病轨迹。数据卡应同时记录覆盖范围、不可用原因、缺失处理和不适用条件。
偏差还可能来自科室编码、设备型号、扫描协议、记录习惯、语言和人群构成。统一映射 ICD 或药品编码有助于检索,但映射规则本身也要版本化并抽检,不能把不同临床语境的代码强行合并。影像的层厚、矩阵、期相和伪影会影响可用性;文本的截断、复制失败和模板复用会改变模型输入;病理扫描倍率和染色条件会影响跨设备外推。若项目覆盖多个系统,应在统计报告中展示各来源的分布,而不是只给一个合并后的计数。
数据泄漏是长时序项目最容易被低估的风险。同一患者的不同就诊、不同时间点影像、重复导出文件和派生文本必须放在同一数据划分侧;同一病历的报告与影像也不能因为文件名不同而被随机拆开。PULSE 研究把训练与测试按患者划分,作为纵向任务的基本约束之一。1 一项 2025 年对阿尔茨海默病深度学习研究的范围综述也指出,患者级划分和外部验证不足会使某些看似很高的结果难以解释,方法学风险较高的研究更可能出现性能膨胀。7 这不是说某个固定指标一定可信或不可信,而是说明验收必须先问样本单位、划分规则和是否存在跨集合重复,再讨论 AUC、F1 或误差。
内部留出评估只能回答有限问题。更有意义的外部验证应改变至少一个重要条件,例如来源机构、时间段、设备或协议、科室构成、语言或人群,并在验证前冻结预处理和标签映射。MEDomics 研究展示了将结构化信息、非结构化病历和长期记录组织进持续更新基础设施的路径,同时把其分析表述为真实世界癌症队列中的研究性证明,而不是所有医院都能复制的临床效果。2 多模态研究综述也提醒,异质数据的缺失、异步时间和融合方式会同时影响模型性能与可解释性,临床部署前仍需要真实世界的完整评估。3
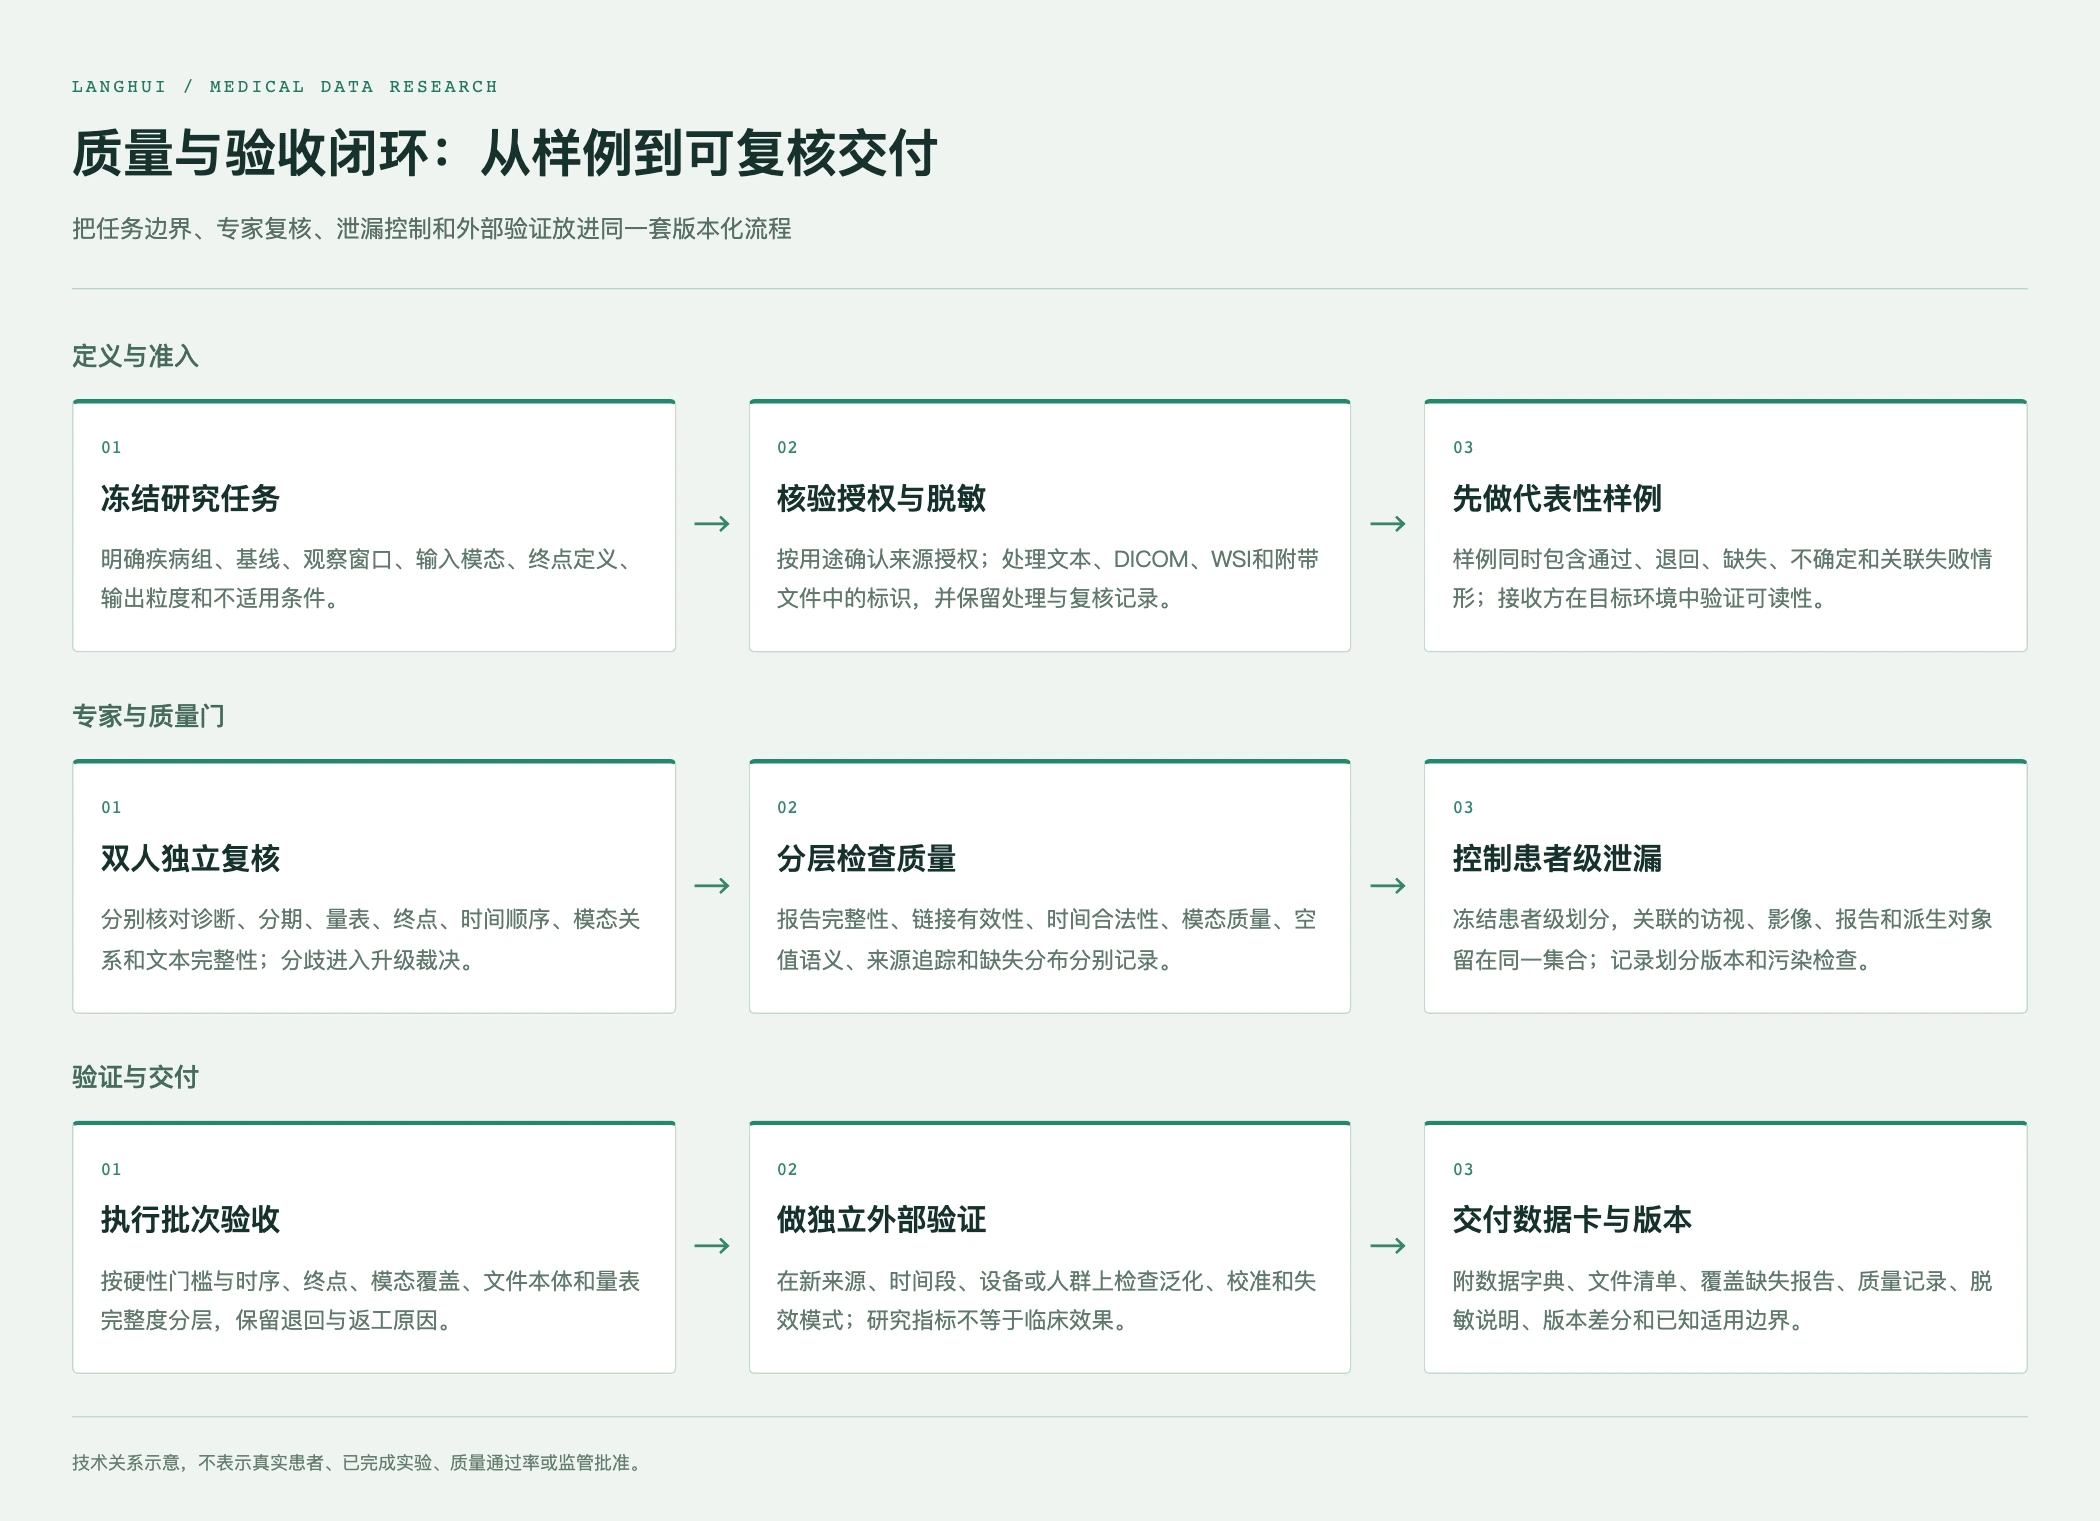
图2|从任务定义、双人复核到外部验证和版本交付的技术示意;不表示真实患者、实验完成、诊断准确率或监管批准。
把验收和业务逻辑写成可回放流程
可实施的验收通常从小批样例开始,而不是直接承诺大批量交付。样例应同时包含合格、退回、缺失、不确定和跨模态关联失败的情形,让算法、临床和质量人员共同确认数据字典。每个样例要能打开对应的文书、报告、文件清单和关联键;接收方还应在目标训练环境中测试编码、文件格式、时间字段和空值规则。样例通过不等于量产范围自动成立,任务、授权、源文件、模态本体和质量阈值仍需在项目文件中冻结。
批次验收可以按硬性门槛与分层质量组织。硬性门槛包括关键关联断裂、全文本严重截断、终点没有依据、患者跨训练测试重复、脱敏残留、影像序列与报告无法对应,以及必需模态缺失。分层质量则可记录时序长度、终点精度、模态覆盖、文件本体、量表完整度和外部可用性。对于只提供结构化结果、不提供原始文书或影像本体的批次,应明确其适合的研究用途,不把它与全源文件交付混称。
交付物不应只有数据表。建议至少配套数据字典、文件清单、覆盖分布、缺失与异常报告、抽样复核记录、脱敏处理说明、版本差分和数据卡。数据卡中应说明来源类型、时间范围、目标人群、病种和模态边界、观察窗口、终点定义、缺失机制、划分方式、已知偏差与不适用研究。若使用 DICOM 去标识配置,需注意 DICOM PS3.15 明确提示:属性级去标识并不保证整个信息对象绝对不可识别,像素中烧录的文字、图形叠加、私有标签和跨序列一致性仍需纳入流程。5 因此,去标识应当是数据治理和风险评估的一部分,而不是交付末端的一次字段删除。
业务逻辑也应围绕研究用途而不是文件数量展开。队列建设可以按疾病组、观察窗口和终点拆成多个工作包;全文本、报告、DICOM、WSI、组学和量表可以按是否可得、是否授权和是否通过质量门分别交付;缺件、返工、复核和版本升级应有独立记录。这样,研究团队可以知道当前数据能支持什么,供应方可以知道哪些工作属于字段治理、哪些属于专家标注、哪些需要额外的源文件处理。合同价格、特定机构名单和内部经营数字不应进入公开技术文章,也不能被模型指标替代。
能力适配要保持边界
在已核验的公司范围内,朗慧科技将自身定位为 AI 数据基础设施及流程服务商,LangData 覆盖采集、处理、标注、质检和数据交付;医疗方向提供按部位、模态和任务组织的数据目录与项目化评估入口。基于这一定位,较适配的工作包括协助梳理数据字典和文件清单、组织专业标注与复核、设计质量门和版本记录、检查关系键与交付可读性,并按项目范围整理可审计的研究数据包。
这种能力边界不等于已经拥有某个特定病种的现货队列,也不等于独立证明了病例规模、专家数量、临床效果或监管状态。实际可用数据、来源授权、观察长度、模态覆盖、标注主体和交付周期都必须在项目书面文件中单独确认。公司可以支持把需求拆成可验收工作包,但不能把建设目标写成既成数据成果,也不能把研究性性能、公开论文或网站目录自述写成临床批准或诊断承诺。
对医疗 AI 研发和数据采购读者而言,真正有价值的交付不是一个看似庞大的压缩包,而是一条可回放的证据链:研究问题被明确,患者轨迹可排序,模态之间能挂接,缺失和冲突有记录,专家判断有版本,训练划分不泄漏,外部验证有计划,接收方可以在目标环境中复核。长时序多模态病历只有在这些条件同时成立时,才从“可存放的材料”变成“可解释、可审计、可复用的研究基础设施”。
参考来源
- Longitudinal alignments and syntheses of multimodal clinical data for personalized medicine with the PULSE framework
- An artificial intelligence framework integrating longitudinal electronic health records with real-world data enables continuous pan-cancer prognostication
- Research progress on electronic health records multimodal data fusion based on deep learning
- Connecting Data to Accelerate Cancer Research — NCI Cancer Research Data Commons
- DICOM PS3.15 E Attribute Confidentiality Profiles (Normative)
- Provenance — FHIR v5.0.0
- Data Leakage in Deep Learning for Alzheimer's Disease Diagnosis