
MEDICAL DATA RESEARCH
颅脑结构分割不是“画满”:固定5 mm CT的17类标签如何转成可复现训练数据
围绕固定5 mm头部CT的17类颅骨、脑池、脑沟、钻孔与置管标签,说明窗位、边界、逐层修订、盲审仲裁、患者级划分、外部验证与导出验收,帮助医疗AI团队把结构分割需求写成可复核的数据规范。
当一套头部CT标注同时要求区分左右颅骨、多个脑池、脑沟、钻孔和置管时,最容易出现的错误并不是少画一条轮廓,而是把不同证据层级的结构当成同一种“像素分类”问题。固定5 mm序列、骨窗与脑窗切换、患者解剖左右、术后缺损补全、脑池受压变形以及导管伪影,都会改变一个标签的含义。若没有先冻结语义,算法训练、专家复核和最终验收可能各自遵循不同的“正确”,得到的Mask即使看起来完整,也很难复现或解释。
本文把一份颅脑结构分割规范改写为可执行的数据工程问题,讨论输入模态、解剖对象、标签颗粒度、标注主体、模型路线、偏差控制、外部验证和交付验收。它面向医学AI研发与数据采购,不构成个体诊断或治疗建议;文中不使用任何患者样本、病例信息或项目商务条款。
先把需求拆成一个有边界的临床数据任务
这项任务的主输入不是任意头部影像,而是项目指定的固定5 mm头部CT序列。薄层序列和多平面重建可以帮助判断骨缝、缺损曲率或导管走行,但不能替代主序列,也不能把不同序列混在同一轮标注中。显示语境也要先冻结:源规范将骨窗设为窗宽2000 HU、窗位400 HU,脑窗设为窗宽80 HU、窗位40 HU,置管则要求双窗结合邻层确认;若项目调整这些参数,应在版本化指南中另行记录。这样的限定很重要:层厚、重建核、窗宽窗位和方向共同决定可见边界,若输入条件变化,标签定义和模型表现都可能随之变化。DICOM影像中的空间位置、方向和参考关系还必须保留,不能将截图当成训练标签或几何依据。DICOM当前标准的分割对象将分割作为与参考影像关联的影像对象来组织,实施时仍需按项目确认编码、参考序列和下游软件的兼容性。1
输出是逐层、连续的体素级语义标签,而不是单层框、点或阅片结论。标签名使用小写英文与下划线,颜色只服务于显示,不能代替类别键。数据颗粒度至少包括检查/序列级元数据、切片或体素级Mask、结构级状态以及审核和版本记录。对脑池、脑沟、钻孔和置管,单一标签可以包含多个不连通区域;这意味着评估时不能只问“是否只有一个连通块”,而要问每个可见区域是否都满足该类的定义。对完全消失、被伪影遮挡或位于扫描范围外的结构,则应区分“不可辨认”“不适用”和“阴性”,不能把无法观察强行编码为正常。
这份规范的17类标签分为三组。第一组是八类左右对称的颅骨:left_frontal_bone、right_frontal_bone、left_parietal_bone、right_parietal_bone、left_temporal_bone、right_temporal_bone、left_occipital_bone、right_occipital_bone。第二组是六类不分左右的脑池:suprasellar_cistern、sylvian_cistern、prepontine_cistern、ambient_cistern、quadrigeminal_cistern 和 cisterna_magna。第三组是三个补充标签:burr_hole、cerebral_sulci 和 catheter。基底节、丘脑等结构不在这次任务范围内,不能因为它们在头部CT中可见,就擅自扩充类别或将其作为阴性对照混入金标准。
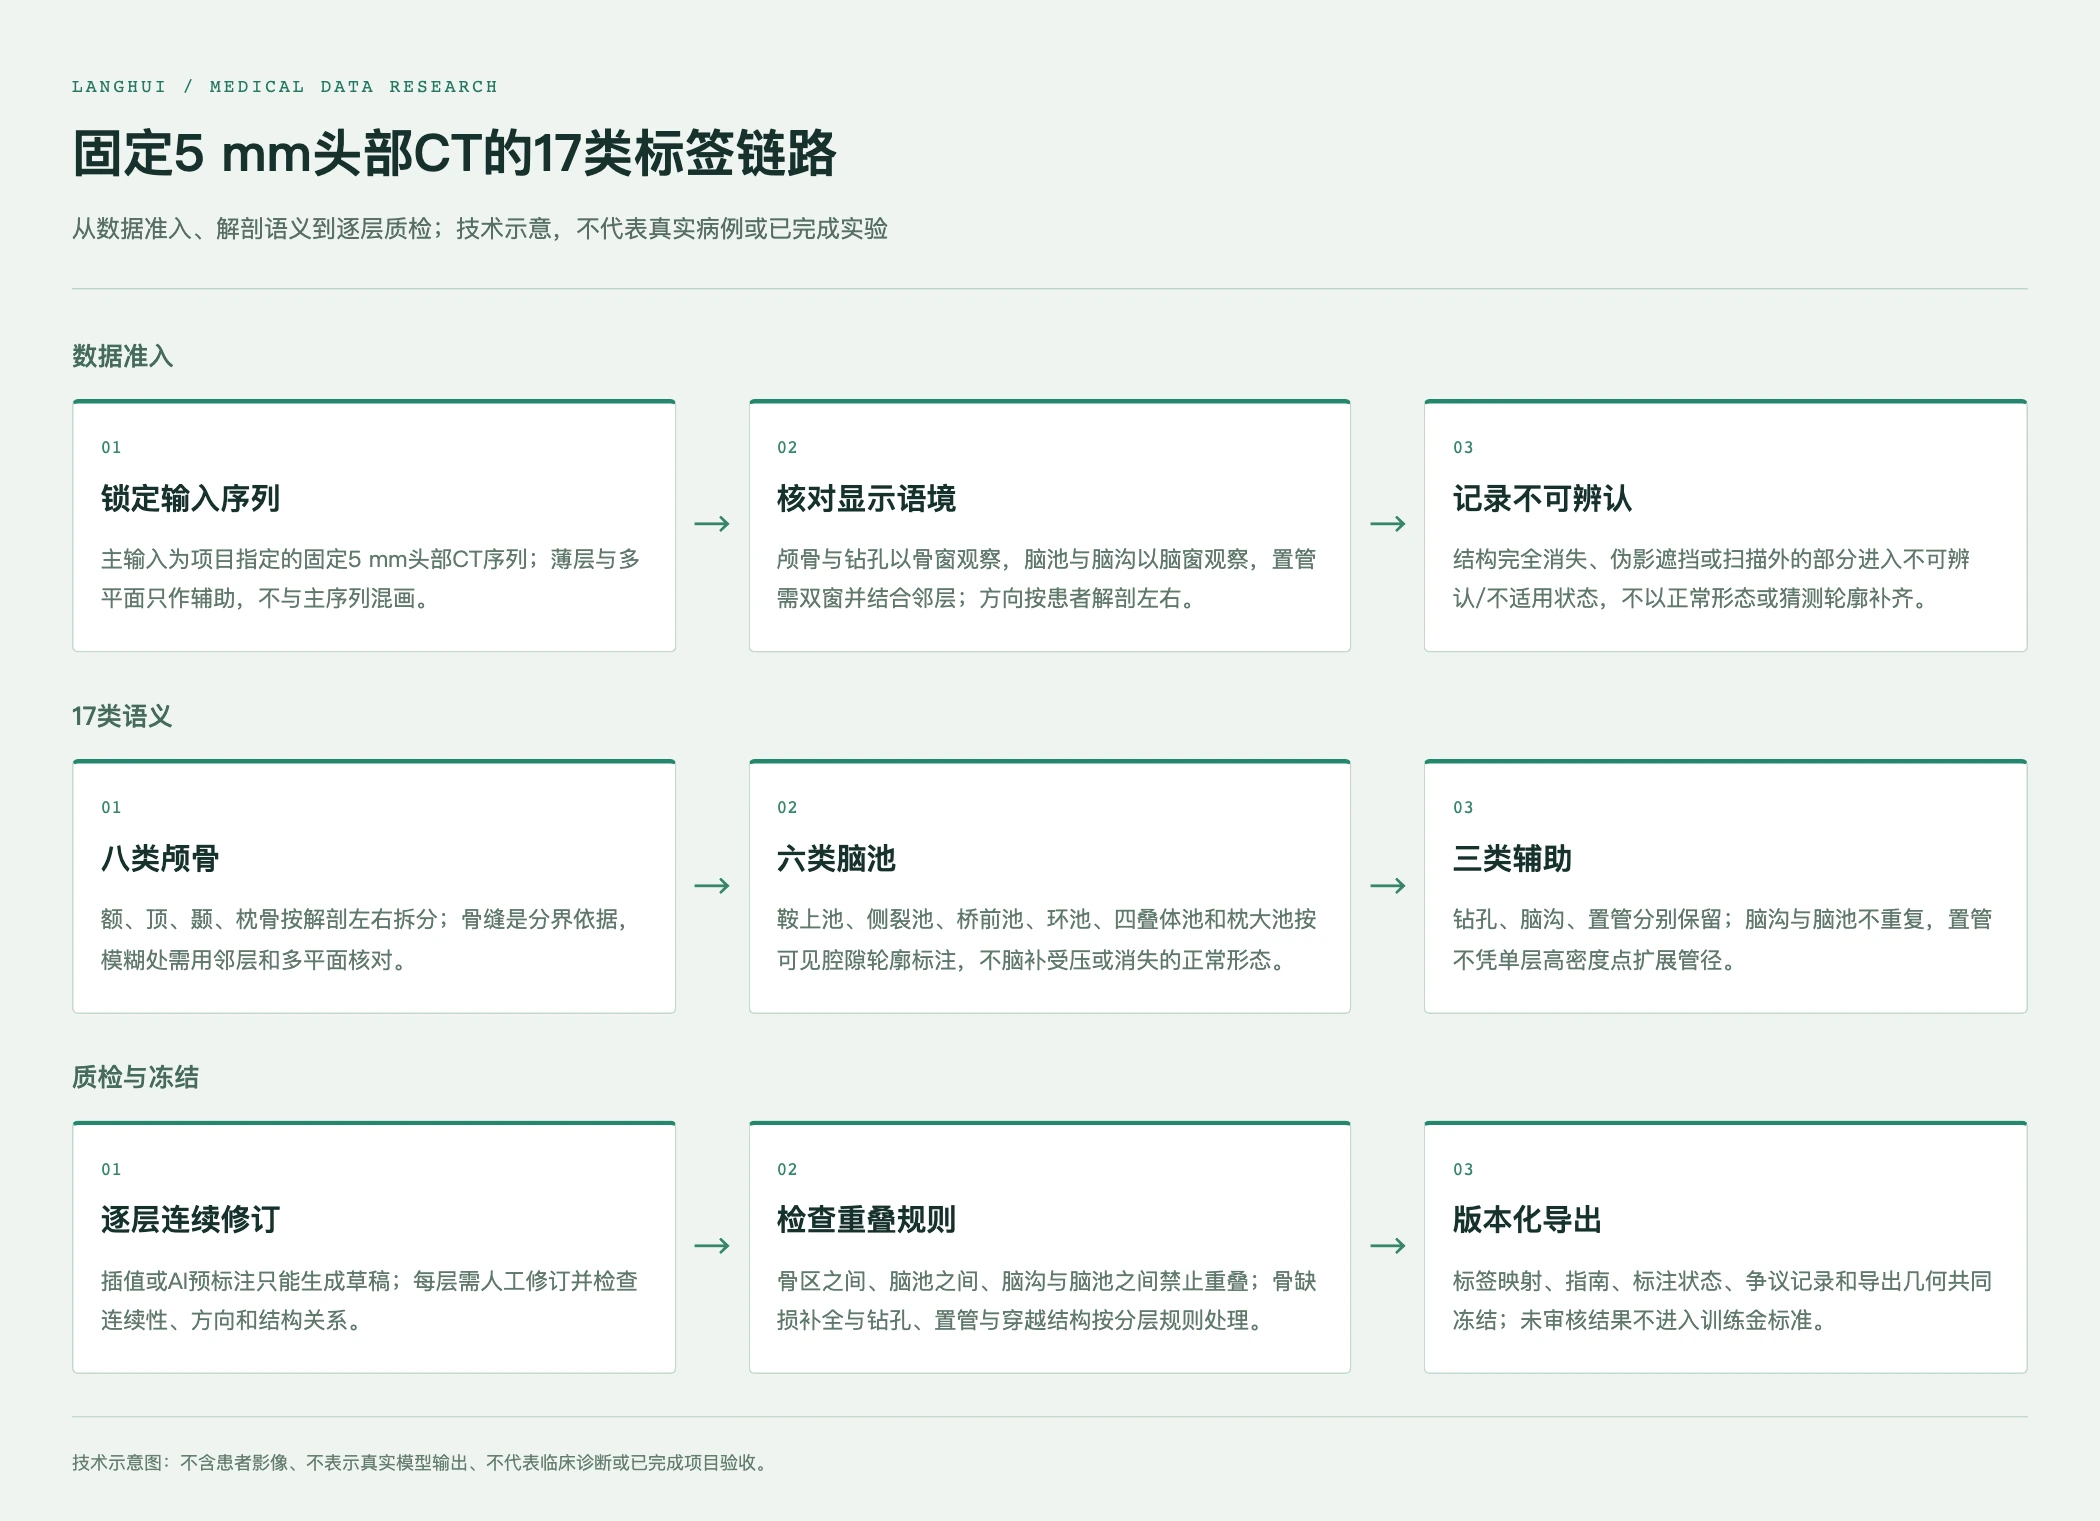
图1 固定5 mm头部CT的17类标签链路。图示用于说明标注关系,不代表患者影像、实验结果或临床诊断。
颅骨、脑池和辅助结构需要三套不同的边界逻辑
颅骨分区不能简单地按灰度阈值切成八块。规范要求沿颅骨内外缘勾画,保留内板、外板和板障,并以冠状缝、人字缝和鳞状缝等解剖分界建立额—顶、顶—枕和顶—颞的区域关系。骨缝模糊时,应结合邻层与多平面判断;用一条直线替代真实骨缝,会把显示方便误当作解剖事实。正常孔道如额窦、枕骨大孔不能被填实,蝶骨、筛骨和面颅骨也不能因为靠近目标区域而被并入本任务。
术后去骨瓣或钻孔使颅骨规则更复杂。对于去骨瓣或钻孔形成的缺损,规范允许依据残存骨缘和邻层曲率补成连续的骨性壳层,并让它与相应正常骨区共用标签;但这只是解剖定位意义上的补全,不代表真实骨质,也不能被转写成骨量测量结果。跨越多个骨区的缺损要按原解剖分界分别补全,不能把整个颅腔涂满。人工材料可以作为轮廓参考,却不能追随金属伪影扩大;拿不准时应进入复核,而不是靠镜像或规则化膨胀制造确定答案。已有颅颌面CBCT多结构研究显示,模型结果会受到不同中心标签定义不一致的影响,尤其是薄骨和分界线;研究中的交叉验证分数不能替代本项目对标签语义的冻结。2
脑池的逻辑相反:只标可见腔隙,不恢复“应有的正常形态”。鞍上池位于蝶鞍上方,不包含垂体和第三脑室;侧裂池位于外侧裂内,不把凸面脑沟或硬膜下积液并入;桥前池位于脑桥与斜坡之间,不包含脑桥和第四脑室;环池围绕中脑两侧,不能把侧脑室颞角带入;四叠体池位于中脑顶盖后方,不包含松果体和导水管;枕大池位于小脑下方、延髓后方,也不能把后颅窝其他低密度区当成该标签。受压变窄按实际可见形态描画,完全消失或无法辨认时记录状态,不“脑补”一个对称的正常池。
三个辅助标签承担的是不同类型的证据。钻孔只表示可见的手术性骨缺损,不能扩展到头皮切口、皮下通道或正常骨缝,也不把大范围去骨瓣当作多个钻孔。脑沟是大脑皮质表面可见的沟隙,不分名称、不分左右;脑回、白质、脑室、脑池、术后腔隙和硬膜下积液均应排除,外侧裂已经由侧裂池表达时不能重复标注。置管则只覆盖影像可见的颅内或头皮下管体轮廓,包括脑室管、引流管和分流管头部段;单层高密度点不足以证明管体,扫描外或伪影遮挡的部分不能补画,气管插管、胃管、金属钉、支架和钛网也不能误归为置管。
从人工规则到算法路线:先分语义,再谈网络
算法方案不应把17类标签直接作为一张无约束的彩色图。一个可复现的基线可以采用适配各向异性体素的2.5D或3D语义分割框架,以固定5 mm序列作为主输入,利用相邻层和必要的多平面上下文,但将主序列与辅助序列的角色写入配置。nnU-Net的价值不在于给出一个“万能网络”,而在于根据数据指纹自动配置预处理、网络、训练和后处理;其原始研究也提醒,方法选择高度依赖数据属性和硬件条件,公开数据集上的表现不能直接外推到新任务。5 对本任务,更稳妥的做法是先以可复现的通用基线建立参考,再针对小体积脑池、细骨边界和术后结构进行任务级改造。
多头或分层建模比单纯扩大类别数更容易解释。颅骨头可重点处理左右关系、骨缝和缺损补全;脑池头应关注低对比、小体积、形态受压和不可辨认状态;辅助头则要防范脑沟与脑池的语义冲突,以及置管与金属伪影的混淆。训练时可对各类别设置分层采样或损失权重,但不能以“少数类权重”掩盖标签定义不一致。对脑池和脑沟,整体背景占比很大,单一总体准确率几乎没有解释力;对置管和钻孔,阳性体素稀少,漏掉一段连续结构可能比少量边缘偏差更值得单列记录。
预标注、插值和任何自动后处理都只能生成草稿。逐层人工修订是本需求的核心,不是异常情况。后处理可以在规则允许时去除孤立的标签值错误、检查连通性或恢复经人工确认的层间连续,但不能把扫描外的导管补出来,不能把已经消失的脑池按模板填回,也不能把人工材料伪影当成骨缘。模型输出进入训练金标准前,必须经过规定的审核状态和争议关闭;这与“模型已经画出轮廓”是两个不同事件。
数据划分需要按患者或检查级别隔离,而不是随机打散切片。若同一检查的相邻层被分到训练和测试,模型可能通过几何相似性获得不真实的优势;同一患者的术前、术后或重复检查也应按研究设计放在同一分区,除非明确做纵向外部测试。预处理应记录窗位窗宽、重采样、方向校正、强度截断和软件版本。对固定5 mm任务训练的模型,薄层、不同重建核、不同层间距或不同扫描范围不是“同分布的新样本”,而是需要单独评估的输入条件。
专家标注不是最后一道签字,而是金标准的形成过程
标注主体应在项目开始前定义。至少需要一套明确的指南、正反例和难例集,说明不同结构的包含与排除,允许使用哪些辅助序列,手术记录在什么情况下只能作为背景信息,何时必须提交复核。影像可见性优先于推测性证据:手术记录不能替代影像轮廓,不能因为知道某处曾放置导管就把影像上不可见的管段补画。对于骨缺损,标注者需要知道“解剖补全”与“真实骨质”是不同语义;对于脑池,需要知道“不可辨认”与“阴性”不是同一状态。
推荐先由两名经过培训的标注者独立完成一批小样本,再进行盲审和仲裁。盲审的含义是审阅者不能直接看到他人的轮廓或修改理由,以免把先前答案当作参考。分歧不宜简单取平均:左、右侧颠倒、脑池与脑沟重复、把钻孔当正常孔道、把置管伪影扩大成管体,都是语义错误,不能被一个总体重叠度抹平。仲裁者应依据冻结后的条款和对照样例记录理由;若规则本身无法处理某类情况,应修订指南并重新标记受影响批次,而不是事后悄悄改变金标准。
对脑池完全消失、低对比无法判断或被伪影覆盖的层面,允许保留不确定或不可辨认状态,通常比强行给出一个“正常形状”更诚实。关于医学分割不确定性的研究提出了用范围或多层轮廓表达高置信与可能区域的思路;相关工作是未经过同行评审的预印本,本文只把它作为不确定性记录的研究提示,不能直接当作本任务的现成标注格式,但它提示项目方:争议区可以被显式记录,而不是被压缩成没有来源的单一真值。7 在实际交付中,是否采用多轮廓、软标签或仅保留争议状态,应由任务用途、下游损失函数和审核成本共同决定。
质量评价要同时看重叠、边界、连续性和语义
验收不能只设一个总Dice。对于颅骨,可以按左右骨区分别计算重叠度和边界距离,并额外检查骨缝分区、孔道是否被填实、缺损补全是否越过原解剖边界。对于脑池,应分别报告每类的重叠度、表面距离、起止层一致性和“不可辨认”状态的一致性;侧裂池、环池和四叠体池的可见范围不同,不能把大结构对小结构的平均结果作为整体质量。对于脑沟、钻孔和置管,应单列漏标、误标和断裂次数,尤其检查相邻层的连续性与管体直径是否被人为加粗。
分割研究中的高分也必须放回样本和参考标准中解释。颅骨多结构研究在CBCT上使用多中心数据和人工标注,报告了不同结构之间的表现差异,并指出部分差异与标注不一致、样本量和结构细节有关;这正说明专家标签的定义会影响模型评价,而不是“分数低”就必然等于网络差。2 颞骨解剖的nnU-Net研究同样在很小的高分辨率数据集上比较多个细小结构,某些结构的Dice明显低于其他结构,说明细小、复杂或边界不稳定的目标需要独立解释,不能被大结构平均值掩盖。3
脑池分割的近期研究也提供了一个有用的验证提醒:在头部CT上,较大脑脊液区域可以得到较高重叠度,而高凸面蛛网膜下腔等细小或形态复杂区域的外部验证表现更低;研究因此采用独立外部数据检验模型,而不是只报告内部结果。4 这与本任务的经验相通:固定5 mm、术后缺损、脑池受压和置管存在时,应把“是否能在新设备、新重建条件和新结构状态下保持语义边界”作为验证问题,而不只是看训练曲线是否收敛。
公开报告规范CLAIM 2024更新要求研究交代数据来源、纳排标准、预处理、参考标准的形成方式、标注者资格、分区是否在患者层面独立、性能不确定性、稳健性分析和外部测试等内容。6 因此,项目验收表至少应能回答:本批数据使用了哪一版标签字典;哪些病例含骨缺损、钻孔或置管;哪些结构不可辨认;标注者是否看到了同一组示例;测试集是否与训练患者完全隔离;评价脚本是否把不可适用与阴性分开;外部样本是否改变了层厚、设备或重建协议。
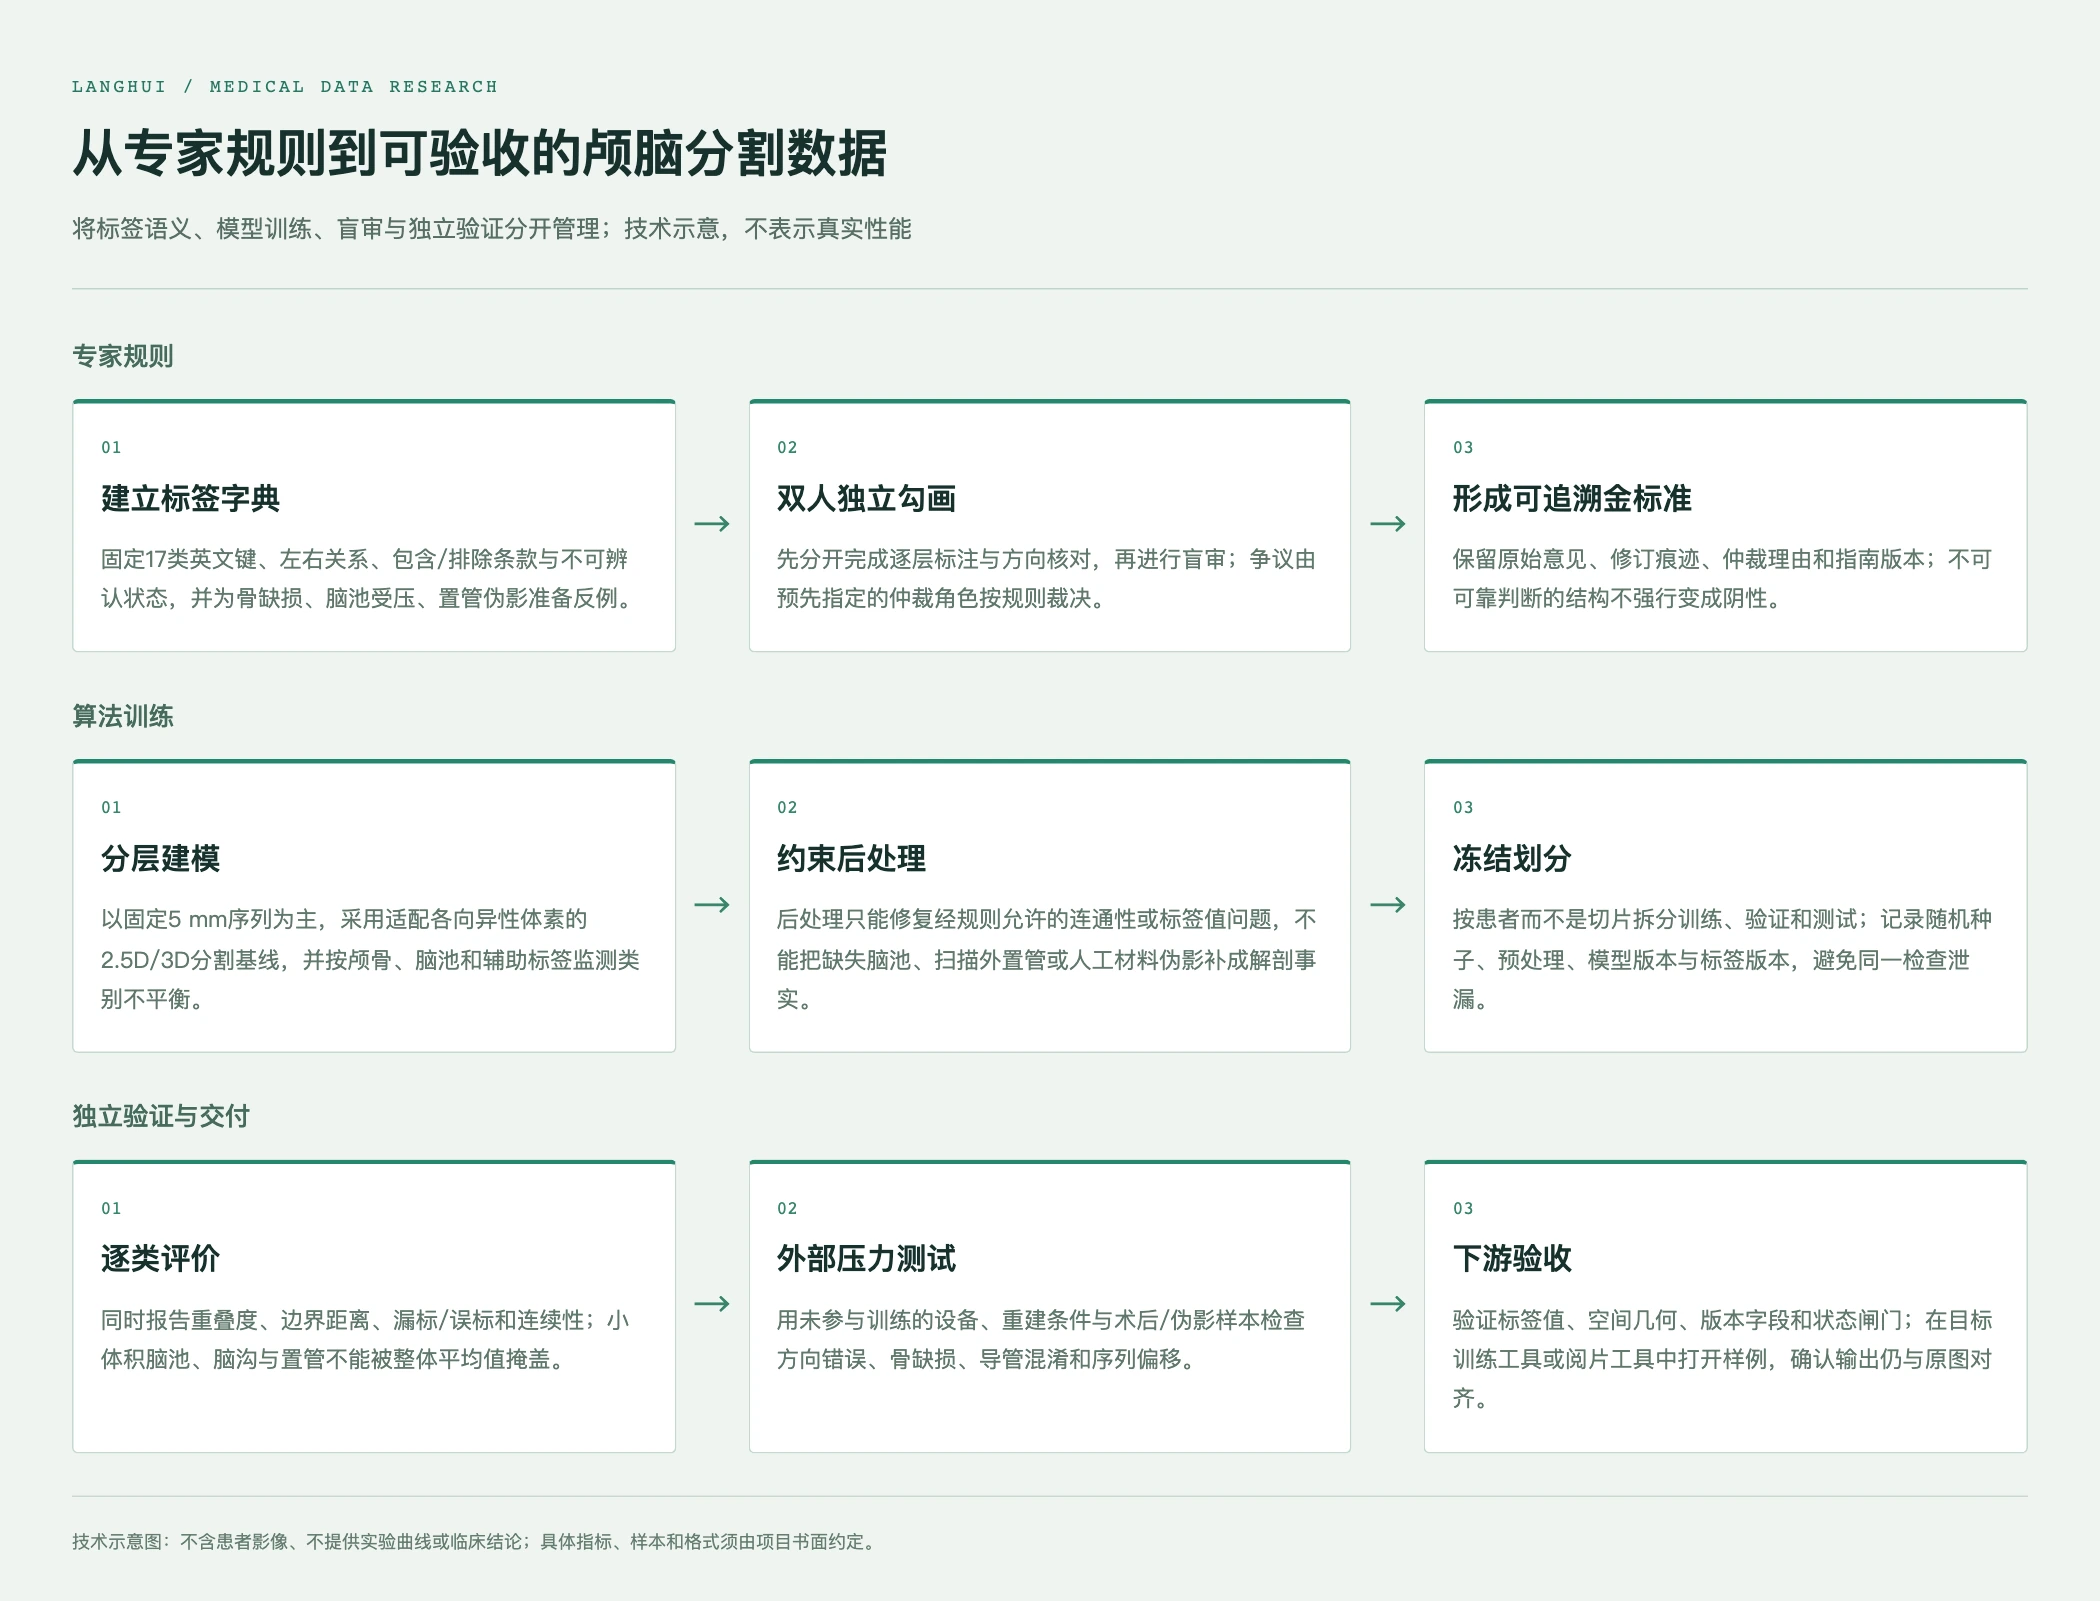
图2 颅脑分割数据的规则、算法、外部验证与下游验收关系。图示不提供实验曲线或临床结论。
把验收写成可操作的交付逻辑
第一道闸门是数据准入。导入后应核对序列标识、层数、层厚、方向、像素间距、患者坐标关系和是否存在无法解释的缺层。固定5 mm是本需求条件,不是可以随意写成“头部CT均可”的泛化承诺。窗宽窗位记录应进入方法学说明;骨窗、脑窗和双窗的使用场景必须与标签字典一致。严重运动、金属伪影、扫描范围不足或结构完全不可辨的样本应进入隔离或不可标记录,而不是为了维持数量被迫完成轮廓。
第二道闸门是规则准入。验收人员可以用脱敏样例逐项检查17个标签是否使用当前英文键,左右侧是否按患者解剖而非屏幕位置判断,脑池与脑沟是否重复,八类颅骨是否发生非法重叠,钻孔与骨区补全是否按分层保留,置管是否被金属伪影放大。对每个失败样例,记录失败类别、切片范围、责任环节、返工状态和指南版本;“整体看起来还可以”不能代替可检索的退回理由。
第三道闸门是审核和导出。只有完成约定的单盲或多盲审核、关闭仲裁记录并标明版本,结果才可进入训练集或科研交付。若采用DICOM SEG、NIfTI或其他格式,应分别约定类别映射、坐标系、参考影像、方向、间距、压缩方式和下游读取工具;DICOM标准的存在不等于某个具体系统已经完成互操作,专项格式仍需用样例验收。1 最小可执行验收是:打开原始影像与标签,检查空间叠合;抽查每类标签值;核对版本和审核状态;在目标训练工具或阅片工具中读取一例;对失败结果保留可回滚的版本,而不是覆盖原文件。
需求、研发建议与服务能力必须分开写
需求本身是:固定5 mm头部CT上的17类结构分割,要求特定窗位、方向、逐层连续、术后缺损分层处理、脑池不脑补、置管不凭单层点扩展,并明确哪些结构禁止重叠。研发建议是:以适配各向异性的2.5D/3D基线起步,按语义组分层监测,使用患者级划分、双人独立标注、盲审仲裁、逐类指标和外部压力测试。两者都不等于某个团队已经拥有现成模型、固定准确率或完成临床验证。
在已核验的公司能力边界内,朗慧科技被定位为AI数据基础设施与流程服务商,自研LangData覆盖采集、处理、标注、质检和数据交付;质量交付以项目规格、数据卡、样例、质量记录和版本为依据。由此,这个任务的适配点应是把标签定义、数据准入、专家审核、争议记录和版本化交付组织成可核查流程,而不是把公开研究的模型分数写成公司能力,也不是把网站上通用的“脑”或“头颈”名称当作17类任务的独立证明。具体模态、工具、专家角色、样本范围、导出格式和验收阈值,仍应通过授权样例和书面项目规格确认。
对算法团队,交付物应至少包括当前标签字典、输入序列约束、方向与体素间距说明、不可辨认状态定义、患者级数据划分、预处理配置、模型和后处理版本,以及一份在训练代码中可复现读取的样例。对医学专家,交付物应包括正反例、术后和伪影难例、盲审角色、仲裁条款和变更记录。对采购与信息团队,交付物应包括脱敏与授权边界、权限和日志要求、导出审批状态、版本冻结和失败回滚方式。三套材料相互关联,但不应被一张产品截图替代。
结语:高质量不是把每个空白都填满
颅脑结构分割的研发价值,来自把复杂解剖和复杂状态转成可以复查的标签合同。固定5 mm序列限制了输入语境,却也为任务复现提供了明确起点;17类标签增加了细节,却迫使团队区分左右、连通、不确定和分层重叠;术后缺损与置管增加了难例,却让验证更接近真实数据生产而非理想化Demo。真正可交付的数据,不只是像素Mask,还包括它为什么这样画、哪些地方不能判断、谁复核过、哪一版规则生效,以及在新样本上如何检验。
如果一个项目能在训练前回答这些问题,算法路线可以迭代,模型也可以更换,而标签语义和验收逻辑仍然可追溯。相反,如果先追求“画满”和单一分数,再补规则、补版本和补外部验证,后续出现的性能变化就无法判断究竟来自网络、数据、窗位、解剖状态还是标注标准本身。对于医疗AI研发和数据采购,这种可解释的工程闭环,往往比一个脱离任务条件的漂亮数字更接近可复用价值。
参考来源
- DICOM PS3.3 2026d - Information Object Definitions
- Automatic multi-anatomical skull structure segmentation of cone-beam computed tomography scans using 3D UNETR
- A Self-Configuring Deep Learning Network for Segmentation of Temporal Bone Anatomy
- CT-based automatic segmentation of key CSF regions for detecting disproportionately enlarged subarachnoid space hydrocephalus
- nnU-Net: a self-configuring method for deep learning-based biomedical image segmentation
- Checklist for Artificial Intelligence in Medical Imaging (CLAIM): 2024 Update
- Uncertainty-Aware Annotation for Medical Semantic Segmentation