
MEDICAL DATA RESEARCH
髋膝关节 CT 数据集:从骨性分割到手术规划的标注与验收
面向医疗AI研发与数据采购,拆解髋膝关节CT的扫描范围、骨掩膜、LPS关键点、病理例外、盲审与独立验证,说明如何把数据做成可复核的手术规划研发资产。
髋膝关节 CT 数据如果只交付一批“画过的骨头”,能否支持手术规划算法、模型训练和医疗器械注册?通常不能。真正决定数据能不能进入下游的,不只是病例数量,而是扫描范围、体素空间、左右侧语义、病理例外、关键点坐标和审核证据能否在同一套规则下闭合。对这类任务而言,分割掩膜、解剖关键点和标签文本不是彼此独立的附件,而是共同描述骨性解剖的不同数据对象。
公开研究已经展示了髋膝 CT 从影像到几何测量的可行路径。一项膝关节研究用 DICOM CT 建立股骨、胫骨、腓骨和髌骨的逐层标注,并同时考察重叠度和表面距离;另一项髋膝术前 CT 研究则把层面定位、分割和角度或距离测量串成流水线。1 这些结果说明自动化有工程价值,却不等于任意项目都能直接复用同一模型,更不等于已经产生临床获益。要把数据采购或专项标准改写成可执行的研发资产,第一步应是把临床任务拆成输入、标签、坐标、粒度和验收证据。
先把临床任务拆开:不是一张骨掩膜
这类数据的临床背景通常是髋膝关节手术规划、三维重建或相关医疗器械研发。算法输入是符合 DICOM 语义的 CT 体数据,算法输出可能同时包括骨结构分割、左右侧识别、病理状态标签和解剖关键点。它们服务于不同的后续操作:掩膜用于重建和配准,关键点用于建立轴线、旋转中心或测量基准,病理标签用于分层训练、误差解释和适用范围界定。若把三类任务混成一个“标注完成率”,就无法判断是边界错、侧别错,还是病例根本不适用于某个点位。
膝关节至少有两种输入形态需要被明确区分。一种是覆盖下肢较长范围的全长扫描,便于观察股骨和胫骨的整体关系、机械轴或远近端参照;另一种是以关节间隙为中心的局部扫描,细节更适合关节面和局部关键点。二者的视野、层数、骨段完整性和可推导测量并不相同,不能只在文件夹名称上区分。训练集可以包含两种范围,但标签字典、质控抽样和测试分层必须保留扫描范围字段,否则模型可能学习到“范围”而不是解剖结构。
髋关节任务关注的输入范围又不同。应确认骨盆和股骨近端是否完整,股骨头、股骨颈、大小转子以及骨盆髋臼、前后柱和闭孔环是否在视野内。髋关节退变、股骨颈骨折和转子间骨折会改变骨性边界的形状与连续性,因此“正常解剖位置”不能被简单理解为一条固定模板。骨折病例的关键点有时需要依据对侧结构或骨折前的解剖关系推定,这一推定必须带有不确定性记录,而不是伪装成与正常病例同等明确的真值。
疾病状态也应成为数据设计的一部分。膝关节可按正常或基本正常、不同程度退变以及严重退变分层;髋关节则可区分正常、退变和不同骨折类型。这里的状态标签用于定义队列和评估亚组,不应在没有临床结局支持时直接写成预后或治疗标签。若某一结构在严重退变、骨性强直、骨折愈合或既往手术后发生真实融合,标注应记录“影像实际融合”,而不是机械制造一个看似整齐的间隙。
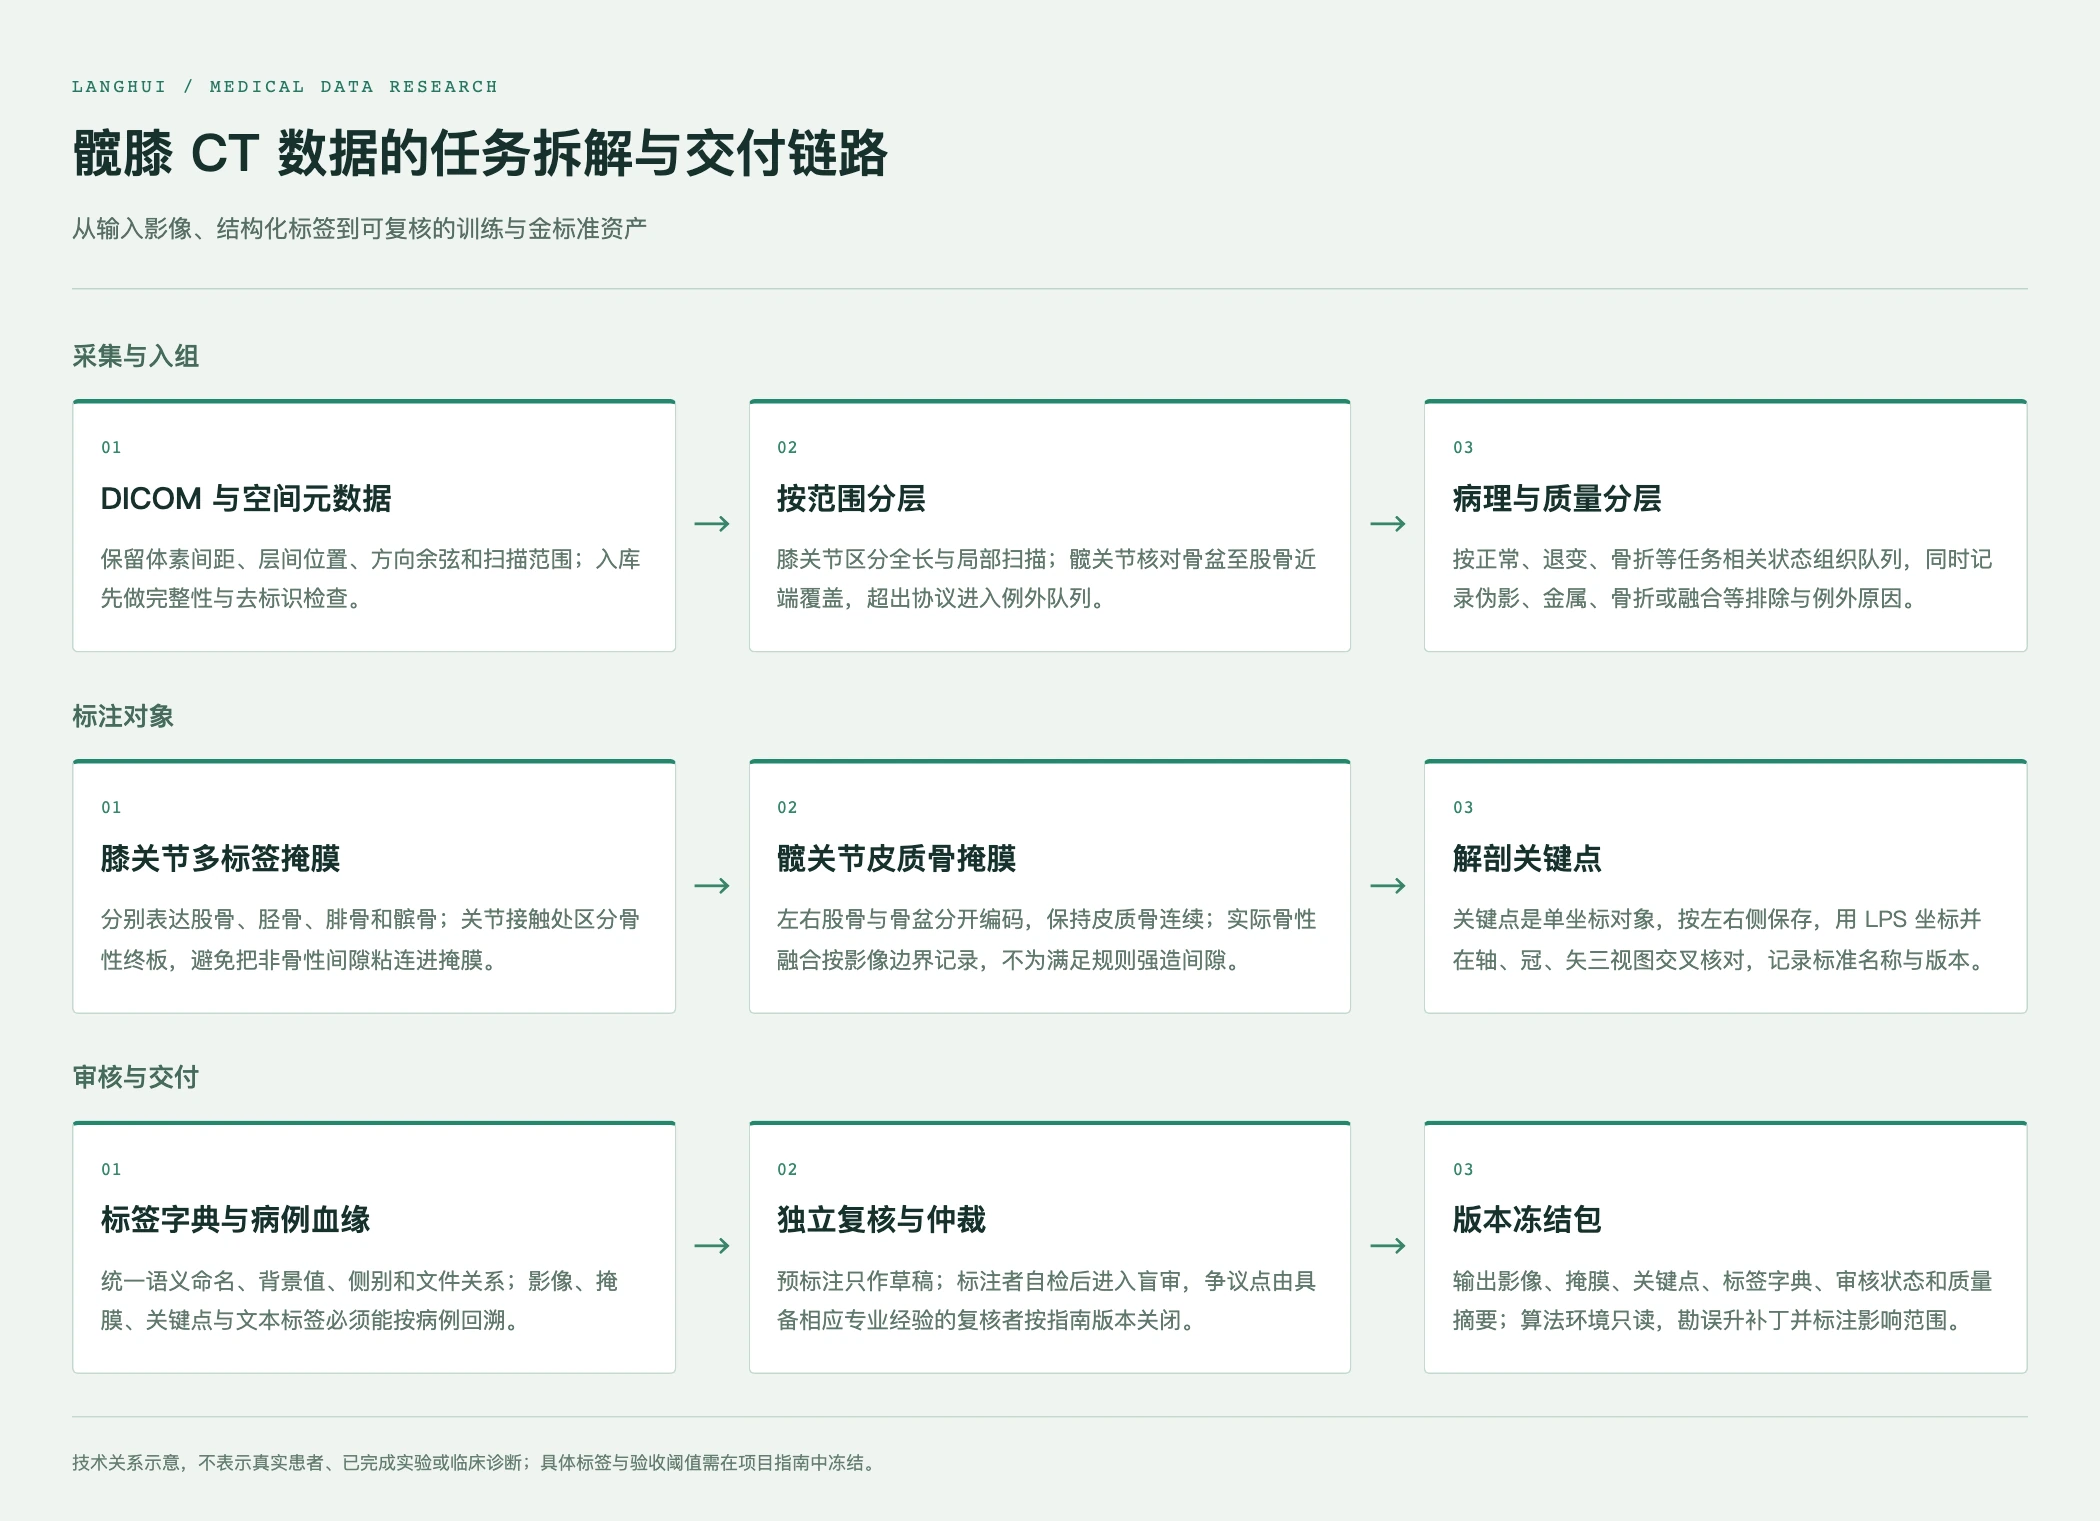
图1 髋膝 CT 数据的任务拆解与交付链路。技术关系示意,不表示真实患者、已完成实验或临床诊断;具体标签与验收阈值需在项目指南中冻结。
数据设计:扫描范围、病理层级与数据颗粒度要同时冻结
数据集的最小颗粒度应是“病例—检查—序列/重建—侧别—结构对象”。病例是划分训练、验证和测试的基本单位;检查决定一次 CT 的空间和采集上下文;序列或重建版本决定层厚、方向和图像质量;侧别决定左右股骨、胫骨或关键点的语义;结构对象则决定掩膜、点和文本标签如何互相引用。把切片当作独立样本会带来严重泄漏风险,同一病例的相邻切片或派生文件可能同时进入训练和测试,结果看起来很好,却不能代表新病例上的表现。
采集阶段应把 DICOM 头信息当作算法输入的一部分来治理,而不是交付后再手工补表。DICOM 的患者坐标系由图像位置、图像方向和像素间距共同决定;像素索引转换到患者空间需要同时使用原点、行列方向余弦以及行列间距。6 这也是为什么只保存 NIfTI 或图片而丢掉原始几何元数据,会让关键点的毫米误差、左右侧关系和三维重建难以复核。若在预处理时重采样,还要记录插值方法、目标间距、裁剪范围和版本,避免掩膜边界与点坐标来自不同空间。
纳入与排除不能只写“图像质量好”。应把层间缺失、层厚超出范围、严重运动伪影、金属植入、非目标部位缺失、骨折或融合等情况分别编码。某些例外可能应排除,某些例外则正是模型需要面对的边界样本。质量规则需要回答两个问题:这个病例是否进入主训练集或金标准集,以及若保留,是否需要在评估时作为单独亚组。把所有困难病例静默删除,会造成数据分布看起来更整齐,却无法说明模型对真实复杂解剖的适用范围。
分层还应覆盖年龄段、退变程度、骨折类型、左右侧、全长与局部扫描以及设备或中心。分层不是为了制造漂亮的配比,而是为了让训练、调参和测试的差异可解释。对少数但高风险的骨折、严重退变或融合病例,可以采用分层抽样、加密审核或单独的外部测试,而不是用总体平均把它们的错误稀释掉。CLAIM 报告规范要求明确数据纳排、参考标准、标注者、分区方式和评估数据来源,这些要求同样适合作为数据交付前的工程检查表。5
标签设计:掩膜、关键点和文本字典必须互相约束
膝关节的多标签掩膜至少需要区分股骨、胫骨、腓骨和髌骨,并保持左右侧编码稳定。关节接触处最容易发生“粘连”:股骨髁与胫骨平台在显示上接近,但它们的骨性终板属于不同结构,中间的非骨骼间隙不能因为平滑或插值而被填成骨。边界审核要在轴位、冠状位和矢状位之间来回核对,不能只在单张切片上追求轮廓闭合。骨赘是否属于目标也要在指南中写清;如果项目目标是骨性结构本体,骨赘可以作为影像状态保留,但不应未经定义就混入另一个结构标签。
髋关节的掩膜应区分左右股骨和骨盆,并规定皮质骨、髓腔、髋臼以及骨盆边界的纳入范围。股骨向远端延伸到哪里,骨盆向上、前后和下方覆盖到哪里,都应转化为可观察的解剖描述。皮质骨中的非生理性孔洞是否填补,不能靠标注者个人习惯;填补规则会改变连续性,也会影响后续的三维表面与测量。对实际骨性融合,正确做法是保留影像事实并增加例外标签或质量说明,而不是为了满足“必须有间隙”而修改真值。
关键点不是掩膜的质心,也不是在一张截图上画出的十字。它是一个有解剖名称、侧别、坐标系、单位、可见性和审核状态的单坐标对象。膝关节的关键点可以涉及股骨头旋转中心、内外侧髁远端与后髁参照、上髁、滑车沟、胫骨平台前后及内外侧边界、踝关节中心和胫骨结节;髋关节的关键点可以涉及双侧髂前上棘、耻骨联合、髋臼旋转中心与上/下外缘、前后缘、坐骨结节、股骨头中心及大小转子。这里的“可以”不是泛化清单:正式任务应冻结每个点的标准名称、侧别和定位方法,不能因为某点常见就默认它适用于所有扫描范围。
关键点清单还要写明例外路径。原任务对股骨颈骨折和转子间骨折允许按骨折前解剖位置或对侧结构推定,但“推定”应作为状态保留,不能与直接可见的点混成同一种真值;严重退变、骨性强直或真实融合时,也要记录影像事实和不可判定原因。每个点先在轴位、冠状位和矢状位交叉核对,再以 LPS 患者坐标输出,单位、空值和版本随点保存。这样,关键点才可作为轴线、旋转中心或测量基准的可追溯接口,而不是一组脱离掩膜与原始 CT 的数字。
关键点定位要先定义“如何找”,再定义“在哪里存”。例如球面拟合得到的旋转中心与单一切面手点可能不是同一个对象;髋臼前后缘若使用时钟定位,需要把参考平面、朝向和左右侧规则写进图谱。所有点应在同一患者坐标系下表达,并用三视图交叉确认。若算法输出的是像素索引,交付时必须同时给出到毫米坐标的转换依据;若关键点从掩膜推导,则要锁定掩膜版本和插值版本,防止边界更新后点悄悄移动。
文本标签不是说明性备注,而是模型读取和质检的主键。背景值、结构编码、左右侧、文件命名和病例目录必须形成一张有版本号的标签字典。字典还应记录废弃别名、禁止值、缺失值、异常值处理和例外原因。对于多标签文件,要确认标签值之间没有重叠含义;对于点文件,要确认点的顺序、单位和侧别不依赖人工记忆。最小可用交付不是“文件能打开”,而是下游程序能按字典正确读出结构、点和病例关系。
算法路线:先保证空间与对象正确,再谈网络结构
工程上可以采用“入库校验—预处理—粗分割—边界细化—几何点位—规则后处理”的分层路线。预处理阶段统一方向和体素间距,但不应丢掉原始坐标;粗分割阶段先定位骨性区域,细化阶段重点处理关节面、骨皮质、骨折边缘和相邻结构;关键点阶段可以使用单独的回归、热图或从审核掩膜推导的几何算法。每一阶段都要留下输入、输出、模型或规则版本,方便把错误归因到空间转换、分割、点位或后处理,而不是把所有失败都归为“模型不准”。
公开研究中,膝关节 CT 分割曾使用粗分割后再针对不确定边界细化的网络结构,并把 Dice、平均表面距离和 Hausdorff 距离并列报告。1 另一项 TKA 术前规划研究提出边缘损失与多尺度结构来改善股骨和胫骨表面,并进一步观察三维重建和测量可行性。3 这些工作给出的启发是:对手术规划,体素重叠并不是唯一目标,边界位移、薄层连续性和由边界推导的角度或距离同样重要。但公开研究的模型、扫描协议和病理范围与新项目不必然一致,不能把论文中的分数直接写进采购承诺。
nnU-Net 等自配置方法说明,预处理、网络和后处理可以根据数据特性进行系统化选择,而不是只依赖某个固定网络名称。9 TotalSegmentator 的研究则在包含不同年龄、异常、扫描仪和部位的真实世界 CT 上评估多结构分割,提示数据多样性和结构标签规模会显著影响可迁移性。4 对髋膝项目而言,优先级应是建立稳定的数据卡和基线,然后比较 2D、2.5D 或 3D 路线在边界、显存、推理时间和外部数据上的差异,而不是先承诺一个“最先进”模型。
术前规划相关的算法输出还需要经过几何层验证。分割后若要计算轴线、旋转中心、角度或距离,必须说明参考点的来源、拟合方法、单位和异常处理。公开的髋膝 CT 研究把层面分类、分割和测量串联起来,并在未参与训练的病例上比较自动与人工测量。2 这可以作为流程设计的参考,但不能替代当前项目自己的独立测试。算法输出如果会被下游软件用来配准或生成器械计划,验收应同时验证掩膜可读、坐标可重建、点位方向正确以及几何测量的误差分布。
专家标注:金标准不是“最后一次点击”
专家参与应按任务拆分。熟悉骨科影像或关节解剖的标注者负责按照图谱勾画和落点;独立审核者负责检查范围、侧别、层间连续性、关节间隙、融合例外和文件关系;仲裁者只处理预先定义的争议或高风险亚组。标注者与审核者不应在同一病例上互相暗示。若第二位读者能直接看到第一位的轮廓或点位,一致性会被高估,争议分布也会被压低。
在正式批量标注前,应使用不进入最终评测的教学例或脱敏体模做校准。校准材料要覆盖正常结构、边界模糊、严重退变、骨折、融合、伪影和左右侧不对称。每个关键点至少要有名称、定位步骤、参考切面、允许空值条件和典型反例。若某点在骨折病例中只能参照对侧推定,就应把“推定”作为标签状态,而不是让不同读者分别选择一个看似合理的点。
建议采用“初标—独立盲审—争议仲裁”的流程,并把自检与独立复核分开记录。自检关注漏标、重叠、命名和文件完整性;盲审关注边界、侧别、坐标和指南符合性;仲裁关注争议原因以及是否需要修改指南。对重复标注或观察者研究,应分别统计同一读者的重复差异和不同读者的差异。读者之间的距离如果已经大于模型希望达到的误差,就应该先修订图谱或培训,而不是直接增加网络复杂度。
预标注可以提升从空白影像到可审核草稿的效率,但草稿不能直接成为金标准。尤其在髋臼边缘、骨折线、严重骨赘、皮质孔洞和金属伪影附近,自动轮廓容易出现模式化错误。平台应保留原始草稿、人工修改和终审版本,算法训练只读取已审核版本。任何“算法环境回写金标准文件”的便捷操作都应关闭或受权限控制,以免草稿覆盖专家标签后又被误当成真值。
质量偏差与外部验证:把看起来准确拆成可解释证据
最常见的泄漏来自切片级随机划分、同一病例的双侧结构跨集合、重采样文件与原文件分开进入集合,以及同一患者多次检查被错误视为独立样本。每次划分都应保存病例清单、随机种子和版本快照。对纵向检查,如果任务不是预测变化,就应在病例层面统一归入一个集合;如果任务需要纵向配对,则要明确时间点、配对规则和是否存在治疗后信息泄漏。
第二类偏差来自采集协议。层厚、重建核、设备厂商、扫描范围和患者摆位会改变骨边界的外观。一个在单一协议下表现稳定的模型,遇到不同设备或不同重建条件时可能出现边界漂移。数据卡应记录这些变量,评估时按设备、中心、扫描范围和病理亚组报告,而不是只给一个总体 Dice。若某些亚组样本过少,应明确这是证据不足,而不是用数据增强或插值制造“覆盖”。
第三类偏差来自参考标准本身。骨皮质边界、关节间隙和关键点都可能存在观察者差异。对于薄层 CT,体素化、窗宽窗位、显示倍率和吸附工具会改变手动点击;对骨折和融合,临床语义比几何模板更重要。质量记录应把“指南歧义”“工具操作误差”“影像不可判定”和“真实解剖变异”分开编码。这样,后续模型误差分析才能回答是要改采集、改指南、增加标注,还是调整算法。
外部验证至少要与内部测试分开。冻结模型后,可以使用未参与开发的中心、设备、时间段或协议进行测试;如果暂时没有独立来源,也要把限制写清,并避免把内部留出测试称为临床泛化。近期对医学影像 AI 泛化研究的综述把外部验证定义为来自不同中心或人群的独立数据,并强调多中心、人口和扫描仪差异对评估可靠性的重要性。8 FUTURE-AI 共识则把公平性、通用性、可追溯性、可用性、鲁棒性和可解释性贯穿开发、验证、部署和监测全生命周期。7
评价指标要对齐临床任务。分割可以同时报告 Dice 或 IoU、平均表面距离、95% Hausdorff 距离或其他预先选定的表面指标,但要说明计算空间、结构、侧别和病例单位。关键点应报告毫米误差、点位缺失、错侧、异常值和不同点型的分布,不能用掩膜重叠度替代点位准确性。若输出用于角度或长度测量,还要直接评估测量误差和置信区间。任何阈值都应在测试前冻结,并说明是工程容差、研究终点还是注册资料中的适用性要求,不能在看完结果后倒推。
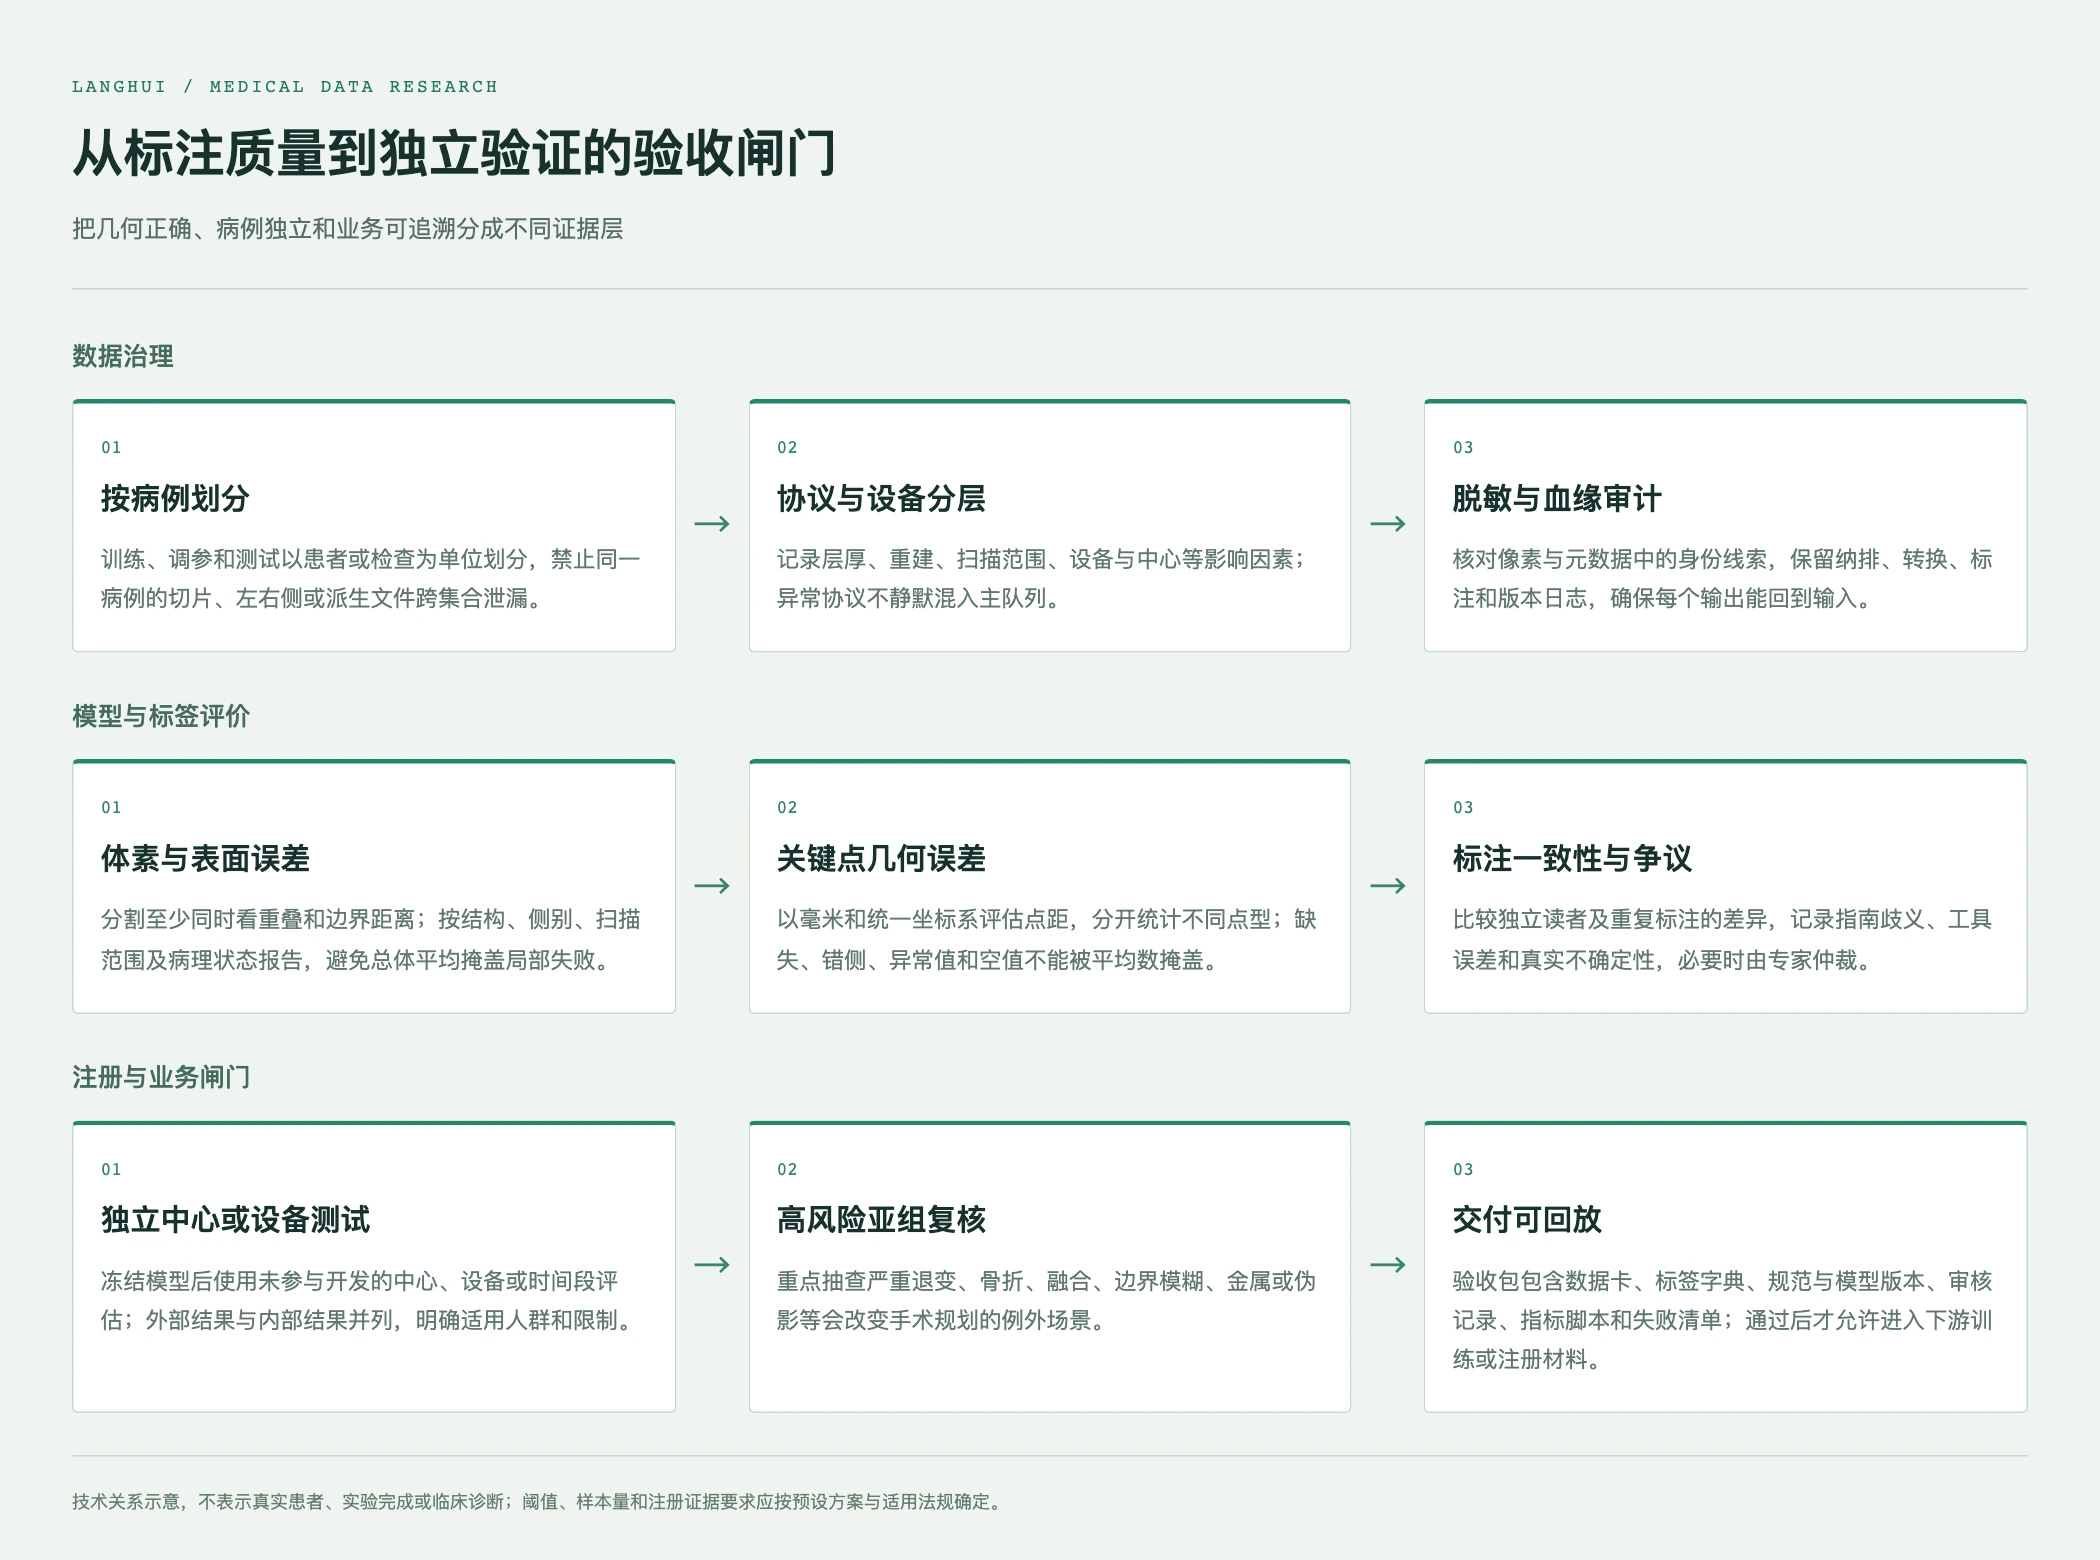
图2 从标注质量到独立验证的验收闸门。技术关系示意,不表示真实患者、实验完成或临床诊断;阈值、样本量和注册证据要求应按预设方案与适用法规确定。
验收与业务逻辑:交付的是证据包,不只是文件包
一个可执行的验收方案至少分为四层。第一层是输入验收:DICOM 可解析,必要的空间字段齐全,扫描范围和层厚符合约定,去标识检查完成,病例清单与纳排记录一致。第二层是标签验收:结构编码、侧别、边界、间隙、连续性和关键点字段符合字典;多标签掩膜与原始影像同空间,点位能在三视图中被重新定位。第三层是质量验收:独立复核和仲裁记录完整,按结构、侧别、范围和病理亚组汇总错误,不以总体平均掩盖高风险失败。第四层是下游验收:训练代码或目标软件能够读入样例,导出后坐标与掩膜仍然对齐,版本号、指标脚本和失败清单可回放。
注册相关研发还应保留“过程证据包”。其中包括纳排标准、扫描协议、脱敏规则、标签字典、图谱版本、标注者角色、培训和校准记录、盲审与仲裁记录、软件版本、数据划分、测试清单、错误分析和变更影响范围。过程证据不是把研究包装成已经获批,也不能替代具体产品的法规路径;它的作用是让后续团队能够回答“这一版标签如何产生”“这一项指标在什么样本上计算”“修订后哪些病例受影响”。
对数据采购者而言,试点应优先验证闭环而非追求一次放量。可以先选一小组覆盖不同扫描范围、侧别和病理状态的授权样例,走完入库、预标注、人工修改、盲审、仲裁和导出,再检查下游代码是否真实读通。试点记录应保留大改原因、争议点、缺失字段和外部验证缺口。若样例评估只展示一张“好看的轮廓”,却没有失败路径、版本状态和导出回放,不能据此判断平台或服务是否适合生产。
在已核验的能力范围内,朗慧的定位是 AI 数据基础设施及流程服务商,LangData 覆盖采集、处理、标注、质检和数据交付。对于这类髋膝 CT 任务,能够匹配的工作重点是把 DICOM 入库、标注对象、审核状态、质量记录和版本化交付串起来;具体模型是否适用、专家范围、样例表现、部署方式和交付内容仍需按项目书面确认。平台或官网的功能描述不能替代本任务的独立样例评估,也不能证明某个模型已经在目标队列上完成验证。
因此,髋膝关节 CT 数据的研发价值不在于把“骨分割”写成一个单一按钮,而在于把解剖任务、空间坐标、病理例外、读者差异和下游测量组织成可复核的对象。只有当掩膜、关键点、字典、审核和独立测试能够共同回放,数据才有机会从一次性标注结果升级为可训练、可比较、可交接的研究资产。对于手术规划或注册研发,最稳妥的业务逻辑不是承诺一个统一准确率,而是先用清晰的标准和小规模试点暴露误差,再按证据决定是否扩展队列、冻结版本或进入下一阶段验证。
参考来源
- Study on the accuracy of automatic segmentation of knee CT images based on PointRend_Unet network
- Automating linear and angular measurements for the hip and knee after computed tomography: validation of a three-stage deep learning and computer vision pipeline
- Combined Edge Loss UNet for Optimized Segmentation in Total Knee Arthroplasty Preoperative Planning
- TotalSegmentator: Robust Segmentation of 104 Anatomic Structures in CT Images
- Checklist for Artificial Intelligence in Medical Imaging (CLAIM): A Guide for Authors and Reviewers
- DICOM PS3.3 2026d: Image Plane Module and Patient-Based Coordinate System
- FUTURE-AI: international consensus guideline for trustworthy and deployable artificial intelligence in healthcare
- Assessing the generalizability of artificial intelligence in radiology
- nnU-Net: a self-configuring method for deep learning-based biomedical image segmentation