
MEDICAL DATA RESEARCH
甲状腺超声 AI 数据采购,怎样把“完整动态”变成可验收的病灶证据链
面向医疗 AI 研发与数据采购,拆解甲状腺超声静态与动态数据的病灶级 ID、全帧 Mask、病理证据、专家复核、患者隔离与验收闭环,区分研究建议与公司能力边界。
甲状腺超声 AI 项目最容易被低估的,不是模型选哪一种网络,而是数据采购时到底买到了什么。买方如果只验收“有多少张图、有没有一个框、能不能打开文件”,就很难确认这些数据能否支持多结节检测、逐帧跟踪、病灶级分类和跨设备验证。对超声而言,检查不是一张脱离上下文的截图;它是由采集设备、探头、切面、时间序列、病灶对象和临床证据共同组成的研究对象。
这也是“完整动态”必须被重新定义的原因。完整不只是视频文件仍然存在,还包括原始帧序可核对、病灶出现与离开视野的时间范围可解释、每个可见病灶都能独立关联、不可见帧不被悄悄删除,并且人工标注能够回到对应的原始影像和证据来源。若这些关系没有写进数据结构,后续模型即使在内部切分中得到漂亮的曲线,也可能只是在学习设备、病例来源或标签流程的痕迹。
本文把一份匿名化采购技术规范改写为可复用的方法学讨论。源文件中的项目数量、类别配额、合同语境和具体验收门槛不作为公司现货或项目结果公开;真正需要落地的字段、样本范围、专家角色、授权条件和指标,仍应由项目方在书面规格、数据字典和统计方案中冻结。
先把任务对象拆开:检查、病灶、帧与证据不是同一层
一个可复用的甲状腺超声数据对象,至少要同时承载检查级、影像级、病灶级和证据级信息。检查级需要表达是否存在结节、检查范围是否完整、静态或动态序列是否可用,以及报告或参考资料的可用状态。影像级要保留图像或序列的来源、切面、设备和采集条件。病灶级要回答“这一个结节在哪里、是否为主病灶、在其他图像或随访中是否仍是同一个对象”。证据级则记录良恶性、组织学、侵犯或随访结论究竟依据什么资料、适用于哪个病灶、由哪个版本的规则整理而成。
这四层不能用一个病例标签代替。一个检查可能没有结节,也可能有多个结节;同一患者的不同结节还可能拥有不同的病理或随访结果。如果只保留检查级的“癌阳性”或“癌阴性”,模型训练时就可能把一个恶性结节的标签扩散到同一检查内的其他结节。更稳妥的做法是把“结节存在状态”和“癌存在标签”设为两个独立字段,再为每一条标签记录适用范围:检查级、主病灶级、具体结节,或者无法可靠配对。
公开数据集研究已经说明了证据分层的必要性。Hou 等在 Scientific Data 发布的资源以 842 个病例建立甲状腺超声图像与组织学诊断的关联,并在技术验证中把不同患者批次用于内部测试和独立验证。1 这个研究不是任何新采购项目的现货证明,但它提醒我们,影像表现、报告分级和组织学结果并不是可以随意互换的标签。采购验收时应保留证据类型、日期或合规的相对时间、关联病灶以及证据范围,而不是只留下一个没有来源的二分类结果。
ACR TI-RADS 的价值也在于把超声词汇和风险分层组织成可重复使用的结构,而不是把它当成病理金标准。美国放射学会对 TI-RADS 的说明包含超声词典和基于词典的风险分层目标。2 因此,数据字典应并列保存原始体系和规范化映射。若不同来源使用不同体系,不能在入库时把原始类别覆盖掉;映射规则还应有版本号、适用日期和例外处理。这样,研究团队日后改变任务定义时,仍能回到原始语义重新计算派生标签。
源需求还将病灶级字段拆成多个语义层:良恶性、原始与规范化 TI-RADS、组织学、主病灶位置、甲状腺外侵犯和临床 T。侵犯不宜被压缩成一个未经说明的互斥值,包膜、邻近软组织和血管关系可以作为独立字段,再依据冻结规则生成下游接口所需的派生类别。位置字段也要预先定义左右叶上中下及峡部等允许值。临床 T 或相近的临床显著性字段,如果没有明确医学含义、分期标准、值域和证据范围,只能先保留经脱敏的原始文本,不能由供应方自行猜测规范化值。
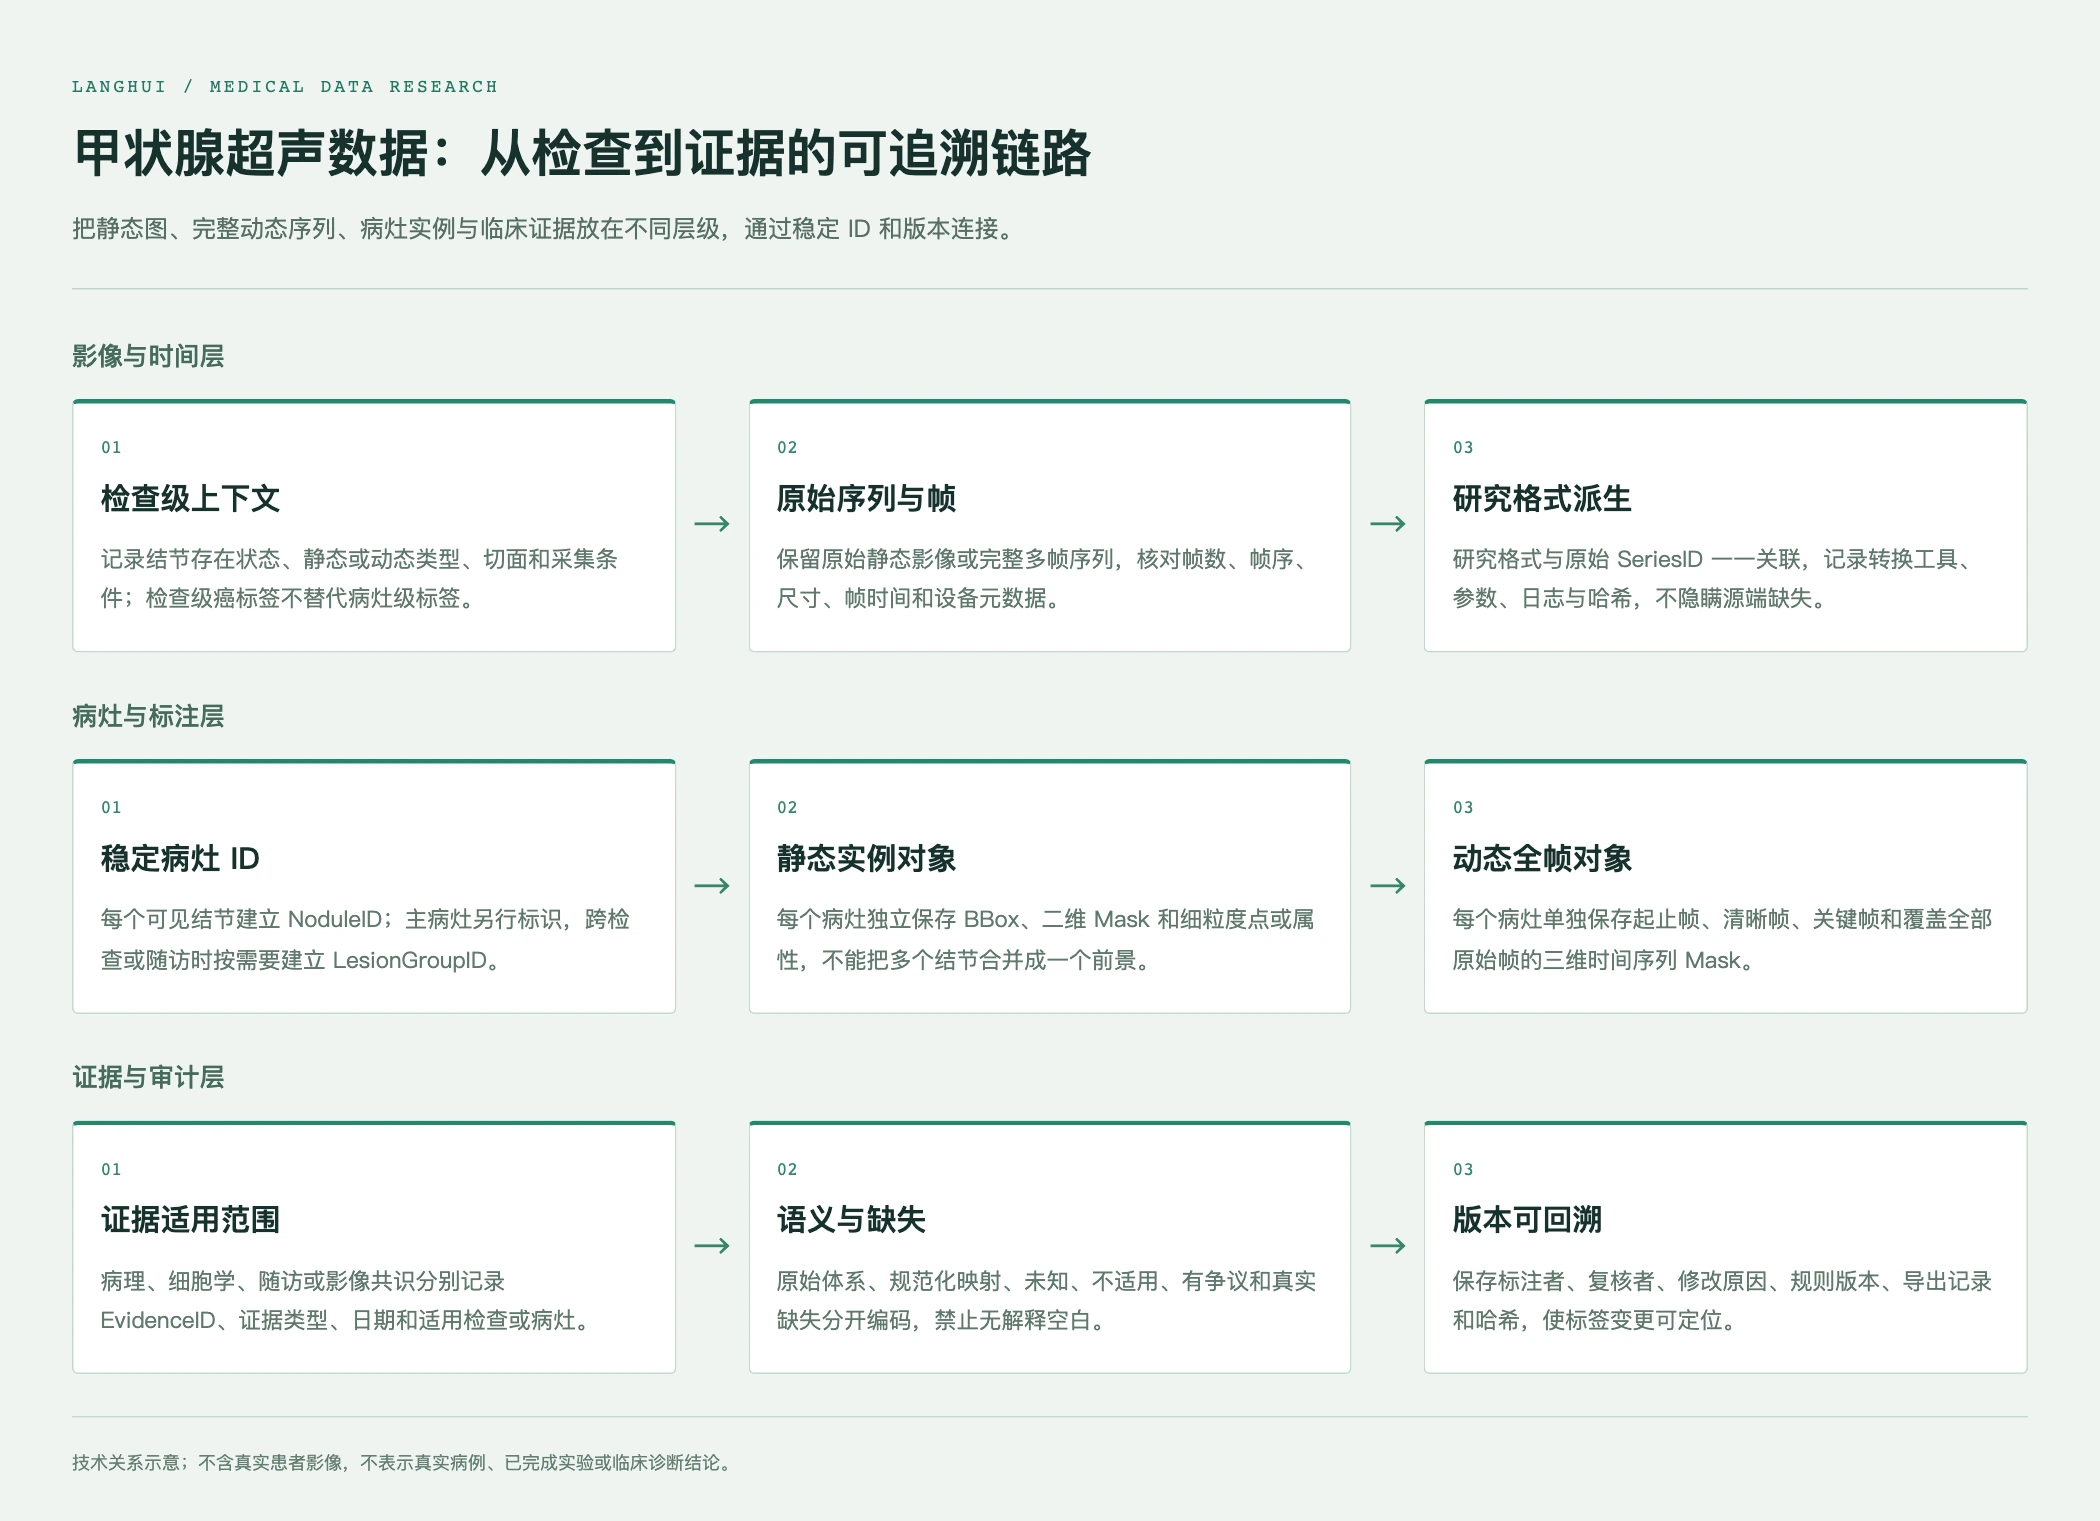
图1 甲状腺超声研究数据的层级与证据链技术示意;不含真实患者影像,不表示任何真实病例、实验结果或临床诊断。
静态标注不能只画主结节,动态标注不能只交最佳帧
如果任务同时服务于检测、分割和病灶分类,静态影像中的每一个实际可见结节都应作为独立实例处理。每个实例需要有稳定的 NoduleID、边界框和二维 Mask,并与图像、切面和临床属性关联。主病灶可以另行标识,但“主病灶”不能成为只标一个结节的理由。多结节病例正是检验数据设计是否健壮的场景:最大结节、最可疑结节和与最终证据对应的结节可能不是同一个对象,选择依据必须留下可复核记录。
微小钙化点、边缘模糊点等细粒度字段也要明确任务边界。它们可以是点标注、属性或困难样本标签,但不能因为在某一帧中难以定位就被默认为不存在。更合适的编码包括“存在但不可可靠定位”“不适用”“未知”和“有争议”。这些状态不会让数据变得不整齐,反而让训练者知道哪些区域不适合被当作确定性金标准。
动态序列比静态图多了一条时间轴。最低限度的数据对象应保留原始完整序列,记录病灶进入视野、可清晰观察和离开视野的范围,并列出清晰帧而不是只挑一两张代表图。关键帧可以用于快速复核和建立基准任务,但不能替代完整帧。对每个病灶单独提交与原始序列同尺寸、同帧数、同顺序的三维二值 Mask,病灶暂时不可见的帧保留同尺寸的空 Mask,并在需要时说明不可见原因。
这里的“三维”是时间序列堆叠后的标注表达,不等于从二维超声扫查直接推断真实解剖体积。原始动态文件仍是追溯主版本,研究格式只是可复现的派生版本。DICOM 标准将超声多帧图像定义为由超声设备创建的多帧影像对象,为保存帧信息和设备上下文提供了正式的对象语义。3 实际项目还应核对帧数、帧时间、图像行列、像素间距或空间标定、设备与探头参数,以及转换前后的哈希和日志。
研究格式的转换要特别说明边界。NIfTI 或其他格式可以便于批处理,但不能在转换时悄悄插帧、调序、裁剪、重采样或改变像素强度语义。转换脚本、依赖版本、参数、轴顺序和日志应与原始 SeriesID 一一关联;如果源设备使用有损编码,“无损转换”只能表示没有再次引入有损处理,不能暗示恢复了源端已经丢失的信息。
最危险的做法,是用自动跟踪或插值生成的轮廓直接充当人工金标准。自动传播可以作为草稿,降低重复操作,但每个受影响帧仍需按照预先冻结的规则人工复核。病灶部分遮挡、散斑增强、边界低对比度或暂时离开视野时,模型和标注者都可能产生看似连续却没有依据的轮廓。验收应把帧错位、跨帧跳变和病灶串联列为独立缺陷,而不是只检查关键帧的视觉效果。
采购的数据设计,要能支撑不同研究任务复用
一份面向算法研发的数据字典,不应只有文件名和坐标。建议把 PatientID、StudyID、SeriesID、FrameID 或 ImageID、NoduleID、AnnotationID 和 EvidenceID 作为不同作用范围的主键候选,并明确外键关系。文件名可以帮助人工浏览,但不能作为病灶与临床信息的唯一配对机制。跨静态图、动态视频、不同切面和随访检查时,如果研究目标要求同一病灶的纵向关联,还需要单独的 LesionGroupID,并记录关联的可信程度和复核状态。
元数据同样属于模型可解释性的一部分。设备厂家与型号、探头类型和频率、成像深度、增益、焦点、动态范围、帧率、检查日期的合规表达和采集切面,都可能成为算法学习到的捷径或偏差来源。源端没有记录的字段应标记为“源端不存在”“去标识化移除”“未采集”“未知”或“交付缺失”,不能用空白把几种完全不同的事实混在一起。原始静态影像、完整动态序列、清洁影像版本和派生研究格式也应通过清单与哈希建立关系。
数据质量还要区分没有病灶、没有该字段、证据不足和资料缺失。可以在数据字典中设置不同状态码,例如确认无病灶、确认不存在、医学上不适用、未知、有争议和本应存在但未提供。若这些状态都被写成“无”,模型就可能把缺少病理误学成良性,把不适用的 TI-RADS 误学成低风险,把未采集的设备字段误学成某类设备。缺失语义看起来是数据工程细节,实际会直接影响偏差分析和模型阈值解释。
公开研究也提示,数据集的“规模大”与“适合外推”并不是同义词。TN5000 研究提供了 5,000 张带专家标注和活检确认的甲状腺结节 B 模式超声图像,采用初步标注、资深放射科医师核验和穿刺或病理依据确定类别的流程。4 该研究还提供了图像级的训练、验证和测试划分。这样的公开基准便于方法比较,却不自动等同于新项目应采用的患者级或中心级评估方案;若同一患者的多张图像跨越训练和测试,模型仍可能接触高度相关的视觉信息。
算法路线必须服从标签层级,不能用一个指标验收所有任务
甲状腺超声数据采购通常同时服务于四类问题:检查级结节存在状态,病灶级检测,静态或动态实例分割,以及病灶级分类或属性建模。它们的输入、输出和误差含义不同。检查级分类可以使用病例或检查作为评估单位;检测要关注漏检、误检和病灶级匹配;分割要定义像素重叠、边界偏差和不可见帧处理;临床属性建模则要说明标签的证据来源与适用范围。把分类准确率、分割 Dice、检测 FROC 或属性一致性混在一个“总体准确率”里,会掩盖最重要的失败模式。
算法路线可以采用由简单到复杂的分层设计。第一步先用规则检查和基线网络确认数据读入、坐标系、Mask 值域和病灶 ID 没有问题。第二步在静态影像上建立检测与分割基线,评估不同大小、回声、钙化和边界状态下的错误。第三步将完整动态序列作为时序输入,比较逐帧独立预测、带记忆的跟踪或时空模型,并专门检查进入与离开视野的过渡帧。第四步再把病灶级影像属性与证据分层结合,避免把病理字段无条件地泄漏到输入或标签中。
近年的分割研究展示了自监督预训练和 Transformer 路线的潜力,但也说明模型表现取决于数据和划分。Xiang 等在 Frontiers in Artificial Intelligence 研究了带掩码自编码器预训练的 Transformer 甲状腺结节分割方法,并在多个公开数据集上与其他架构比较。5 这类结果可以帮助研发团队提出候选路线,却不能被转写为某个新采购集的预期指标。不同研究的样本来源、图像质量、标注方式、患者划分和测试集定义并不相同;研究性能也不等于临床效果。
系统综述和 Meta 分析纳入了 41 项研究,将任务分为分割和检测,并报告了显著的方法学异质性。作者指出,既有研究普遍存在回顾性设计、图像质量不一致、外部验证不足和评价指标不完整等限制。6 这意味着采购阶段就要为外部验证留下数据结构,而不是等内部模型训练完成后再寻找“代表性样本”。分层报告也应覆盖中心、设备、探头、年龄段、性别、病灶大小、多结节和困难样本,避免总体指标掩盖某一来源或某一亚组的明显退化。
训练、调参、内部验证和最终测试至少要按患者隔离。同一患者的所有检查、随访、静态图、动态序列、病灶和衍生文件只能进入一个分区;同时应结合患者标识、检查与序列标识、文件哈希及感知相似度检查近重复。连续入组的独立验证集则应在模型开发和阈值选择之外冻结,尽量保持接近目标场景的病例、中心、设备和检查质量分布,而不是根据已知标签反向回补。验证集的具体规模和统计精度属于项目方的样本量与统计方案,不能由供应方擅自承诺。
专家标注与争议处理:保留分歧,比制造假确定性更重要
甲状腺超声中的专家角色不应只写成“医生审核”。项目启动时应明确初标、独立复核和仲裁各自负责什么,以及是否允许复核者看到前一人的结果。对常规病例可以按预先设定的分层比例进行双人复核,对边界模糊、低质量、多病灶、侵犯属性和标签冲突等高风险场景,应提高复核覆盖。两名专家意见不一致时,要保留双方初始标注、争议类型、依据、仲裁结论和规范版本,不能只留下最终一个值。
复核重点也不能只看 Dice 或 IoU。静态数据要检查漏标、实例合并、边界外溢、尺寸错位和点标注与病灶关联;动态数据还要检查帧序、起止帧、全部清晰帧、不可见帧、跨帧跳变和病灶 ID 是否一致。Dice 或 IoU 可以作为一致性监测工具,但对超声边界不清的病例,它们不能替代医学复核和争议记录。低一致性并不必然说明某一位标注者“做错了”,也可能说明规则本身没有定义清楚。
临床属性更需要证据分层。病理组织学、穿刺或细胞学、稳定随访、报告转录、专家影像共识和未知状态应分别保存。一个病理结果如果只能对应到检查级,而不能可靠配对到某个结节,就不能把它当作该结节的病灶级金标准。甲状腺外侵犯可以分别保存包膜、邻近软组织和血管字段,并保留证据类型与复核状态;若下游接口只能接受单一枚举,也应由版本化规则派生,而不能反过来覆盖多标签事实。对于尚未冻结定义的临床 T,应保留原始语义并暂停自行归一化。
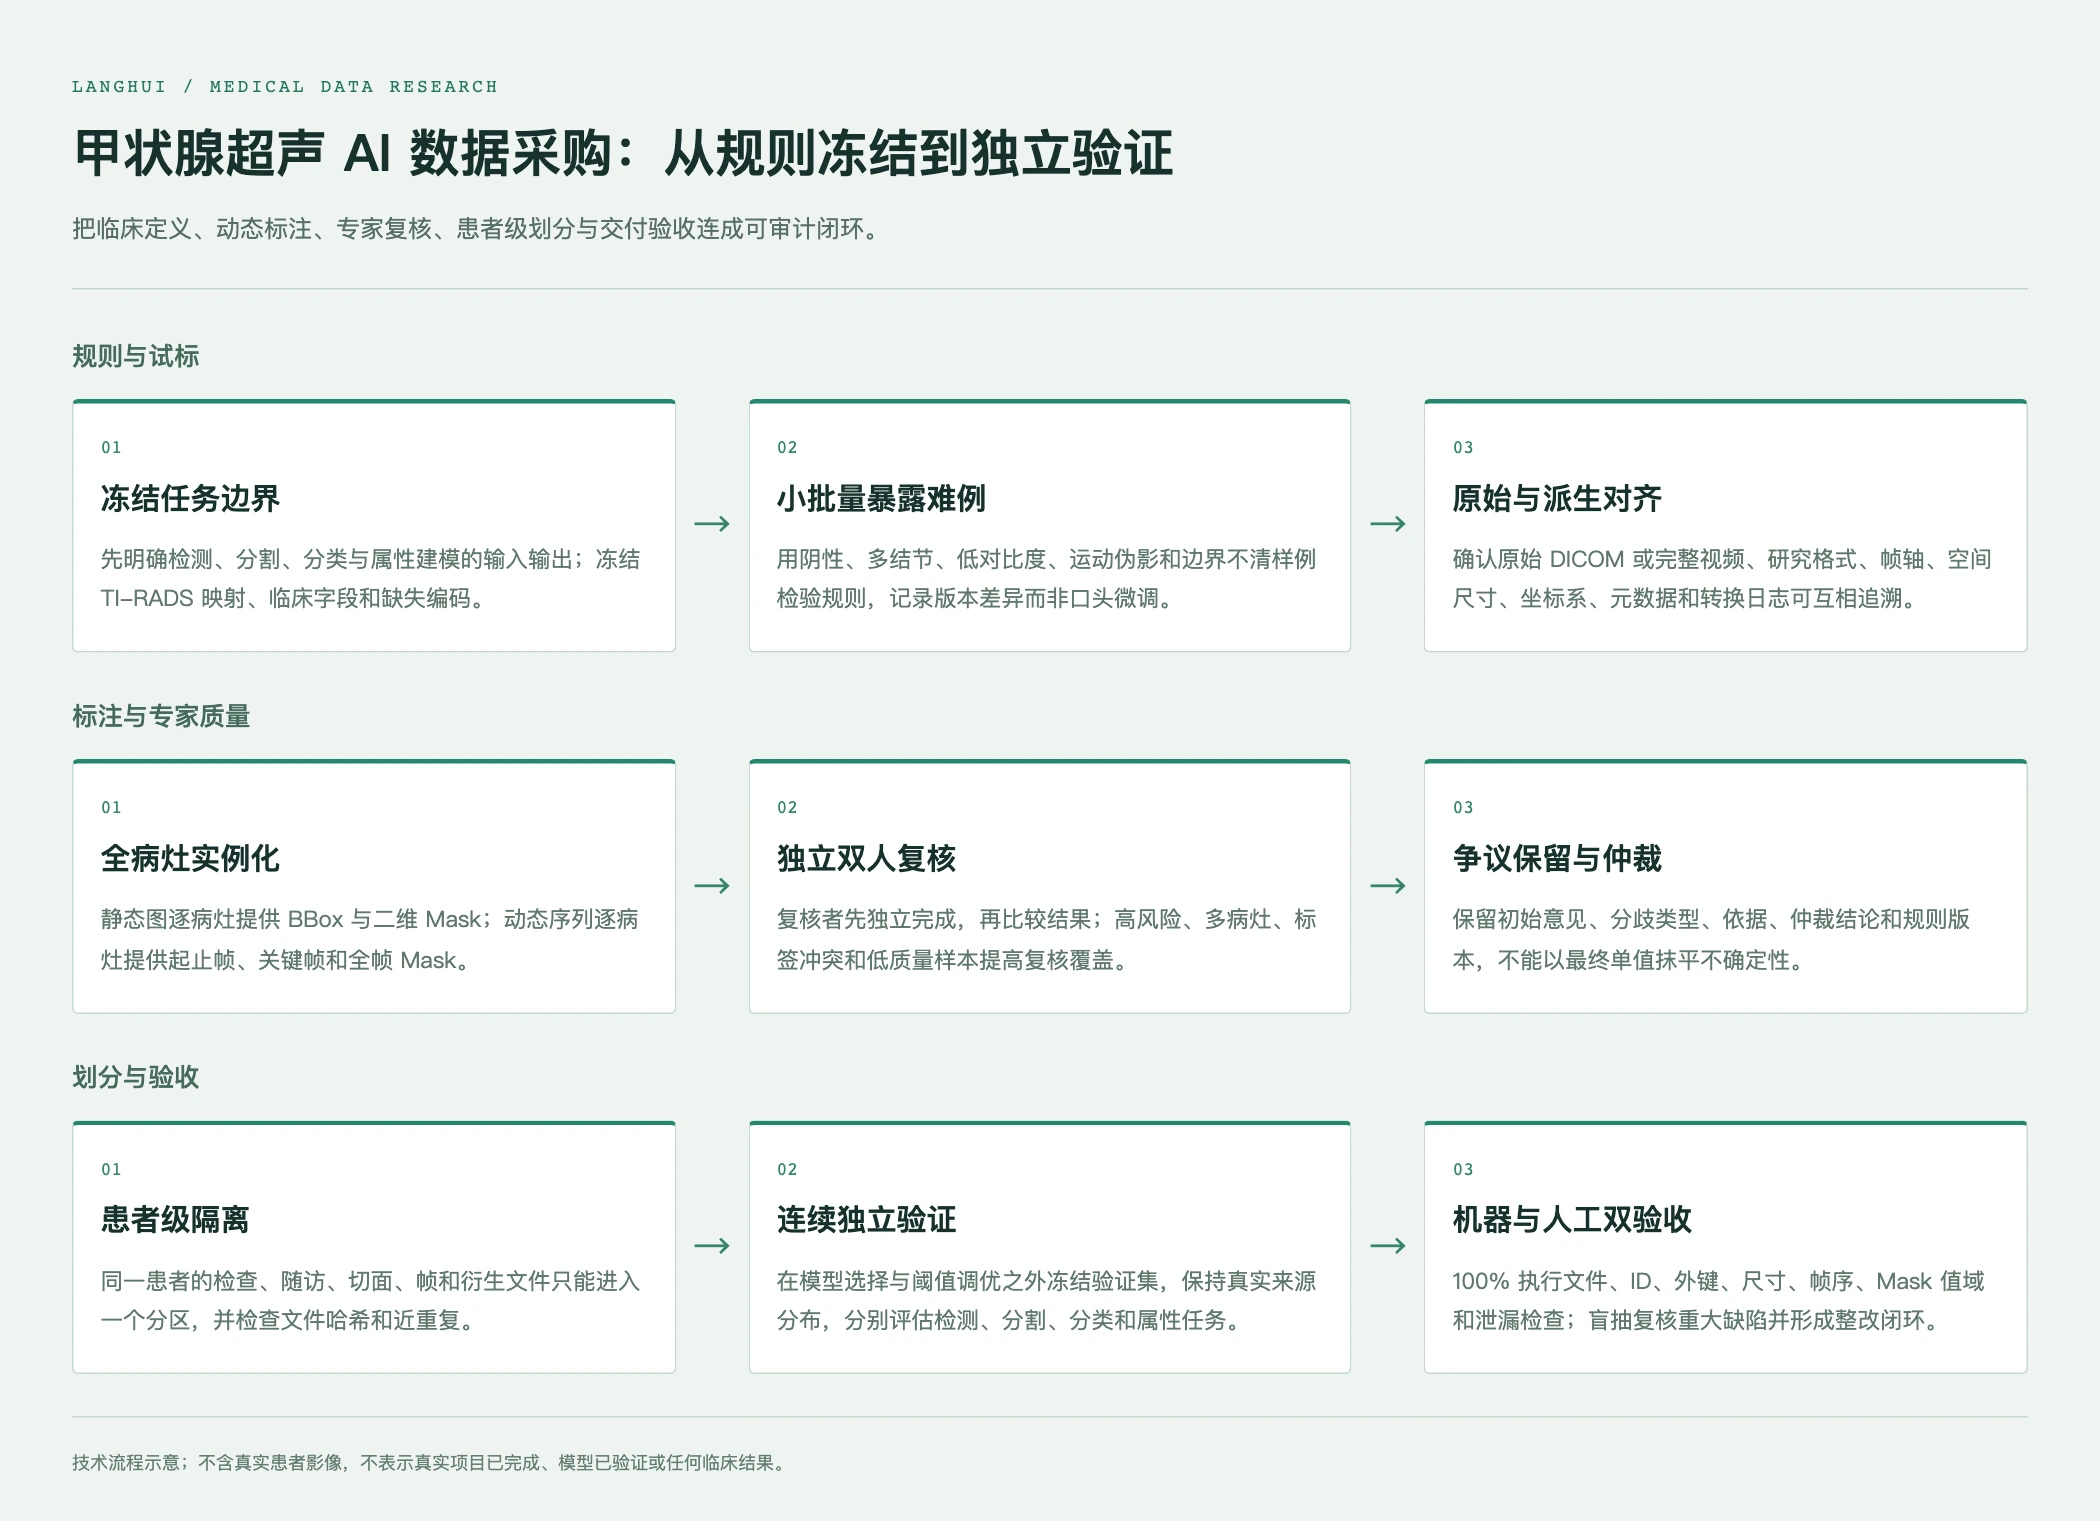
图2 甲状腺超声 AI 数据采购的质量与验收闭环技术示意;关系用于说明研发流程,不代表真实项目已完成、模型已验证或任何临床结果。
把验收写成可执行的研究质量门槛
到货验收的第一道门槛是文件和关系完整性。原始静态影像、完整动态序列、派生研究格式、标注、证据、数据字典、转换脚本、版本记录和哈希应能相互追溯。机器检查可以覆盖文件是否可读、Mask 尺寸是否匹配、动态 Mask 帧数是否一致、值域是否符合约定、起止帧是否在合法范围、外键是否完整、阴性病例是否错误创建病灶实例,以及训练与验证之间是否存在患者或近重复泄漏。自动检查不能证明医学标签正确,但可以先阻断大量可复算的交付错误。
第二道门槛是病灶和证据的医学一致性。阳性检查至少应有可解释的病灶对象,多个病灶不能合并为一个无法区分的前景;主病灶信息必须绑定具体 NoduleID,不能依赖文件名或 ROI 顺序;良恶性和侵犯属性要能回到对应 EvidenceID 或明确的未知状态。没有可靠病理、细胞学或随访依据的影像判断,可以作为开发数据中的单独层,但不应在未说明限制的情况下进入独立验证金标准。
第三道门槛是盲抽与缺陷闭环。盲抽不应只问“图像看起来像不像”,而要按中心、设备、静态或动态、病灶数量和困难标签分层抽取。重大缺陷包括漏标病灶、Mask 明显错位、病灶与证据错配、主病灶错误和动态帧不一致;关键缺陷包括患者串配、隐私泄露、跨分区泄漏、伪造独立病例和原始像素被不可追溯替换。出现阻断缺陷时,相关数据不应计入合格交付量;整改或替换应形成新版本,并以变更记录和前后哈希说明影响范围,不能覆盖原交付物后重新计数。
机器验收与医学验收需要同时成立。文件、ID、外键、尺寸、帧序、Mask 值域、近重复和隐私检查适合形成机器可读报告;病灶边界、主病灶选择、证据适用范围、疑难多结节和属性冲突则需要按冻结规则进行人工复核。最终验收报告应分别说明检测、分割、动态时序、分类和属性字段的适用范围,不能以一个总通过率替代各任务的失败模式。
围绕这类项目,朗慧的公开定位是 AI 数据基础设施及流程服务商,LangData 覆盖采集、处理、标注、质检和数据交付等流程。基于这一定位,项目沟通可以聚焦需求梳理、数据目录、标注规范、质量记录、版本和交付协同;具体模态、专家角色、动态文件处理、数据规模、授权用途和验收阈值,仍需以项目书面确认和合同为准。官网目录或方法学文章不能单独证明某一批数据已现货存在,也不能替代医学资质、伦理授权、数据所有权和临床验证。
本文讨论的是甲状腺超声 AI 研究数据建设、标注治理与采购验收方法,不是医疗建议、临床诊断、筛查意见、风险预测、治疗方案或疗效承诺。公开研究中的数据规模、模型结果和评价指标,只用于说明研究设计与偏差控制,不能外推为任何企业项目的成果。任何实际临床使用都需要独立的外部验证、适用法规与伦理要求、数据脱敏和授权,以及具备相应资质的医务人员结合完整资料作出判断。
参考来源
- An ultrasonography of thyroid nodules dataset with pathological diagnosis annotation for deep learning
- TI-RADS: Thyroid Imaging, Reporting and Data System
- Ultrasound Multi-frame Image Information Object Definition
- TN5000: An Ultrasound Image Dataset for Thyroid Nodule Detection and Classification
- Thyroid nodule segmentation in ultrasound images using transformer models with masked autoencoder pre-training
- Performance Evaluation of Deep Learning for the Detection and Segmentation of Thyroid Nodules: Systematic Review and Meta-Analysis