
MEDICAL DATA RESEARCH
通用医学图片数据如何变成可用的AI训练集:从临床任务拆解到独立验收
面向医疗AI研发与数据采购读者,拆解器械手册、皮肤与口腔病灶、低质量报告、刻度读数和医疗文书OCR七类任务的输入输出、标签颗粒度、隐私治理、专家复核、拒答逻辑与独立验收边界。
医疗大模型面对的“图片”并不是一种数据:设备操作手册中的页面与多视角照片,皮肤病变的确诊图像,模糊或反光的报告照片,口腔与黏膜病灶,试纸和检查影像,带指针或液柱的刻度仪表,以及包含印刷体、手写体和印章的医疗文书,分别对应不同的临床任务。如果把它们放进同一张“图片—标签”表格,只按文件数量验收,模型可能学到设备外观而不是说明书证据,把拍摄缺陷当成疾病特征,或在字符不可辨认时凭上下文补写。真正可用的数据产品,起点不是“收多少张图”,而是先把输入、输出、颗粒度和不确定性写清楚。
一、先按临床任务拆分,而不是按文件扩展名归类
这类数据需求通常同时服务于检索增强生成、视觉问答、病灶定位、质量判断、数值读取和文书结构化。它们的共同输入是图像,输出却不同:有的要求图像与说明书页码对齐,有的要求框出病灶,有的要求模型在看不清时停下,有的要求把刻度几何关系转换为带单位的数值,还有的要求保留原始版式并逐字符转录。因此,数据字典应先以“任务—输入—输出”建立主键,再决定存储格式;Excel、JSON、DICOM或图片文件只是交付容器,不能代替任务定义。
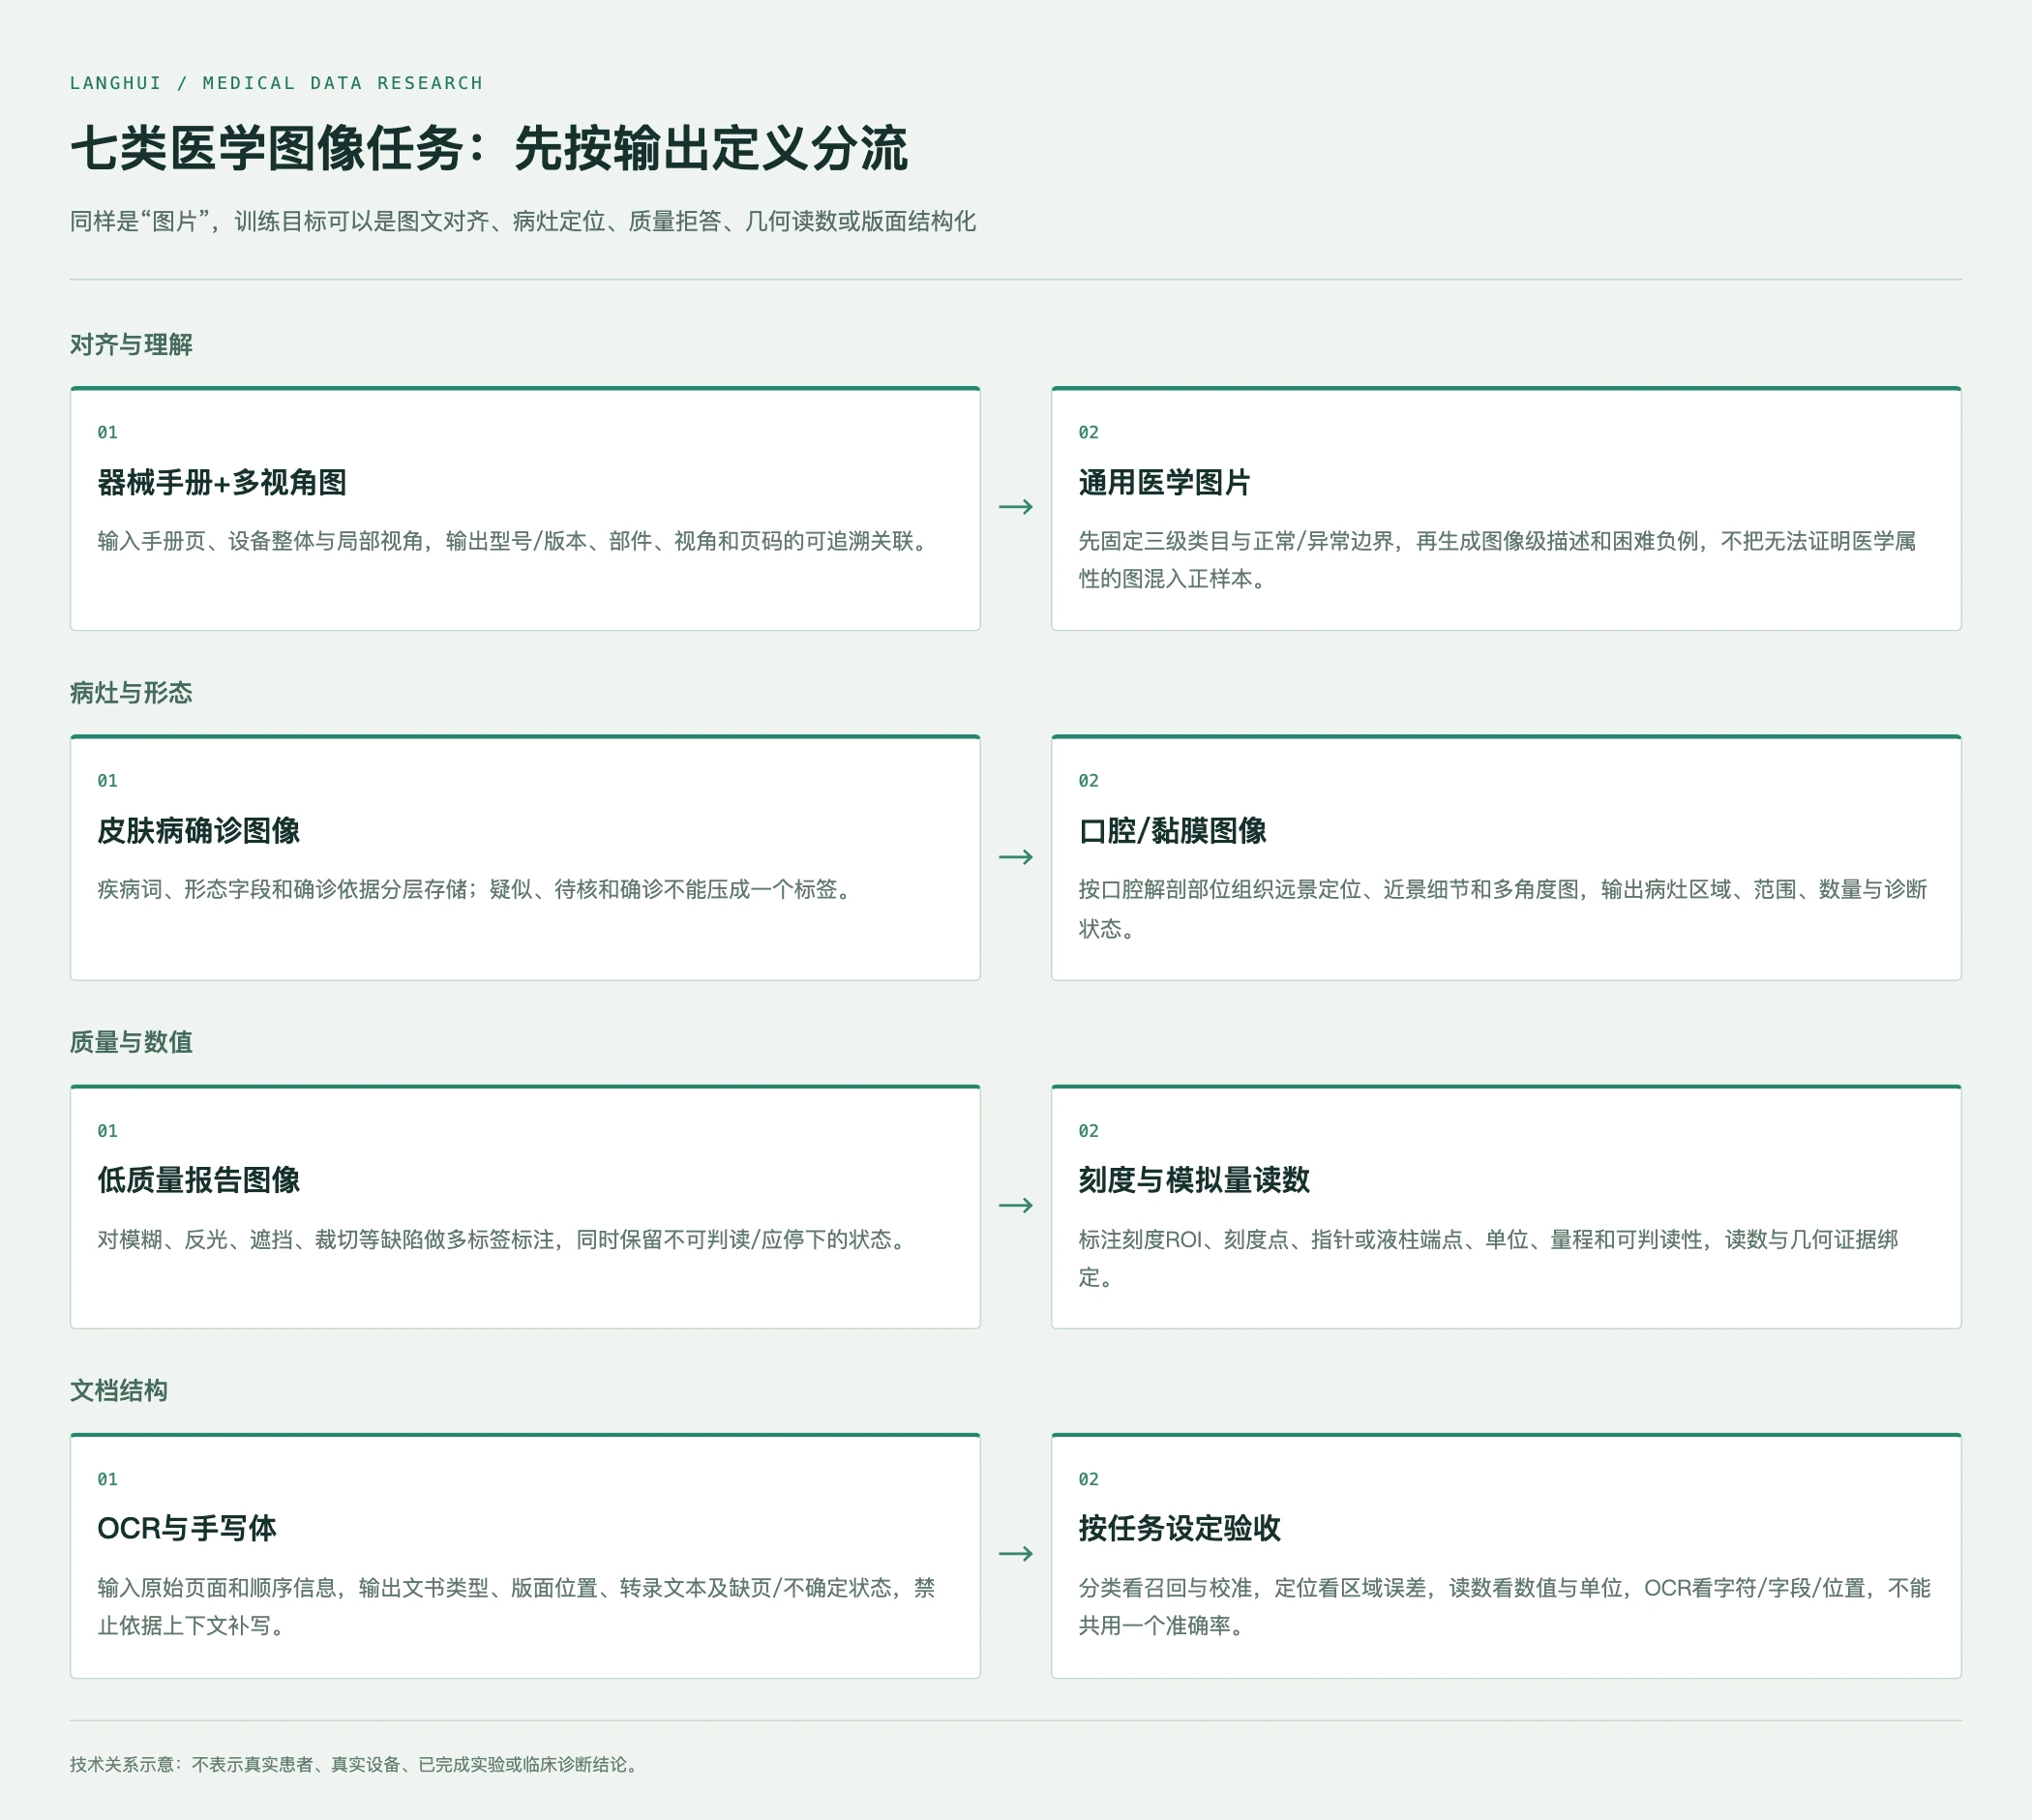
图1|技术示意:七类医学图像任务的输入、输出与标注颗粒度分流;不表示真实患者、真实设备或已完成实验。
医疗器械手册类数据,本质是文档与实物的跨模态对齐问题。一个可复核的记录应把型号或版本作为主记录,把说明书页面、设备整体图、接口、铭牌、屏幕和耗材等视角作为附属对象,并保留视角名称、部件名称和页面锚点。模型训练的目标可以是“根据图片找到对应手册页”,也可以是“从页面和照片回答部件问题”,两者需要不同的正负例。若把不同外观版本混在同一型号下,模型会把外观差异误学成版本事实;若只交照片不交关联表,训练端无法判断一张局部图属于哪个对象。
器械记录还应把注册或备案信息列为可核验字段,保留核验来源、型号、说明书版本和页面锚点之间的关系;这是一项数据治理要求,不是对任何具体品牌、型号、数量或现货的证明。对于原始 PDF、照片和注释表,也要分别记录是否完整、可读、可追溯,避免用一张“有图片”的状态掩盖手册缺页或关键文字不可辨认。
皮肤病图像和口腔病灶图像则是病变识别与定位问题,但两者的解剖部位、成像条件和确认依据都不同。皮肤数据可以包含疾病词、病变部位、颜色、形状、边缘、鳞屑或痂等形态字段,同时把“临床判断、皮肤镜、病理或实验室依据”作为独立字段;疑似、待核与确诊不能被压成一个疾病标签。口腔数据应按牙齿、牙龈、舌、唇和颊黏膜等部位组织,尽量把远景定位、近景细节和多角度图作为同一病灶的关联记录,输出可以包括病灶区域、范围、数量和描述,而不是只保留一个疾病名。近期一项公开的龋病图像数据集采用采集者培训、双人标注和第三位牙医裁决,并对图像质量、文件完整性和标注格式进行了技术核验6;这说明标注者校准和争议留痕比单纯扩大图片数量更关键,但其具体数据规模和一致性结果不应直接转化为其他项目的承诺。
低质量报告图像的目标不是让模型“修复后再猜”,而是训练质量门控与拒答能力。模糊、低分辨率、倾斜透视、反光、阴影、物理遮挡、裁切、过度压缩、远距离和近距离拍摄应当既能单独出现,也能形成复合缺陷;每张图可有多个缺陷标签,并增加实体类型和“可判读/不可判读”状态。真正的线上原图与人工制造的模糊、遮挡或压缩不能混为一谈,因为后者只能测试某种变换,不能代表真实采集链路。验收重点也不应是图像看起来更漂亮,而是模型能否在证据不足时输出不确定、请求重拍或转人工。
刻度与模拟量读数是几何测量任务。字段至少要包括量具类型、量程、单位、起点和读数方向,刻度条或表盘区域、主次刻度坐标及数值、指针或液柱端点、圆形表盘的中心与角度、可判读性及不可判读原因。最终读数要与几何证据绑定,保留“位于哪两个刻度之间、跨过几格、每格代表什么”的解释字段;否则数值即使偶然正确,也无法区分真正读懂刻度与语言模型猜测。超量程、边界读数、反光遮挡和视差样本应保留并明确标识,不能为了提高表面准确率而全部删除。
如果需求同时要求参考范围或“临床意义”,它们应作为来源明确、适用人群和版本可追溯的辅助字段,与图像读数分开验收;一次读数不能被自动改写成疾病判断,也不能在公开稿中变成患者个体建议。对量具的读数真值,还应记录获取方式和复核角色,区分设备显示值、人工几何推导和不可判读状态。
医疗文书OCR和手写体数据的最小单位不是一句话,而是“文书—页面—版面区域—字符或字段”。病历首页、门诊记录、处方、医嘱、验光单等文书需要页面顺序、文书类型、缺页状态、文本框位置和原始图片相互对应;手写体、印章、签名、勾选框和涂改也应有单独类别。转录规则要保留原始大小写、数字、小数点、单位、否定词和行序,无法辨认的字符标为不确定,不能根据上下文猜写。近期一项手写与印刷医疗处方OCR研究以两名标注者独立转录、第三位审核者裁决建立参考文本,并同时报告字符错误率和词错误率5;对于医学文书,还应把关键数字、剂量、单位、否定词和字段位置单独设为高风险检查项,因为总体字符率掩盖不了一个小数点或“无”的错误。
二、数据设计要把“记录”与“关联”同时建起来
七类数据都需要比图片文件更稳定的对象标识。皮肤或口腔任务应以匿名个体或病灶为切分单位,器械任务应以型号和外观版本为单位,文书OCR应以文档或来源模板为单位,刻度读数应以一次采集的仪表实例为单位。原图、增强版、同一病灶的多角度图、同一文书的不同页面和同一设备的多视角图都要建立关系图,而不是依赖文件名猜配对。训练、验证和测试集应在这些主体层级上切分,避免同一患者、同一设备、同一模板或同源图像跨集合造成泄漏。AAPM关于医学影像AI的实践报告特别强调,独立测试集应在模型优化之外保持封存,并具有与预期使用相符的代表性;数据增强也不能被误认为增加了同等数量的独立样本4。
“真实”也需要字段化。采集设备、拍摄角度、光照或偏振方式、图像分辨率、压缩状态、报告模板、文书语言和手写/印刷状态,都会改变模型面对的分布。对于缺陷图像,应记录缺陷来源和严重度;对于刻度图,应区分正常量程、边界、超量程和不可判读;对于口腔或皮肤图像,应记录图像是否为定位图、细节图或多角度配对。没有这些上下文,后续的外部验证只能看到一堆数字,无法解释性能变化来自病种、设备、采集方式还是标签规则。
“正常”“异常”“未知”“不适用”“不可判读”和“未提供”也不能共用一个空值。比如没有看到病灶,不等于检查结果为正常;没有病理依据,不等于病理阴性;字符模糊,不等于原文没有该字符。对模型训练而言,空值语义混乱会把缺失机制学成疾病特征;对验收而言,空值没有定义就无法复判。数据卡应写明每个字段的枚举、单位、缺失含义、来源和是否允许推断,并与每个批次绑定版本号。
隐私治理要贯穿像素、文件属性和关联表。DICOM PS3.15指出,属性去标识不能保证信息对象已经完全去标识,去标识流程还需要结合用途、接收方和再识别风险;同时应处理像素中烧录的姓名、编号、地址或图形文字,并保持相关实例之间必要的一致性2。因此,医学图片的脱敏审计不能只查文件名和表格字段,也要检查页面上的印刷文字、截图边缘、条码、嵌入元数据及跨页面关联。完成去标识也不等于自动获得公开传播或商业训练授权,使用范围、保存期限和再分发边界应单独记录。
三、算法路线应与标签颗粒度对应
通用医学图片不适合用一个“万能分类器”覆盖全部任务。器械手册可以采用文档版面解析、图像编码和检索/视觉问答组合,先解决页面与视角的对齐,再回答部件或步骤问题;皮肤和口腔图像可以把病灶检测、区域分割、形态属性和疾病分类拆成不同任务头,让模型知道“看到了什么”与“如何命名”并非同一层证据;通用医学图片则更适合从类目树、图像描述和困难负例开始,避免把无法确认医学属性的照片当作正例。
低质量报告应先经过质量评估或可判读性门控,再进入OCR、视觉问答或字段抽取。这个门控不一定只输出一个连续分数,还可以输出缺陷多标签、受影响区域和拒答理由。医学图像质量评估研究显示,专家视觉评分存在观察者差异,质量等级缺乏统一尺度也会影响跨研究比较;多读者、多中心、预先定义的等级和一致性记录有助于降低单一观察者偏差8。因此,低质量数据的“合格”不应写成绝对清晰,而应写成缺陷可解释、标签可复核和模型知道何时停止。
刻度读取可以把检测、几何推理和文本输出分层:检测表盘或刻度条,定位刻度点与指针端点,依据单位和读数方向完成数值计算,最后输出读数、有效位数、误差范围和可判读性。对于圆形表盘,角度关系可能比像素距离更稳定;对于线性刻度,非零起点、非均匀刻度和多圈指针需要专门的反例。算法评估既要看读数误差,也要看单位、量程、不可判读判断和解释字段是否一致,不能只看整张图片的分类准确率。
文书OCR则应把版面分析、印刷体识别、手写体识别、表格结构恢复和字段校验拆开。路由器可以先判断文书类型、手写/印刷混排和图像质量,再选择相应识别器;下游规则只做格式和一致性检查,不应把药品词典或语言模型当成补写许可证。字符错误率和词错误率适合衡量转录,但对医学文书还必须报告字段—位置对应、关键数字、单位和否定词的错误;在不能辨认时,正确输出“不确定”有时比生成一个看似完整的句子更安全。
四、专家标注要处理分歧,而不是掩盖分歧
标注工作应从小样本校准开始。每一类任务先准备清晰正例、反例和边界例,说明什么可以标、什么必须标为未知、什么需要升级专家。皮肤与口腔任务的形态描述、疾病词和确诊状态最好分层审核;刻度任务需要能读懂仪表结构和单位的复核者;文书任务需要能够辨识原始字符、版式、符号和否定词的标注者。标注者资质是质量链的一部分,但不等于把所有判断都交给一个人。
独立初标和盲审可以把“真实分歧”暴露出来。对于框、点、分割和版面区域,应定义边界容差或重叠规则;对于类别和文本,应定义一致的枚举、空值与不确定写法。发现分歧时要保留原意见、争议位置、裁决依据、修改前后版本和是否需要回扫同批数据。公开的口腔龋病数据集示例采用标注者校准、双人标注与第三方裁决,并对一部分数据做一致性评估6;这种流程可以作为设计参照,但一致性系数不是脱离任务、样本和标签定义的通用合格线。
确诊状态尤其需要克制。图片上的形态可能支持筛查或候选标签,却不能自动替代病理、皮肤科或口腔专业判断。训练集可以保留“候选”“疑似”“待核”“确诊依据类型”等状态,让模型学习证据等级;公开文章也不应把数据标注流程写成诊断承诺。对买方和数据服务商而言,专家审核的价值不是把所有样本强行归入疾病,而是把证据能支持到哪一级写清楚。
五、质量与外部验证要围绕失败方式设计
合格率不能只有一个总数。器械手册看的是型号—版本—图片—页面关联、视角完整性和关键文字可读性;皮肤和口腔看的是图文配对、病灶区域、解剖部位、确认状态和长尾分布;低质量报告看的是缺陷多标签、真实性、可判读状态和隐私;刻度读数看的是坐标、单位、量程、数值与几何解释;OCR看的是字符、关键数字、字段位置、页面顺序和缺页识别。每项应有抽检样本、分层方式、通过/退回定义和复判角色。
外部验证不是把一批未见过的图片随机留出来就结束。应尽量变化采集设备、光照、模板、场景、人口或疾病谱,并提前冻结测试集,避免依据结果反复改模型。医学数据集文档研究指出,年龄、性别、族群、纳入标准、缺失模式、来源重叠和标注差异都可能形成偏差;完整的数据说明能够帮助使用者判断代表性、复现流程并发现“拼接数据集”带来的虚高表现3。口腔潜在恶性病变的影像研究综述也指出,不同成像协议、样本谱系和标注标准会带来明显异质性,独立来源测试仍然有限7。所以,研发报告应同时给出总体结果和按设备、部位、质量、标签状态分层的错误。
验收样例应尽量覆盖最容易失败的组合,而不是只展示清晰、典型和容易判读的图片。器械类要有相似外观与版本差异;皮肤和口腔类要有困难负例、多病灶、边界不清和证据不足;低质量类要有复合缺陷与真实不可判读;刻度类要有非零起点、边界、反光和超量程;OCR类要有手写、印章、涂改、表格、缺页和关键否定词。只有正例的样例评估,会把生产线的未知部分交给标注者临场猜测。
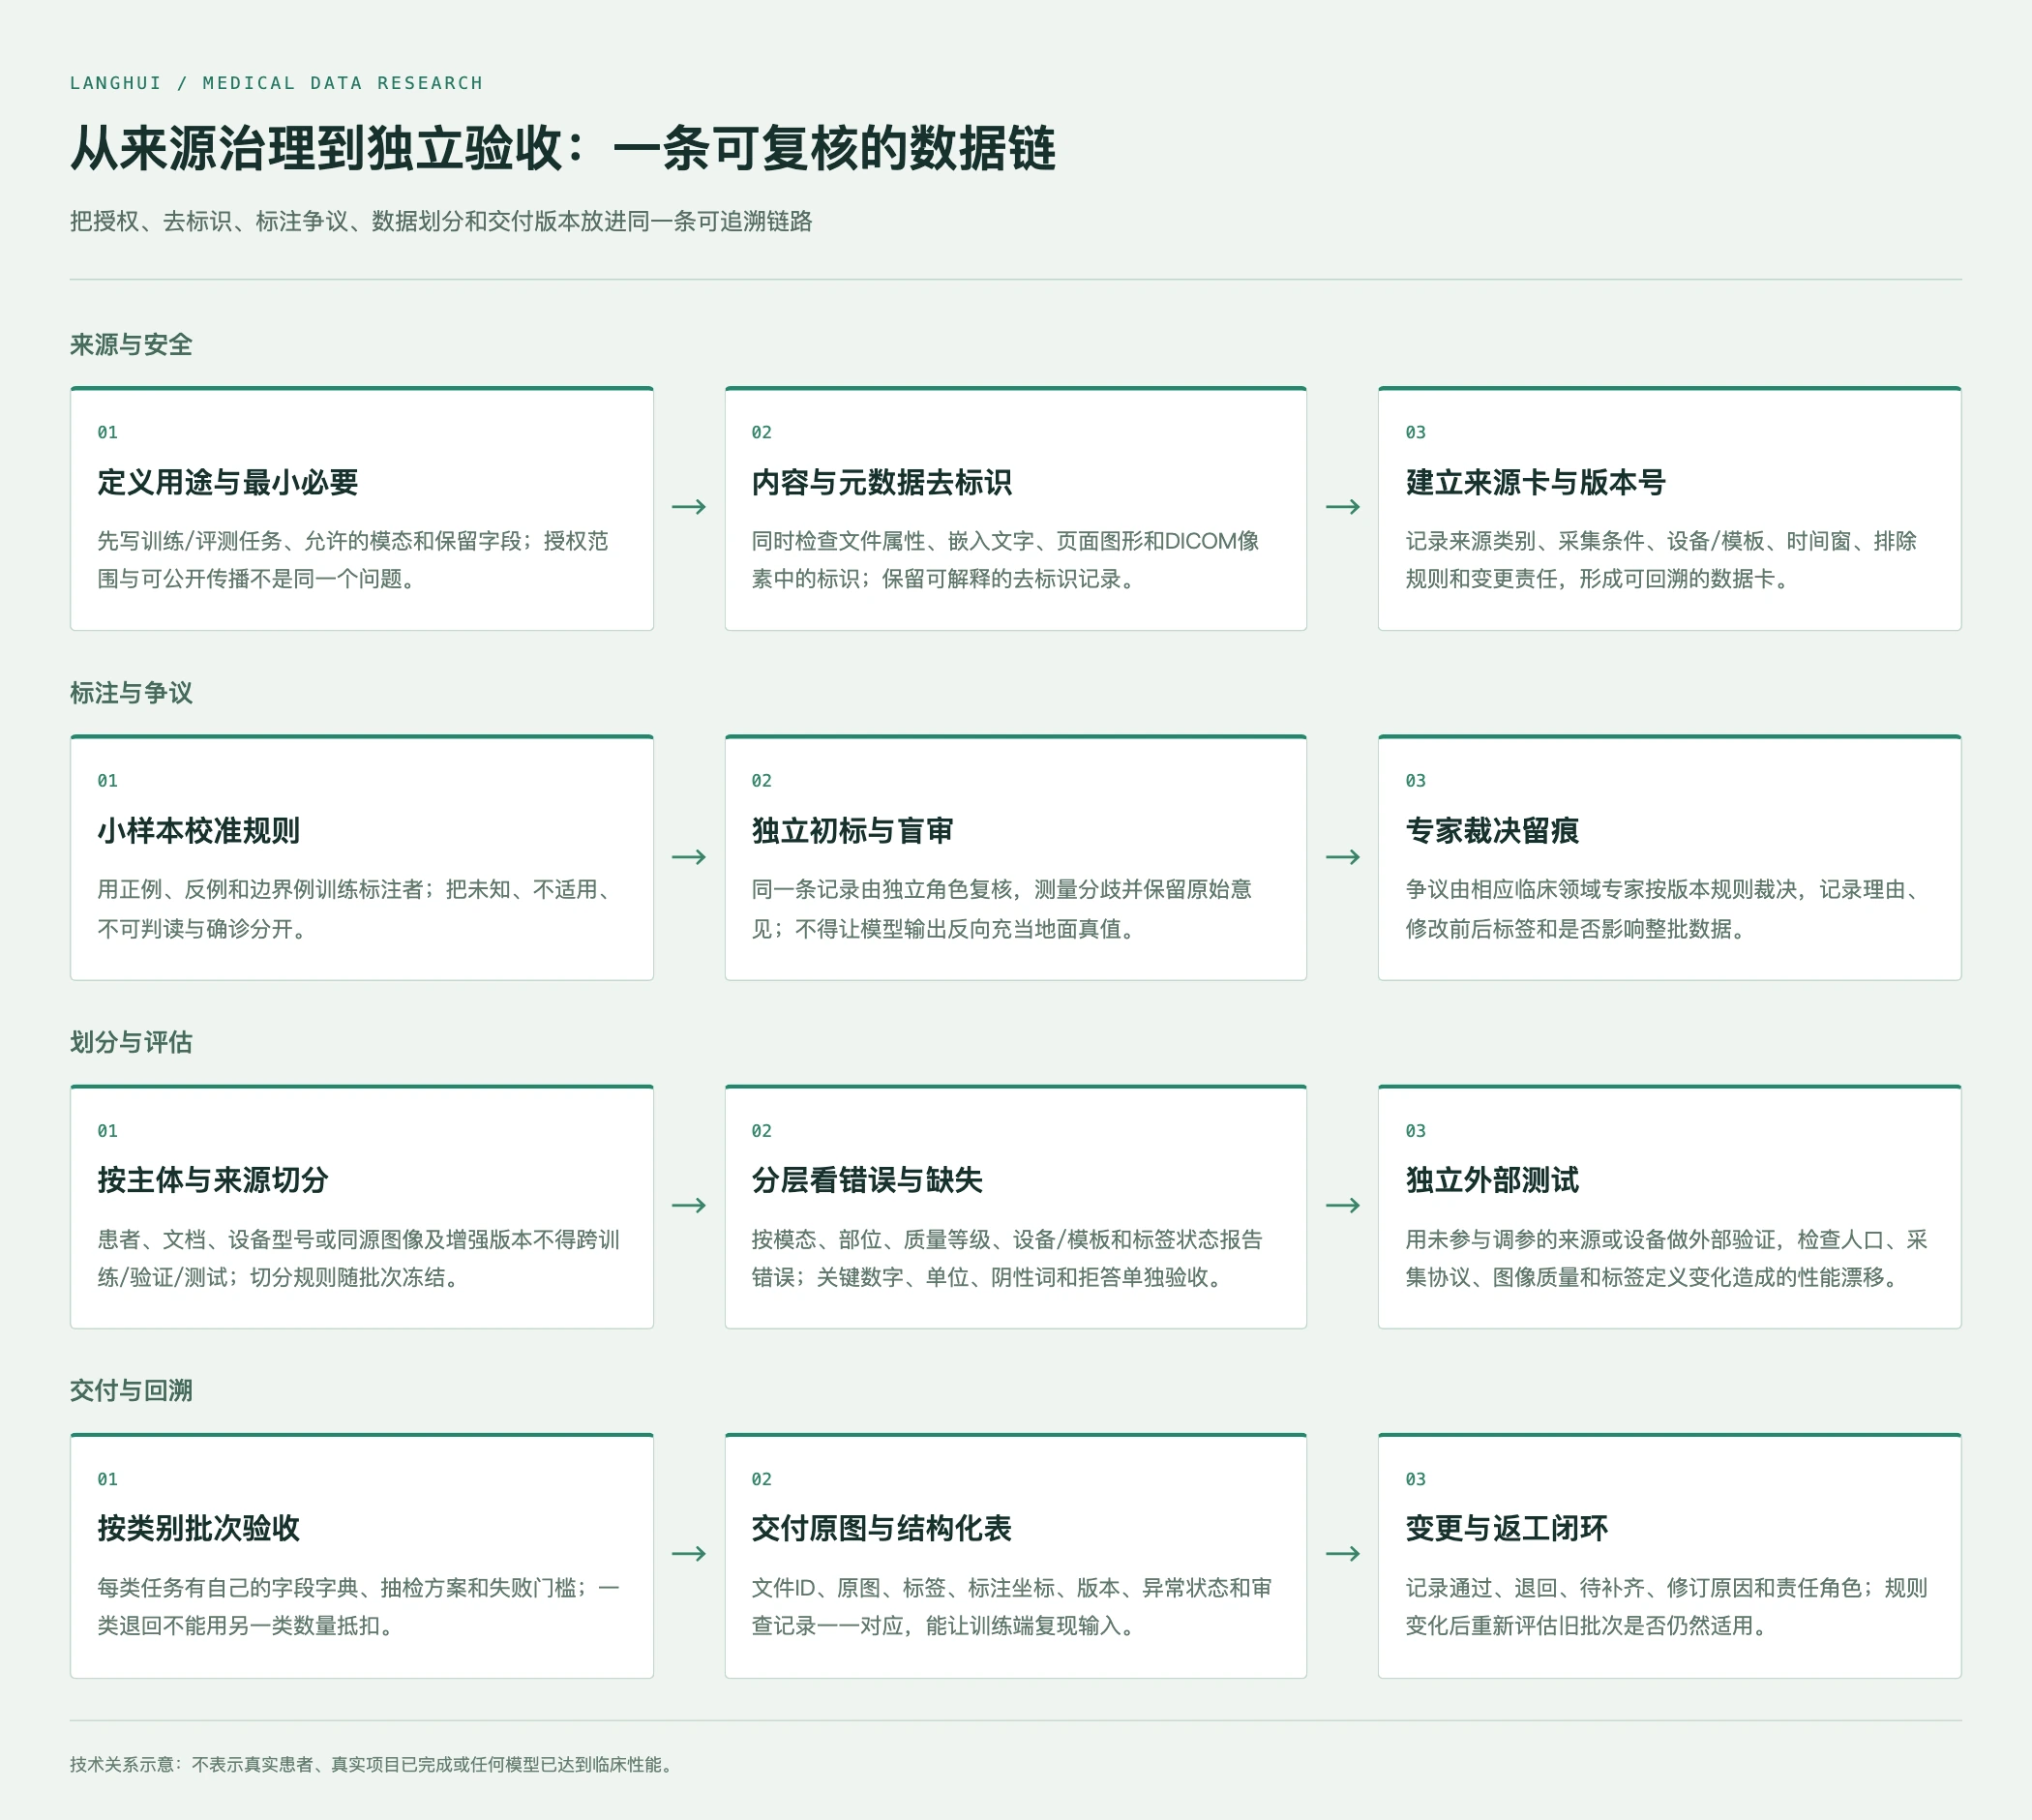
图2|技术示意:来源治理、专家标注、数据切分、外部验证和分批交付的关系;不表示真实项目已完成或任何模型达到临床性能。
六、让验收成为研发与交付之间的共同语言
一个可执行的工作说明,至少要把任务类别、记录单位、字段字典、正反例、反例处理、标注者角色、盲审与裁决、切分规则、隐私检查、抽检方法、失败门槛和版本变更写在一起。每类数据独立验收,不能用通用图片的数量抵扣OCR的关键字符错误,也不能把皮肤病疑似样本算作确诊样本。交付包要能由未参与采集的工程师打开并复现:文件ID、原图、结构化标签、坐标、版本、异常状态和审核记录应一一对应。
源需求中的采购规模、批次合格率、字符或字段阈值、样例数量和交付节点,属于具体项目的书面规格,不能被改写成朗慧的统一服务标准、既有库存或已完成交付。公开稿更适合说明如何把阈值与抽检单位、失败样本和复判路径绑定;实际数值应由买方、数据来源和项目风险共同确认。朗慧公开定位支持围绕规格开展目录匹配、样例评估、采集处理、标注质检和结构化交付,但是否具备某类现货、授权或项目结果,仍需逐项书面确认。
对于研发团队,业务价值不在于把七类数据包装成一张大表,而在于把每类任务的失败方式提前变成可测量的字段。这样,模型选择、标注成本和外部验证才可以围绕同一份数据卡协作:视觉语言模型需要图文证据链,质量门控需要拒答与缺陷标签,几何读数需要测量真值,OCR需要版面和字符真值,所有任务都需要独立测试和可回溯版本。研究效果可以说明某一方法在特定数据和设置下的表现,但不能直接替代项目验收,更不能等同于临床效果或监管批准1。
对于数据服务商,合理的能力表述应是能够围绕项目规格提供目录匹配、样例评估、采集与处理流程、专业标注、质检记录和结构化交付;实际范围、授权、周期和是否具备某类现货,仍需以书面确认和样例评估为准。朗慧科技公开定位是AI数据基础设施及流程服务商,自研LangData覆盖采集、处理、标注、质检和交付环节;这支持其参与数据规格拆解和质量流程设计,但不构成某个具体病例库、设备库或OCR数据量的独立证明,也不替代买方对授权、伦理和临床适用性的核验。
结语:先把“不确定”写进数据,模型才有机会学会负责
通用医学图片采购的难点,不是七类名称够不够多,而是每类输入是否能映射到明确输出,每个标签是否有证据等级,每个空值是否有固定语义,每一张图是否能追溯到来源和版本,每个测试结果是否能在独立数据上复核。当“看不清”“无法确认”“不适用”和“需要专家裁决”都被保留下来,数据集才不仅能训练模型识别,也能训练模型在证据不足时停止推断。对医疗AI研发和数据采购而言,这种可追溯、可争议、可外部验证的结构,才是从图片文件走向可靠训练资产的关键一步。
参考来源
- Good Machine Learning Practice for Medical Device Development: Guiding Principles
- DICOM PS3.15: Attribute Confidentiality Profiles (Normative)
- Assessing the documentation of publicly available medical image and signal datasets and their impact on bias using the BEAMRAD tool
- AAPM task group report 273: recommendations on best practices for AI and machine learning for computer-aided diagnosis in medical imaging
- A hybrid deep learning–based OCR model for handwritten medical prescriptions
- Annotated intraoral image dataset for dental caries detection
- Accuracy of Artificial Intelligence in Detecting Oral Potentially Malignant Disorders and Oral Cancer: A Meta-Analysis of Imaging-Based Studies (2015–2024)
- A Systematic Review of Medical Image Quality Assessment