
MEDICAL DATA RESEARCH
肿瘤影像数据集如何从“有图”变成可复核的多模态研究队列
面向乳腺癌与NSCLC研究,拆解原生DICOM、影像报告、病理与ER/PR/HER2/Ki-67、EGFR的患者级关联、缺失编码、去标识、外部测试与项目验收边界。
开篇:真正难的不是收集几种影像,而是证明它们属于同一次临床证据链
对乳腺癌和NSCLC人工智能研究而言,关键不只是模型,而是:一张影像、一次检查、一个病理结论和一项分子检测,能否在脱敏后指向同一患者和同一时点。若队列只是若干文件夹,算法可能混淆检查时点,把缺失标志物当阴性,或将同一患者拆到训练集和测试集,高分也不能证明任务完成。
因此,肿瘤影像数据集的建设应被理解为一项可审计的数据工程与临床语义工程,而不是影像文件的简单采购。这里讨论一个可匿名复用的双队列需求:一条队列面向病理确诊的乳腺癌,优先治疗前的乳腺X线摄影或数字乳腺断层合成、超声、乳腺MRI以及可获得的PET/CT;另一条队列面向病理确诊的NSCLC,优先治疗前胸部CT和FDG PET/CT。两条队列彼此独立,不把患者跨癌种关联作为隐含前提。每名患者不必拥有全部模态,但每种模态的存在、缺失、检查时点和配套文档都必须如实进入交付记录。
这种需求的核心产物不是一个“多模态”标签,而是由原生DICOM、最终版影像报告、病理报告、指定标志物结果和患者级元数据构成的证据链。DICOM本身既包含像素,也包含检查、序列、设备和工作流关系。DICOM PS3.15明确提醒,属性保密配置不能保证信息对象已经完全去标识;去标识还要考虑像素中烧录的身份文字、图形覆盖、私有属性、UID一致性、上下文和再识别风险。1 因而,面向AI研究的交付必须同时回答“影像能否被算法读入”和“这份影像的临床身份与语义边界是否可核查”两个问题。
一、先把临床任务拆成队列、模态、标签和颗粒度
1. 两个队列,不是一张混合表
乳腺癌队列的入组依据应是病理确诊,而不是单凭影像怀疑。优先时点是基线或治疗前;若纳入手术后、化疗后或其他治疗后的影像,应在检查级字段中明确区分。乳腺影像至少要保留原始DICOM及相关视图或序列,并分别记录2D乳腺X线摄影与DBT,保留左右侧别和投照体位。超声如果存在动态回放帧,不应在入库时被静态截图替代;MRI如包含增强序列,应保留序列类型和造影相关信息。对FDG PET/CT,应区分PET序列与同次检查的CT序列,并在可得时保留示踪剂、摄取时间和SUV相关信息;FAPI PET/CT则不能由FDG字段代替,示踪剂缺失必须显式表示。
NSCLC队列的入组同样以病理确诊为优先,主要影像是治疗前胸部CT以及可得的FDG PET/CT。胸部CT应尽量保留完整检查和全部相关序列,并在元数据中记录层厚、重建序列、扫描设备等会影响复现的参数。PET/CT若存在同次扫描的CT,需记录其是否与PET在同一检查上下文中配对。病理报告至少应支持NSCLC及其亚型字段;EGFR检测结果不是一个可选的装饰字段,而是该队列开展相关预测或分层分析时的关键输入。具体突变或变异类型应按原报告保留到项目定义的粒度,未知、未检测和报告缺失不可全部编码成同一个空值。
上述要求代表不同的数据颗粒度。患者级字段描述队列归属和去标识患者ID;检查级字段描述某次study及其相对时间点;序列级字段描述CT、PET、MRI或乳腺影像的具体series;报告级字段指向某次检查的最终版报告;病理和标志物字段则要保留来源文档、采样或检测时间以及是否经过复核。若所有信息都被压扁到“患者一行”,就无法知道一个标志物究竟对应哪次活检,也无法判断影像是基线还是治疗反应阶段。
2. 不完整模态是现实,不是允许推断的空白
真实队列往往存在部分模态覆盖。部分覆盖本身并不使数据失去研究价值,关键在于把缺失变成可分析的变量,而不是用默认值掩盖缺口。对每位患者,应至少有一张模态可得性矩阵:行是患者或检查,列是乳腺X线/DBT、超声、MRI、FDG PET/CT、FAPI PET/CT、胸部CT、影像报告、病理报告及指定标志物;每个单元格同时记录“已得且通过审核”“未找到”“未做”“不适用”“待核查”或“因质量问题隔离”等状态。
这种状态设计直接影响算法路线。若模型只接受完整多模态输入,训练和评价必须预先规定完整案例的定义,并报告因缺失而被排除的比例;若模型允许模态缺失,则应将缺失模式作为输入设计的一部分,采用掩码、模态专属编码器或分层任务,而不能在测试阶段临时用平均值、同队列其他患者的标签或报告推测缺失结果。NCI Imaging Data Commons将影像、病理图像、标注、测量和临床伴随数据放入以DICOM统一的云基础设施中,其价值正在于让不同对象的关系和元数据可被检索与追溯,而不仅是把像素放在同一个存储桶里。2
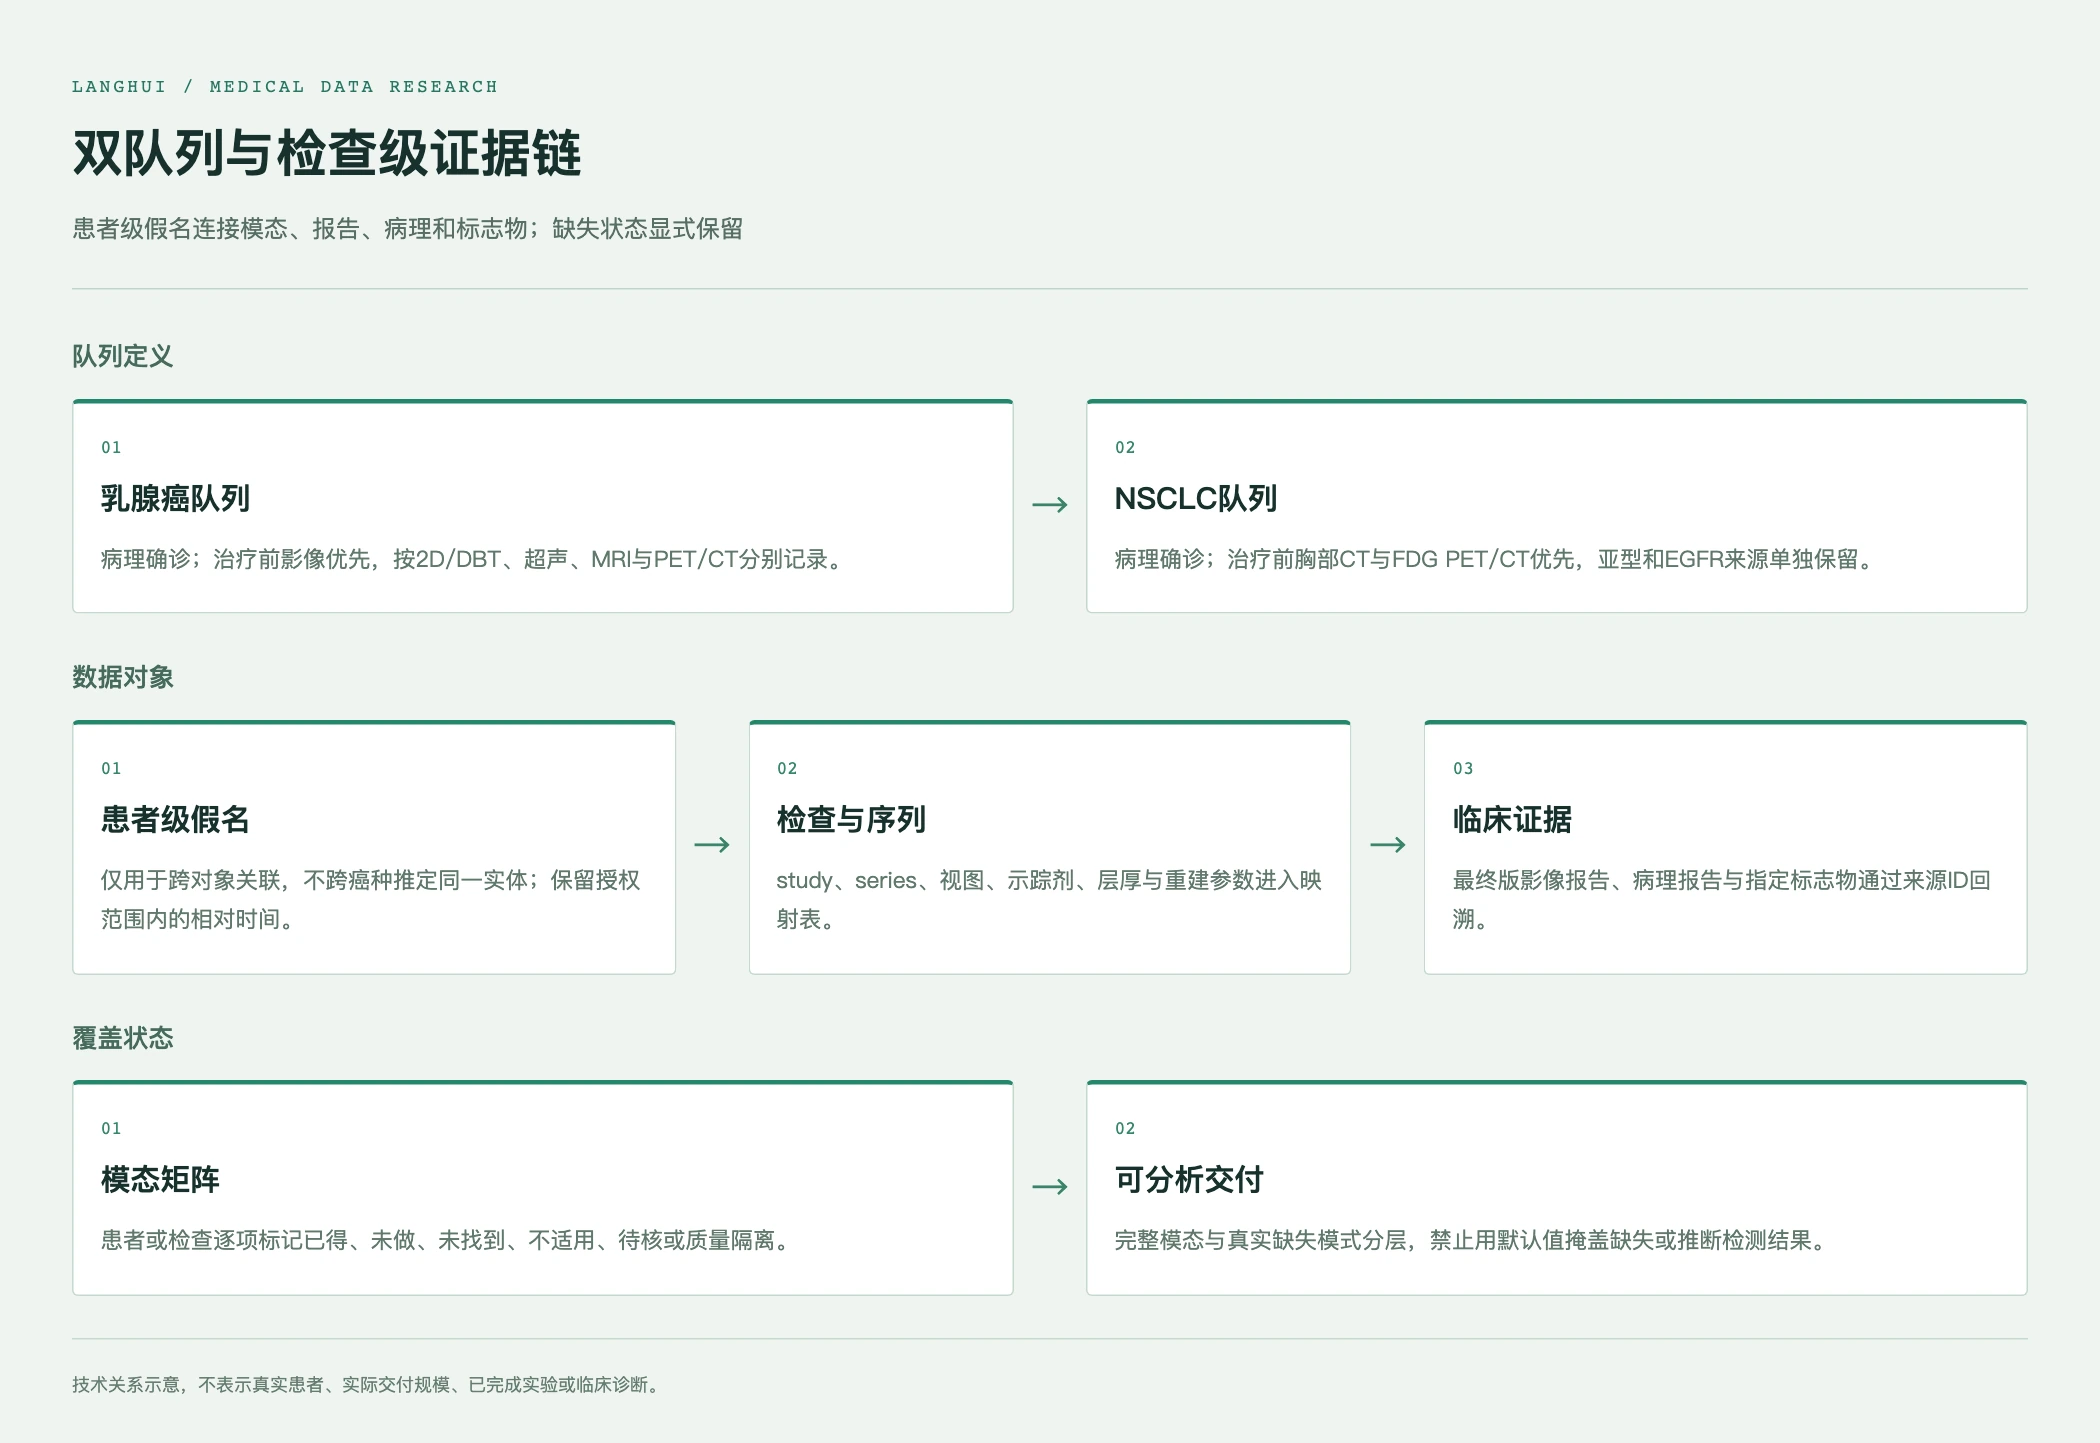
图1 双队列、检查级关联与缺失状态的技术示意;不代表真实患者、实际交付规模或已完成实验。
二、把原生影像、临床记录和标志物连接成可回溯的图
1. 患者ID不是万能主键
去标识患者ID需要贯穿影像、报告、病理与标志物,但它不应承担所有关联责任。一个更稳妥的设计是把患者、检查、序列、文档和样本建成带有约束的关系图:去标识患者ID连接患者级对象;study ID连接一次影像检查;series或序列标识连接同次检查中的具体重建或模态;报告ID指向最终版报告;病理样本ID指向活检或手术病理;检测ID指向ER、PR、HER2、Ki-67或EGFR结果。映射表还应包含来源文件、相对时间点、模态、设备、层厚或序列等可用于复核的字段。
DICOM去标识不能等同于删除姓名和住院号。官方标准要求对需要保护的属性进行删除或替换,并要求相关UID在多实例之间保持内部一致;同时还要处理像素中烧录的识别信息、图形覆盖、私有属性和文件元信息。1 这意味着工程流程至少应有四道检查:字段规则检查、UID和引用一致性检查、像素与覆盖文字检查,以及去标识后与授权用途相匹配的人工或专项复核。日期如果为了保留时间顺序而进行偏移,也必须保留同一患者内部的时间逻辑,并在数据字典中说明规则;不能为了“看起来匿名”而破坏基线、治疗和随访的先后关系。
2. 报告和病理是证据来源,不是自动标签生成器
每一份提交的影像检查应尽量有最终版报告,并与相应DICOM study一一匹配。匹配不应只依赖文件名相似,而要同时核查患者ID、study ID、检查日期或相对时间、部位、模态和报告中可识别的检查描述。报告版本需要冻结,初稿、修订稿和最终版不能在一个字段中混为一谈。
组织病理报告应作为乳腺癌和NSCLC确诊的来源之一,而不是把影像中“疑似恶性”改写成病理阳性。乳腺队列中,ER、PR、HER2和Ki-67需要分开存储,并保留检测是否完成及结果来源;分子分型、淋巴结状态和组织学分级只有在报告载明且授权范围允许时才纳入。NSCLC队列中,亚型与EGFR结果也要与具体病理或分子检测文档关联。若某项未检测,应该标为未检测;若报告不可得,应标为缺失;若结果与患者或检查无法可靠匹配,应隔离待核,不应让脚本自动填成阴性。
这种“来源优先”的做法与CLAIM 2024更新强调的reference standard理念一致:医学AI中的参考标准可能存在不确定性,不能把“ground truth”当成绝对真值;研究应说明标签如何得到、由谁复核、潜在误差和偏差是什么。3 对病理标签尤其如此。病理报告字段、影像报告字段和模型输出应是三套不同的对象。模型的概率不能回写成病理结论,影像征象也不能被升级成分子分型。
三、从采购清单转成可实施的数据设计
1. 交付包应包含文件、映射表和数据卡
可实施的交付不应只是一批DICOM目录。至少需要四类材料协同交付。
第一是原始或原生DICOM对象及其目录清单。清单应记录患者级假名、study ID、series、模态、左右侧别或身体部位、重建序列、文件数量和质量状态,并区分已交付、可得但隔离和缺失。原生文件的保留不意味着后续研究不能重采样或归一化,而是要把预处理从原始层分离,并记录软件、版本、参数和派生文件的来源。
第二是患者级元数据映射表。它应能把一名患者的多个检查、同次检查的多序列、报告、病理和标志物连起来,同时保留相对时间点、基线/治疗前或治疗后状态。该表应禁止把不同癌种队列的患者ID直接当作同一实体,也应在跨中心或跨来源时使用命名空间,防止ID碰撞。
第三是数据字典和缺失代码表。数据字典要说明字段定义、取值范围、单位、来源、允许的空值状态和变更版本。对SUV、层厚、序列名称、检测结果、病理亚型等字段,不能仅依靠自然语言注释;应在机器可读的字典中写出编码规则。缺失代码要区分未做、未找到、不可读、不适用和待核查,避免把不同机制的缺失混在一起。
第四是数据卡和质量报告。数据卡应描述队列定义、模态覆盖、时间窗、授权用途、去标识方法、已知偏差、排除规则和不适用范围。质量报告应给出患者级和检查级的可得性分层,而不是只给一个总例数。公开研究基础设施也采用类似思路:IDC除影像外还管理图像衍生数据、临床数据和可检索的队列清单。2 对采购或项目交付而言,文件清单、覆盖表、缺失报告、抽样核验记录和版本日志同样是数据产品的一部分。
2. 数据划分必须以患者为单位
乳腺和NSCLC影像都可能有同一患者的多次检查、多个序列和多个报告。若按图像、切片或series随机拆分,模型可能通过患者特有的解剖、设备、文本或重复检查模式“记住”个体,形成泄漏。数据划分的最小单位应是去标识患者;若任务关注某次基线检查,其他时点也要遵守患者级隔离。跨模态数据必须同步移动,不能把同一患者的CT放入训练集、PET放入测试集,再将其称为独立评价。
模型输入还应携带采集协议和设备分布。乳腺X线摄影、DBT、MRI、超声和PET/CT的物理含义与参数并不相同;胸部CT的层厚、重建核、剂量和扫描范围也会影响模型。CLAIM要求报告图像采集协议、预处理、去标识、缺失数据和数据子集选择,以便研究可以复现并评估偏差。3 这不是要求每一个项目都收集无限字段,而是要求对会改变输入分布和外推边界的字段进行有意识记录。
四、算法路线:先保证证据对齐,再决定融合方式
1. 乳腺队列的路线应允许模态分支
乳腺队列包含二维投照、DBT、超声、MRI及可能的PET/CT,空间维度和视图/序列并不一致。因此应先做模态内基线,再在可靠配对子集上融合,并单独评价缺失模态的影响。
乳腺X线/DBT需保留视图和侧别,超声动态帧不能随意抽成代表图,MRI要区分序列和增强时点,PET/CT要保留功能与解剖配对。分类、检测、分割和风险预测还需分别定义标签来源与颗粒度,不能用病理确诊替代病灶位置或侧别标签。
部分模态覆盖可采用模态掩码、晚期融合或分层分析,但缺失处理应在训练前冻结,并分别报告完整、单模态和真实缺失模式,避免只评价资料最齐全的人群。
2. NSCLC队列要区分结构、代谢和分子来源
胸部CT提供结构与密度信息,FDG PET/CT则包含代谢信息,但两者的配对必须来自明确的同次或近同期检查关系。若把任意时间相近的CT和PET拼接,治疗、病灶变化和扫描协议差异都可能被误解释为模态互补。输入表应保存PET示踪剂、摄取时间、对应CT是否存在、配准状态和检查时点;任何缺失都应进入掩码或排除逻辑,而不是静默补齐。
NSCLC亚型和EGFR结果来自病理或分子检测,不应由影像预处理阶段生成。算法任务可以是影像表型描述、病理亚型分类、EGFR相关预测或预后分析,但每一种任务都需要独立的终点定义、参考标准和评价集。2026年一项以PET/CT预测肺癌PD-L1状态的研究探索了在部分标注数据下使用半监督与无监督学习;该研究说明标注有限时可以研究标签利用方式,但其研究性能不能直接转译为临床效果,也不能替代对标签来源和外部数据的审计。7
更早的低剂量CT研究曾在大规模筛查队列与独立临床队列上评估肺癌风险模型,显示外部测试是观察分布变化和泛化边界的重要环节。6 该结论对NSCLC数据集的启示不是“照搬某个模型”,而是要在数据层面预留独立中心、设备或时间段的测试条件,并在数据卡中明确哪些患者或检查不能进入训练。若只有单一来源,至少要把内部测试与外部测试的缺失清楚写出,不能把随机留出误称为外部验证。
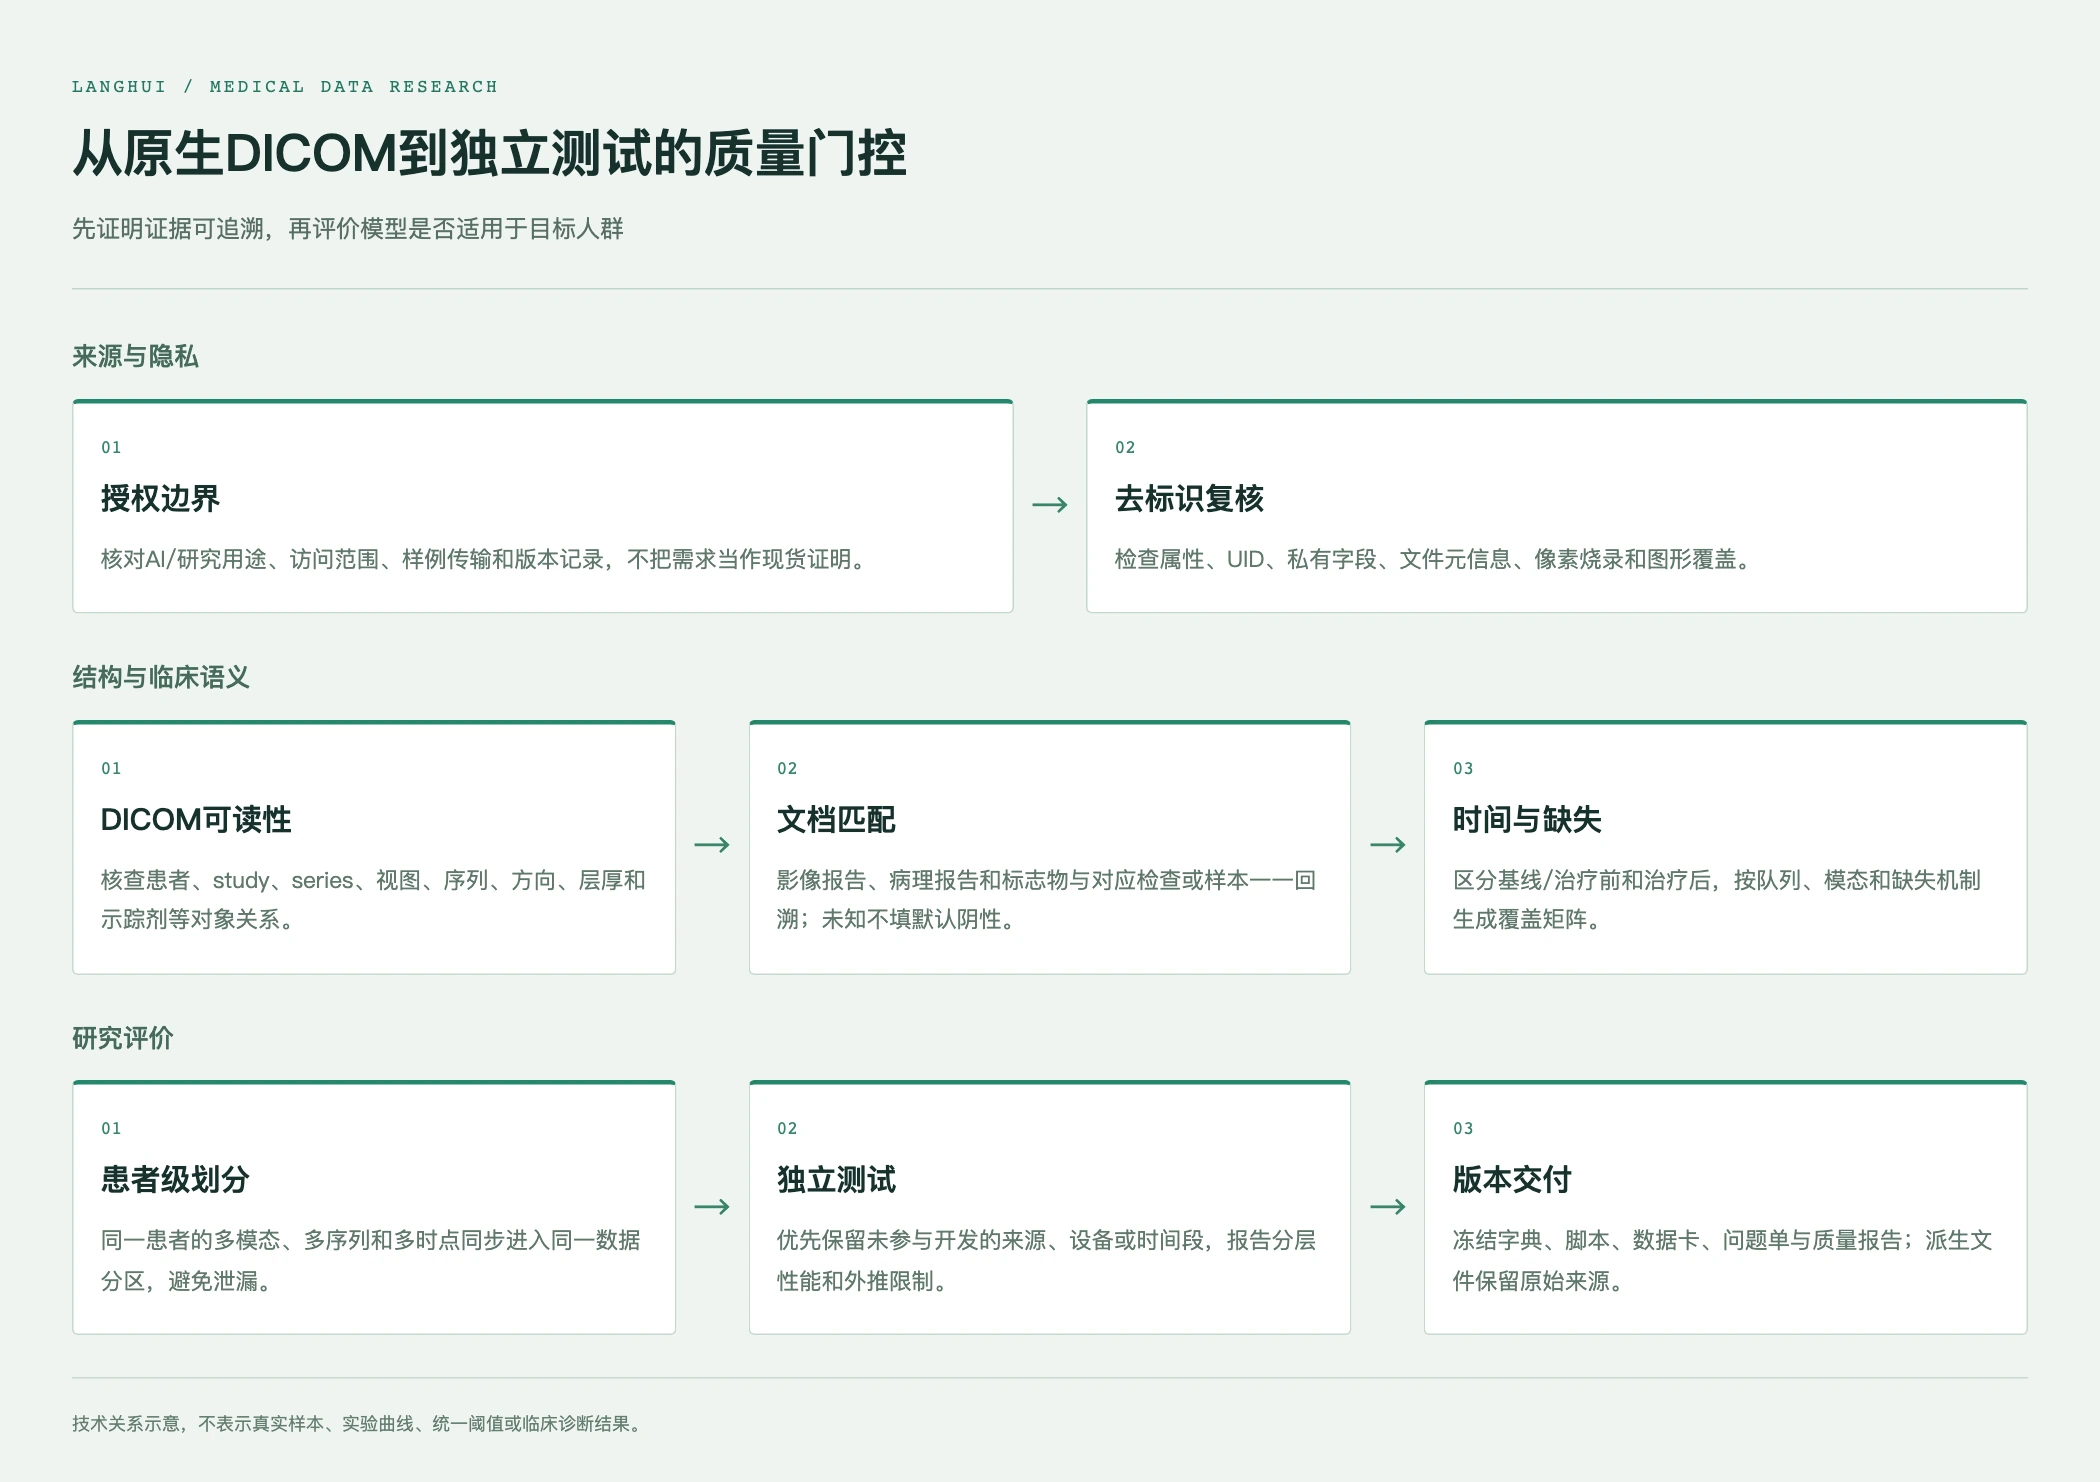
图2 影像与临床证据的质量门控和验收技术示意;不代表真实样本、实验曲线或临床诊断结果。
五、专家标注与质量控制:标注的重点是来源、边界和争议
1. 谁来确认什么,必须在任务书中分层
影像技师、放射科医师、病理专家、分子检测人员和数据质控人员承担的职责不同。影像侧可以确认模态、视图、侧别、序列完整性和报告匹配;放射科专家可对影像任务中的病灶位置、影像征象或检查级标签进行定义和复核;病理专家或授权的病理记录审核者负责核对组织学来源、亚型和分级字段;分子检测字段应追溯到具体检测报告;数据质控人员则负责映射、缺失、版本和文件可读性。不能用一种“专家已审核”标签涵盖所有证据类型。
如果项目需要病灶框、分割掩膜或视图级标签,应建立版本化的标注规范,明确主病灶、可见边界、不可判定区域、阴性样本和多发病灶处理方式。若项目只需要病例级标签,也要规定病理阳性与影像阳性如何区分。专家在看到模型输出后再修改参考标签,可能把模型偏好写回数据,因此用于独立测试的参考标准应尽量在模型输出盲法下确定,并保留争议和仲裁记录。
2. 质量不应压缩成一个“准确率”
质量控制至少应分成来源完整性、结构完整性、关联正确性、临床语义、影像可读性和隐私风险几个层面。来源完整性检查授权用途和文件链条;结构完整性检查DICOM能否被标准工具读取、序列是否缺失或重复;关联正确性检查患者、study、series、报告、病理和检测是否一一对应;临床语义检查基线/治疗前状态、病理确诊和缺失代码;影像可读性检查方向、像素、层厚、动态帧或增强序列;隐私检查则覆盖字段、UID、私有属性、像素烧录和附带文档。
抽样复核应按患者和检查两种粒度进行。一个患者可能同时拥有多种模态,随机抽一张切片不能证明整条证据链正确;一个study也可能含多个series,检查级清单不能替代序列级核查。对于缺失和隔离对象,质量报告要保留原因分布,不能只汇报“通过率”。若项目约定了阈值,应把阈值写入版本化验收表;若没有统一阈值,就应将“建议的验收指标”和“项目书面确认值”分开,避免把研发建议误写成公司固定标准。
CLAIM 2024还建议在研究报告中清楚说明数据来源、入排标准、预处理、缺失数据、采集协议、参考标准以及内部和外部测试数据集,并强调“外部测试”比含义不清的“验证”更明确。3 TRIPOD+AI则把临床预测模型的训练数据、评价数据、结局、校准、区分度、偏倚和公平性纳入统一报告框架,同时提醒评价数据不能与训练、调参或模型选择所用患者重叠。4 对数据采购而言,这些指南可以转化为交付字段和验收记录,而不是等模型训练完成后才补方法学。
3. 外部验证要看人群、设备和缺失模式
乳腺影像AI在不同人群和临床场景的表现可能变化。一个多中心外部测试研究使用独立且更具多样性的美国筛查人群评估乳腺X线模型,发现模型在新队列的表现低于原开发和既往外部队列,并观察到乳腺密度、既往乳腺癌史及族群分布等因素与性能差异相关。5 这提示数据集建设不能只追求阳性病例数量,还要描述年龄、性别、设备、密度、既往治疗史和检查场景等与目标用途有关的分布;缺失项也要纳入分层分析。
NSCLC队列同样需要区分筛查人群、已确诊人群、术前人群和治疗中人群。将筛查CT的标签直接用于病理确诊NSCLC并不自动成立;将治疗前FDG PET/CT与治疗后结局拼接也可能引入时间泄漏。外部测试应优先在未参与开发的数据来源、设备或时间窗口上进行,并按癌种队列、模态覆盖和关键标志物完整性报告。若样本量不足以支持某一亚组,不应通过合并不同临床语境来凑出稳定数字,而应将该亚组标记为证据不足。
六、面向研发与采购的验收框架
1. 先验收可追溯性,再验收模型可用性
第一道验收是文件可读性:原生DICOM能否被约定工具打开,患者、study、series、文件层级是否一致,全部相关视图和序列是否在清单中。第二道验收是关联性:随机抽取患者,检查影像、最终版报告、病理报告和标志物能否通过映射表互相回溯;对不能匹配的对象,系统是否保留隔离状态而不是自动归档。第三道验收是时间与语义:基线/治疗前和治疗后是否分开,报告版本是否明确,乳腺侧别、DBT与2D、PET示踪剂、CT层厚、EGFR变异等字段是否按字典编码。第四道验收是缺失与覆盖:按队列和模态列出实际覆盖,区分未做、不可得、待核和质量隔离。
第五道验收是去标识:抽查DICOM属性、UID引用、私有字段、文件元信息和像素烧录文字,并检查去标识策略是否与授权用途相匹配。第六道验收是可复现交接:将一个脱敏样例导入下游工具,确认方向、体素间距、序列名称、报告和标志物表能够被正确读取;记录软件版本、规范版本、校验脚本和问题单。第七道验收才是算法评价:明确患者级划分、独立测试集、缺失处理、参考标准、指标和置信区间。没有前六道验收,最后一张AUC图无法证明数据集适用于研发。
2. 评价指标要匹配任务,不制造临床承诺
如果任务是病例级分类,可以报告AUROC、AUPRC、敏感度、特异度、校准和分层结果;如果任务是检测,应报告病灶级定位规则、自由响应或FROC等适用指标;如果任务是分割,应说明参考轮廓、空间分辨率、Dice或边界指标的计算方式;如果任务是标志物预测,应把预测结果与真实检测报告分开,并报告不同缺失模式下的结果。准确率不能替代所有指标,也不能因某一指标改善就宣称已经具备诊断、治疗或监管用途。
研究论文中的性能是特定数据、参考标准、设备、时间窗和评价口径下的研究结果。它不等于临床效果,更不等于医疗器械获批。对于预印本或最新研究,应明确其同行评审状态;对于已经发表的研究,也要同时保留适用样本和外推限制。TRIPOD+AI强调透明报告是为了让读者判断模型是否适合特定场景,而不是为模型贴上“已验证”的永久标签。4
七、公司能力适配与项目边界
在已核验的公开能力范围内,朗慧科技定位为AI数据基础设施及流程服务商,自研LangData覆盖采集、处理、标注、质检和数据交付,并以项目规格、样例、数据卡、质量记录和版本为基础组织工作。对于本文所讨论的肿瘤影像需求,这种能力适配应理解为:在项目书面确认后,可围绕目标队列梳理数据字典、设计样例评估、定义映射关系、组织质量门控和交付版本;医疗目录页面可用于按部位、模态和任务进一步沟通,但不能由目录或网站自述推断某一具体队列已经现货、具备固定病例量,或已经完成独立临床验证。
实际项目仍需逐项确认:数据来源和授权是否允许约定的AI/研究用途;乳腺与NSCLC的样本边界、模态优先级和缺失处理;原生DICOM与派生文件的交付范围;报告、病理和标志物是否能够匹配;去标识规则、样例传输和访问边界;质量指标、抽样方法、返修轮次和版本冻结方式。公司能力、客户需求和建议研发路线三者必须分开写。一个合理的试点应先用经批准的脱敏样例走通导入、映射、缺失标记、质量报告和下游读取,再决定是否扩大范围。
这种设计让研发团队明确模型接收的影像、检查、标签和缺失机制,也让采购与临床合作方获得覆盖矩阵、限制清单和版本化验收。最终形成的不是“所有模态齐全”的宣传样本,而是能说明证据来源、缺失边界、质量风险和适用范围的研究基础设施。
肿瘤影像数据集的可复用标准,不是文件数量或单次分数,而是能否回答影像来自哪次检查、标签来自哪份报告、模态为何缺失,以及结果能否复核。理清患者—检查—序列—报告—病理—标志物关系,分层保存原始与派生数据,并用独立测试检验外推边界,才能让乳腺癌与NSCLC研究可解释、可复现、可验收。
参考来源
- DICOM PS3.15 2026d — Attribute Confidentiality Profiles (Normative)
- Imaging Data Commons — National Cancer Institute
- Checklist for Artificial Intelligence in Medical Imaging (CLAIM): 2024 Update
- TRIPOD+AI statement: updated guidance for reporting clinical prediction models that use regression or machine learning methods
- Validation of a Model for Automated Mammography Interpretation by a Diverse, Multicohort, Multicenter Population
- End-to-end lung cancer screening with three-dimensional deep learning on low-dose chest computed tomography
- Multimodal PET/CT-based PD-L1 status prediction in lung cancer via semi-supervised and unsupervised deep learning