
MEDICAL DATA RESEARCH
妊娠期糖尿病纵向数据建模:从病历字段到可验证母婴结局
从妊娠实例主键、孕周时间轴和OGTT证据链出发,拆解孕期用药、血糖管理、母婴结局标签、专家复核、防泄漏与外部验证,面向医疗AI研发和数据采购说明可追溯交付边界。
同一例妊娠的糖代谢信息,往往散落在入院记录、产科系统、检验结果、用药医嘱、超声报告和分娩记录中。研究者真正面对的问题不是“能否再增加一些字段”,而是:怎样把这些不同来源、不同时间粒度、不同书写习惯的数据,组织成一条不会跨妊娠串联、不会把未来信息泄漏到预测时点、也能被临床专家逐项复核的纵向证据链?对妊娠期糖尿病(GDM)及母婴结局研究而言,数据字典的设计本身就是研究设计的一部分。
这类数据建设不应被理解为把病历复制到一张更宽的表格,而应被理解为一次“临床事件建模”:先定义一次妊娠、一次就诊、一次检验和一个结局之间的关系,再决定每个变量在什么时间点有效、由什么证据支持、缺失时如何表达,以及最终交付给算法的到底是预测输入、诊断标签还是结局标签。下面以可匿名复用的技术问题为主线,拆解GDM纵向数据集的结构、清洗、标注、建模和验收逻辑。本文只讨论科研数据与AI研发,不构成个体诊疗建议。
一、先把临床问题写成可验收的任务
GDM数据项目常见的任务至少有三类。第一类是早期风险预测:在孕前或孕早期可获得的信息基础上,预测后续是否满足研究预先规定的GDM诊断标准。第二类是过程与管理研究:围绕OGTT、饮食和运动管理、口服降糖药或胰岛素治疗的时间顺序,分析血糖控制与妊娠结局的关联。第三类是结局预测或分层:利用母体特征、实验室检查、治疗过程和超声测量,预测早产、妊娠期高血压疾病、产后出血、巨大儿、低出生体重、胎儿生长受限或新生儿并发症等结局。
三类任务的输入窗口和标签定义不同,不能用一张“全字段表”来代替。早期风险预测必须冻结预测时点,只允许使用该时点以前已经可用的信息;管理研究需要保留连续的治疗和血糖事件;结局预测则要区分真正的基线变量、治疗后变量和可能位于因果路径上的中间变量。若研究目标没有先写清,清洗人员很容易把分娩后才产生的诊断、最终用药方案或完整住院经过误放进早孕预测模型。
因此,项目启动时至少要形成一页任务说明:研究对象是“妊娠实例”还是“患者”;预测时点按孕周、首次产检、OGTT前还是入院时定义;输出是二分类、连续值、时间到事件还是描述性统计;标签来源是检验规则、医生判定、出院诊断还是多来源仲裁;哪些字段是必需字段,哪些字段允许缺失,哪些字段只有在时间信息可靠时才进入分析。对同一字段,还要标记它属于输入、标签、结局、协变量还是仅用于质量核查。
若项目同时包含GDM与对照,队列入口还要记录纳入与排除依据、既往糖尿病排除状态以及无法判定或证据冲突的样本;没有找到诊断文本不能直接当作对照。这样才能避免把来源缺失、未检查和真正阴性混在一起,也便于后续按标签版本复核队列构成。
妊娠实例应作为纵向数据的第一层主键。一个人可能有多次妊娠,每次妊娠又会产生多次门诊、住院、检验和影像记录。仅以患者键连接所有记录,容易把上一次妊娠的GDM史、分娩方式或实验室结果带入下一次妊娠;仅以就诊键连接,又会丢失跨就诊的治疗与结局关系。更稳妥的模型是“研究妊娠键—就诊/事件键—检验或观察值键”,同时保留来源系统、原始时间、标准时间、时间精度和处理状态。
二、把孕周和事件顺序当作核心数据类型
孕周不是一个可在最后一步补填的普通字段。末次月经日期、超声估孕、检查日期、分娩日期和入院日期的记录质量可能不同,且各来源的时间精度也不同。建议同时保存原始日期、推导的孕周、推导方法、可用的时间范围和不确定原因。例如,能够由可靠日期计算出的孕周可以进入“可用于时间窗口”的状态;只有月份或相对描述的记录,应保留为低精度信息,不宜伪装成精确孕周。
按孕早期、孕中期和孕晚期组织实验室数据时,“每个阶段最早的一次”并不等于“任意找到一个数”。必须先规定观察窗口的左右边界、同一检查的多项结果如何成组、部分缺失时是否允许从下一次检查补充,以及补充后的记录如何留下血缘。若某次血常规缺少一个分量,直接用后一次结果拼接,会制造一个在真实时间上不存在的“合成检查”;更合理的做法是保留检查级完整性、允许变量级缺失,并将替代规则作为显式版本记录。
源规范示例将孕早期、孕中期和孕晚期分别写成不晚于13周+6天、14周至27周+6天、28周及以后;这里是项目数据窗口的版本化约定,不应脱离研究方案被当作适用于所有场景的诊疗阈值。边界日、孕周推导方法和无可靠日期时的处理状态,都应随数据包交付。
OGTT是GDM标签和糖代谢过程的关键时间锚点。字段设计不应只保留一个“OGTT结果”,而应分别保存空腹、1小时和2小时结果、单位、采样时间、检查孕周、判定标准版本和结果来源。不同研究或地区可能采用不同筛查和诊断路径;即使同一队列在不同年份使用了不同流程,也不能在清洗时无提示地合并。ADA《2025年糖尿病诊疗标准》的妊娠章节将孕前评估、既往GDM史与后续妊娠的血糖筛查置于连续照护框架中,但项目仍须在研究方案中固定具体诊断标准与阈值。5
治疗信息需要用事件思维表达,而不是单一的“是否用药”。药物变量至少可拆为药物类别、通用名、给药方式、频率、剂量描述、首次使用时间、首次使用孕期、停用或调整时间以及治疗时的血糖状态。饮食控制、运动控制和定期血糖监测同样需要有明确时间范围。二甲双胍或胰岛素使用前后的血糖不能混成一个均值,否则模型会无法区分疾病严重程度、治疗反应和治疗选择本身。药物名称归一化还要保留原始文本和映射版本,避免把不同制剂、不同给药途径或不同治疗目的误合并。
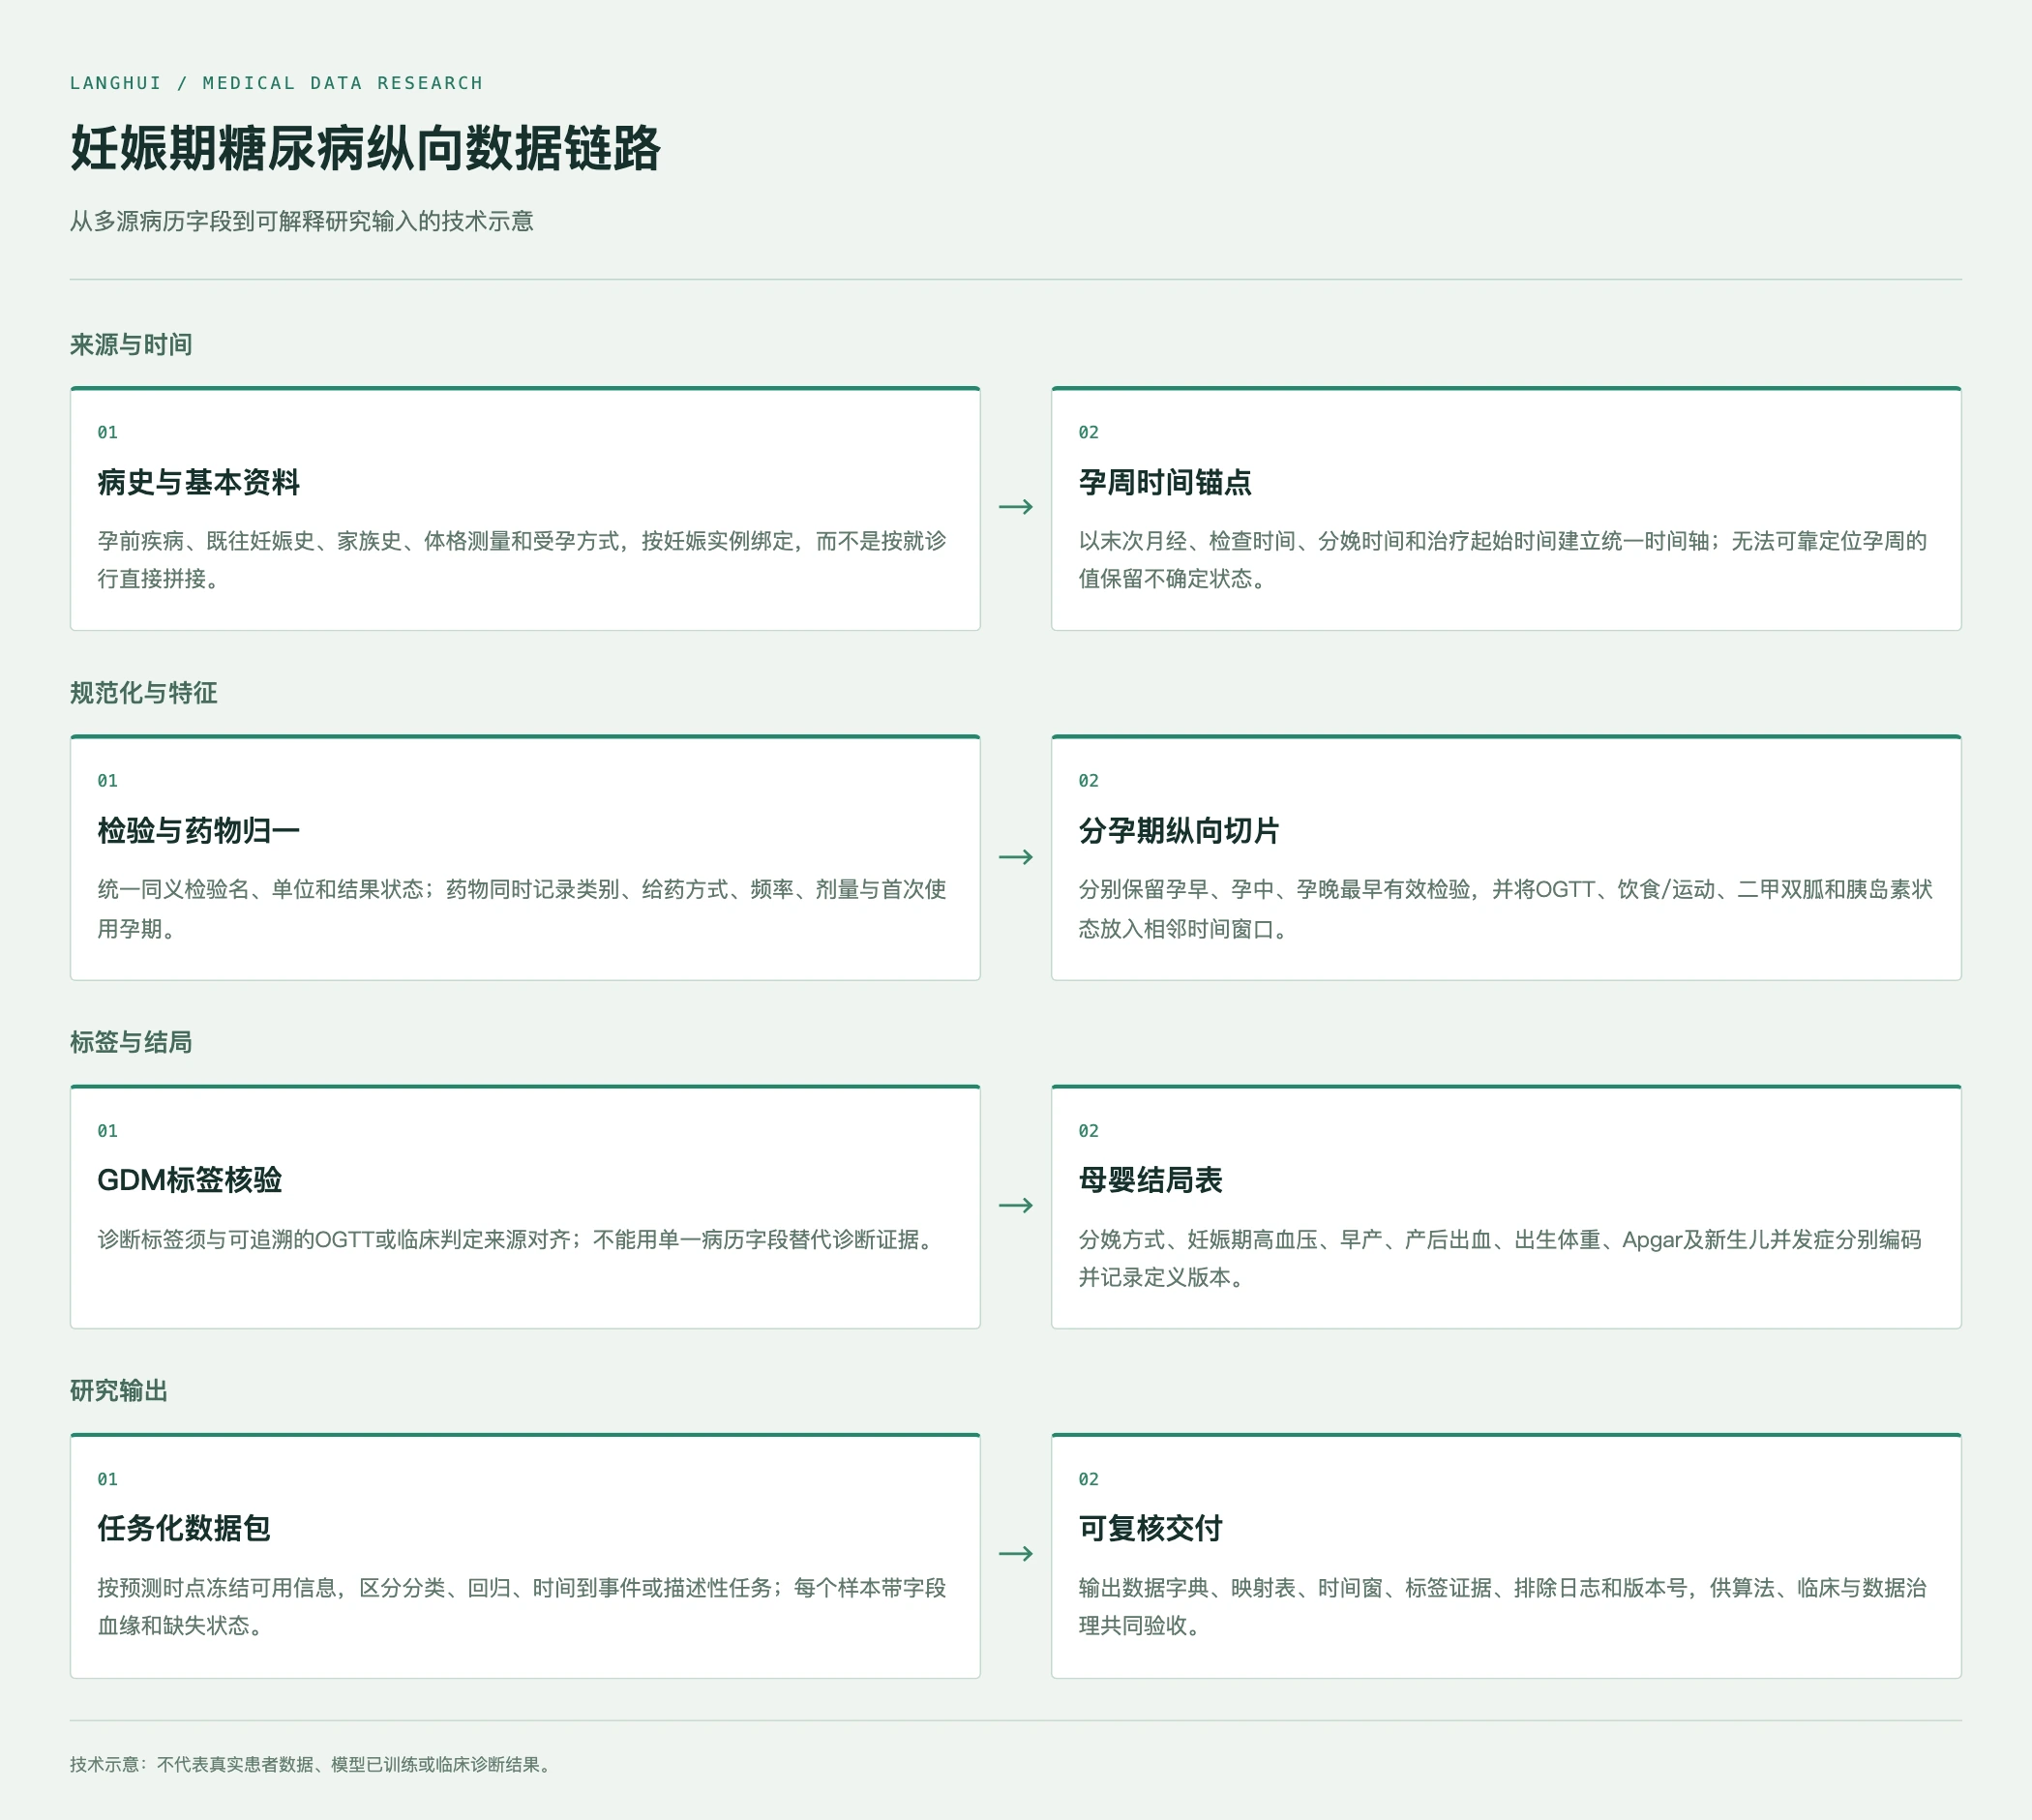
图1 妊娠期糖尿病纵向数据链路技术示意:按妊娠实例绑定来源,建立孕周时间轴,归一化检验与用药,再分别形成诊断标签、母婴结局和任务化研究输出;不代表真实患者数据、模型已训练或临床诊断结果。
三、从字段清洗走向可追溯的标签体系
临床文本中的同义词、缩写、否定表达和主语变化,是产科数据结构化的主要难点。比如“既往妊娠期糖尿病”与“本次妊娠糖尿病”在研究含义上不同;“男方有某病史”不能归入孕妇既往史;“无手术史”与“有无手术史”也不是同一语义。清洗规则应同时记录实体、时间、主体、断言状态和来源片段的定位信息。对否定、未提及、未知和无法判断,至少要设置彼此不同的编码,不能把“没有证据”直接写成“否”。
病史字段可以按“孕前母体风险—既往妊娠—本次现病史—孕期治疗—分娩与新生儿结局”组织。孕前风险包括年龄、体重或BMI、既往代谢手术、PCOS、慢性高血压、甲状腺疾病、肾脏疾病、贫血或血红蛋白病、乙肝携带状态以及一级亲属糖尿病史等。既往妊娠应将GDM、妊娠期高血压、子痫前期、早产、肩难产、巨大儿、流产或死胎等分别编码;“曾经有过不良妊娠”不能替代这些具体标签,因为不同结局对研究问题的意义不同。
本次妊娠的结局也应拆成多个可验证字段。分娩方式、孕次、产次和剖宫产次数需要明确是否计入本次妊娠;妊娠期高血压疾病与子痫前期应有相互关系清楚的层级;胎膜早破、早产、引产、肩难产和产后出血要同时保存事件状态与必要的量化值。新生儿部分可包括性别、出生体重、Apgar评分、结构异常、巨大儿、低出生体重、SGA/FGR、新生儿低血糖、黄疸、呼吸窘迫和NICU收治等,但每个字段都必须给出定义、观察窗口和来源。
母体实验室和超声数据需要特别注意单位与测量语境。血常规、肝肾功能、血脂、甲状腺功能、凝血、铁代谢、维生素D、感染筛查、PAPP-A、胎盘生长因子及同型半胱氨酸等项目,既有定量结果,也有阴性/阳性结果,不能用一个通用数值类型承载。胎儿估测体重、腹围、股骨长、脐动脉S/D和羊水评估还要绑定孕周、检查类型和报告来源;超声报告中的“未见异常”与“未检查”应分开编码。
标签核验应优先于模型训练。GDM标签不能只由病历中某个单选字段生成,应尽可能与OGTT结果、诊断标准版本和临床管理记录进行交叉核对。2025年的一项电子病历验证研究将EHR标签与临床团队实时维护的参照数据库比对,并显示标签不一致会影响机器学习模型的训练和测试;研究未能完成跨医院外部验证,说明单中心标签核验并不等于模型已经具备跨场景有效性。1 这对数据项目的启示是:标签表应保留“原始标签”“核验标签”“冲突原因”“最终纳入状态”四列,而不是只交付一个0/1结果。
四、算法路线要服从时间和证据边界
在基线模型层面,逻辑回归、正则化回归、梯度提升树和随机森林可以作为可解释的比较起点。它们适合检查字段方向、缺失模式、共线性和标签漂移,也有助于发现某个看似强的变量是否只是编码习惯或中心差异的代理。深度模型只有在样本规模、事件数、时间密度和标签质量足够时才有意义;不能因为字段数量多,就默认多模态深度学习会比结构化基线更可靠。
GDM数据常同时包含类别、连续值、分段时间和文本派生变量。可采用分层编码或按事件序列构建时间窗,但必须先决定每个预测时点允许读取哪些事件。若任务是孕早期风险预测,OGTT结果、分娩诊断和产后结局只能作为标签或后续评价,不能作为输入。若任务是治疗反应研究,则用药前后的窗口需要分开定义,并在统计解释中区分治疗选择与治疗效果,避免把观察性关联写成因果结论。
缺失值处理不是单纯的工程补洞。缺失可能来自未检查、检查后未回传、病历模板变化、病情选择性检查或系统迁移。2025年一项中国队列研究比较了均值/众数、KNN、多重插补和深度学习插补方法,并在训练集和测试集分开后拟合插补模型,以降低数据泄漏风险;研究也展示了高缺失字段会显著影响可用样本量。2 因此,数据字典要记录“未测量”“未知”“不适用”“源系统缺失”和“被规则排除”,并在模型报告中说明插补策略与不确定性,而不是只提供一个填充后的整洁表。
外部验证应在设计阶段写入,而不是模型完成后再寻找一个“相似数据集”。时间验证可检验诊疗路径、编码习惯和人群结构随年份变化后的稳健性;地理验证可检验不同中心、设备、实验室流程和书写习惯带来的分布差异。近期研究在妊娠间隔和再次妊娠GDM风险预测中,将后续年份的队列作为时间验证,并以另一中心作为地理验证,且由产科专家按统一标准重新核对结局。3 这说明“按随机比例切分”不能替代真正的外部验证。
对于跨研究或跨中心合并,变量同名并不代表可直接合并。2024年的外部验证研究使用多项试验的个体数据核验GDM风险模型,报告了变量类别、诊断标准和缺失模式的异质性,并说明协调与插补会影响可用样本量和性能指标。4 数据采购或合作时,需优先对照变量定义、筛查方式、OGTT负荷、诊断阈值、结局窗口和样本排除条件,而不是只比较字段数量。
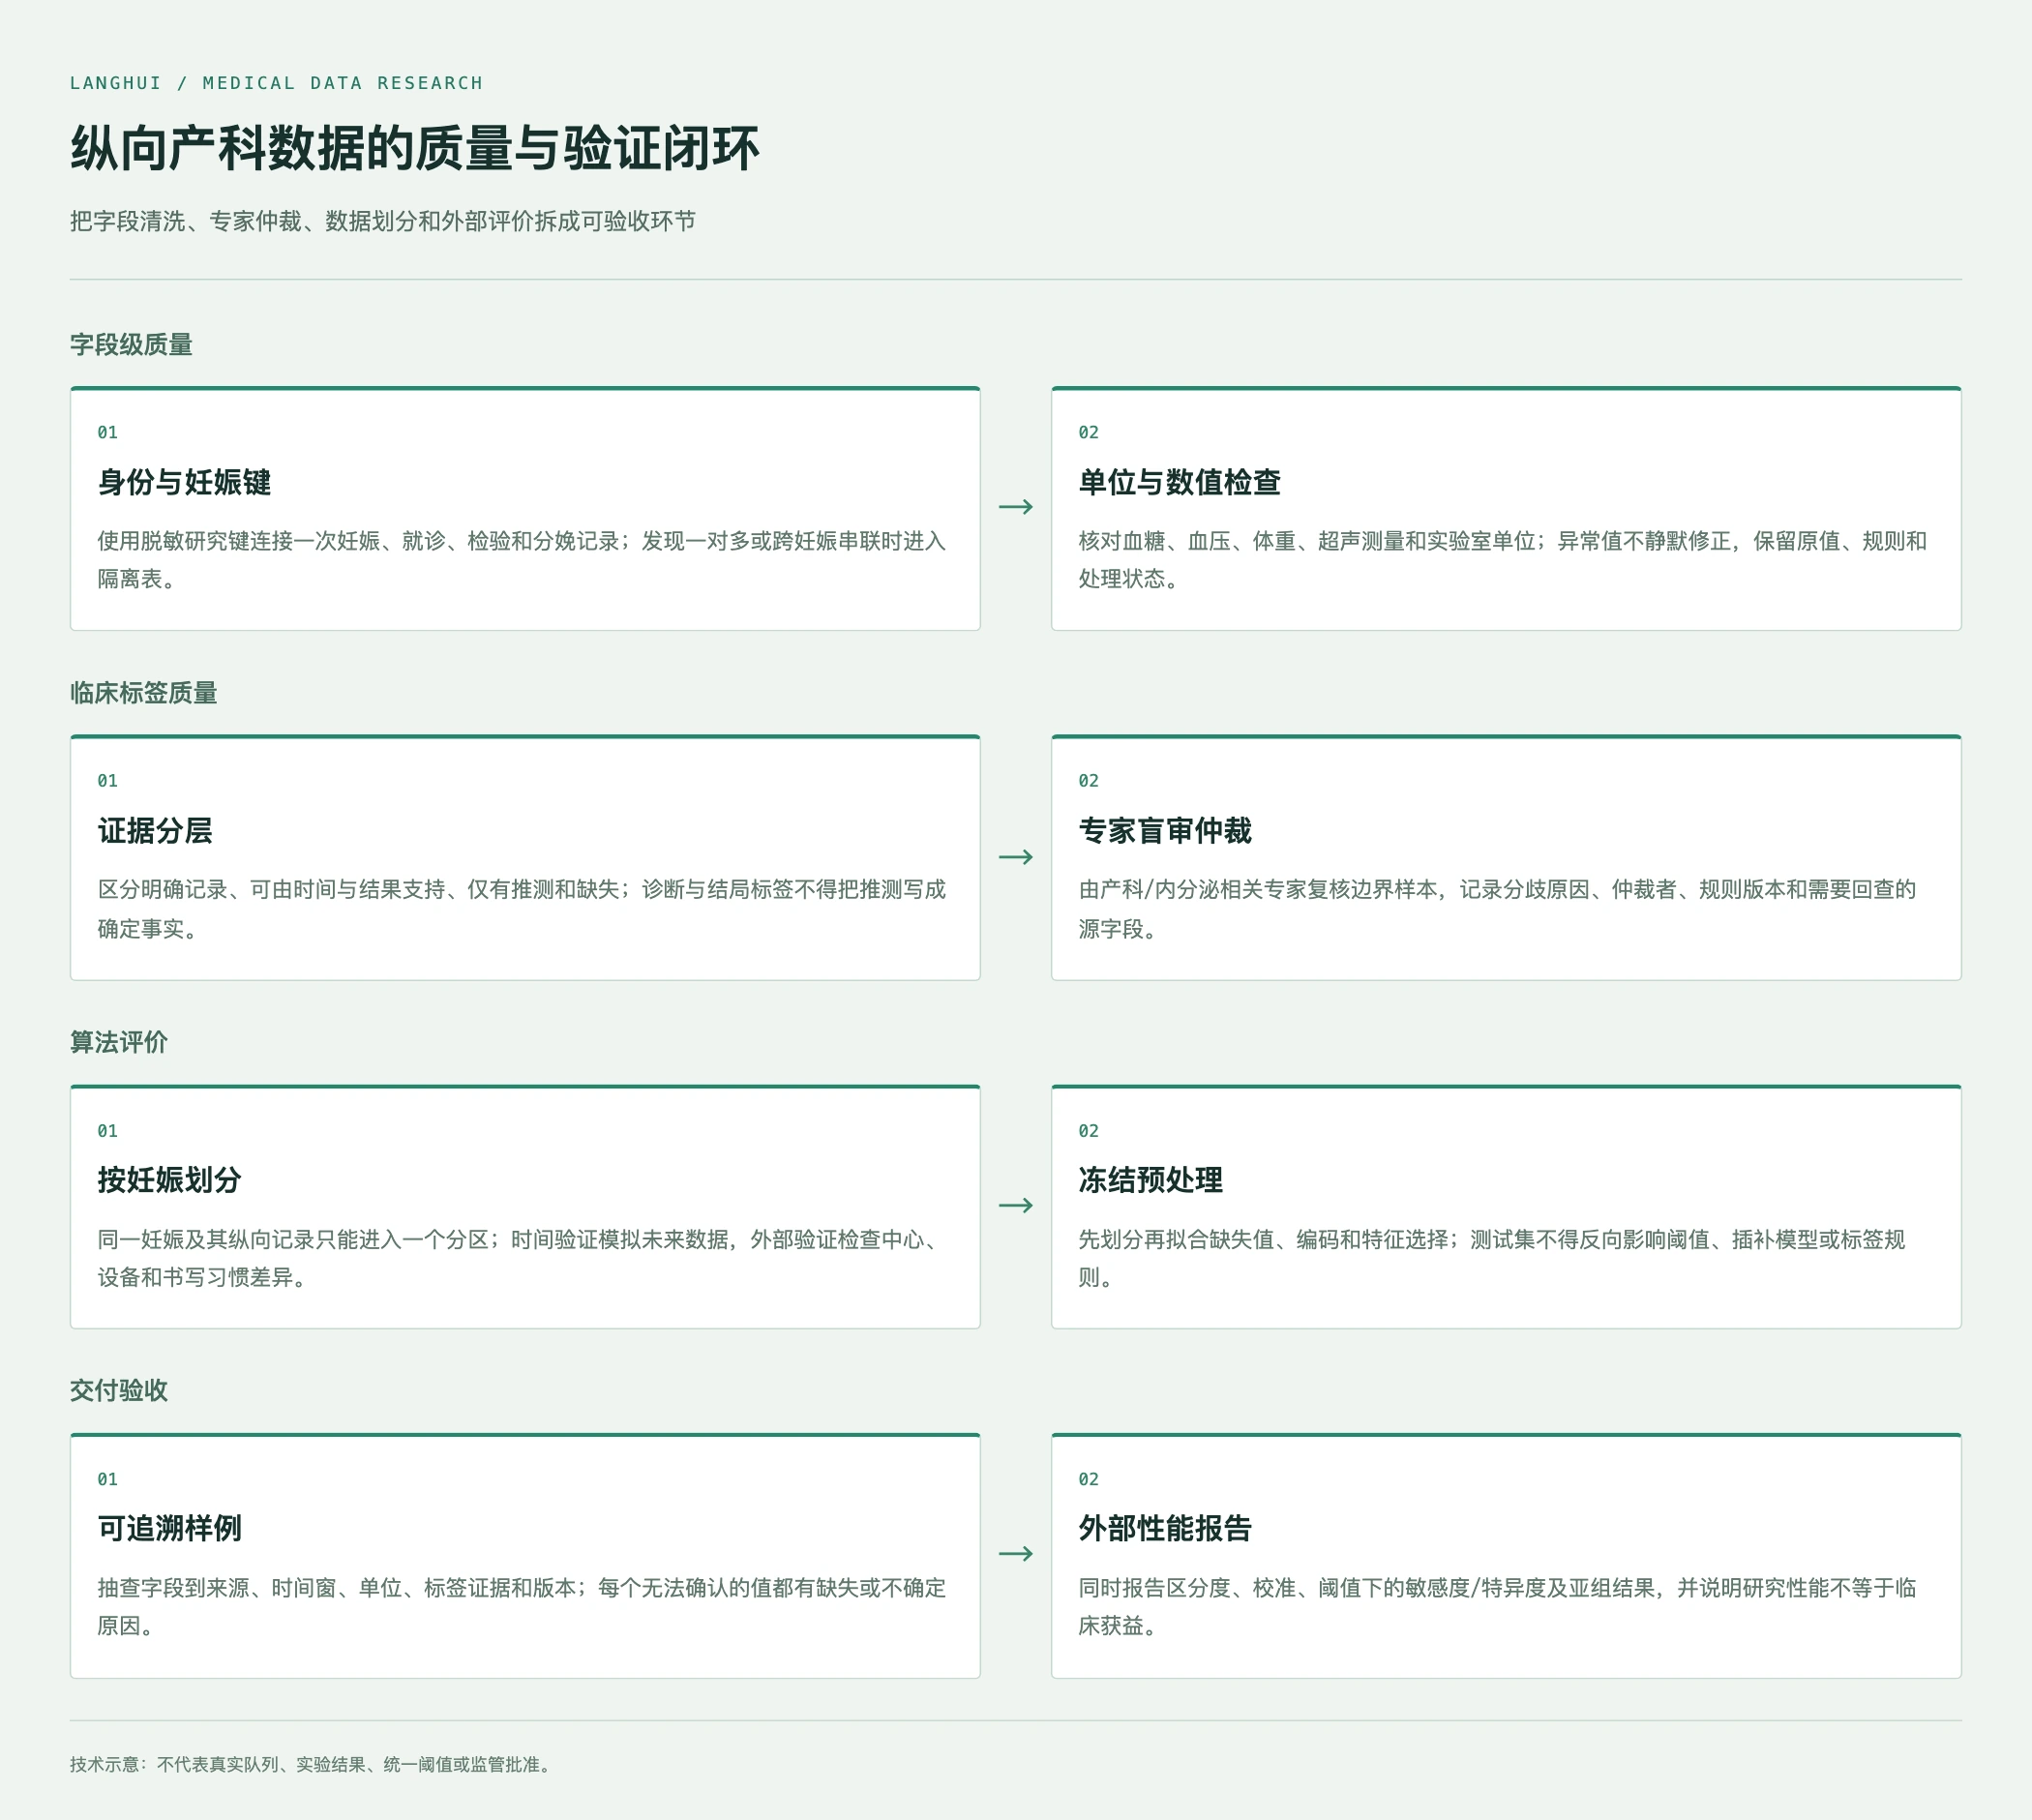
图2 纵向产科数据质量与验证闭环技术示意:字段核查、临床证据分层、盲审仲裁、按妊娠划分、冻结预处理和外部性能报告应作为连续验收环节;不代表真实队列、实验结果、统一阈值或监管批准。
五、专家标注与质量控制要写成动作
专家参与不应只写“由医学专家审核”。对于边界样本,应先规定谁负责字段语义、谁负责诊断标签、谁负责妊娠结局和超声指标,哪些分歧由第二位专家复核,哪些情况需要仲裁。审核者应看到足够的上下文来判断时间和主语,但不应通过先看算法预测来反向修改金标准。每次修改要留下原值、修订值、依据、修订人、复核人和规范版本。
盲审设计可按字段或样本抽样执行。结构化字段适合先由经过培训的标注人员提取,再由具有产科或内分泌背景的专家复核;复杂的GDM标签和母婴结局应建立疑难样本池。评价指标可以包括字段级一致率、分类标签的Kappa、连续值的绝对误差或组内相关,但指标必须预先指定样本单位、参考标准、缺失处理和计算方法。一个总体一致率不能掩盖早产、子痫前期或新生儿并发症等低频标签的系统性漏标。
质量偏差需要覆盖四个层面。来源偏差包括单中心、单一设备和特定转诊路径;记录偏差包括不同医生、不同模板和年份的书写差异;选择偏差包括只纳入有完整OGTT或有完整分娩记录的妊娠;标签偏差则包括把推测、既往病史和本次诊断混淆。对每一层偏差,都应有排除、分层、敏感性分析或外部验证计划。对少数族群、不同年龄、BMI区间、不同孕次和不同受孕方式,也应在可行时报告分层表现,而不能只公布总体AUC。
研究结果应同时呈现区分度和校准。AUC或平均精确率可以描述排序能力,但不能说明概率是否可信;校准曲线、校准斜率/截距和预先定义的阈值指标,才能帮助读者理解模型在不同风险区间的表现。TRIPOD+AI要求对使用回归或机器学习方法的预测模型进行完整、准确、透明的报告,并强调关键亚组、公平性、数据与代码开放程度等内容。6 对医疗AI数据交付而言,这意味着数据卡和验收报告也应记录版本、划分、预处理、标签来源和已知限制,而不是只交付一张指标截图。
六、把采购和交付拆成可以复核的业务逻辑
面向算法团队的交付物,应包括数据字典、字段映射、单位和范围表、时间锚点规则、标签证据表、缺失状态表、排除日志、训练/验证/测试划分说明和一组能被代码实际读取的脱敏样例。面向临床研究团队的交付物,还应包括纳排标准、结局定义、专家复核说明、争议样本清单和规范版本。面向信息与治理团队的交付物,则要说明授权用途、访问审计、脱敏检查、版本留存和数据退出机制。
验收不应只检查“字段是否存在”。可以设计四类可复核测试:第一,随机抽取样本,从标准字段追溯到来源、时间、单位和证据;第二,抽取同一患者的多次妊娠,确认不同妊娠不会互相串联;第三,抽取边界时间样本,确认孕周窗口、OGTT前后和治疗起始点符合规则;第四,使用一份冻结的样例运行导入、预处理、标签生成和导出,检查下游代码能否重现字段和版本。对于异常值,应同时给出原始值和处理状态,不能用静默删除代替质量记录。
业务上,还要把“数据集交付”“标注审核”“平台工具”“算法开发”和“院内部署”分开核对。一个平台具备结构化管理、标注和质检流程,不等于已经拥有某个特定病种的现成数据,也不等于模型已经完成临床验证。根据已核验的公司能力边界,朗慧的定位是AI数据基础设施与流程服务商,覆盖采集、处理、标注、质检和数据交付;具体项目仍需按样例、模态、字段、专家复核范围、授权和验收条件书面确认。本文不把网站自述、需求字段或研究建议转换为现货规模、临床效果或监管背书。
在试点阶段,建议先用小规模、已脱敏且授权范围清楚的样例验证三条链路:字段能否从来源稳定映射到数据字典;专家能否对关键标签达成可记录的一致意见;算法能否在不读取未来信息的前提下复现同一版本的输入。试点中发现的“时间无法定位”“既往与本次混淆”“治疗前后错位”“结局定义不一致”等问题,应回写规范和问题单,再决定是否扩大到全队列。这样做的价值不是增加文档数量,而是把模型失败和数据失败区分开。
结语
妊娠期糖尿病纵向数据的难点,不在于列出多少疾病、药物或检验名,而在于把临床语义、孕周时间、证据等级和研究任务绑定起来。一个可复用的数据集,应能回答每个字段来自哪里、代表哪一次妊娠、在什么时间可用、由谁确认、缺失意味着什么,以及它是否可能把未来信息带入模型。只有在这些问题被版本化并通过独立抽查后,算法性能、外部验证和业务交付才有可解释的基础。
参考来源
- Label Accuracy in Electronic Health Records and Its Impact on Machine Learning Models for Early Prediction of Gestational Diabetes: 3-Step Retrospective Validation Study
- Enhancing early gestational diabetes mellitus prediction with imputation-based machine learning methods
- Predicting gestational diabetes before conception for personalized interpregnancy weight management
- External validation of risk prediction model for gestational diabetes mellitus
- 15. Management of Diabetes in Pregnancy: Standards of Care in Diabetes—2025
- TRIPOD+AI statement: updated guidance for reporting clinical prediction models that use regression or machine learning methods