
MEDICAL DATA RESEARCH
上腹部多病种 CT 分割数据怎么建:从薄层协议到可复现验收
面向医疗AI研发与数据采购团队,拆解上腹部多病种CT数据建设中的薄层协议、DICOM脱敏、像素级掩码、专家复核、患者级划分与分层验收,明确研究证据、项目边界和可复核交付条件。
上腹部 CT 数据建设最容易被低估的环节,不是“能否拿到足够多的影像”,而是同一套标签是否真的描述了同一个医学任务。肝脏、胆囊、胆管和胰腺病变的形态、边界、增强表现与可见性并不相同;如果把它们放在一个模糊的“异常区域”标签下,模型可能学到扫描协议、设备或标注习惯,而不是病灶本身。更稳妥的做法,是把临床任务、采集协议、像素级输出、专家责任和独立验证写成一条可追溯的数据链。
本文讨论一类匿名化的上腹部多病种 CT 数据建设需求。原需求包含采购与合同信息,公开讨论只保留可独立成立的技术问题:多病种上腹部 CT 的采集如何冻结协议,异常区域如何逐层形成掩码,专家如何处理边界争议,脱敏如何覆盖 DICOM 属性与像素内文字,以及交付如何让算法团队复核和复现。文中的建议参数、阈值和流程不是统一行业标准,必须在试标、伦理与项目书面约定后确定;文章也不提供任何个体诊断或治疗建议。
一、先把“上腹部异常”还原成可执行任务
源需求的临床任务不是一般的影像分类,而是为辅助分析模型建设带有病灶像素级标签的 CT 数据。输入是上腹部 CT 体数据及其序列元数据,输出是与原始影像逐体素或逐轮廓对齐的异常区域标签,并附带病种类别、检查级信息、标注状态和质量记录。数据颗粒度至少分为患者、检查、序列、切片和病灶对象五层;如果只以文件为单位统计数量,同一患者的多次检查或同一检查的派生序列就可能被错误地当作独立样本。
病种字典应把肝脏、胆囊、胆管、胰腺等解剖区域的不同异常类型拆开定义,而不是只保留“肿块”“囊性影”或“高密度区”等视觉描述。肝癌、血管瘤、囊肿、局灶性结节性增生和腺瘤的标签边界并不自动相同;胆囊息肉与胆囊恶性病变、胆管恶性病变与邻近炎性改变,也不应只凭一个总类别处理。公开稿不复述特定采购清单,而将其转化为通用原则:类别名称、纳入条件、排除条件、疑似或不确定状态、邻近结构误标处理,都要在标签字典中留下版本号。
还要区分“病灶是否存在”“病灶属于哪一类”和“病灶在哪里”三个层次。分类标签可以位于检查级或病灶级,分割标签则位于体素或轮廓级;二者的参考依据、专家资质和验收指标不同。若某个病灶只能确认大致范围,项目可以保留不确定区域或争议状态,而不应为了填满掩码强行补出精确边界。这样做会牺牲表面的整齐,却保留了对模型校准和后续复核更有价值的证据。
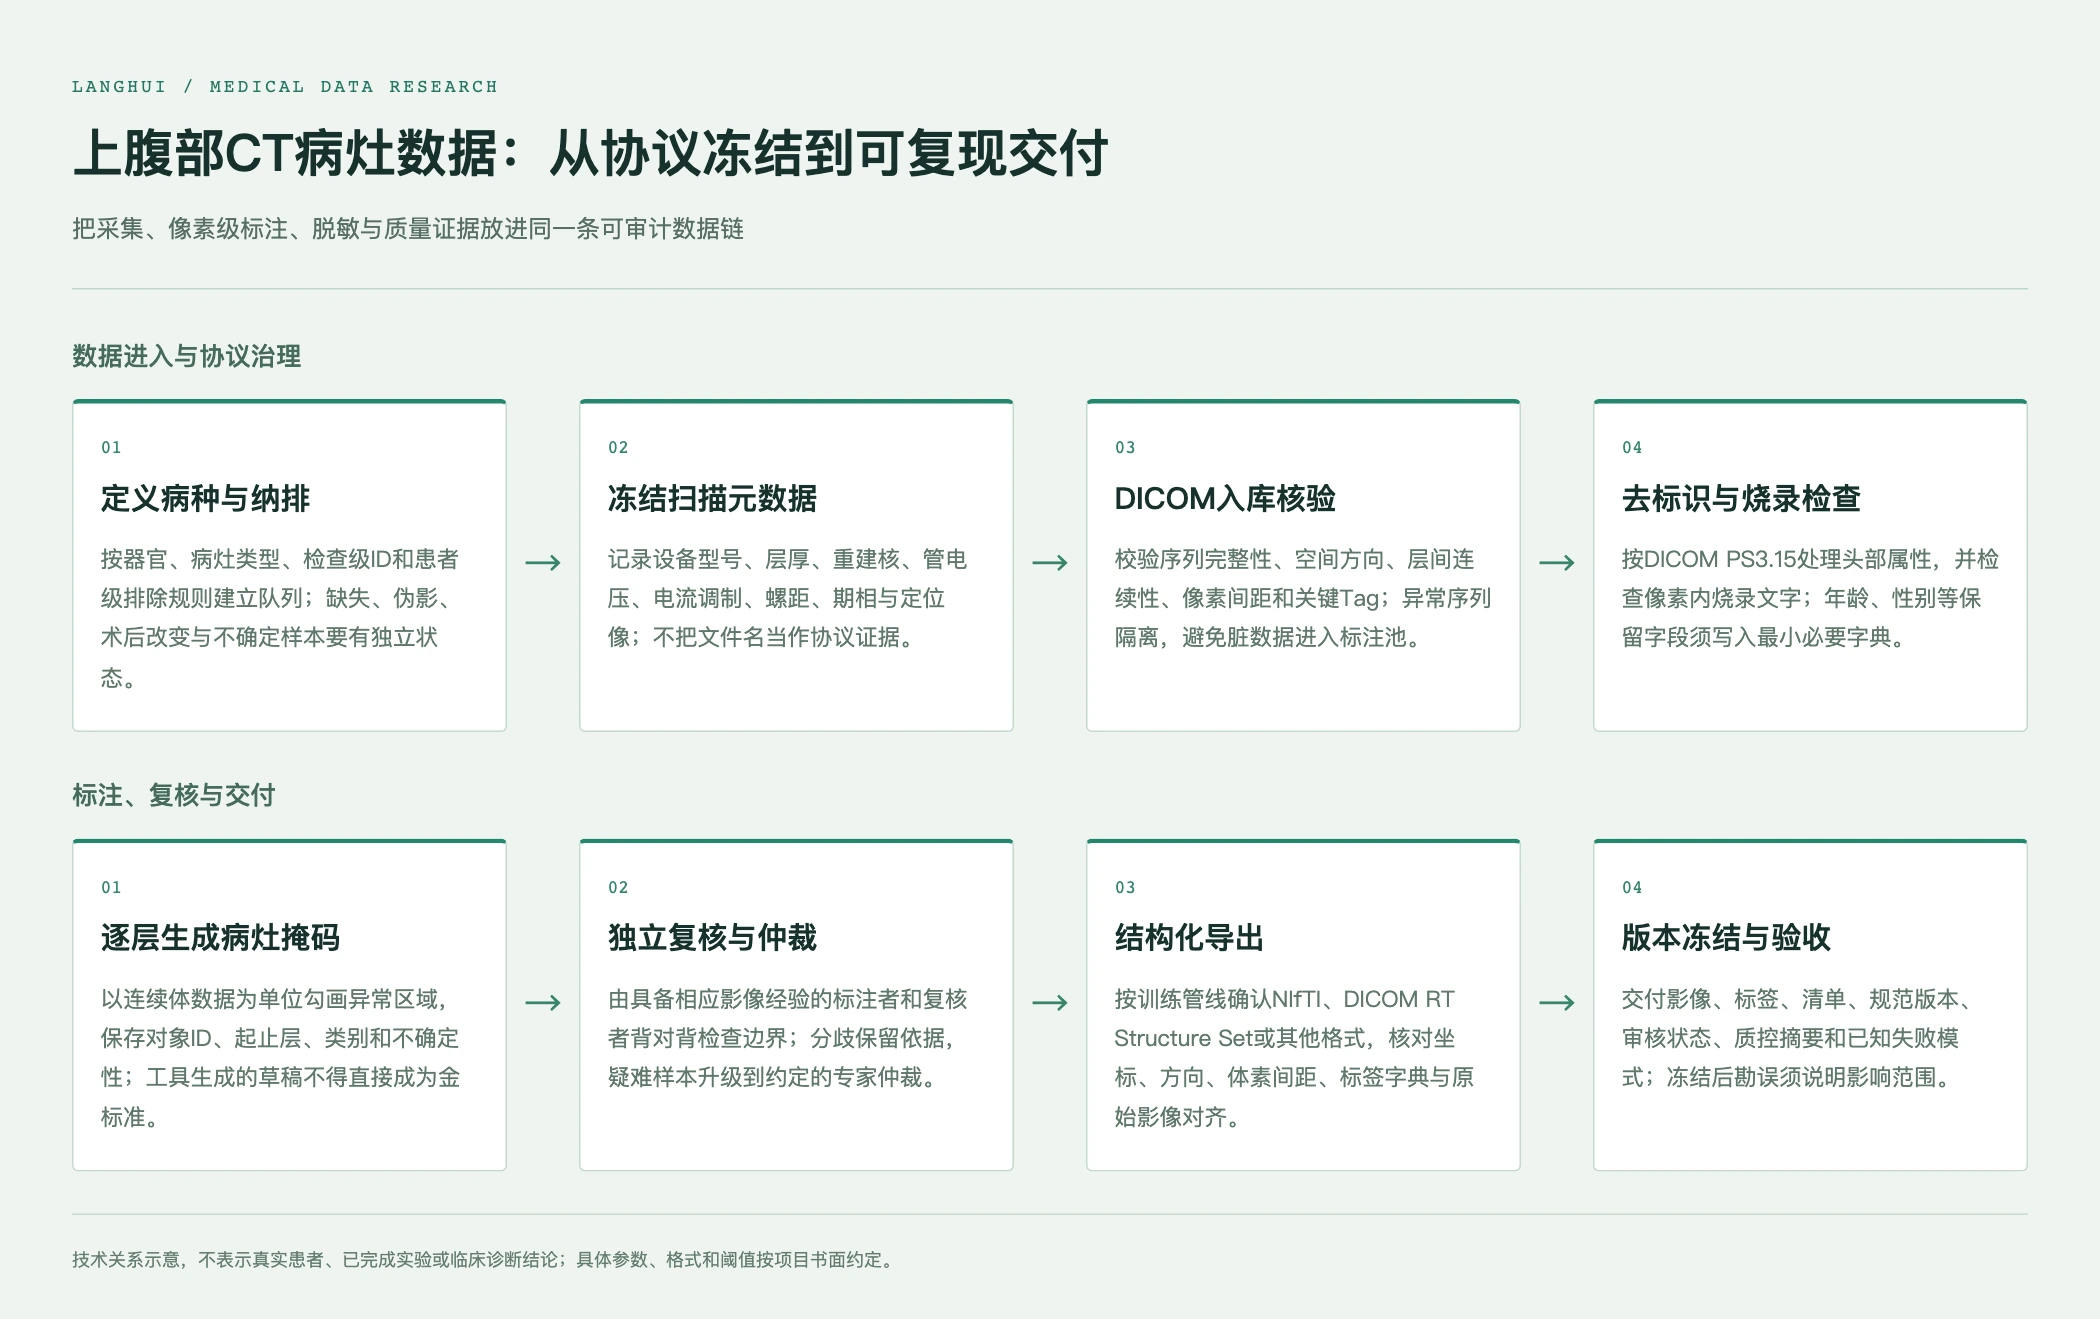
图1 技术示意:采集协议、DICOM核验、去标识、逐层标注、专家复核与版本交付的关系;不表示真实患者、已完成实验或临床诊断结论。
二、采集的核心是协议一致性,而不是设备名称
CT 采集需求通常会写到设备级别、层厚、管电压、电流调制、螺距和薄层序列。对数据工程而言,这些不是“设备越高端越好”的宣传词,而是决定重建几何、噪声特征、增强对比和病灶可见性的元数据。建议在入组时保留定位像、完整薄层序列以及能解释采集条件的 DICOM Tag,并把设备型号、重建核、扫描范围、对比剂期相和层间连续性纳入数据字典。具体数值应随研究目的和设备条件做试标后冻结,不宜将单一采购阈值直接当成所有课题的医学标准。
多病种数据尤其需要处理协议漂移。病灶在动脉期、门静脉期或延迟期的表现可能不同;某些序列适合显示血管关系,另一些序列更有利于观察实质或囊性成分。研究者不能根据文件名猜测期相,也不能把同一检查的平扫、增强和派生重建当成相互独立的样本。已有腹部多期相研究显示,期相所携带的互补信息会影响多器官分割,但其训练与外部验证依然依赖明确的数据来源、配准关系和人工勾画。3 因此,入库表应记录序列类型、期相、层厚、方向、像素间距、重建信息和缺失原因;无法确定的字段应标注“未知”,不能由标注员推断填补。
设备差异也不应被简单地用“同等级设备”替代。不同厂商和型号可能带来重建核、噪声纹理、剂量控制和对比度差异。2025 年一项胰腺 CT 分割研究在标准化门静脉期数据上进行专家勾画,同时指出单一厂商占比偏高会影响外推,并以多机构数据做独立验证。4 这对上腹部病灶项目的启示是:采集阶段就要把设备和协议作为分层字段,而不是等模型训练结束后才发现训练集与目标环境之间存在明显偏移。 设备差异也不应被简单地用“同等级设备”替代。不同厂商和型号可能带来重建核、噪声纹理、剂量控制和对比度差异。2025 年一项以影像学未见明显胰腺异常病例为主的 CT 分割研究,在标准化门静脉期数据上进行专家勾画,同时指出单一厂商占比偏高会影响外推,并以多机构数据做独立验证。4 这对上腹部病灶项目的启示是:采集阶段就要把设备和协议作为分层字段,而不是等模型训练结束后才发现训练集与目标环境之间存在明显偏移。
三、像素级标注必须回答“画什么、画到哪里、依据是什么”
逐层像素级分割并不等于在每张切片上圈出一个看起来异常的区域。首先要明确标的是病灶整体、病灶实性部分、囊性或坏死部分,还是器官与病灶的联合结构;这些对象如果同时存在,必须使用不同类别和对象 ID。其次要规定起始层、结束层、相邻层连续性和部分容积效应的处理方式。边界在某一层不清晰,不意味着可以用平滑、膨胀或插值代替医学判断;如果采用插值生成中间层,必须规定哪些层需要回看,以及如何记录修改。
器官掩码与病灶掩码应当分开设计。肝脏、胆囊、胰腺等器官轮廓可以作为定位、裁剪和错误检查的参照,但不能把器官轮廓直接当成病灶真值。对于胰腺周围的血管、肠管和脂肪间隙,肿块边界可能细弱;对于肝脏病变,血管、胆管、坏死区和邻近实质的对比会随期相改变。任务说明需要给出正例、反例和“证据不足”案例,明确邻近结构被误纳入时是修订、排除还是升级仲裁。
标注格式同样是任务的一部分。NIfTI 适合许多三维训练管线,但需要验证方向矩阵、体素间距、原点和标签编码;DICOM RT Structure Set 保留轮廓对象及其引用关系,但下游软件的读取方式可能不同。采购或研究交付不应只写“提供掩码”,而要提供一份能在目标训练代码或阅片工具中打开的样例,核对原图与标签的层数、方向、坐标和类别映射。标签文件之外,还应交付标签字典、对象 ID 规则、异常状态编码和变更记录。
四、专家标注不是人数承诺,而是责任链设计
源需求要求至少两名放射科医师独立标注,并由资深医师审核。公开转写时,关键不在于复述一个固定人数,而在于把职责分离为初标、独立复核和争议仲裁三种角色。初标者依据版本化指南逐层勾画;复核者在看不到初标理由或必要时采用背对背方式检查边界;仲裁者只处理预先定义的高风险分歧,并把结论回写到指南示例。若同一人既写规则又完成全部标签,后续的一致性数字很难解释。
“标注精度不低于某个百分比”也不能脱离测量对象。像素重叠、表面距离、病灶级召回、漏标率和类别混淆分别回答不同问题。Kappa 受类别分布、抽样单位和不确定标签影响;Dice 受病灶大小和边界定义影响;平均表面距离对少量远离边界的错误更敏感。项目应在试标后确定参考勾画、计算实现、抽样单位和阈值,不把一个孤立数字包装成普遍质量保证。
关于多读者与单读者,研究证据并不支持机械地选择一种模式。胰腺 CT 研究采用经过培训的专科影像医师按统一协议进行标注,以控制大规模生产中的漂移,同时承认胰腺边界困难和外部验证的必要性。4 CURVAS 数据集则用肝脏、胰腺和肾脏的多专家标注研究不确定性与校准,结果显示胰腺的标注一致性更具挑战,并强调分割不存在对所有病例都适用的单一“金标准”。5 对采购方而言,更重要的是根据病种风险决定何处使用双人独立标注、何处使用抽样复核、何处必须保留多意见,而不是只追求一个统一流程。
五、算法路线应服务于可审计的金标准
算法路线可以从三维 U-Net 或 nnU-Net 类自配置框架开始。nnU-Net 的贡献不只是某个网络结构,而是把预处理、网络配置、训练和后处理与数据特征联动,提醒团队先确认体素间距、图像尺寸、类别不平衡和硬件约束,再决定 2D、2.5D 或 3D 方案。6 对上腹部薄层 CT,3D 路线可以保留层间上下文,但显存、各向异性和小病灶比例需要通过试标和消融实验验证;2D 或 2.5D 路线可能更易部署,却需要额外设计层间连续性检查。
对于多病种任务,建议把器官参照模型、病灶分割模型和异常分类头拆成可替换模块,而不是让一个模型承担所有语义。器官模型可以帮助检查病灶是否越过解剖边界,病灶模型负责生成候选掩码,分类模块则处理病种或检查级标签。模型产生的结果应始终保持“草稿”状态,经过专家修订、盲审和争议关闭后才进入金标准或训练集。MedSAM 的研究展示了提示式分割与专家修订可以形成协同工作流,但论文同时报告了模态不均衡以及血管样分支结构的困难;其研究结果不能直接转换为本项目的临床效果或验收指标。2
预标注的验收重点应从“模型画得像不像”扩展为“是否帮助发现错误”。建议记录草稿大改比例、漏标类型、越界类型、不同病种间的修改差异和不确定样本比例;这些是项目内部改进指标,不是对外宣传的准确率。若某一病种的草稿经常把邻近血管或器官纳入,问题可能来自期相、窗位、标签定义或训练样本,而不是单纯需要换网络。失败样本要回流到指南、采集协议或排除规则,形成版本化闭环。
六、质量控制要覆盖脱敏、泄漏和外部验证
DICOM 去标识不能简化为删除患者姓名和 ID。DICOM PS3.15 的保密配置既涉及属性处理,也提供清理像素数据和烧录文字的选项;标准特别指出,像素内识别信息需要单独检查,覆盖图形或遮挡不一定等于改变存储像素值。1 因此,脱敏验收至少包括头部属性抽检、私有 Tag 策略、UID 重映射规则、定位像检查、像素内文字检查、日志和授权用途核对。年龄、性别等临床变量是否保留,应根据最小必要原则与研究问题书面确认,而不是默认全部保留。
分割项目还要防止数据泄漏。同一患者的不同检查、同一序列的不同重建、从原始体数据派生的裁剪和增强副本,都应在患者级规则下进入同一数据划分。若训练集含有某设备或某中心的独特协议,而测试集只是同一来源的随机切分,内部分数可能高估实际迁移能力。应在冻结划分前保存患者级清单、随机种子、重复检查处理规则和派生文件关系。外部验证最好引入未参与指南制定的设备、协议或来源,并报告样本选择、缺失序列、影像质量和失败案例,不把外部得分改写成临床有效性。
验收指标应与任务类型对应。像素级分割可以报告 Dice、IoU、表面距离、病灶级漏标与越界等;分类标签可使用灵敏度、特异度、AUROC 或校准指标;数据交付还需要检查文件可读性、坐标对齐、标签字典一致性、审核状态和版本冻结。对小病灶或稀有病种,平均分可能掩盖少数高风险错误,宜按病种、病灶大小、设备、期相、伪影和修改幅度分层抽检。科研论文中的模型性能与数据供应项目的交付合格不是同一件事,前者还需说明训练策略和测试集,后者必须能追溯到每批数据的状态与责任人。
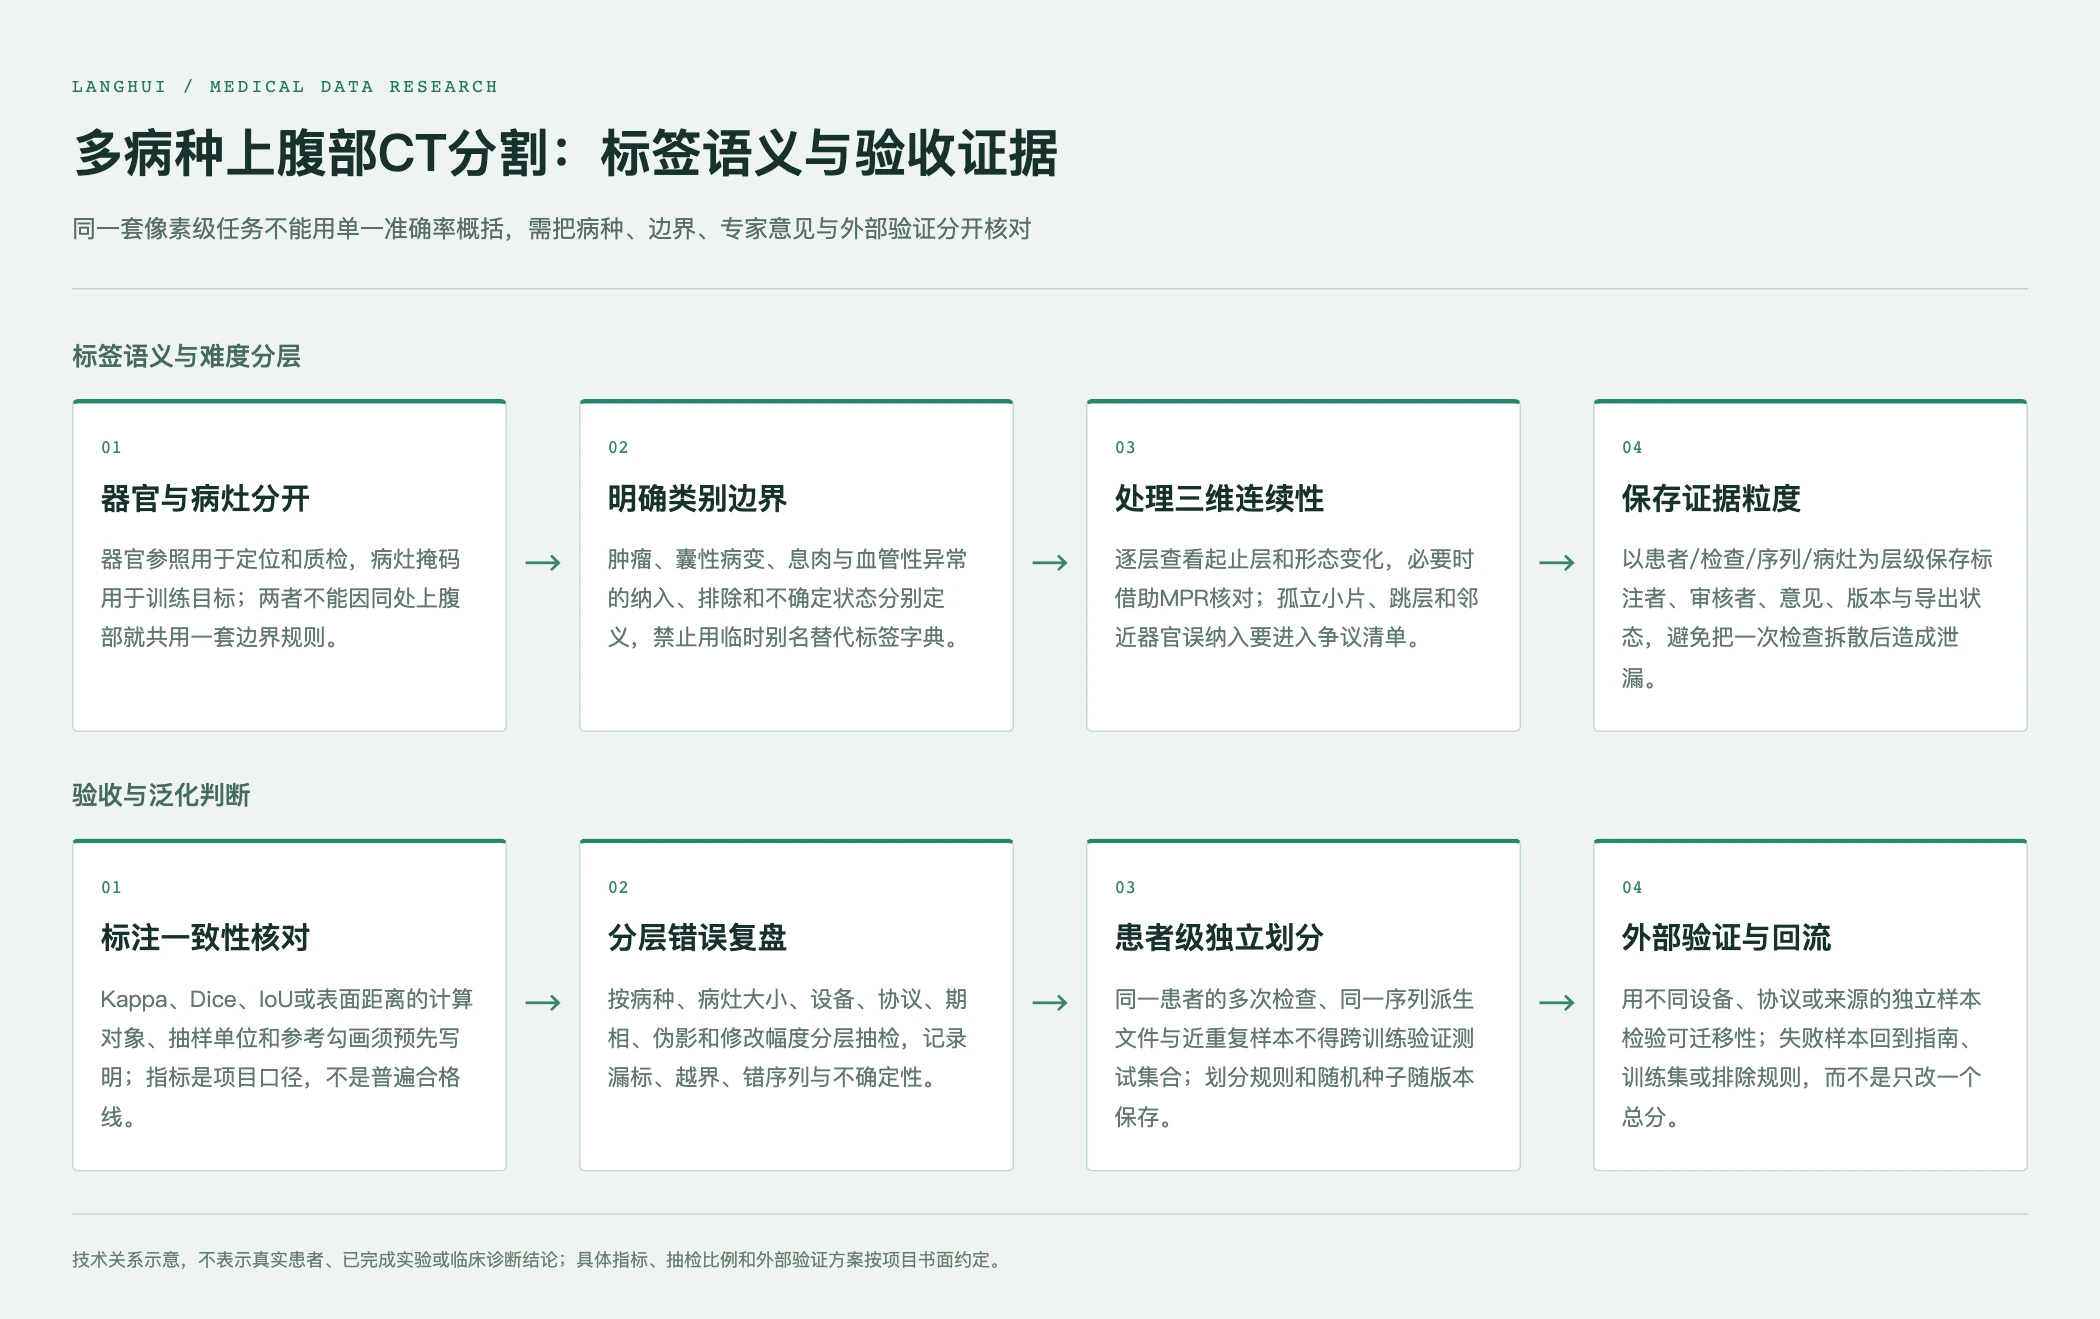
图2 技术示意:从器官/病灶分离、三维连续性到分层抽检、患者级划分和外部验证;不表示真实患者、已完成实验或临床诊断结论。
七、交付要让三个团队拿到同一套事实
算法团队需要原始影像或按授权范围整理的训练输入、标签文件、体素和方向信息、患者级划分、标签字典以及一份可运行样例。影像研究团队需要纳排标准、期相和设备字段、专家角色、争议记录、缺失编码与质量摘要。信息与合规团队需要脱敏规则版本、权限、日志、备份、传输边界和退出时的数据交还方式。三类材料不能被一张“已完成标注”的清单替代。
目录结构可以按病种、患者级匿名 ID、检查和序列组织,但目录本身不是质量证明。交付清单应同时指向影像、标签、元数据表、审核记录、指南版本、模型或工具版本(如适用)以及勘误补丁。若使用硬盘、NAS 或其他介质交付,应核对校验和、文件数量、压缩规则、读取软件和抽样打开结果;存储方式的变化不应改变标签语义。TCIA 的 Pancreas-CT 数据集就是一个有明确采集期相、设备与层厚描述、匿名化说明以及人工分割和放射科医师复核信息的公开例子,说明“影像文件+标签”之外的上下文同样是可复用数据的一部分。7
八、把技术需求转成可控制的业务逻辑
上腹部多病种项目不宜从一次性大规模生产开始。更可执行的路径是先选能暴露主要边界争议的脱敏样例,完成导入、协议字段核对、逐层标注、独立复核、导出和下游读取,再据此冻结标签字典与验收脚本。试标阶段应回答:病种是否需要不同指南,哪些病例应进入争议队列,哪些协议差异需要分层,预标注是否造成系统性错误,外部验证的最小样本如何构成。试标不是缩小版宣传演示,而是决定是否值得放量的工程闸门。
采购范围还应把平台、数据采集、专业标注、专家终审、存储和接口拆开。软件许可不等于标注已经完成,数据交付也不自动包含临床验证;如果同时需要私有化、专网、PACS 对接或持续维护,应分别列出部署边界、权限、日志、接口和服务责任。公开能力只能作为任务匹配的起点,不能把网站上的模型名称、目录规模或服务描述当作某一病种现货、固定专家数量或统一性能证明。
在已核验的公司范围内,朗慧的定位是 AI 数据基础设施与流程服务商,能力表达应围绕采集、处理、标注、质检和数据交付展开。医疗项目可按部位、模态和任务做需求评估,质量依据应落在项目规格、样例、质量记录与版本上;实际数据来源、授权范围、专家配置、交付规模和部署形态仍需逐项书面确认。对于这类上腹部 CT 需求,合适的价值不在于承诺某个模型已经解决所有病种,而在于把规格、专家协作、版本冻结和问题回流组织成可核对的生产流程。
结语:先建立可辩护的数据,再讨论模型效果
高质量的上腹部 CT 分割数据集不是“影像数量加掩码文件”的简单相加。它需要以患者级划分守住泄漏边界,以 DICOM 元数据保留采集语境,以标签字典说明每个病种和边界,以专家复核记录不确定性,以分层质控和外部验证检验可迁移性。医学影像 AI 数据准备综述也将采集、去标识、数据整理、存储管理与医学标注视为相互衔接的准备链条。8 公开研究已经分别展示了多期相信息、提示式分割、自配置训练和多读者不确定性研究的价值,但这些研究结果只有在任务定义、数据授权、标注规则和独立评价条件相近时才有参考意义。[2–6]
对医疗 AI 研发团队而言,最值得优先投入的不是把需求写得更大,而是把每一个标签变成可解释、可复核、可版本化的事实。做到这一点,数据才有机会支持后续算法迭代、复现实验和谨慎的外部验证;在此之前,任何“高精度”“临床可用”或“自动诊断”的表述都应保持克制。
参考来源
- DICOM PS3.15: Security and System Management Profiles
- Segment anything in medical images
- Multi-phase CT synthesis-assisted segmentation of abdominal organs
- Pancreas segmentation using AI developed on the largest CT dataset
- A MultiRater MultiOrgan Abdominal CT Dataset for Calibration Analysis
- nnU-Net: a self-configuring method for deep learning-based biomedical image segmentation
- Pancreas-CT | The Cancer Imaging Archive
- Data preparation for artificial intelligence in medical imaging: A comprehensive guide to open-access platforms and tools