
MEDICAL DATA RESEARCH
妊娠期糖尿病纵向队列:把孕周、检验与母婴结局整理成可验证数据
面向医疗AI研发与数据采购,拆解妊娠期糖尿病纵向队列的孕周对齐、OGTT与治疗时间窗、病历与检验融合、专家复核、标签防泄漏和母婴结局验收,说明如何交付可追溯、可复核的研究数据包。
妊娠期糖尿病(GDM)研究最容易被低估的难点,不是把“是否患病”填进一列,而是要回答:一次妊娠从何时开始,哪一次检验真正位于目标孕周,诊断发生在治疗前还是治疗后,病历中的阴性究竟代表未发生、未记录还是尚未核验。若这些问题没有在数据字典和清洗规则中冻结,后续模型即使能够输出漂亮的分数,也可能只是在学习记录习惯、就诊频率或标签缺口。
这类研究需要的不是一张扩大后的病例表,而是一套以妊娠事件为主线、把病历文本、结构化人口学信息、实验室结果、用药与血糖管理、产科影像测量以及分娩和新生儿结局连接起来的纵向数据工程。它既服务于GDM表型识别,也可以支持治疗轨迹、母婴结局和早期风险研究;但不同任务必须使用不同的时间窗和终点,不能把整个孕期的所有字段无差别地塞进同一个模型。
一、先把临床问题写成数据问题
源需求呈现的是一份医学数据治理和清洗规格:研究对象包含GDM与对照,数据来自住院和门诊记录、出入院文书、检验、用药及产科评估;目标不是给某一名孕妇诊断,而是把分散在不同业务表和自由文本中的变量整理成可复核的研究队列。公开化改写时,应删除样本行、姓名、住址、就诊号、机构线索和原始项目名称,只保留能够独立成立的技术任务。
临床任务可以拆成四层。第一层是队列识别:判断一条记录属于哪一次妊娠,并区分既往糖尿病、孕期首次发现的高血糖、GDM、对照和无法判定。第二层是时间对齐:将末次月经、检查日期、诊断日期、用药起始时间、分娩日期和孕周放到同一时间轴。第三层是表型构造:形成孕期病史、孕期用药和营养补充、血糖管理、人体测量、实验室与产科超声变量。第四层是结局连接:把妊娠期并发症、分娩过程、胎儿生长和新生儿结局与母体记录建立受控关联。
对应的输入模态并不只有“电子病历”。文本病历承载既往史、家族史、月经史、婚育史、现病史和出院经过;结构化表承载年龄、孕产次、身高体重、血压和就诊日期;实验室系统承载血常规、肝肾功能、糖化指标、甲状腺指标、凝血、感染筛查和妊娠相关生物标志物;医嘱和用药记录承载药物名称、途径、频率、剂量及开始时间;产科检查或超声报告承载羊水、估测胎重、腹围、股骨长和脐动脉血流等研究变量。
输出颗粒度需要在项目开始时分开定义。妊娠级输出用于GDM状态、诊断孕周、孕期治疗和分娩结局;母体级输出用于既往疾病和基础特征;检验事件级输出用于每一次采样与结果;药物事件级输出用于每一次处方、给药和调整;胎儿或新生儿级输出用于性别、出生体重、Apgar评分、NICU收治和新生儿并发症。把这些层级压成一行,会丢掉重复妊娠、纵向检测和多胎关联。
二、妊娠事件是纵向数据的主键,而不是住院号
常规医院数据往往按一次就诊或一次住院组织,但GDM研究的时间单位是妊娠。一次妊娠可能对应多次门诊、住院、检验、用药和影像检查;同一人也可能在不同年份存在多次妊娠。如果直接以就诊号拼接,研究者会得到多个互相割裂的“患者”,或者把两次妊娠的病史和结局错误合并。因此,数据模型至少应保留母体匿名键、妊娠事件键、就诊事件键、检查事件键和母婴关联键,并记录每个键的生成规则。
妊娠事件的起止并非总能从一个字段读出。末次月经日期可能缺失或被补录,分娩日期相对明确但不能单独证明早期检查属于哪一次妊娠,超声报告可能只写“孕周”而不含原始日期。工程上应把末次月经、检查日期、分娩日期、孕周文本和产科记录作为证据集合,按预先冻结的优先级重建时间轴;无法消解的冲突应保留冲突状态,并将证据来源交给专家仲裁,而不是悄悄选择一个日期。
孕早期、孕中期和孕晚期并不是装饰性分组。不同阶段可获得的检查不同,治疗暴露的含义不同,诊断标签也可能受检测窗口影响。WHO关于妊娠期高血糖的分类将孕期首次发现的高血糖区分为妊娠期糖尿病和妊娠期糖尿病以外的糖尿病,并对75克口服葡萄糖耐量试验的判定提出了明确框架。1 因此,数据字典必须写明采用哪一版标准、使用哪些阈值、如何处理早期检测,以及何时把“既往糖尿病”排除在GDM之外;本文引用该框架用于说明标签设计,不把它替代项目书面冻结的本地规则。
2025年WHO关于妊娠期糖尿病照护的更新也把血糖管理、孕期体重、胎儿监测和母婴结局放在同一照护链路中。2 对数据工程而言,这意味着“孕周”不仅用来做一个分类标签,还要决定哪些变量可以作为某一时点的输入、哪些变量只能作为后续结局。若研究目标是早孕预测,孕周冻结点之后才取得的诊断、治疗或分娩相关信息不能回流为早期特征;若研究目标是全孕期轨迹,则应保存事件顺序,而不是只保留最后一次结果。
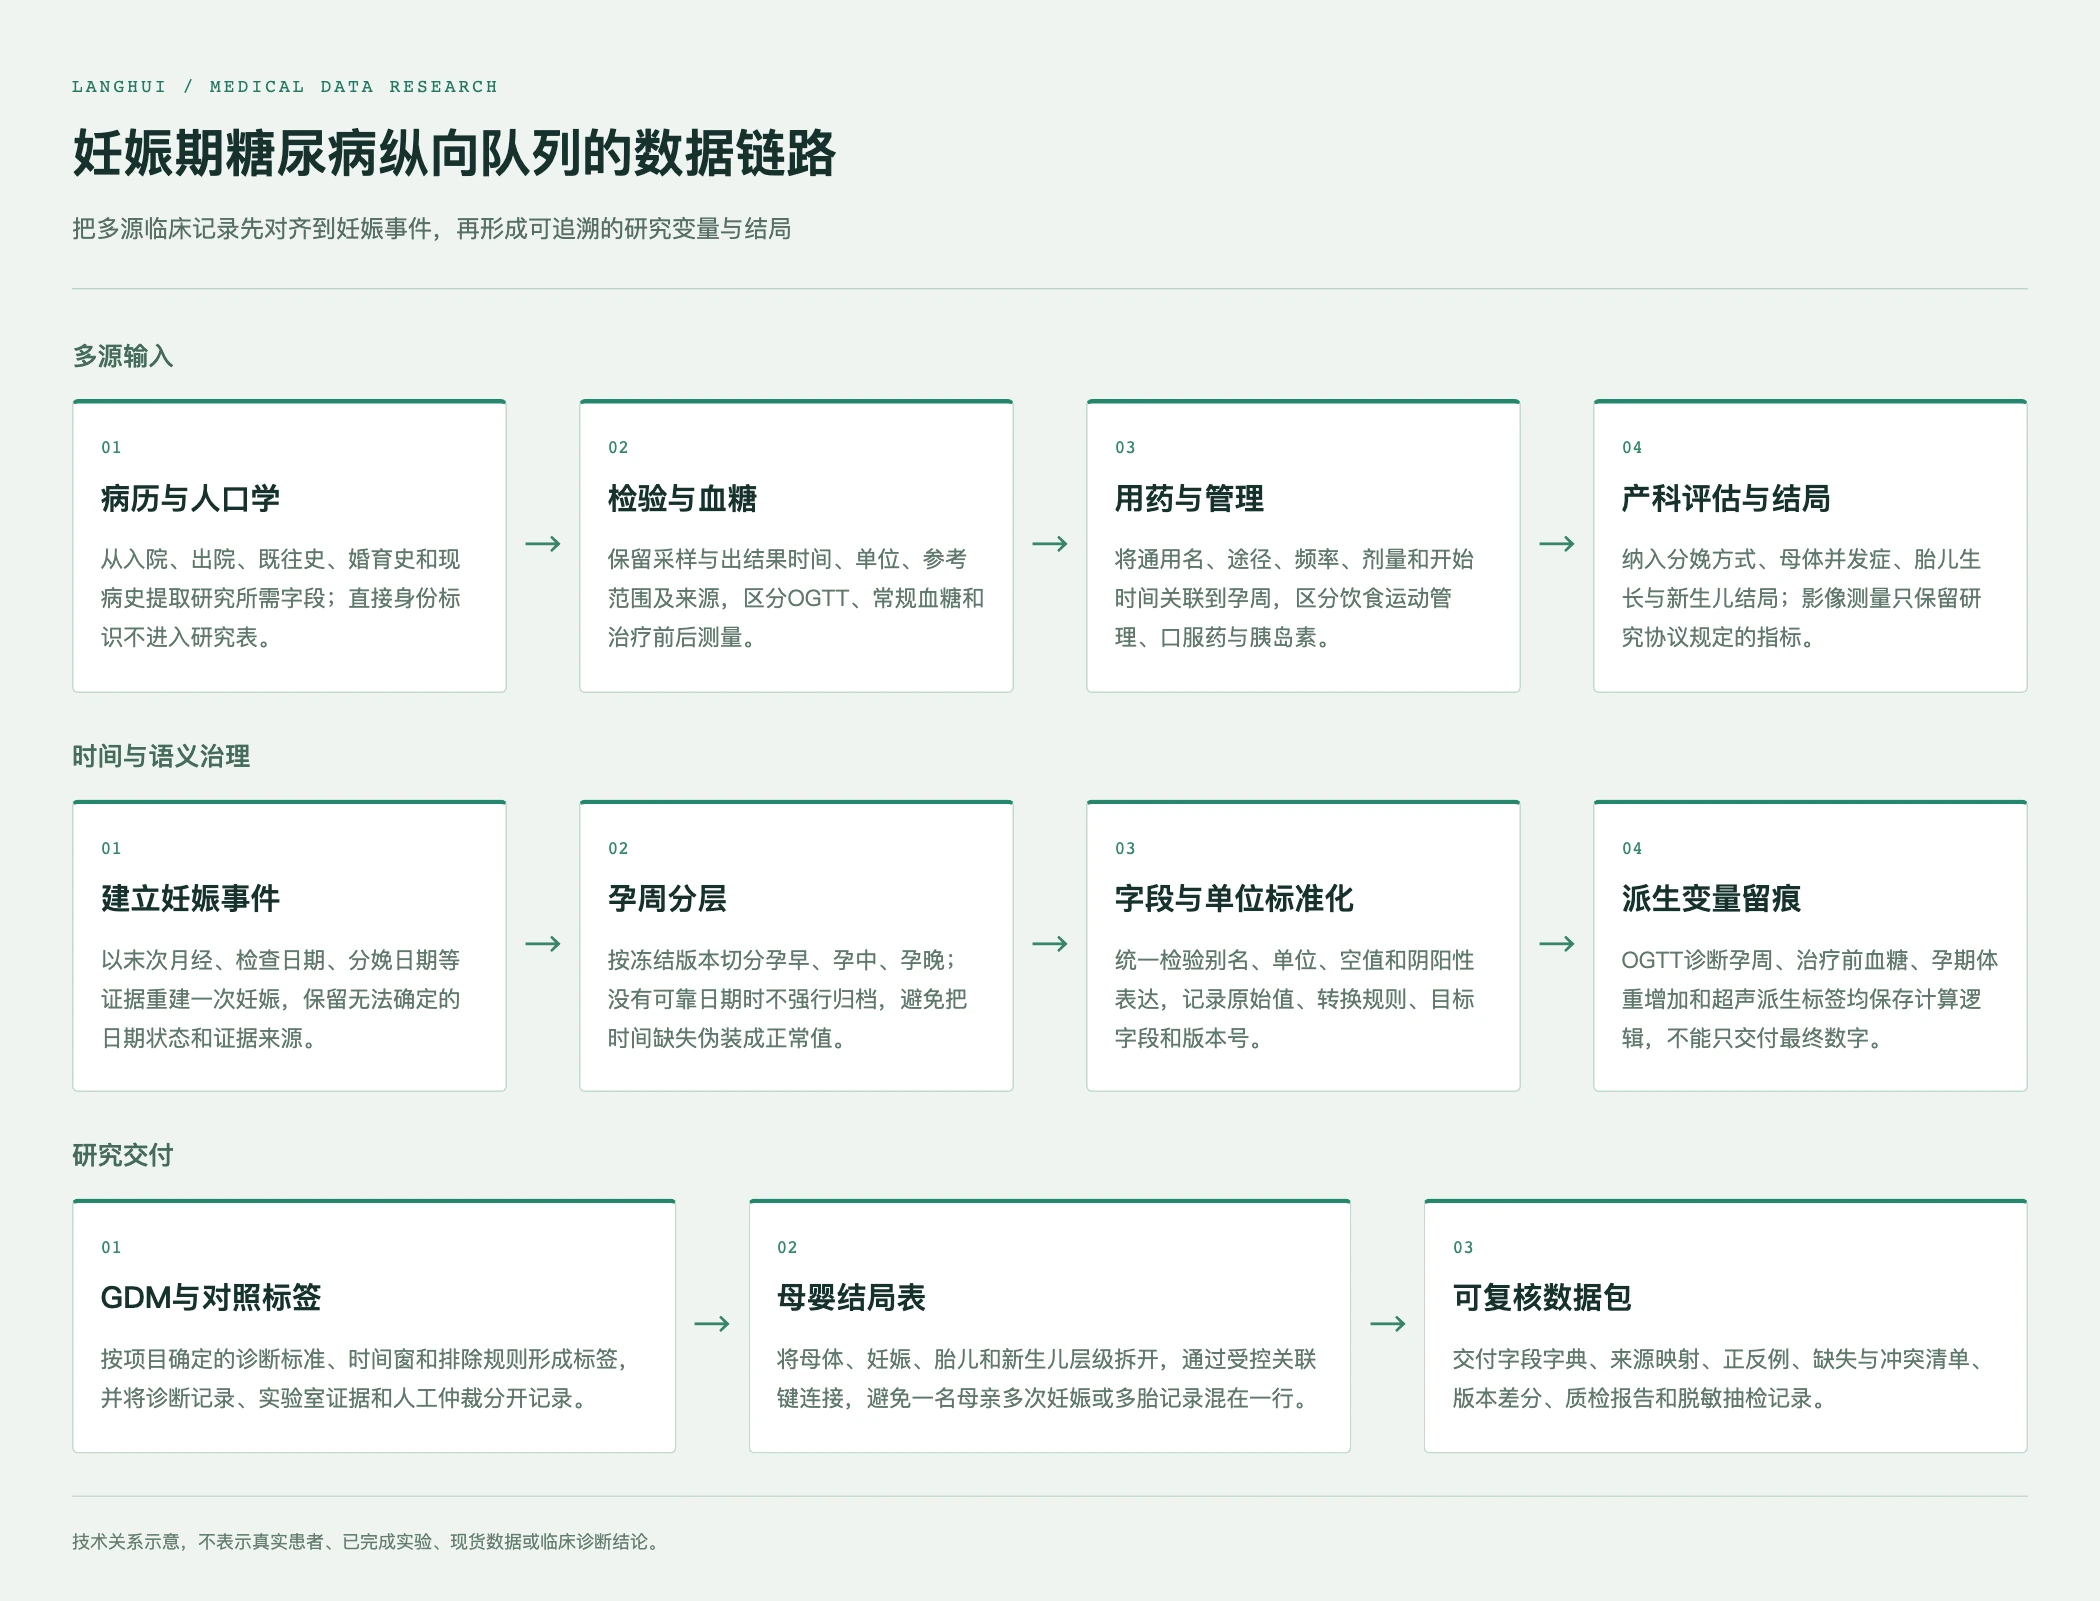
图1 妊娠期糖尿病纵向队列的数据链路。技术示意,不代表真实患者、现货数据或已完成实验。
三、变量设计要同时满足临床语义与机器可读
清洗表里常见的困难是同一临床概念拥有多个写法。例如红细胞压积与红细胞比容、谷丙转氨酶与丙氨酸氨基转移酶、尿素与血清尿素氮可能来自不同检验目录;OGTT的0分钟、60分钟和120分钟也可能以不同名称出现在检验系统或病历文本中。标准化不能只改表头,还要保存原始字段、标准字段、单位、转换关系、采样时间、出结果时间和来源系统,才能在复核时解释“这个数字从哪里来”。
实验室字段至少要带单位和参考范围,并将数值、定性结果、未检出、拒检、无法测量和未记录分开。横杠、空字符串、零值和“未查”不能混成一个缺失编码;阳性与阴性也不能被简单转成1和0后丢掉“检测是否发生”。在跨设备或跨批次研究中,单位换算、方法学变化和参考范围变化都可能造成表观趋势,应该在版本记录中体现,而不是等模型训练后才解释。
用药信息需要从药名扩展到药物事件。至少应保留通用名、给药途径、频率、剂量说明、开立时间、开始时间、停用时间和证据来源。孕激素、降压药、解痉药、早产抑制剂、促胎肺成熟药、抗凝或抗血小板药、甲状腺激素、抗生素、糖皮质激素和营养素补充的研究含义不同,不能只做一个“孕期用药是/否”。更重要的是,药物类别与孕周的关系必须可追溯:使用最早发生在哪一阶段、是否早于OGTT、是否在胰岛素前后,都应由事件时间计算而非凭最终诊断倒推。
血糖管理变量也不宜只做“达标/不达标”。研究表可以同时保留OGTT三点值、OGTT之后且在胰岛素前的血糖、二甲双胍治疗期间血糖、胰岛素治疗期间血糖、饮食控制、运动控制和定期监测情况。若项目使用临床阈值,应把阈值版本、测量时点和夜间低血糖规则写入方法学;不同指南或项目协议可能存在差异,公开文章不应把一套约定阈值包装成适用于所有场景的医学结论。
四、产科影像和母婴结局不能成为“附加列”
源需求中还包括基于产科超声或检查结果形成的羊水过多、胎儿结构异常、胎儿生长受限或估测体重等变量。这些变量不是普通数字字段。它们可能来自报告文本、结构化测量和手术记录,时间点与孕周密切相关;同一指标在孕中期和孕晚期的含义不同。工程规则应明确原始测量、来源文书、报告日期、孕周、单位和派生判定,避免把缺少报告的样本误标为阴性。
产科结局也应按母体、妊娠、胎儿和新生儿分层。分娩方式、妊娠期高血压疾病、子痫前期、胎膜早破、早产、肩难产和产后出血属于母体或分娩过程;胎儿性别、脐带绕颈、出生体重、巨大儿、低出生体重、大于或小于胎龄儿、胎儿生长受限属于胎儿层;新生儿低血糖、黄疸、呼吸窘迫和NICU收治属于新生儿层。分层后再用受控关联键连接,便于定义一个结局是“每次妊娠一次”“每个胎儿一次”还是“每个事件多次”。
某些结局依赖判定规则。例如产后出血不能只读一个数值,还要记录测量单位、分娩方式和项目使用的阈值;大于胎龄儿和小于胎龄儿需要孕周与出生体重共同解释;影像估测体重和出生体重不能混为同一个终点。数据交付中应同时提供原始证据、派生变量和计算脚本或伪代码,不能只提供一个看似完整的最终表。
五、算法路线应先保证证据链,再谈模型复杂度
这类项目的第一步通常不是训练深度网络,而是建立可审计的规则与数据血缘。规则层负责妊娠事件重建、孕周分层、字段映射、单位换算、时间窗和明显矛盾检查;信息抽取层负责从病历文本识别既往史、用药、诊断描述和产科结局;关联层负责把文本、检验、医嘱和影像测量绑定到同一妊娠。只有当这些中间产物可复核,才适合讨论分类、风险预测或多模态模型。
在文本抽取中,可以比较规则、词典、传统自然语言处理模型和临床语言模型,但模型输出只能作为候选或草稿。否定词、家族史、既往病史、待查、鉴别诊断和出院诊断的语义位置不同,简单的关键词命中很容易制造假阳性。抽取结果应保留原文片段位置、抽取标签、时间表达、否定或不确定状态以及人工复核结果;若原文证据不足,就输出未知,而不是让模型补齐一个“合理答案”。
GDM标签尤其需要多证据组合。诊断记录、OGTT、孕周、处方或胰岛素记录、临床团队维护的队列以及分娩资料可能互相支持,也可能彼此矛盾。可采用组件算法,把诊断、检验、用药和数据源特有变量分别定义,再用AND、OR和排除逻辑组成多个候选标签;每个候选标签都要有版本号,不能在分析过程中临时更换规则。
2025年BMJ Open的一项跨五个欧洲数据库研究显示,使用不同诊断、处方、出生登记和排除既往糖尿病逻辑,会得到明显不同的GDM患病率;研究还指出,其主要限制是多数数据库没有实验室结果,且该研究不是验证研究,不能据此得到灵敏度或特异度。3 文中这些跨数据库结果是研究方法的观察,不是本项目的患病率、标签阈值或公司数据。对本项目的启示不是照搬某个算法,而是把“标签如何形成”作为交付内容,并在本地数据上做参考标准核对。
已有研究也说明,电子病历中的GDM标签误差会影响模型评价。2025年一项三步回顾性验证研究将EHR标签与临床团队数据库对照,发现测试集中的标签噪声对评价指标的影响尤其明显。4 因此,训练集、验证集和测试集不能只记录文件名,还应记录标签版本、证据状态、排除原因和是否经过人工终审。
六、专家标注的对象是证据和规则,不是替模型做诊断
专家参与应从标签定义开始,而不是在算法已经完成后只抽查几条结果。产科、内分泌、临床研究或医学信息学专家需要共同确认:既往糖尿病与GDM如何区分,早期高血糖如何处理,OGTT缺一项时标签是什么,药物记录没有适应证时能否作为代理证据,妊娠日期不一致时哪一类记录具有优先级,产科影像指标缺失时如何表示。
双人独立复核可以减少“先看标准答案再标注”的从众效应。两位审核者先分别判断阳性、阴性、未知和冲突,再由仲裁者处理分歧;仲裁记录应指向具体文书、检验事件或医嘱事件。对于“医生写明待查”“报告提示可能”“患者自述曾经使用”等语气,应按研究协议保留不确定性,不能把临床叙述改写成确诊事实。
标注主体、审核主体和最终验收主体应分开记录。标注员可以完成字段抽取和初步映射,但涉及诊断边界、产科结局和时间冲突的样本应升级给相应领域专家。专家资质、培训版本、盲审方式、仲裁规则、抽检比例和返工状态都属于质量记录;它们不是公开稿中可替换成“高质量”三个字的宣传语。
七、把标签偏差、数据泄漏和外部验证写进验收
GDM队列质量至少有六个维度:来源和授权是否明确,患者和妊娠关联是否完整,字段和单位是否规范,时间线是否可复核,标签证据是否充分,输出是否已经去除直接标识符及残余识别线索。每个维度都需要失败原因,而不是只给一个总通过率。缺失、冲突、重复、异常范围和无法关联应分开计数,否则返工优先级无法确定。
患者级划分是防止泄漏的底线。同一母体的多次就诊、同一妊娠的不同检查以及同一胎儿的多个结局不能随机散落到训练和测试。若任务是早期预测,特征冻结在规定孕周之前;若任务是全孕期风险或结局分析,则应明确哪些后验变量仅用于结局定义而不进入输入。源需求中存在“最早一次”“治疗前一次”“每孕期一次”等选择规则,这些规则都应进入数据处理版本,而不是在建模脚本里隐式实现。
内部验收可分为字段级、记录级和队列级。字段级检查数值类型、单位、空值、范围和别名;记录级检查母体—妊娠—检验—用药—结局的关联键、时间顺序和冲突状态;队列级检查GDM与对照构成、孕周分布、缺失模式、中心或设备分布及标签来源。验收阈值应由项目书面约定,不能把外部论文中的准确率直接改写成公司承诺。
研究模型的评价还应至少包含时间留出、中心留出或设备留出中的一种独立设计,并报告外部样本的构成和缺失模式。2025年一项中国孕产妇早产风险研究使用后续时间段样本做外部验证,说明“独立时间段”可以成为验证设计的一部分,但论文中的AUC属于该研究任务和样本条件下的研究结果,不等于任何GDM项目的临床效果。5 对GDM项目而言,除区分度外还应看校准、阳性预测值、阴性预测值、分层表现和决策阈值,避免只追逐一个最高分。
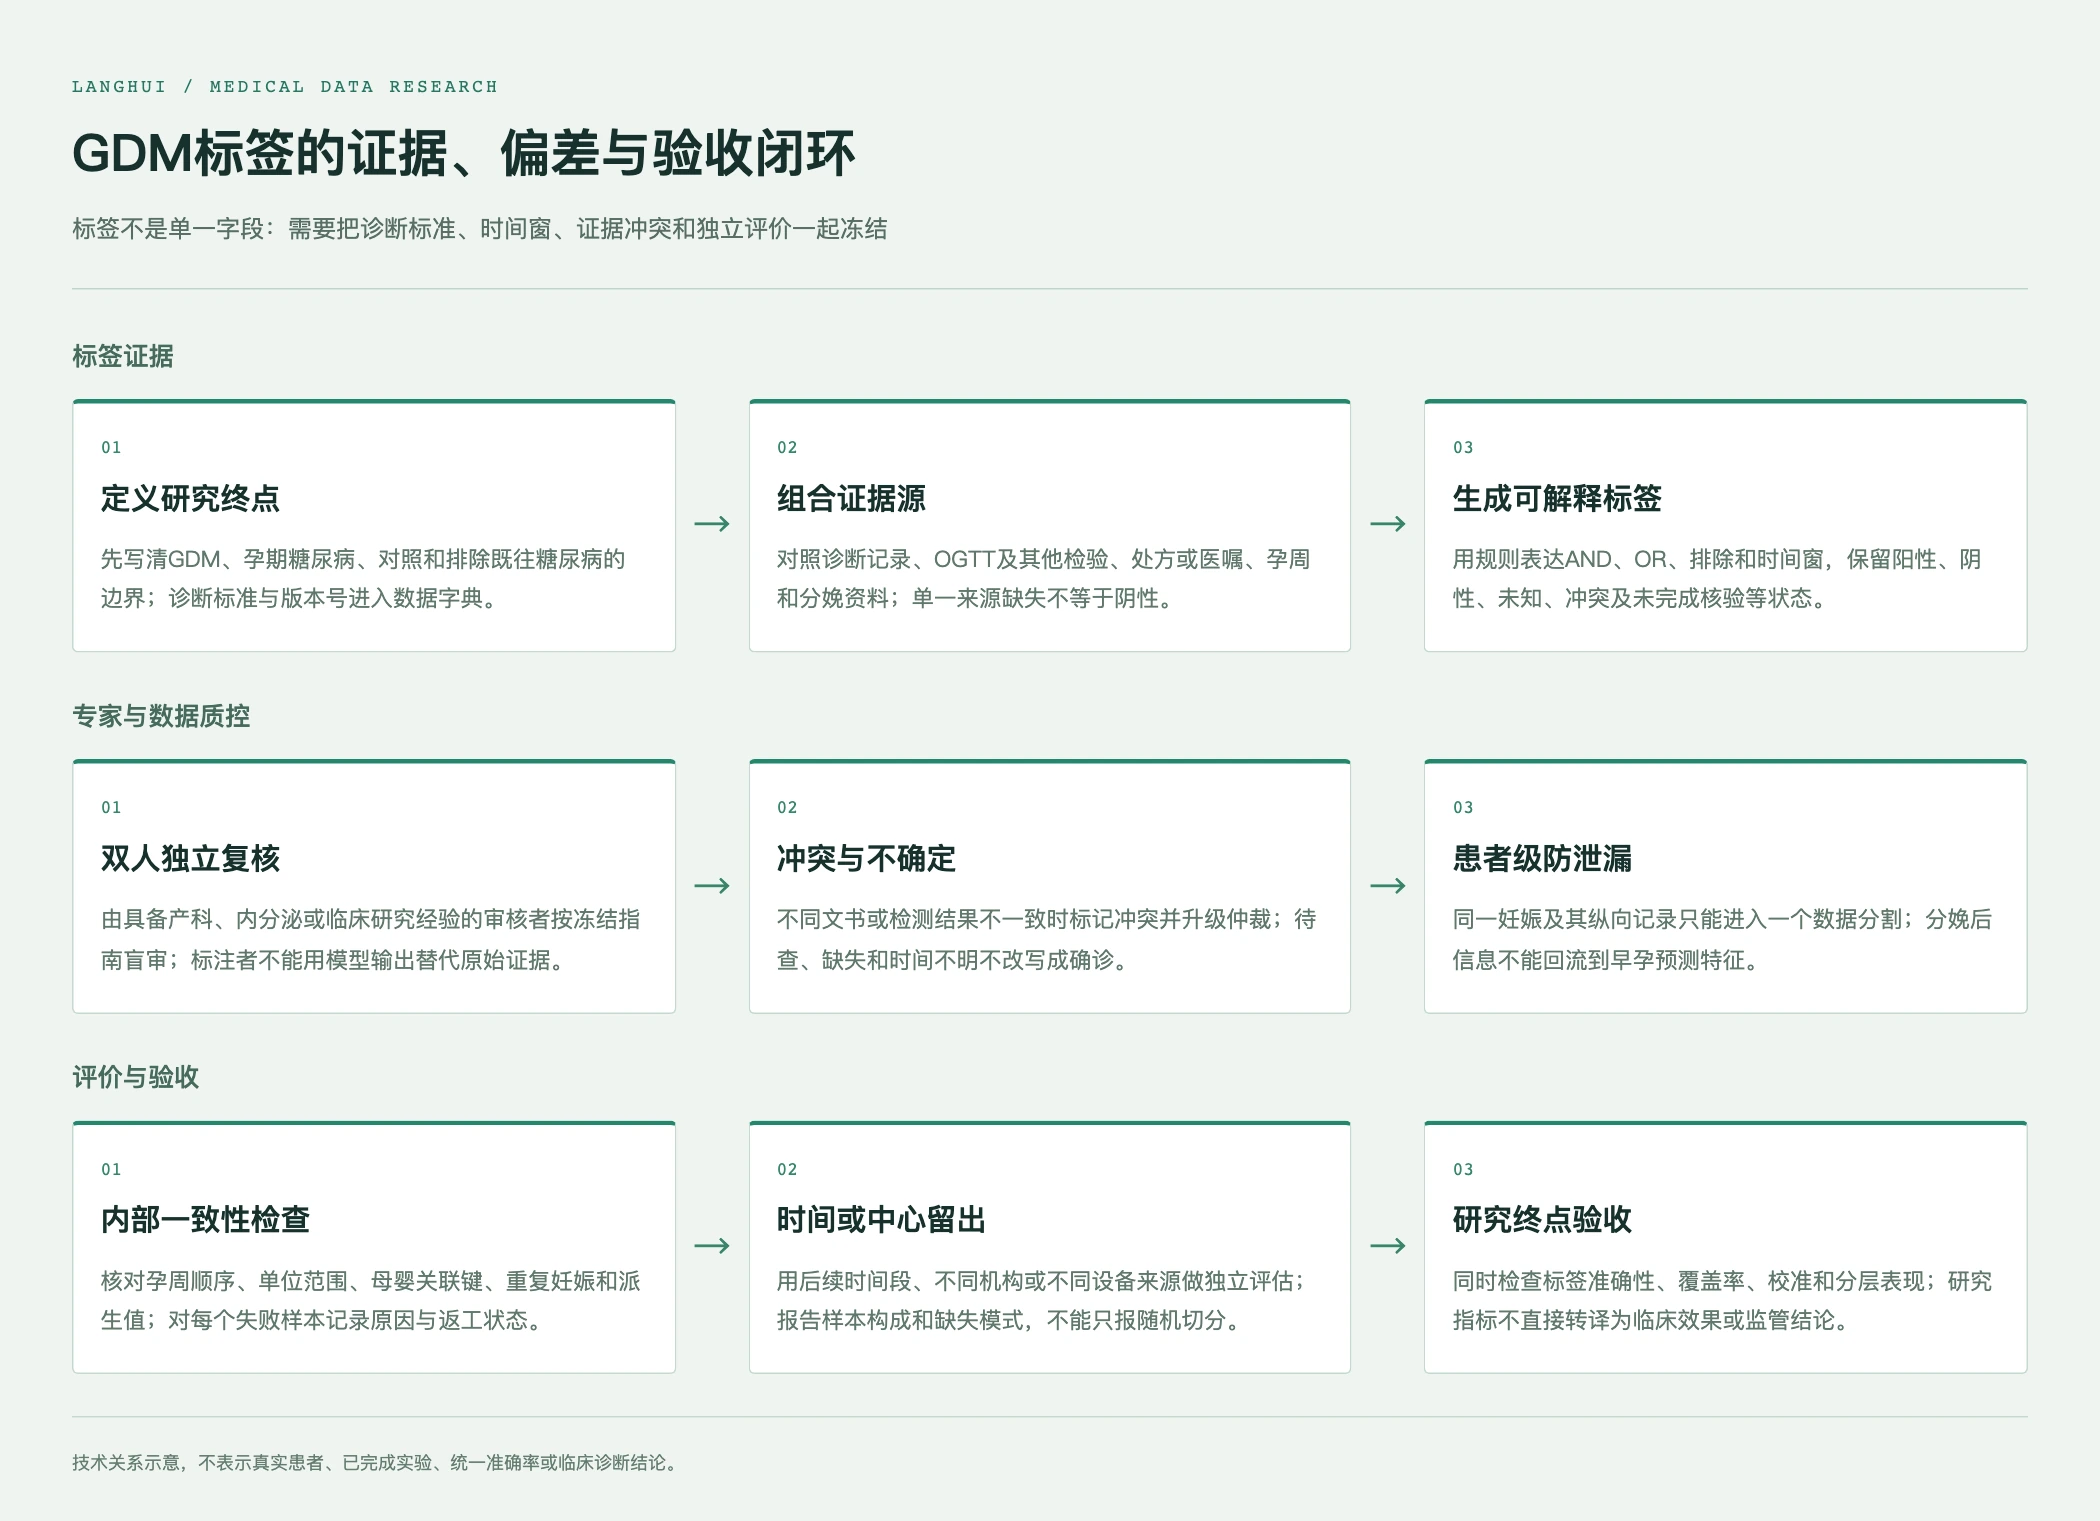
图2 GDM标签从证据组合、专家复核到独立评价的闭环。技术示意,不表示真实患者、统一准确率或已完成实验。
八、从数据包到研究可用资产的交付逻辑
一份可进入研究的交付物,至少应包括字段字典、来源到目标的映射表、文本抽取规则、诊断和结局算法、正反例与不确定例、缺失和冲突清单、版本号、变更记录、脱敏抽检记录以及能够在下游环境打开的样例。若使用派生孕周、孕期体重增加、治疗前血糖或超声判定,应一并交付计算逻辑和输入字段。这样算法团队才能区分“原始证据”“清洗值”“人工标签”和“模型特征”。
RECORD声明针对常规采集健康数据强调,研究需要报告数据类型、地区和时间范围、链接过程、队列识别算法以及代码或算法的验证情况。6 这套思路可转化为采购或项目验收语言:交付方不只说“有病历”,而要说明哪些数据源被使用、哪些字段通过何种规则进入、哪些字段无法公开或无法验证,以及不同来源关联成功与失败的数量和原因。
TRIPOD+AI进一步强调,训练数据与评价数据应在参与者层面独立,评价数据应代表目标使用人群,并需要报告区分度、校准、临床效用和公平性等要点。7 对本项目而言,这意味着数据治理规格应为后续研究预留标签版本、数据分割、时间留出和亚组分析,而不是等模型报告时再从压缩包里猜测这些信息。
FDA介绍的IMDRF良好机器学习实践原则把安全、有效和高质量放在全产品生命周期中,并提醒开发者面对AI/ML迭代和数据驱动带来的特殊风险。8 这并不意味着一个研究数据集已经获得任何监管认可,而是说明数据代表性、独立评价、变更记录和使用边界应从研发早期就被记录。文章中的验收建议同样不能替代伦理、授权、隐私和监管审查。
九、公司能力边界与业务落点
已核验的公司定位是AI数据基础设施和流程服务商,LangData覆盖采集、处理、标注、质检和数据交付,医疗栏目按部位、模态和任务组织数据目录与样例评估入口。这个能力边界适合承接需求梳理、字段映射、文本与结构化数据处理、专家复核和质量记录设计;它不自动证明存在现成的GDM专病库存、固定中心样本、统一专家规模或已经完成的临床模型。
因此,业务流程应从小规模脱敏样例开始。第一轮冻结研究目标、纳排标准、诊断标准版本、孕周算法和字段字典;第二轮用样例核对原始证据、派生逻辑和缺失状态;第三轮进行双人复核、冲突仲裁和患者级划分;通过后再决定是否扩展。样例评估期间发现的新标签、新模态、新验收指标或新的伦理授权要求,都应形成变更记录,不能用旧批次的结果代替。
对采购方而言,验收重点不应是“能否做出一张大表”,而是每个关键字段能否追溯到来源、每条标签能否解释、每个结局能否重算、每次规则变化能否定位、每个失败样本能否返工。对数据服务方而言,公开表达应限定在已核验的流程能力和项目规格交付,不展示未授权的病例、医院、供应商、数量、报价或经营信息,也不把研究性指标写成临床诊断承诺。
结语:把时间和不确定性当作数据的一部分
妊娠期糖尿病队列的价值,不在于变量数量堆得多高,而在于每个变量都能回答三个问题:它发生在这一次妊娠的哪个时点,证据来自哪里,经过什么规则才成为研究标签。孕周、OGTT、用药、血糖、产科评估和母婴结局只有在同一条可回溯时间线上,才可能支持可靠的表型研究和后续模型评价。
对研发团队来说,先建好妊娠事件、证据状态、标签版本和患者级划分,再选择规则模型、自然语言处理或多模态学习路线,通常比先追求复杂模型更能减少返工。对数据采购和质量团队来说,字段字典、样例、冲突清单、专家仲裁和独立验证不是交付附属物,而是决定数据能否被复用、复盘和外部验证的核心资产。该数据集可以支持研究,不等于能够替代医生诊断、治疗决策或监管审查。
参考来源
- Diagnostic criteria and classification of hyperglycaemia first detected in pregnancy
- WHO recommendations on care for women with diabetes during pregnancy
- Identification of gestational diabetes mellitus in European electronic healthcare databases: insights from the ConcePTION project
- Label Accuracy in Electronic Health Records and Its Impact on Machine Learning Models for Early Prediction of Gestational Diabetes: 3-Step Retrospective Validation Study
- Predicting the risk of preterm birth with machine learning and electronic health records
- The REporting of studies Conducted using Observational Routinely collected health Data (RECORD) Statement
- TRIPOD+AI statement: updated guidance for reporting clinical prediction models that use regression or machine learning methods
- Good Machine Learning Practice for Medical Device Development: Guiding Principles