
MEDICAL DATA RESEARCH
胃镜病灶多边形标注:从逐图像操作到可复现验收
胃镜病灶多边形标注如何从图像目录操作转化为可复用研发数据?本文拆解病灶轮廓、类型字典、阴性与不可判读状态、JSON导出、专家复核、数据划分和独立验收,并说明视频扩展需另行确认。
胃镜画面中的异常区域,为什么不能只靠“找到一张典型图片、画一个框、导出一个文件”来支撑医学人工智能研发?因为真正进入训练和评估的,往往不是一张孤立的图片,而是一次检查中的连续画面、不同质量状态下的可见区域、病灶轮廓、类别和标注依据。若图像或帧的位置、病灶边界、类别字段与复核状态没有被绑定,算法看到的就可能是互相矛盾的监督信号;若同一检查的相邻画面被拆入不同数据集,测试分数还可能被重复外观放大。胃镜异常区域的标注需求,因而应被理解为一项“逐图像空间标注加数据治理”的工程;只有在项目明确保留视频关系时,才扩展为逐帧时序任务,而不是某个软件按钮的使用说明。
本文围绕一类可匿名化的技术需求展开:以胃镜图像(或经项目确认的视频抽帧)为输入,在可判读的画面中沿异常区域边界绘制多边形,完成病灶类型选择,并支持逐图像检查、修改、删除、自动保存和结构化导出。若项目把输入扩展为连续视频,再另行确认抽帧、跨帧关联和时序验收规则。原需求本身没有提供病例结论,也不应被解读为某个模型已经完成训练或取得临床效果。下文把它改写为面向医疗AI研发、数据采购和质量管理读者的技术方案,重点讨论任务边界、数据对象、标注规则、模型路线和验收闭环。
一、先把“胃镜异常分割”写成可执行任务
第一步不是选分割网络,而是明确一条记录究竟代表什么。若输入是静态图像,最小样本单位可以是“图像—帧索引—病灶实例”;若输入来自完整检查视频,则至少还要保留“检查—视频—帧—病灶实例”的层级。检查级ID用于去重和数据划分,视频或序列级字段保留时间关系,帧级字段描述画面质量和所见,病灶级字段才承载多边形、类别及其复核状态。四个层级混成一个文件名或一张表,后续就难以区分同一病灶在相邻帧中反复出现,还是多个病灶被误合并。
临床任务也要避免一句“标异常”包打天下。一个可执行的项目规格应说明:模型是做病灶定位、病灶实例分割,还是同时预测病灶类型;输入仅包含常规白光,还是还包括窄带、放大或其他增强模式;输出是边界多边形、像素掩膜、边界框,还是几种标注并存;类别是按项目规定的异常类型划分,还是只设一个“疑似病灶”类。影像可见的形态标签、来自报告的判断和病理或随访等外部证据,不应在入库时自动合并成同一字段。对于缺少充分依据的画面,应允许“未知”“不可判读”“待复核”等状态存在。
源需求强调在病灶边界上连续点选并形成多边形,完成后选择病灶类型,并且每个层面都需要标注。这些信息至少对应四个验收对象:轮廓几何是否闭合且与原图同坐标;类别是否来自冻结的字典;逐图像(视频项目则为逐帧)或逐层的完成状态是否可核对;导出文件是否能在下游程序中还原。软件支持撤销、编辑和删除,并不等于研究数据自动具备版本治理;修改前后的轮廓、修改原因、复核者和规范版本仍需被记录,才能解释训练标签为什么发生变化。
如果项目目标进一步升级为视频模型,帧与帧之间是否属于同一病灶必须另行定义。仅仅对每一帧分别画多边形,并不能推出跨帧实例ID、病灶轨迹或时间连续性。对于病灶暂时离开视野、被黏液或器械遮挡、画面失焦以及不同增强模式切换的情况,应明确是标作不可判读、保留上一帧关联、重新建立实例,还是不纳入该任务。没有这条规则,就不应把帧级轮廓包装成完整的时序真值。
二、数据设计:从图像文件夹走向可审计对象
一个适合研发的数据对象,不应只有原始图像和一个同名JSON。更稳妥的结构是把原始媒体索引、帧元数据、质量状态、病灶实例和审核记录分开组织,再用稳定ID关联。原始媒体层可保留文件校验值、采集模式、分辨率、帧率或抽帧策略等与任务有关的信息;帧层记录帧号、相对时间、解剖或检查阶段(如果项目规则需要)以及是否可判读;病灶层记录实例ID、类别、轮廓坐标和可见性;审计层记录标注版本、角色、动作和回修状态。所有字段都应有缺失和不适用编码,不要让空字符串同时表示未知、阴性和尚未处理。
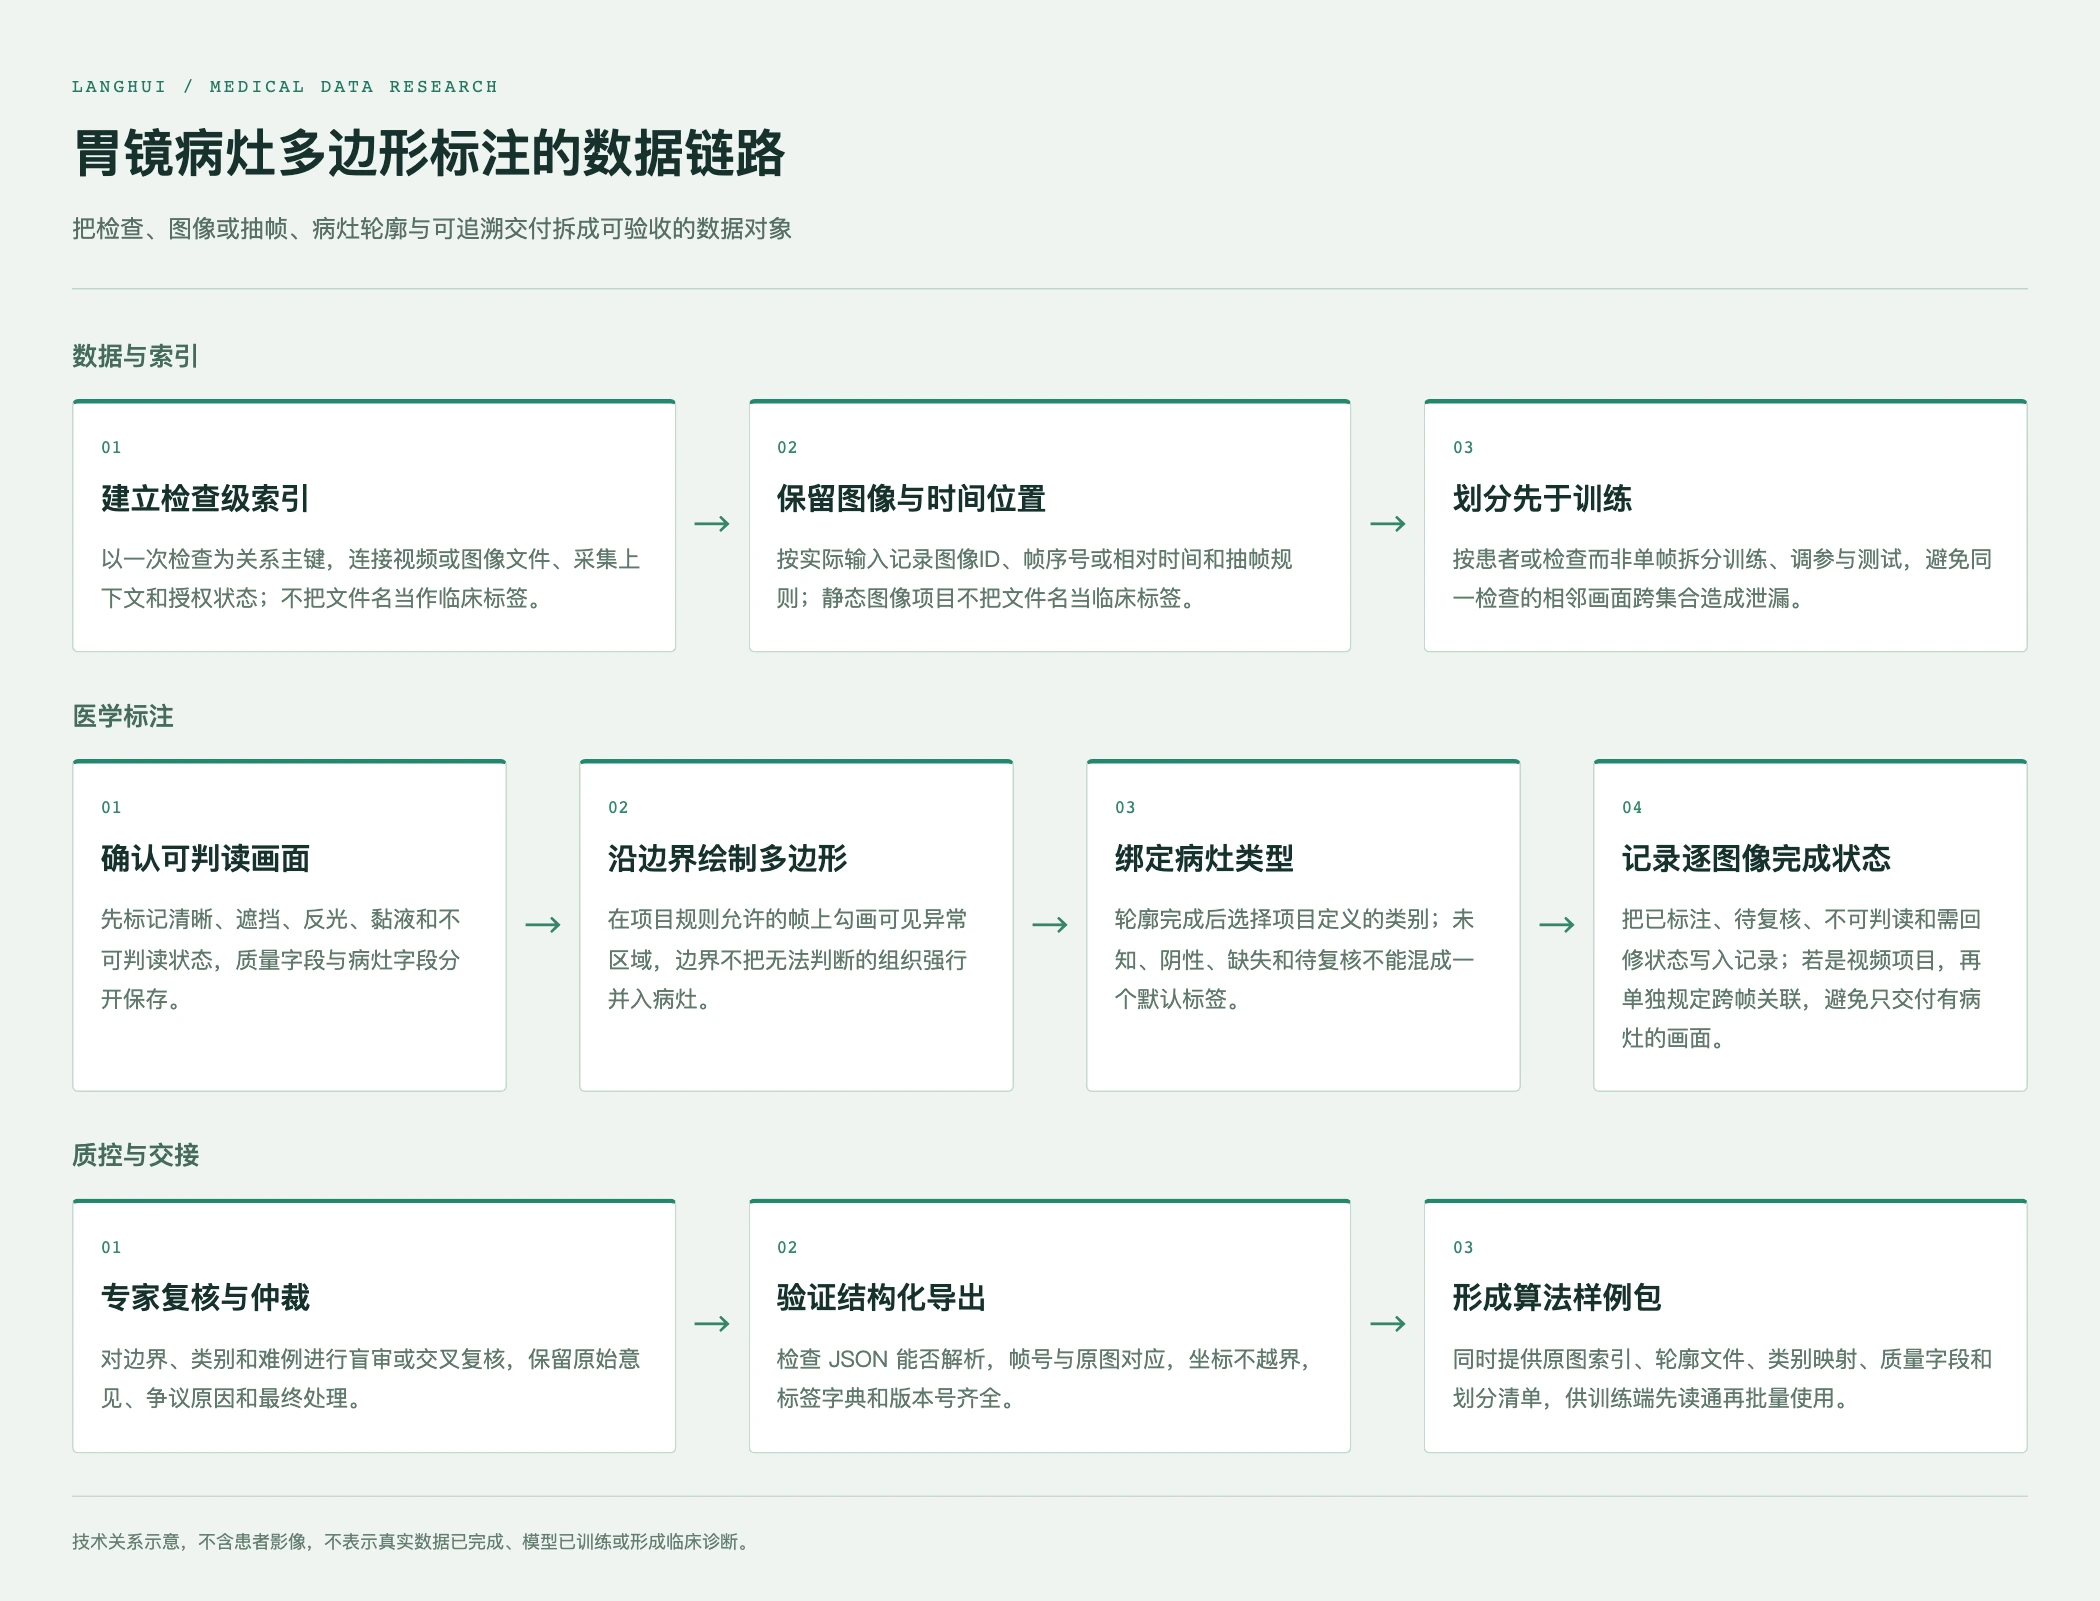
图1 胃镜病灶多边形标注的数据链路技术示意。图中关系用于说明数据对象和验收顺序,不含患者影像,不表示真实数据或模型结果。
结构化导出的价值不在于文件后缀本身,而在于数据能否被另一个程序正确读取。JSON可以保存图像或帧的引用、类别字典、点列和状态,但项目仍应写清坐标原点、宽高方向、是否经过缩放、点列顺序以及多个多边形如何表达。一个病灶有孔洞、多个互不相连区域或边界需要标记为不确定时,不能靠不同标注员自行发明字段。若下游训练端只接受二值掩膜,也要保留从多边形转换到掩膜时使用的栅格化规则和版本,避免同一轮廓在不同工具中产生不同像素结果。
“每个层面都要标注”在静态图像项目中通常意味着纳入的图像不能只挑出阳性画面;在视频项目中还需要把检查内帧覆盖率、抽帧规则和排除原因写进数据卡。若项目以关键帧为单位,则要说明关键帧由谁选择、选择依据是什么,以及未被选择的相邻帧是否仍然作为阴性或不可用样本。公开数据集的实践说明了这种选择会改变任务含义:GastroHUN将完整系统筛查流程组织成序列和代表性帧,并按检查站位设置类别;研究者同时报告了数据划分和分类验证框架,而不是只展示几张好看的图片1。这并不意味着其他项目应照搬其站位或类别,而是提示数据字典要把“代表性画面”与“完整检查覆盖”区分开。
视频采样还会影响训练样本的相关性。Renji内镜黏膜下剥离视频数据集把视频降采样到每秒一帧,并按手术阶段记录帧级标签;研究采用两名标注者初始独立标注,再由有经验的内镜医师进行质量控制,同时明确指出单中心和设备条件限制2。对病灶分割项目而言,这带来两个具体提醒:第一,抽帧频率不能只由存储成本决定,还要匹配病灶出现、遮挡和消失的速度;第二,逐帧数很多不等于检查数很多,统计样本时应同时报告检查、视频、帧和病灶实例等不同单位。
数据划分必须在模型训练之前冻结,并以患者或检查为更高层级保持互斥。相邻帧外观高度相似,如果一部分进入训练、一部分进入测试,模型可能只是在识别同一检查的纹理或设备特征。即使任务只使用静态图,也要调查同一检查导出的重复图片、同一病灶的多视图和重复保存文件。划分清单应保存随机种子、纳入排除规则、各类别分布和无法划分样本的处理理由。若项目要宣称跨设备或跨机构泛化,则还需预留真正独立的外部测试数据,不能把同一来源的随机留出叫作外部验证。
三、标注规则:轮廓、类别与不确定性要分层
多边形标注的第一原则是“只表达可由当前画面支持的边界”。当异常区域边缘清楚时,点位应沿可见外缘分布,避免把无关黏膜、反光或器械边缘纳入;当边缘模糊、被遮挡或受清晰度影响时,应根据指南使用不可判读或边界不确定状态,而不是用经验把缺失部分补成确定轮廓。小病灶、扁平改变、颜色差异和轻微凹凸可能需要不同的边界规则,项目不应只用“尽量贴边”四个字代替示例和反例。
类别选择也需要建立层级。病灶类型字段应服务于明确的研究问题,类别过多会放大标注者之间的语义分歧,类别过少又会把具有不同临床含义的对象混在一起。更稳妥的做法是把“画在哪里”和“它属于什么”分成两个步骤:先判断画面质量与区域可见性,再决定是否形成病灶实例和选择类别。来源不同的证据应保留来源字段,例如直接可见、报告语义、病理关联或专家复核;不能把报告中的“考虑”自动转成影像轮廓的确定类别,也不能把取材结果扩展为整张图的标签。
阴性和不确定样本对分割项目同样重要。只交付有多边形的帧,模型就难以学习“无目标”画面,也无法评价误报;把模糊画面全部删掉,又会让测试集避开真实工作流中的困难条件。建议在帧级设置明确的状态集合,例如明确未见目标、目标可见、目标疑似但不可可靠勾画、画面不可判读和缺失。这里的“阴性”只表示在规定任务和质量条件下未发现目标,不等于患者没有任何疾病。状态集合须与项目的临床任务相匹配,并由专家确认定义。
标注顺序和软件操作可以服务于一致性,但不能替代医学规则。先完成试标,再让标注人员使用撤销、节点编辑和删除功能处理边界,能够较早发现类别定义不清、边缘反光处理不一致和多病灶拆分原则不一致等问题。试标记录应包含问题示例、规则修改、旧版标签如何处理以及何时冻结新版本。对于已经进入训练的数据,规则变更不能静默覆盖;应让算法组知道哪些样本被回修、哪些样本因新规则被排除,以及旧模型结果是否仍然可比较。
四、算法路线:把帧级分割与临床可用性分开
从研发角度,适合这类需求的路线可以分成三个层次。第一层是帧级基线:使用语义分割或实例分割模型输出区域掩膜,再把掩膜转换为可编辑多边形进行人工核查。U-Net、DeepLab系列或轻量化编码器—解码器可作为方法学基线,具体选择应由输入分辨率、病灶大小、类别数量和部署约束决定;网络名称本身不能代替任务定义,也不能承诺某个固定性能。
第二层是病灶级建模:当一张画面可能包含多个异常区域,模型需要区分实例ID,分别输出位置、轮廓和类别。对于极小、边界弱或形态变化大的目标,应同时观察像素指标和病灶级检出,而不是只报告平均Dice。边界偏移一两个像素对大区域和小区域的影响不同,项目可根据目标用途增加边界距离、对象召回、误报率和按病灶大小分层的结果。所有指标都应说明参考标准来自哪一版标注、统计单位是帧还是检查、是否按病例聚合以及不确定样本如何处理。
第三层才是时序扩展。如果项目真正保留了帧间关系和可靠的病灶实例关联,可以考虑利用相邻帧的特征、光流或时序平滑,减少预测闪烁,并对进入、离开和暂时遮挡设置状态机。若原始数据只是逐张图像且没有可信的时序ID,就不宜直接加入时序损失,更不能把连续文件名当成临床时间轴。任何从帧级标注推导轨迹的步骤,都需要在方案中说明推导规则、失败处理和人工复核范围。
预处理和增强也要受医学语义约束。亮度、对比度、轻微旋转和尺度变化可在不改变标签含义的前提下用于训练;过度模糊、镜像、颜色重映射或合成遮挡可能改变病灶外观与成像模式,必须通过试验确认不会把不可见区域伪造成可见区域。不同设备、光源、白光和窄带模式之间的差异,应在数据分层和外部测试中显式呈现。一个在单一采集链路上表现良好的分割模型,不等于能在其他设备、操作者和人群中保持相同表现。
真实研究也提醒我们,速度和分割分数必须限定在实验设置内。胃肠化生实时语义分割研究使用经组织学证实的图像,并按白光和窄带成像划分训练、验证和测试集,报告了内部测试的mIoU和推理速度;这些是该研究条件下的算法结果,不是临床效果或注册结论3。因此,项目验收可以把推理延迟、显存和输出稳定性列入工程指标,但不能把“实时”直接等同于“可用于临床诊断”,也不能用研究中的分数替代本项目的独立测试。
五、专家标注与偏差治理:把难例留在数据里
标注主体应由熟悉胃镜图像的医学专家参与规则制定、试标和争议仲裁,经过培训的标注人员可承担按指南执行的初标,但不能让软件使用熟练度决定医学标签。建议建立初标、复核和终裁三种角色,并在可能的情况下采用盲审或交叉审核,使复核者先依据原图和指南作出判断,再查看前一轮轮廓。不同角色的职责、允许修改的字段和最终责任人,要在项目规格中写清。
一致性不能只用一个汇总比例表示。对于类别,可按检查或病灶统计混淆;对于轮廓,可报告IoU、Dice或边界误差,但要说明抽样层级、参考轮廓的形成方式和无法判读样本的处理。对于多病灶画面,还应核查实例拆分与合并;对于视频,则要检查相邻帧的关联是否出现跳变。任何阈值都应在试标后结合任务风险确定,不能在看到结果后挑选最有利的口径。
困难样本要被分层而不是被删除。反光、黏液、气泡、出血、器械遮挡、运动模糊、曝光变化和不同成像模式都可能影响边界;它们既是标注质量的挑战,也是模型部署时可能遇到的域变化。数据说明中可设置质量等级和排除原因,报告各层级样本的数量与表现。若某些画面确实不能可靠判断,应让“不可判读”成为可追踪的结果,而不是强迫专家在阴性和阳性之间二选一。
偏差还可能来自采样和证据。若数据只收集已经被标记为异常的图片,模型会缺少完整检查中的正常背景;若所有图像来自单一设备和单一操作流程,模型可能学到设备边框、色彩或压缩模式。若只有少数病灶类型得到高质量多边形,类别之间的标签噪声也会不对称。质量报告至少应交代来源范围、检查和帧的统计单位、设备或模式分布、可判读比例、类别分布、缺失字段、复核比例和外部数据差异。
六、从像素指标到独立验收:建立两条证据链
分割项目的验收应同时覆盖“文件是否可用”和“模型是否适配任务”两条证据链。文件链先核对每个媒体索引是否可定位,帧号或图像ID是否能回溯,JSON能否解析,点列是否闭合,坐标是否越界,类别是否在字典内,状态是否完整,修改历史是否可读。对抽样样例,还要在目标训练工具或可约定的下游程序中打开原图与轮廓,确认缩放、旋转、颜色和坐标系统没有错位。只核对文件数量,不能证明数据可训练。
模型链则需要在冻结的参考标准和划分上执行。内部测试应按实际数据单位报告图像或帧级、病灶级和检查级结果,避免大量相邻帧让一个检查被隐性加权;病灶级检出应与像素重叠分开;不同质量层、不同成像模式、不同病灶大小和阴性画面应有分层结果。对于新来源数据,外部测试要说明来源差异、设备差异、标签字典是否一致,以及是否发生再校准或重新标注。没有外部测试时,应把这一点写为限制,而不是用内部留出结果暗示跨域可靠性。
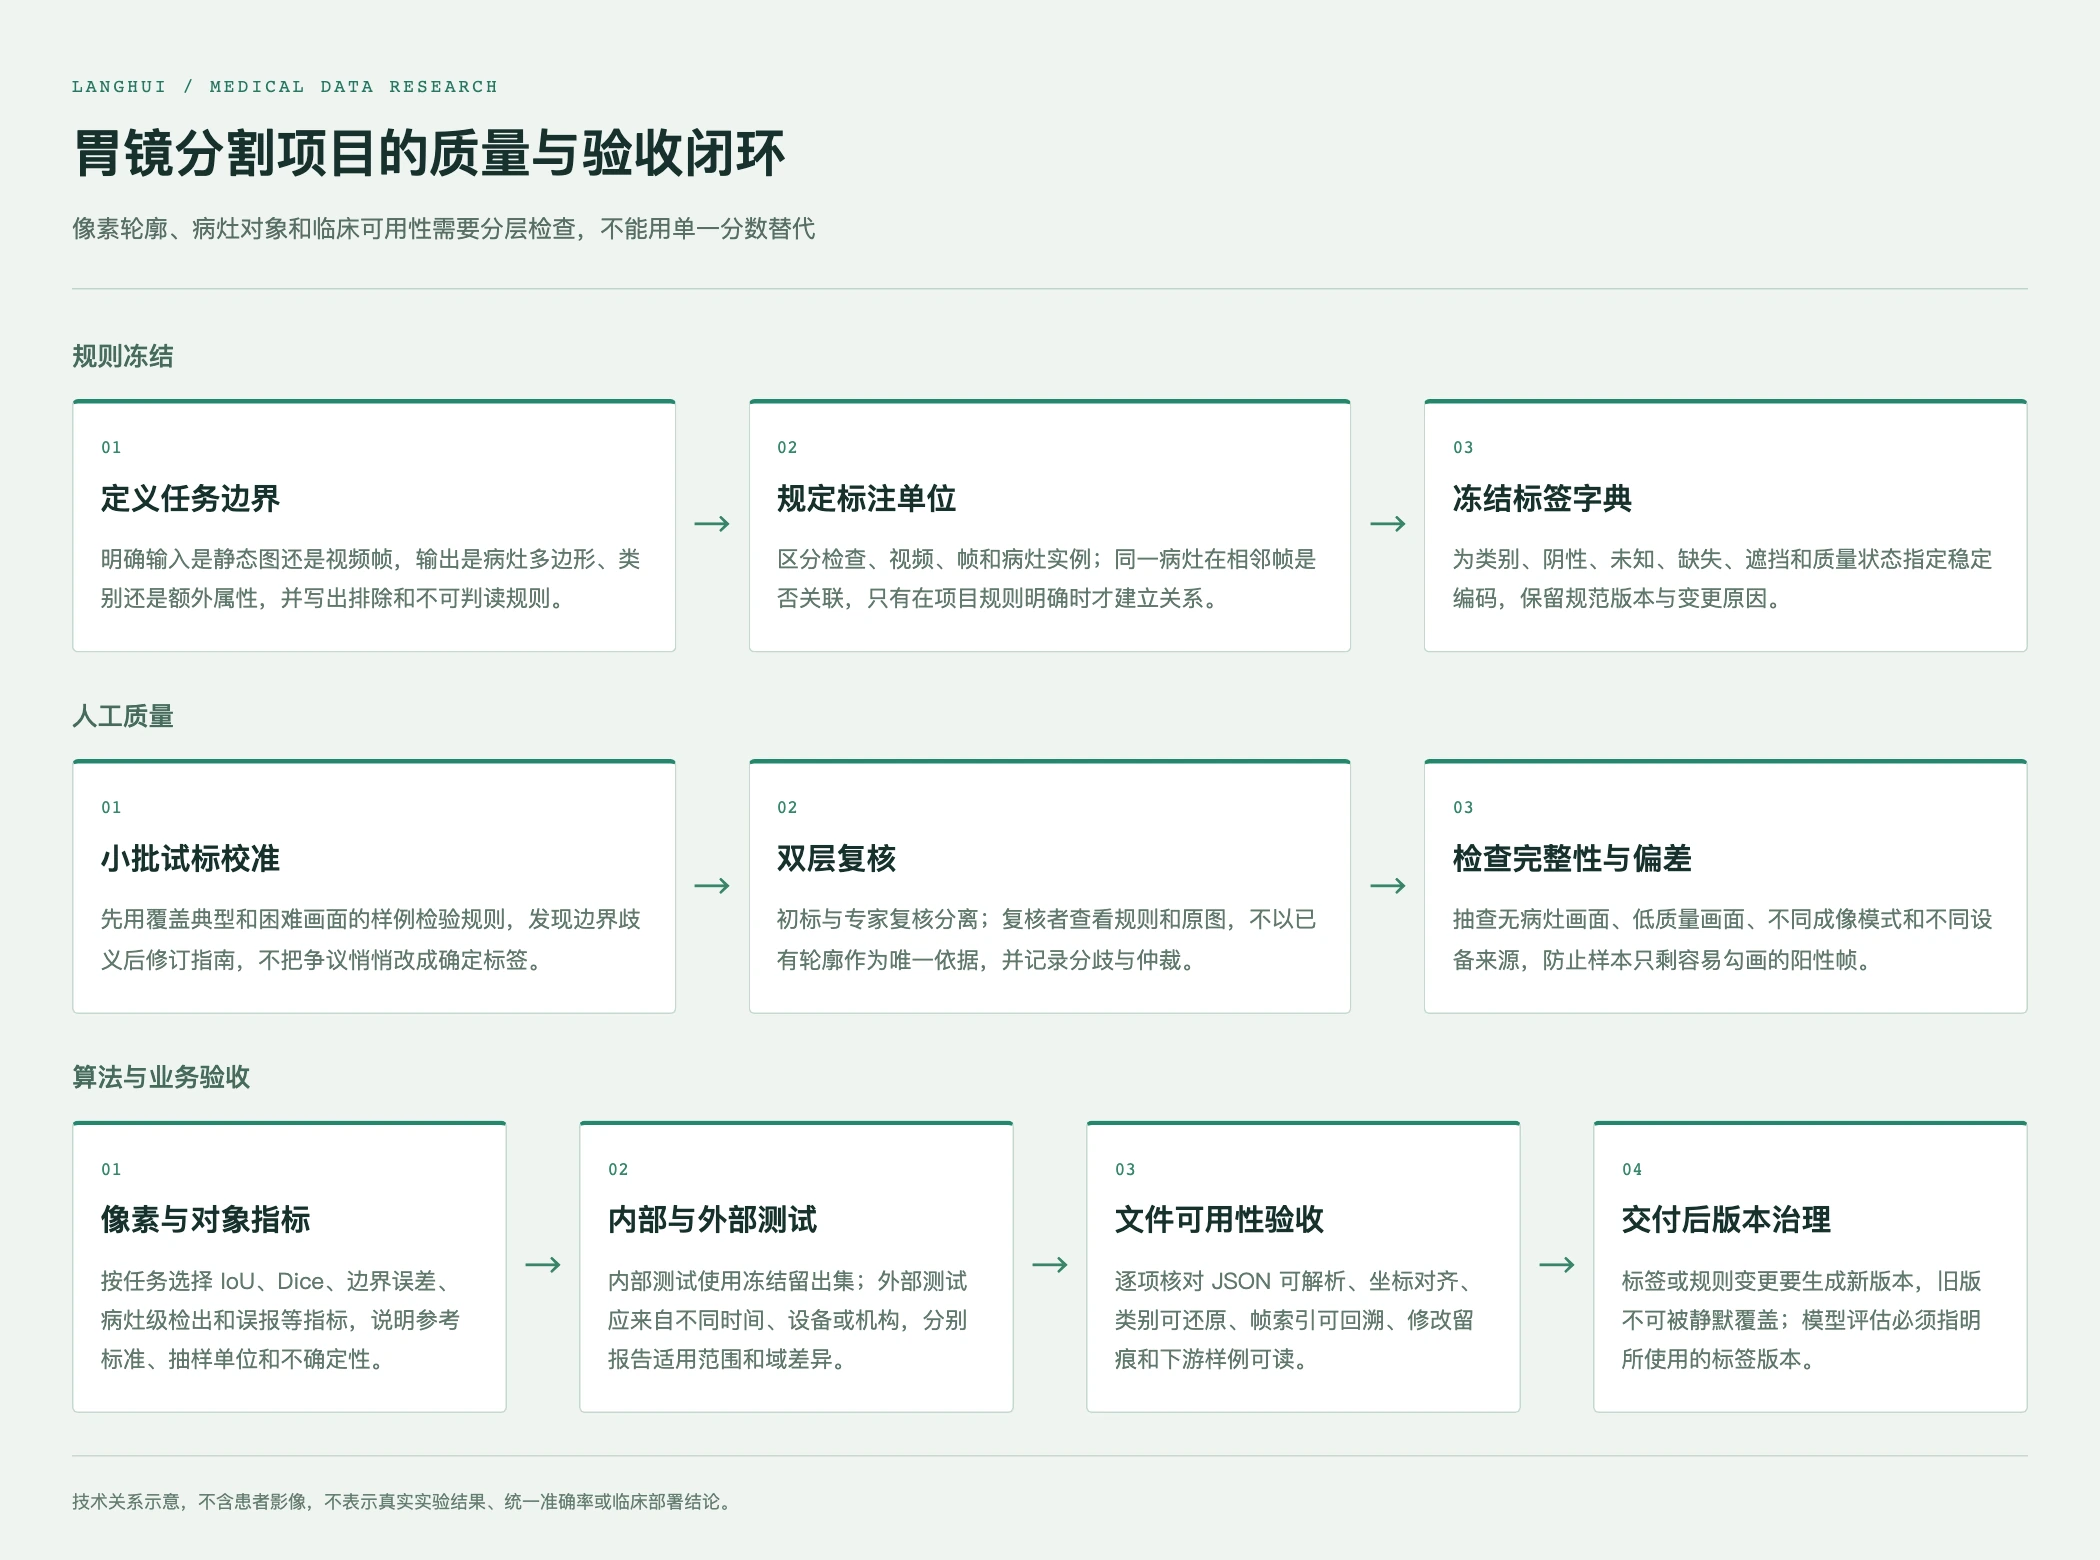
图2 胃镜分割项目的质量与验收闭环技术示意。图中指标、复核和文件检查是建议的工程关系,不含患者影像,不表示真实实验结果或临床部署结论。
临床相关的接受标准还不能由分割分数单独决定。ESGE关于胃肠道人工智能的立场声明提出,涉及上消化道检查完整性和解剖地标识别的AI应用,应与有经验内镜医师的水平进行可比性考察,并提出相关地标自动识别和影像记录的接受要求4。这类要求说明,临床任务的“完整检查”“异常发现”和“关键地标记录”可能需要过程级指标;一个只在精心挑选静态帧上输出漂亮轮廓的系统,不能自动转换为完整检查质量工具。
2025年更新的ESGE上消化道内镜质量改进框架,则可作为把关键解剖部位、异常发现和影像记录纳入过程质量字段的参照6。对数据项目而言,最实际的做法不是把指南阈值照搬为公司承诺,而是把与研究问题有关的过程字段、纳入排除、影像完整性和复核证据写进数据卡,并在项目书面规格中确认其适用范围。数据建设验收与医疗器械性能评价、临床试验和监管审查仍是不同工作,不应混写。
研究报告的透明度也应被当作交付的一部分。CLAIM 2024更新建议用“参考标准”而不是暗示绝对真值的“金标准”,区分内部测试与外部测试,并披露参考标准来源、标注者人数与资格、标注软件、分歧处理、数据划分层级、测试集规模、外部数据和限制5。这与逐图像多边形项目及其可能的逐帧扩展直接相关:如果轮廓只是单一标注者的初稿,就不应在文章中称为无误差真值;如果测试帧来自训练检查的相邻片段,也不应把它称为独立测试。
七、业务落地:把需求、能力和建议路线分开
对采购方而言,项目启动可以拆成“任务确认—小批试标—规则冻结—批量标注—多角色质检—结构化交付—训练端验证”七个阶段。第一阶段确认输入模态、检查与图像/帧的单位、输出字段、类别数量、是否需要逐图像覆盖;若输入是视频,再确认是否需要逐帧覆盖、病灶跨帧关联和时序验收;同时确认外部证据是否纳入以及授权和脱敏边界。第二阶段用覆盖正常、异常、低质量和边界争议的样例检验规则。只有小批样例能被医学专家和算法人员共同读懂,才适合扩大批量。
交付清单不应只写“图片加标注”。更可执行的清单包括原始媒体索引、帧索引和抽帧说明、类别与状态字典、多边形或掩膜、版本号、修改记录、质量分层、数据划分、校验值、问题单和一个能被下游工具打开的样例包。若选择JSON作为轻量交换格式,需同时交付字段说明和示例;若后续转换为掩膜、COCO或其他训练格式,应记录转换程序或规则版本。这样,研发团队可以追溯数据生成过程,而不是在模型训练失败后重新猜测标签含义。
朗慧科技已核验的定位是AI数据基础设施及流程服务商,能力边界包括围绕项目规格开展数据处理、标注、质量记录和数据交付;这些定位支持的是需求分析和项目化执行,并不证明某一胃镜视频数据集已经现货存在,也不证明某个模型已经获得临床批准。尤其是视频、具体专家配置、私有化部署、接口、周期和验收阈值,都应以样例评估和书面项目规格为准,不能从通用影像平台的描述推导出默认支持。
如果研发团队只需要训练数据,重点应放在轮廓可复现、类别字典稳定、阴性与不可判读状态清楚、划分无泄漏和外部测试可执行;如果还要开发检查质量或实时辅助工具,则应增加完整检查级、时间稳定性、地标记录和人机交互的评估。两种需求可以共享部分数据基础,但不能用一套静态病灶多边形验收替代另一套临床流程证据。把业务目标拆开,反而能避免在早期采购时把尚未确认的功能、部署条件和临床评价混进同一个模糊包。
结语:让每个多边形都能回答“从哪里来、为何如此、能否复现”
胃镜病灶分割的核心不是把异常区域画得越复杂越好,而是让每个输出都能回到一个明确的问题:它来自哪次检查、哪张图像或哪一帧、以及哪种成像条件;它代表哪一个可见病灶;边界和类别依据哪一版规则;由谁标注、谁复核、发生过哪些争议;它是否被正确划分,并能否在独立数据上接受检验。逐图像多边形、病灶类型、质量状态、版本记录和JSON交付,若扩展视频再加上明确的逐帧关系,只有被放进同一条可审计链路,才会从软件操作步骤变成可复用的研发资产。
对于医疗AI数据采购者,最值得在合同或项目书中提前写清的,不是一个脱离任务的统一准确率,而是标注单位、纳排条件、专家职责、难例编码、抽样和回修方式、内部与外部测试边界,以及训练端打开样例的验收动作。对于服务方,最稳妥的表达也不是把研究结果包装成临床承诺,而是明确已核验的流程能力、待确认的模态与部署范围,以及每个版本交付中保留的证据。这样,数据质量才不会在模型训练后才被发现,研究价值也不会被一个漂亮但不可复现的分数所替代。
参考来源
- GastroHUN an Endoscopy Dataset of Complete Systematic Screening Protocol for the Stomach
- Renji endoscopic submucosal dissection video data set for early gastric cancer
- Real-time semantic segmentation of gastric intestinal metaplasia using a deep learning approach
- Expected value of artificial intelligence in gastrointestinal endoscopy
- Checklist for Artificial Intelligence in Medical Imaging (CLAIM): 2024 Update
- Performance measures for upper gastrointestinal endoscopy: a European Society of Gastrointestinal Endoscopy Quality Improvement Initiative—Update 2025