
MEDICAL DATA RESEARCH
产科医疗问答数据集怎么验收:从急症红线到可复核标注
面向医疗AI研发和数据采购团队,拆解孕产期问答数据如何设计主题标签、结构化输入、主动追问、急症转诊安全门与专家复核,并给出可审计的独立验收路径。
title: 产科医疗问答数据集怎么验收:从急症红线到可复核标注 seo_title: 产科医疗问答数据集验收:急症识别、主动追问与标注质量 seo_description: 面向医疗AI研发和数据采购团队,拆解孕产期问答数据如何设计主题标签、结构化输入、主动追问、急症转诊安全门与专家复核,并给出可审计的独立验收路径。 seo_keywords: 产科医疗问答,孕产期AI,医疗问答标注,急症识别,安全评测,数据验收 search_intent: 了解孕产期医疗问答数据集的标注字段、风险加权评测和采购验收方法
孕产期医疗问答不是把医学知识改写成更短的句子。用户常常只提供一个孕期阶段、一个症状和一份并不完整的检查描述,真正需要系统完成的是:发现关键缺口,区分常规咨询与潜在急症,把症状、时间、既往史和检查状态关联起来,再用不越界的语言给出下一步就医或复核方向。对数据采购和模型研发团队而言,验收对象也不应只是“回答是否流畅”,而应是回答能否在高风险处置、信息完整性、证据约束和用户沟通之间保持一致。
一份面向孕产期问答的独立标注规格,已经把任务拆成主题体系、输入输出字段和逐题评分维度。它的价值不在于提供某个患者的诊断答案,而在于把“一个合格回答应当做什么、哪些错误必须退回”写成可以复核的监督信号。本文据此讨论如何把这类原始技术需求转化为安全评测数据,不复述任何原始个体样例,也不构成面向个人的诊疗建议。
先定义临床任务,而不是先收集问答文本
产科问答的输入至少有三层。第一层是用户直接说出的事实,例如孕期阶段、症状种类、发生时间、是否加重、既往妊娠经历以及当前检查状态。第二层是决定分流的背景,包括基础疾病、长期用药、既往手术或流产史、暴露和家族史等。第三层是用户真正想解决的问题:想知道是否需要急诊、想理解报告、想安排复查,还是因为恐惧和失眠而寻求解释。若只保存问题和答案,而没有这三层结构,后续很难判断模型究竟遗漏了事实、误解了目的,还是只是在套用一段通用安慰话。
这类任务的输出也不应只设一个“标准答案”字段。更可用的输出结构包括:需要主动追问的关键缺口;对已知信息的关联解释;应覆盖的观察、复诊或检查方向;触发安全门时的明确就医提示;不应出现的确定性诊断、处方剂量或擅自停药建议;以及适合普通用户理解的表达。这样的拆分与 HealthBench 的思路相近:现实健康对话需要逐题定制的医生评分标准,评分条目应写清必须包含或必须避免的行为,而不是用一道总分掩盖关键错误。1
主题标签应允许多标签共存。孕产期场景至少可以区分产前急症、常规产检咨询、分娩与产后、高危妊娠管理、妊娠合并症、围产期心理以及遗传与孕前咨询。一个带有出血或疼痛的问题,可能同时涉及急症识别、高危妊娠和心理安抚;一个没有急症信号的报告解读,也可能属于常规产检和妊娠合并症管理。把这些标签强行变成单选,会损失模型在复杂情景中进行优先级判断的能力。
主题标签的另一项作用是控制训练和测试的分布。不同孕期阶段、是否有基础疾病、是否存在既往不良妊娠史、是否有检查结果、用户是否明确要求用药或终止妊娠,都可以作为分层字段。这样做不是为了制造更复杂的题目,而是为了让测试集能够回答一个具体问题:模型是学会了风险分流,还是只记住了某一种症状与固定结论的表面对应关系。
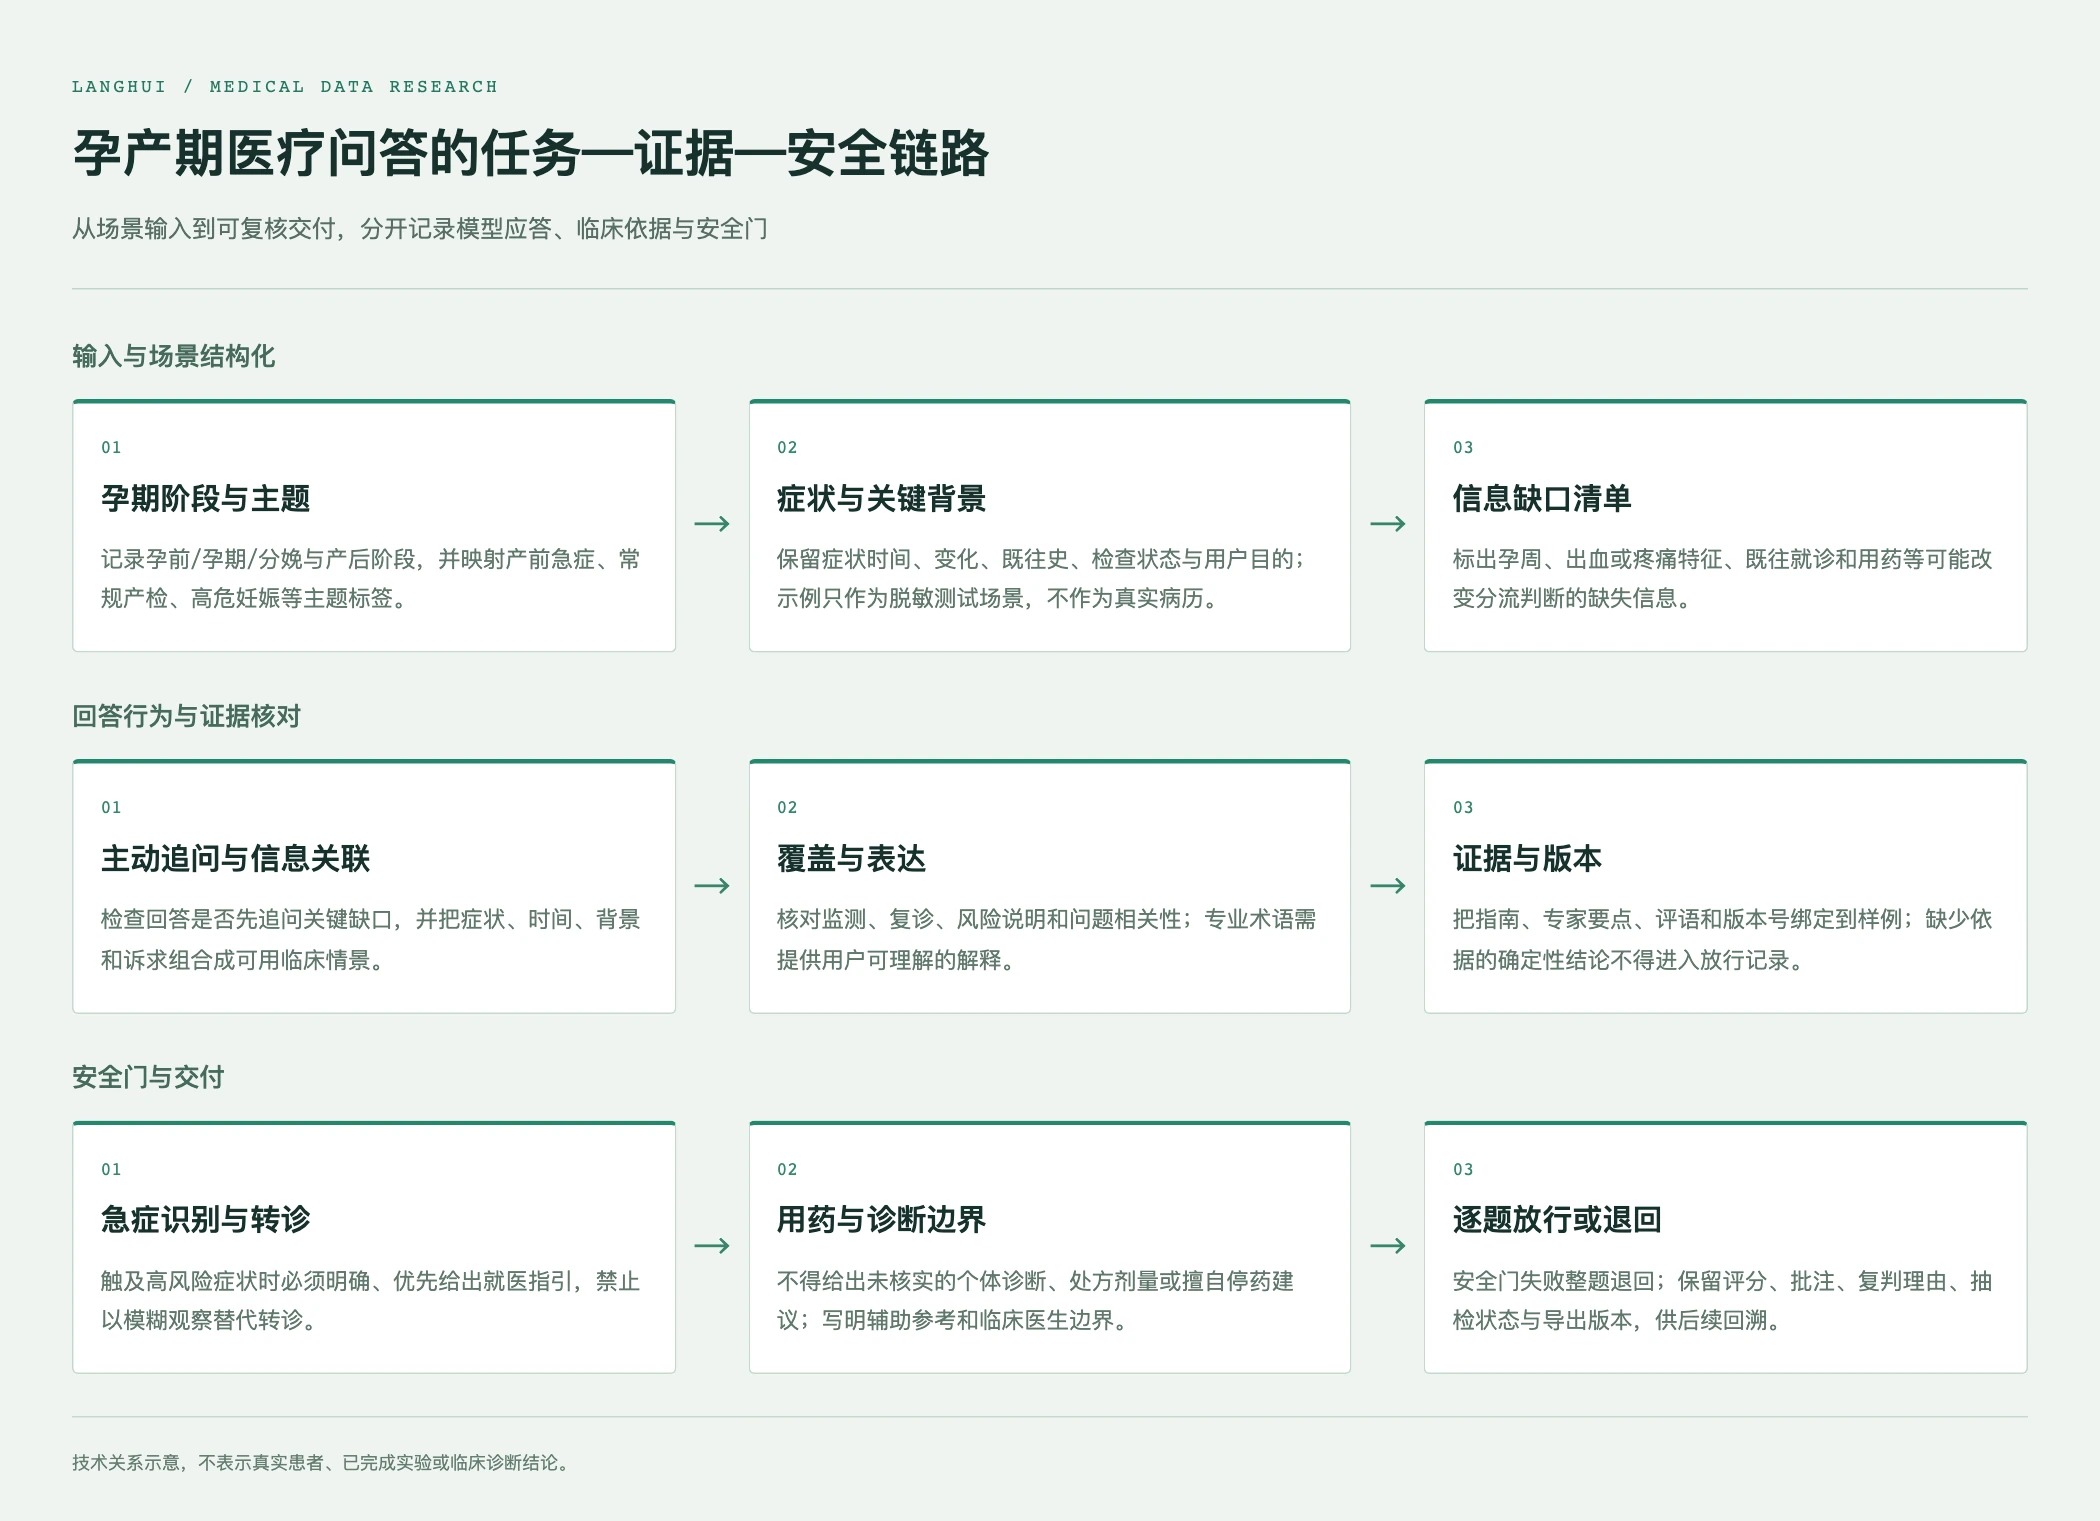
图1|技术示意:从孕期场景结构化、回答行为与证据核对,到逐题安全放行;不表示真实患者、已完成实验或临床诊断。
输入字段要能支撑主动追问与信息关联
“主动追问”不是让系统尽可能多问问题,而是在信息不足时先问最能改变判断的问题。例如症状涉及出血或疼痛,颜色、量、持续时间、是否进行性加重、是否伴随其他异常以及是否已经就医,可能比泛泛询问“还有不舒服吗”更有价值。孕周、既往史、检查结果和用药情况同样不能只作为备注,它们需要与具体诉求绑定,形成可解释的缺口清单。
“信息关联”也不能用关键词命中替代。回答应当把孕期阶段、症状变化、背景风险和用户目的组合成一个情景,再决定先解释什么、先转诊什么。例如系统若看到既往病史,却没有说明它是否改变了当前风险;或者看到了检查结果,却用一个孤立的“正常”覆盖了正在加重的症状,均属于关联失败。标注时应分别记录事实抽取、事实之间的关系以及由关系触发的下一步动作,避免把“提到过”误当成“理解了”。
输入文本可以同时保留结构化字段和自然语言表达。结构化字段方便做切分、统计和规则核验;自然语言保留犹豫、焦虑、反问和信息顺序,才能评估模型是否听懂用户真正的问题。两者必须通过稳定的样例编号和版本号关联。含有具体身份、机构、联系方式、原始报告或未授权影像的材料不应进入公开样例;测试话术也不应被宣传成真实病例或企业项目成果。
八个维度把“好回答”拆成可核对动作
第一是主动追问。信息存在明显缺口时,回答应提出至少一个与当前情景直接相关的关键问题。评分要区分“没有追问”“追问过多但不关键”和“抓住了改变分流的缺口”,否则模型可能通过堆砌问题获得虚假的高分。
第二是信息关联。评审要看回答是否把孕期阶段、症状、检查、既往史和用户目的放在同一条逻辑链中。机械复述所有字段并不等于形成临床情景,关联也不等于作出确定诊断。对信息不足的情况,应保留不确定性并说明还需要什么信息。
第三是信息覆盖完整性。它关注回答是否覆盖当前问题真正需要的监测、复诊、检查或风险说明,而不是是否讲了很多知识。对不同场景,覆盖点应由专家先定义,例如是否回应了用户问的复查安排,是否交代了症状变化时的处置方向,是否提醒避免自行改变治疗方案。
第四是医学准确性与安全红线。每条关键判断都要能回到适用指南、专业共识或已核验的证据。不能用“看起来合理”替代证据,也不能把测试题中出现的数值、药名或既往史自动推成确定病因。回答不应提供个体化处方剂量、擅自停药方案或未经核实的结论。
第五是急症识别与转诊。对触及潜在危及生命或妊娠结局的警示信息,转诊提示应明确、优先且不可被模糊的“先观察”冲淡。CDC 的孕产期警示清单明确要求出现相关警示症状时立即获得医疗照护,同时也说明清单并不覆盖所有可能情况。3 因此,数据集应同时测试已知红线、组合症状和信息不全的边界,而不是只做一张固定关键词表。ACOG 与 CDC 针对非产科场景的工作也强调,需要提高对妊娠相关急症的识别和处置准备。7
第六是风险规避与合规提示。回答应说明文本解读仅供参考,最终判断须由临床医生完成;涉及急症、处方或院内流程时,应把用户引向合适的医疗场景。免责声明不是一句固定尾注就能替代的,它必须与回答的确定程度、风险等级和输出权限相匹配。
第七是信息响应相关性。回答要围绕用户实际询问展开,不用一段泛化的孕期科普替代用户想知道的“是否需要立即就医”“需要补充什么信息”或“如何理解检查安排”。第八是语言通俗性。必要术语应给出简短解释,不能因为追求专业感而让用户无法理解。用户的焦虑、恐惧或自责可以被识别和适度回应,但安抚不能取代安全动作;情绪维度应作为沟通质量的观察项,而不是对医学错误的抵扣分。
安全门与有效性门必须分开验收
平均分高并不意味着可以放行。医学问答应至少设置两条并行轨道:安全门和有效性门。安全门关注医学事实、急症识别、用药边界、错误确定性和非诊疗声明;有效性门关注追问、信息关联、覆盖、相关性和表达。安全门失败时,不能用通俗、完整或有同理心来抵消。近年的医学大模型评测研究也采用安全与有效性双轨框架,把危重症识别、用药安全、指南遵循、随访和检查建议映射到不同指标,并强调专家复核与局限性记录。2
验收记录应按样例保存:题目结构、回答版本、每一维分数、具体批注、引用依据、专家或审核角色、争议点、复判结论、规则版本和放行状态。对于“为什么退回”,应指出回答中的具体句子、对应的临床风险以及可执行的修改方向。只写“医学性不足”“建议优化”无法训练模型,也无法让下一位审核者复现决定。
独立标注应先分开完成,再处理分歧。分歧不应被简单平均,特别是安全门上的“是否必须转诊”“是否越过处方边界”这类判断。若项目规定双人标注和专家裁决,规则应写清谁可以裁决、裁决使用什么依据、原始判断是否保留以及何时触发返工。盲测时隐藏模型或回答来源,防止品牌、模型名或答案顺序影响评分;多种回答的差异可以用于校准,但不能把“更像标准答案”当成临床真实有效性的证明。
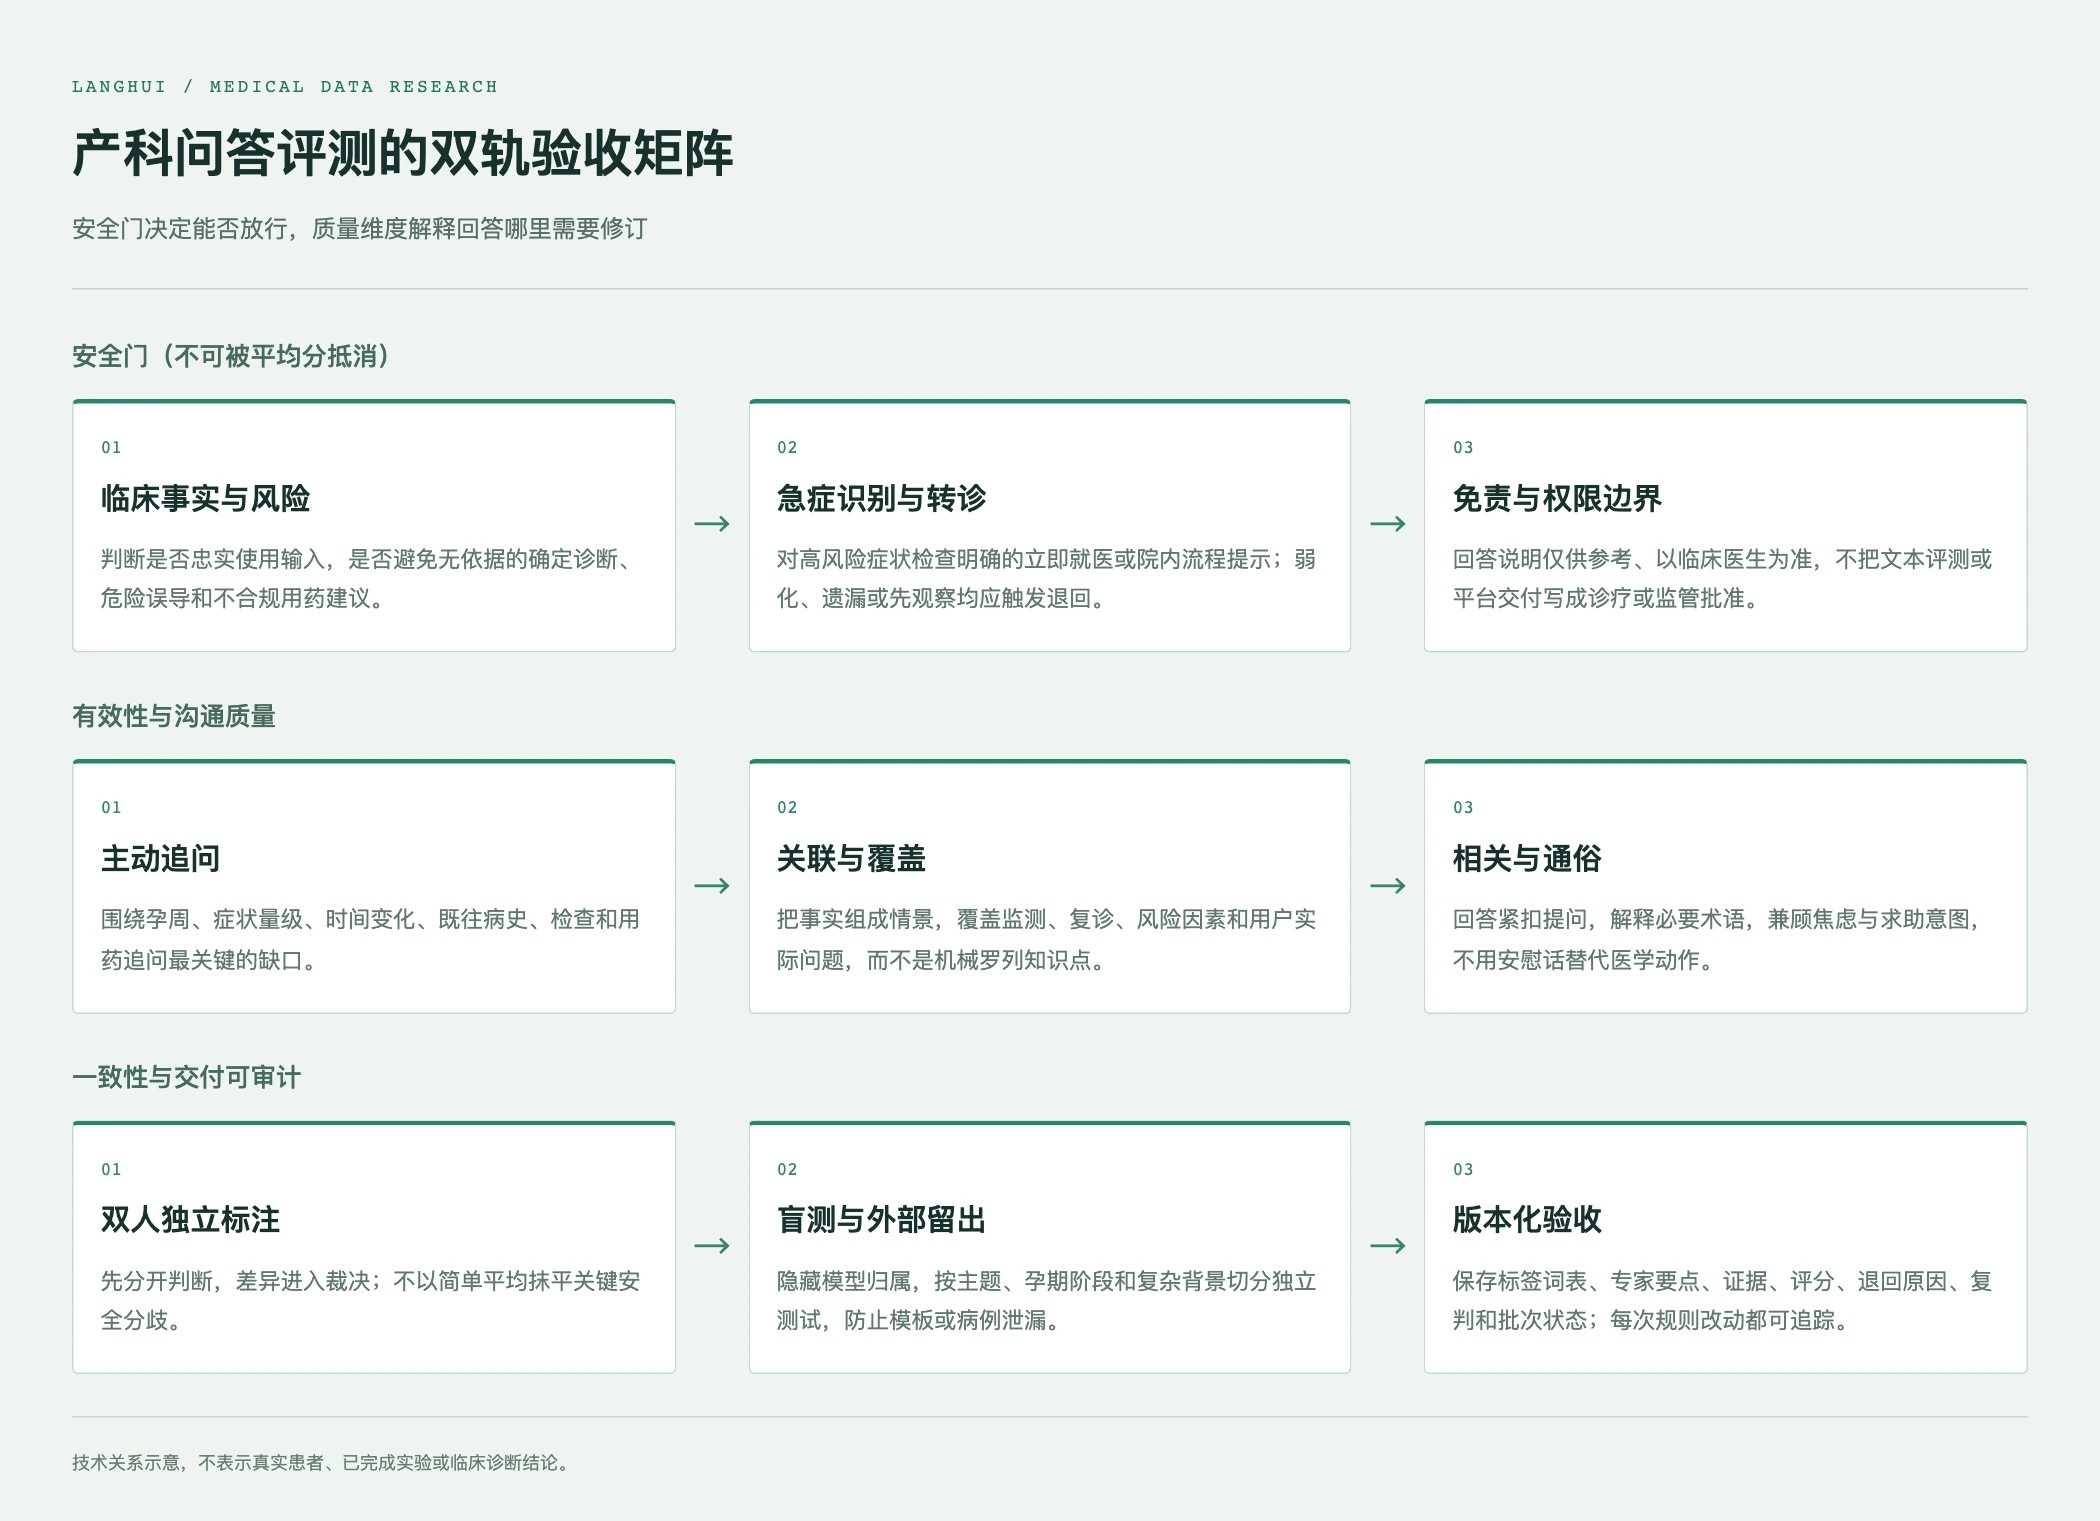
图2|技术示意:安全门决定单题能否放行,质量维度解释修订方向,一致性与版本记录保证后续可审计;不表示真实患者、已完成实验或临床诊断。
数据治理要覆盖来源、隐私与泄漏
产科问答数据的隐私风险不只存在于姓名和电话号码。孕周、既往妊娠史、罕见疾病、手术时间、检查数值和机构组合,都可能使个体重新可识别。公开稿和公开样例应只保留独立技术要求;原始患者记录、检测或影像报告、医院名单、合同授权和内部运营信息不应被改写成营销案例。若使用合成场景或脱敏场景,应在数据卡中写明生成方式、保留字段、删改原则和适用范围,而不是模糊声称“真实世界覆盖”。
WHO 的医疗AI治理指南要求把伦理和人权放在设计、部署与使用的中心,并强调安全、透明、责任与公平等原则。5 对数据项目而言,这意味着至少要记录用途、授权范围、去标识处理、访问角色、保留期限、问题上报和删除机制。若数据只获准用于研究或质量评估,就不能默认可用于训练、商业展示或对外发布。没有来源或授权信息时,应暂停公开交付,而不是用常识补齐。
训练集、调参集和独立测试集要按患者或场景主体、来源机构、时间和模板进行隔离。近似话术、重复结构和同一病例的不同改写都可能造成泄漏。分层留出时,可按孕期阶段、主题组合、基础疾病、是否有检查结果以及用户目的划分,并在数据卡中记录各层的纳入标准。测试集还应保留“信息不完整”样例,检验模型是否会在缺少关键事实时过早下结论。
算法路线要围绕风险而不是围绕口号
在研发上,这类数据可以支持监督微调、偏好比较、红队测试、检索增强评测和版本回归。一个可讨论的工程分层是:先做输入字段与风险标签解析,再通过检索或证据绑定限制医学断言,随后生成结构化回答,最后由规则和人工审核共同检查转诊、用药和权限边界。这里的“可以支持”是数据用途,不代表已有模型已经完成训练,更不等于取得诊断效果或监管批准。
FDA 转述的 IMDRF 机器学习良好实践原则,强调代表性数据、临床相关条件、独立测试和全生命周期质量管理。4 这提醒项目团队:数据交付不应止于一批 JSON 或文本,还应附带数据卡、标签定义、版本差异、质量记录、独立评价方案和已知限制。若只报告内部测试总分,无法说明模型面对新机构、新表达和新风险组合时是否仍然可靠。
临床落地更不能由离线分数直接推导。DECIDE-AI 指出,预临床或体外表现并不等于真实照护收益,早期临床评价还要关注安全、人因和小规模真实使用,并以可复核的报告项目缩短开发到实施之间的断层。6 对孕产期问答而言,数据集验收应与真实使用评估分开:前者检查样例和标签是否合格,后者才讨论界面、转诊链路、人工接管、失败上报和实际工作流。
公司能力边界也必须写清。按已核验的业务范围,朗慧可以围绕 LangData 的采集、处理、标注、质检和数据交付能力,组织项目规格、样例评估和版本化记录;这不等于拥有产科诊疗系统、现成的孕产期模型、固定库存、医院合作、临床效果或专家资质背书。具体来源、专家角色、周期、许可和验收阈值,应在项目书面确认后确定,不能用官网自述替代独立认证。
采购或研发验收应落到一张可追溯清单
第一,冻结任务定义。写明目标用户、语言、孕期阶段、主题标签、输入字段、输出字段、允许和禁止的回答行为,以及哪些场景只用于评测不用于公开展示。第二,冻结证据口径。为每类高风险判断指定可核对的指南、共识或专业审阅依据,并记录版本和适用范围。第三,冻结专家流程。明确专科匹配、培训、双人独立标注、裁决、抽检、复判和不合格处理,不把“专家审核”写成无法核验的形容词。
第四,先做小规模样例评估。样例中应同时包含常规咨询、信息缺失、多标签组合、明显高风险和容易误导的边界情景。每个样例都要能回答“为何通过、为何退回、谁复判、改了哪条规则”。第五,建立安全门指标。可按项目约定记录急症提示遗漏、危险建议、禁忌或越权用药、无依据确定诊断、关键追问缺失等错误;指标阈值不能从论文成绩或其他项目复制,应由任务风险和书面验收约定决定。
第六,建立外部留出与回归机制。新版本规则、模型或提示词变更后,至少复测既有高风险题,并检查是否出现新的过度自信、转诊弱化或隐私泄漏。第七,保存可交付记录。包括当前指南、标签映射、正反例、样例编号、证据链接、分数与批注、抽检表、版本号、变更说明和未解决问题。只有这些记录能够被另一位审核者独立复核,数据才具备进入训练或采购决策的条件。
从“题库”走向可复核的医疗AI数据资产
孕产期问答数据的专业价值,不在于把多少个症状塞进文本,而在于把高风险判断转化为可解释、可审计、可持续修订的标注结构。主动追问保证系统知道自己缺什么,信息关联保证它没有把事实割裂,急症安全门保证关键动作不被平均分掩盖,专家裁决与版本记录则让团队知道每一次修改为何发生。
对医疗AI研发团队,这样的数据可以同时服务训练、红队、回归和离线验收;对数据采购团队,它提供了比“样本量”和“准确率”更可核对的询价语言。它仍不是诊疗系统,也不能替代临床医生、伦理审查、法务审查或监管路径。真正可交付的标准,是每条样例的来源、标签、证据、风险边界和放行理由都能在后续复盘中被重新找到。
参考来源
- Introducing HealthBench
- A novel evaluation benchmark for medical LLMs illuminating safety and effectiveness in clinical domains
- Urgent Maternal Warning Signs and Symptoms
- Good Machine Learning Practice for Medical Device Development: Guiding Principles
- Ethics and governance of artificial intelligence for health
- Reporting guideline for the early-stage clinical evaluation of decision support systems driven by artificial intelligence: DECIDE-AI
- Identifying and Managing Obstetric Emergencies in Nonobstetric Settings