
MEDICAL DATA RESEARCH
胃镜炎症与病灶标注:如何把分类、边界与 PNG/JSON 交付写成验收规则
面向医疗AI研发与数据采购,拆解胃镜影像的炎症多标签、病灶多边形、报告与病理证据分层,以及PNG/JSON交付、盲审、划分和外部验证的验收方法。
胃镜影像人工智能项目最容易在“勾画病灶”四个字上失去技术边界:一张画面可以同时出现炎症、糜烂、萎缩、肠化生或溃疡,某些边界并不清楚;同一检查的相邻画面又可能被当成彼此独立的样本。若只规定“有病灶就圈出来”,而没有写明什么是画面级分类、什么是区域级轮廓、报告和病理在标签体系中各自扮演什么角色,后续模型训练、误差解释和交付验收都会变成事后补丁。一个可执行的胃镜数据方案,应先把临床问题拆成数据对象,再把每个对象绑定到可追溯的标注动作。
先把临床问题拆成两个输出
这类需求的临床任务不是直接给受检者下诊断,而是为胃镜影像算法准备结构化监督信号。输入主体是胃镜检查图像,配套诊断报告,若有则另行关联病理报告。项目纳入规则要求影像和诊断报告同时可用;缺报告的检查不能在后期凭影像印象补成“阴性”或“正常”。既往做过胃部切除的检查通常需要排除,因为术后解剖、黏膜形态和检查范围已经改变了任务分布。病理报告不是每条影像都必然存在的字段,而是可获得时的独立证据层,不能把“有病理”误写成所有图像均有病理金标准。
输出要拆为两层。第一层是当前画面的分类标签,用来描述画面中是否能观察到某类炎症或部位相关异常,例如食管炎、非萎缩性胃炎、萎缩性胃炎、糜烂性胃炎和十二指肠炎。它回答的是“这张画面有哪些被定义为可标注的类别”,不是“整次检查的最终诊断”。同一画面允许出现多种炎症标签,因此数据结构应支持多标签,而不是强迫每帧只能有一个互斥类别。
第二层是病灶实例的边界标签,用于表达隆起或息肉、溃疡、癌、低级别上皮内瘤变、高级别上皮内瘤变、明显糜烂、萎缩以及肠化生等区域。它回答的是“病灶位于哪里、边界到哪里”,本质上是多边形或掩膜监督。把区域边界压缩成一个画面级类别,会丢掉病灶位置和面积信息;反过来,把整个画面都涂成某种病灶,也会把可见证据与报告推断混为一谈。分类和分割应在标签字典中分别定义、分别统计、分别验收。
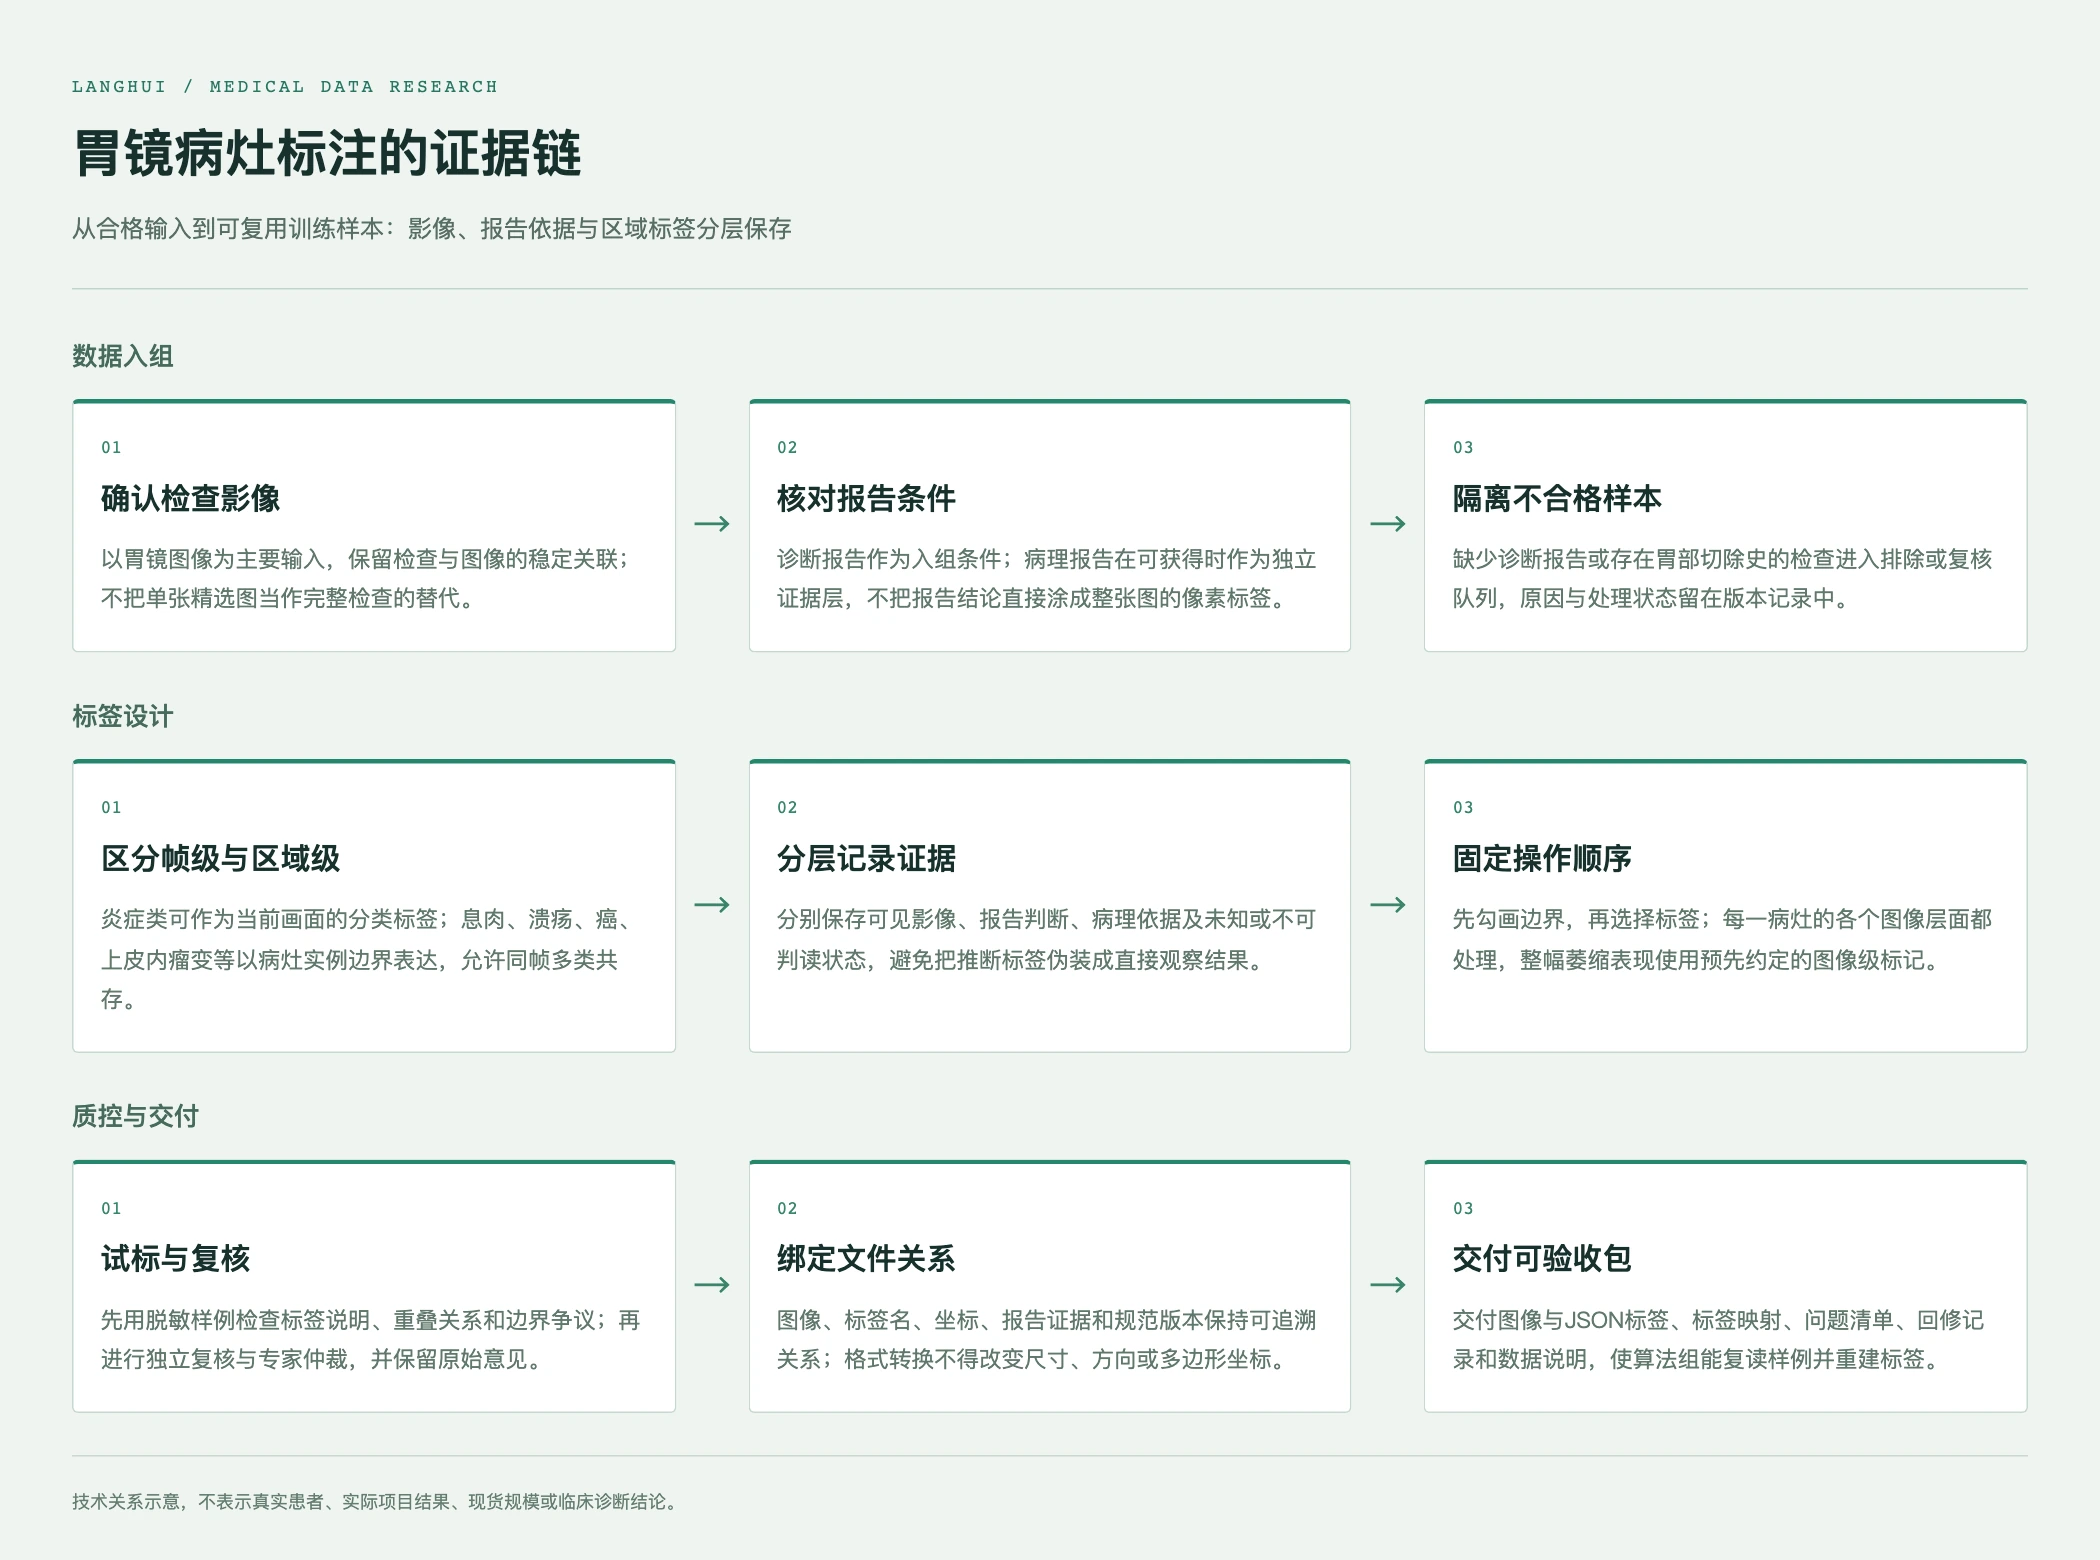
图1 胃镜标注的证据链技术示意,不表示真实患者、实际项目结果或临床诊断。
数据颗粒度决定模型能否复现
“病例”“一次检查”“一张图像”“一个病灶实例”不是同一个数据单位。工程上至少需要建立四级关系:一次检查属于一个去标识化受试者;检查包含按时间或序列整理的胃镜画面;每张画面可以有零个、一个或多个病灶实例;每个实例又有类别、坐标、来源和复核状态。导出的文件名可以采用项目内部生成的稳定键,但公开说明不应暴露真实身份、机构、采集方或原始病例编号。稳定键的用途是连接图像、JSON、报告索引和修订记录,而不是恢复身份。
如果相邻画面来自同一次检查,就不能在拆分训练集和测试集时把它们当成互不相关的样本。相同黏膜、相同器械和相同检查流程会形成高度相似的视觉特征,随机按图像切分会让结果看上去更好,却不能代表新检查上的泛化。CLAIM 2024要求明确说明数据如何分区、分区在什么层级互斥,并强调医学影像通常应在受试者层级或更高层级保持隔离。6 因此,项目在冻结划分时至少要按受试者或检查隔离,并记录分层依据、随机种子和版本。若研究要比较设备或成像模式,还应把设备、白光或窄带成像等信息作为分层变量,而不是在训练后才发现某类设备只出现在一个集合里。
输入质量也需要成为数据字典的一部分。胃镜画面可能有反光、气泡、黏液、出血、器械遮挡、失焦或视野过窄;这些情况不是简单的“坏图”,而是决定某一标签能否可靠判断的上下文。建议把清晰可判读、部分遮挡、不可判读和缺失分开编码。不可判读不等于阴性,缺少报告也不等于无病灶。对于报告和病理,需分别记录“未提供”“未发现相关描述”“结果不确定”和“与影像无法对应”,不要为了让每行都有结论而强行填值。
胃镜AI的研究已经显示,数据粒度和外部验证会直接影响可解释性。Nam等人在两家转诊中心以患者为单位组织胃黏膜病变图像,用组织学诊断作为参考标准,并分别设置内部与外部验证;该研究同时指出模型任务包括检测、鉴别诊断和浸润深度,不同任务不能用同一指标替代。3 另一项多类别胃部病变研究将白光图像按患者划分,纳入正常黏膜、良性病变、上皮内瘤变和癌等类别,并明确提出单中心数据仍需外部验证,类别不平衡可能造成偏倚。5 这些研究不是本项目的性能承诺,却说明了为什么数据字典、划分单位和证据来源应在标注前写清楚。
标签规则要写成标注员能执行的动作
使用Labelme一类多边形工具时,最重要的不是工具名称,而是每一次操作的顺序和可回放性。LabelMe原始工作描述了通过多边形勾勒目标空间范围、共享图像与标注的方式,适合作为“轮廓是独立对象”的方法学参照。7 在胃镜任务中,建议先打开标准化后的图像,检查画面是否可判读,再勾画病灶边界,最后选择病灶标签。这样做可以避免先点选类别后凭类别暗示边界,也便于在同一画面存在多个病灶时逐个建立实例。
边界规则要用可观察的语言表达。轮廓尽量贴近可见病灶的真实边界,但对反光、黏液遮挡或颜色渐变造成的不确定区域,不应通过“想象连续边缘”来制造精确多边形。可以在标签状态中增加“边界不确定”或“需仲裁”,保留原始轮廓和修改后的轮廓,记录修改依据。若研究终点需要区域测量,边界不确定样本可以进入独立分析层;若直接并入金标准,则需要在方案中说明为何这样处理以及可能带来的误差方向。
病灶不是只在一张精选图上出现。对同一检查中被纳入的胃镜图像,凡出现符合规则的病灶,都应按图像层面处理;相邻画面的重复出现要保留时间关系和实例关系,不能把同一病灶无记录地复制成多个独立病例。溃疡还可能处于活动期、愈合期或瘢痕期,项目如果要求这些状态都纳入,应在标签字典中明确是同一大类下的状态字段,还是三个互斥类别。没有定义的状态不能靠标注员临场发挥。
萎缩和肠化生尤其需要把“图像级现象”和“局部区域”区分开。若整张图像呈现萎缩且缺少清晰的萎缩线,适合使用预先约定的图像级标记,而不是画出看似精确却无可靠边界的轮廓。肠化生主要在窄带成像下标注;若白光下也能依据规范确定,则仍可标注,但应记录成像模式。换句话说,模态不是备注,而是标签解释的一部分。后续分析应能回答某个标签是在白光、窄带或其他增强模式下产生,避免不同模式的视觉证据被直接混合。
专家标注也不能只写“医生审核”。应在项目书中定义初标、复核和仲裁各自负责什么;是否独立阅片;复核者能否看到初标轮廓;分歧是回退重标、保留双意见,还是由仲裁者形成最终版本。对于食管炎、胃炎、十二指肠炎等画面级标签,统计标签一致性;对于息肉、溃疡、癌和上皮内瘤变等区域标签,统计边界重合、漏标、过标及实例匹配。Kappa、Dice或IoU只能在明确抽样单位、参考轮廓、实现方式和标签版本后解释,不能把一个总分当成全部病灶类型的质量证明。
从临床规则到算法路线
这类数据最稳妥的建模路线通常是“分类分支加分割分支”,而不是把所有标签压成一个目标。画面级炎症标签可以采用多标签分类器,输出每个类别的独立概率,并保留不可判读或证据不足的遮罩条件。病灶区域则可以采用语义分割、实例分割或检测加轮廓细化的组合,具体选择取决于是否需要区分同类多个病灶、是否要测量边界和项目计算资源。对小面积肠化生、糜烂或早期上皮内瘤变,应单独检查小目标召回与边界偏差,不能只报告宏平均指标。
如果将报告或病理作为多模态输入,影像标签、报告结论和病理结论必须保留来源字段。报告可以帮助确认检查是否符合入组条件,病理可以为部分病灶提供参考标准,但它们未必能精确对应每一帧、每一个轮廓。把一次检查的病理结果复制到该检查所有画面,会产生标签泄漏;把病理确诊病灶当成整次检查的阳性区域,也会把未见病灶的画面错误标阳。更合理的做法是把“可见影像”“报告判断”“病理依据”“无法对应”并列保存,模型训练时按任务选择可用证据。
算法验证应与临床任务对应。画面级分类可按标签报告灵敏度、特异度、精确率、召回率、校准和不确定样本表现;区域分割需关注每类病灶的Dice或IoU、边界距离、实例检出和漏标;检查级任务还要说明如何从多帧合并到一次检查的结论。不能用分类准确率验收分割,也不能用一次检查的最优帧结果宣称整个检查流程有效。若目标是辅助提示而非最终诊断,研究报告还应区分离线图像性能、连续画面稳定性和真实工作流中的人机交互结果。
GRAIDS研究以多中心、不同层级医院的白光内镜图像开展训练和验证,显示跨机构验证可以揭示单中心数据看不到的问题;但它的研究任务、样本来源和输出定义与本项目并不相同。4 ESGE关于消化内镜AI的立场文件也把上消化道完整性、解剖标志识别和病变检测作为不同任务,并强调参考标准应依据任务选择专家共识或组织学证据。2 因此,本项目不应因为使用了同类模型结构,就直接借用其他研究的临床效果或监管含义。数据设计阶段越清楚地写出标签来源和适用范围,后续外部验证越容易解释。
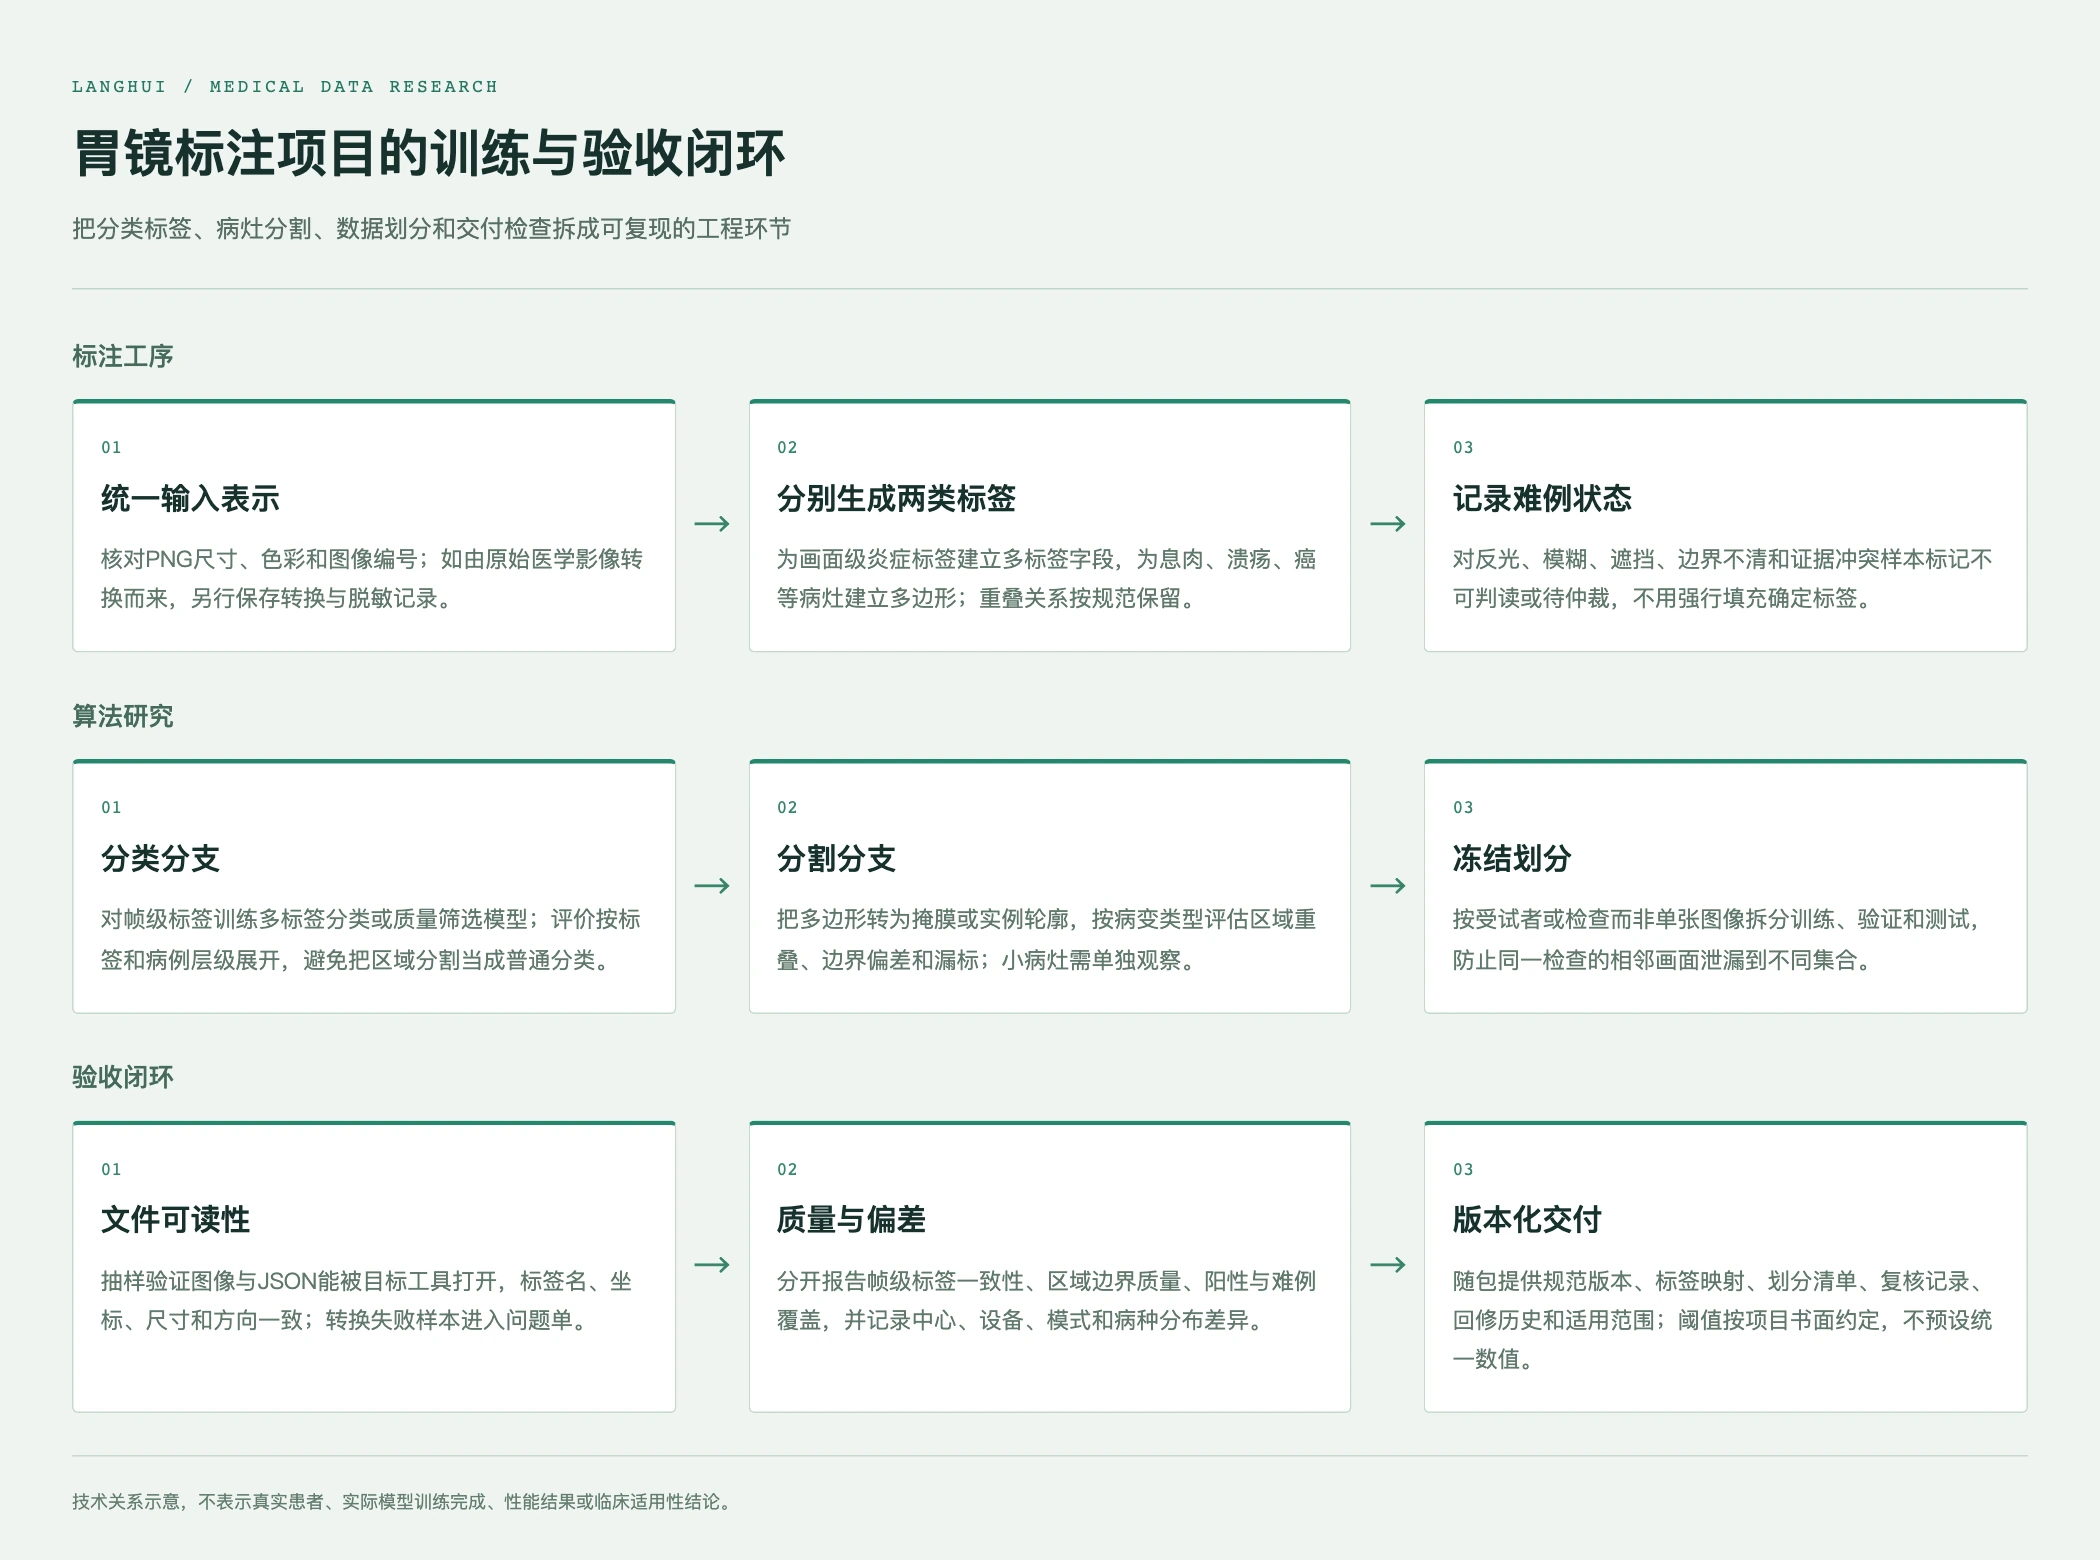
图2 分类、分割、划分和交付检查的技术示意,不表示模型已训练完成或具有临床性能。
质量控制要覆盖来源、标注和导出
第一道质量控制是来源治理。项目需要核对数据使用授权、伦理或合规文件的适用范围,以及是否允许研究、委托处理、交付和再使用。去标识不是商业授权的替代。若图像由医学影像格式转换为PNG,应记录转换工具、尺寸、色彩处理、裁剪和文件对应关系;同时检查像素内是否残留姓名、检查号、日期或机构字样。美国国家癌症研究院相关数据流程明确要求去除像素中的烧录身份信息,并把头信息、UID、自由文本和像素数据分开审查。8 这对胃镜图像同样适用:文件名改掉并不代表画面已经脱敏。
第二道质量控制是小批试标。试标不宜只检查“能不能画”,而要覆盖最容易引起争议的组合:同帧多标签、病灶重叠、整幅萎缩、窄带成像下肠化生、白光下可确认的肠化生、溃疡不同阶段、模糊或遮挡画面,以及报告与影像不一致的情况。每类问题都应形成示例、规则解释和最终处理方式。正式标注前冻结标签字典和版本;规则改变时,明确旧标签是否回溯修订、哪些集合需要重跑,而不是在同一训练集里混用不同版本。
第三道质量控制是盲审和偏差分析。初标者不应看到其他人的轮廓或最终标签,复核者需要知道自己是在检查边界、类别还是证据对应。质量记录应按标签、设备、成像模式、检查部位、图像质量和来源批次拆分,避免多数容易样本把少数高风险标签的错误掩盖。尤其要检查报告完整性造成的选择偏差、病理确诊病例过多造成的阳性谱偏移、单一设备造成的颜色或清晰度偏移,以及同一检查多帧造成的相关性。
标注主体的资格也应成为数据设计,而不是交付末尾的一句“专家审核”。画面级炎症标签可以由经过统一培训的初标人员完成,但疑似癌、上皮内瘤变、复杂重叠边界和影像—报告不一致样本,应由具有相应消化内镜经验的复核者处理。项目应记录培训材料、试标结果、复核范围和仲裁者是否独立于初标者;如果某类标签只能由少数人员判断,更要在抽样设计中防止把个人习惯当成共识。专家意见之间不一致时,保留各自轮廓、争议原因和最终裁决,而不是只留下一个无法解释的“正确答案”。
外部验证也要从标注阶段开始筹备。外部集合不只是换一批图片,还应尽量包含不同设备、成像模式、检查质量、病变谱和报告书写习惯,并采用与训练集一致但不依赖训练集标签的审阅流程。若外部数据的类别定义、边界原则或病理对应关系不同,应先做标签映射和差异说明,再计算性能;如果无法建立可靠映射,应把该集合定位为可迁移性探索,而不是正式验证。这样才能区分模型失效、标签不一致和人群差异三种原因。
第四道质量控制是导出验收。抽样打开PNG和JSON,检查图像尺寸与坐标系是否一致,标签名是否都能映射到版本化字典,多个多边形是否被截断,空标注和图像级标记是否能被下游读取。数据交付不应只有一个“标注文件夹”,还应包含标签映射、数据字典、去标识说明、划分清单、复核记录、问题单、回修历史和适用范围。对下游算法组,至少提供一份实际能够读取的样例;对临床研究组,提供影像与报告或病理索引的关联规则;对信息部门,提供日志、备份和数据返还约定。
把验收和业务边界写进项目逻辑
采购或委托实施时,至少要把四条线拆开:数据来源与授权核验、标注工具或平台、专业标注与专家复核、数据交付和接口部署。软件能否导入、勾画、审核和导出,不等于某个病种的数据已经标注完成;专家复核能力也不等于任何标签、任何规模和任何时限都已具备。项目应先做脱敏样例评估和小批试标,再根据试标结果确定人员、回修轮次、质量指标和交付节奏。具体阈值、周期和范围应在书面项目规格中确认,不应被公开文章写成统一承诺。
从研发价值看,精细的标签本体能减少三类隐性成本。第一,算法团队不必在训练阶段重新猜测分类与分割的含义;第二,临床团队能够区分影像可见结果与报告、病理所支持的结论;第三,采购与交付团队可以用可复核文件验收,而不是用功能截图或单一平均分验收。朗慧已核验的定位是AI数据基础设施及流程服务商,LangData覆盖采集、处理、标注、质检和数据交付;医疗数据的实际范围、专家配置、授权、周期和验收指标仍应按样例评估与项目书面确认。本文不把需求规则、网站自述或建议路线表述为现货、独立认证或临床获批能力。
结语:先冻结标签,再讨论模型
胃镜AI项目的核心交付不是“把异常区域圈出来”,而是让每个标签都能回答四个问题:它描述的是哪一个数据单位,来自什么证据,经过谁的什么复核,最终以何种格式交给算法。对画面级炎症和区域级病灶分别建模,对报告、病理和影像证据分层,对不确定和不可判读状态如实编码,再用受试者或检查级划分和外部验证检验泛化,才能让数据从一次标注任务变成可复用的研究基础设施。模型名称可以后选,标签规则、质量记录和版本血缘不能后补。
参考来源
- Quality indicators in diagnostic upper gastrointestinal endoscopy
- Expected value of artificial intelligence in gastrointestinal endoscopy: European Society of Gastrointestinal Endoscopy Position Statement
- Deep learning model for diagnosing gastric mucosal lesions using endoscopic images: development, validation, and method comparison
- Real-time use of artificial intelligence for diagnosing early gastric cancer by magnifying image-enhanced endoscopy: a multicentre diagnostic study
- Enhanced multi-class pathology lesion detection in gastric neoplasms using deep learning-based approach and validation
- Checklist for Artificial Intelligence in Medical Imaging (CLAIM): 2024 update
- LabelMe: a database and web-based tool for image annotation
- EDRN DICOM De-identification Process