
MEDICAL DATA RESEARCH
耐药菌精准用药AI数据怎么建:把药敏、酶型与纵向结局对齐
面向医疗AI研发与数据采购团队,拆解耐药菌数据如何对齐病原体、MIC、碳青霉烯酶、感染场景与纵向结局,并说明标签治理、时间防泄漏、分层评估和外部验证的可验收路径。
碳青霉烯类耐药的革兰阴性菌感染,难点并不只是“耐药”两个字,而是同一个临床决策同时受到病原体、耐药机制、表型药敏、感染部位、疾病严重程度、既往用药和当地流行病学的共同影响。源文档《新型β-内酰胺酶抑制剂复方制剂临床应用专家共识》围绕CRE、CRAB和耐药铜绿假单胞菌等问题,提出了从病原学检测、药敏试验到分型和动态随访的决策链条,并将不同酶型、不同感染类型和证据等级分开讨论。1 原件标注为在线优先(In Press),本文仅将其中可独立审计的技术要求转译为数据任务,不把它当作已完成的临床验证或个体处方依据。
这类内容如果直接改写成“某种药对某种病都有效”,既会丢失共识中的条件,也容易把研究结果误读成面向个体的处方建议。对医疗AI研发和数据采购而言,更有价值的做法是把它转译为一份可审计的数据任务:模型究竟要识别什么,输入在什么时间点可用,标签由谁按什么证据确定,治疗后的信息如何避免泄漏,最终交付怎样验收。本文讨论的是这种数据与算法设计,不提供患者个体的诊断、用药或治疗建议。
先把临床问题写成可计算的任务
共识中的临床问题不是一个单一分类任务。至少可以拆成四种不同的研究目标。
第一种目标是耐药机制识别。输入可以包括菌种、标本来源、表型筛查结果和分子检测结果,输出则是是否存在碳青霉烯酶、属于哪一类酶,或者是否存在需要进一步复核的冲突。KPC、NDM、VIM、IMP和OXA-48样酶并不代表相同的药物活性谱。模型若只输出“耐药/敏感”,就无法表达机制分层带来的决策差异。
第二种目标是药敏预测。输入可能包括药物、检测平台、原始MIC、培养条件和检测标准版本,输出可以是MIC估计、敏感性分类,或一个需要微生物专家复核的候选结果。MIC并不是脱离方法和版本的永久标签。不同实验方法、药物组合和解释标准会改变标签的含义,所以数据集应保留原始值、分类结果和解释规则,而不是只保存最后一个二元字段。
第三种目标是治疗选项排序或决策支持。输入除了实验室证据,还需要感染部位、严重程度、器官功能、既往抗菌药暴露、源控制和当地耐药流行病学。输出不应伪装成自动处方,而可以是与项目约定一致的候选选项、证据依据、缺失字段和冲突提示。IDSA的更新指南也按CRE、CRAB和DTR铜绿假单胞菌分别讨论药敏、碳青霉烯酶和感染场景,说明“病原体加机制加场景”比单一病名更接近真实决策。3
第四种目标是纵向结局研究。它可以研究治疗后微生物学清除、临床应答、复发、治疗中耐药出现或安全性,但每个结局都需要单独定义评估时间、观察窗口和判定者。不能把“培养转阴”“症状改善”“生存”和“没有再次换药”混成一个模糊的成功标签。不同研究的主要终点也不应互相替换:CERTAIN-1将复杂尿路感染中的微生物学和临床成功组合为主要终点,并明确了测试治愈时间点与微生物学分析人群。5
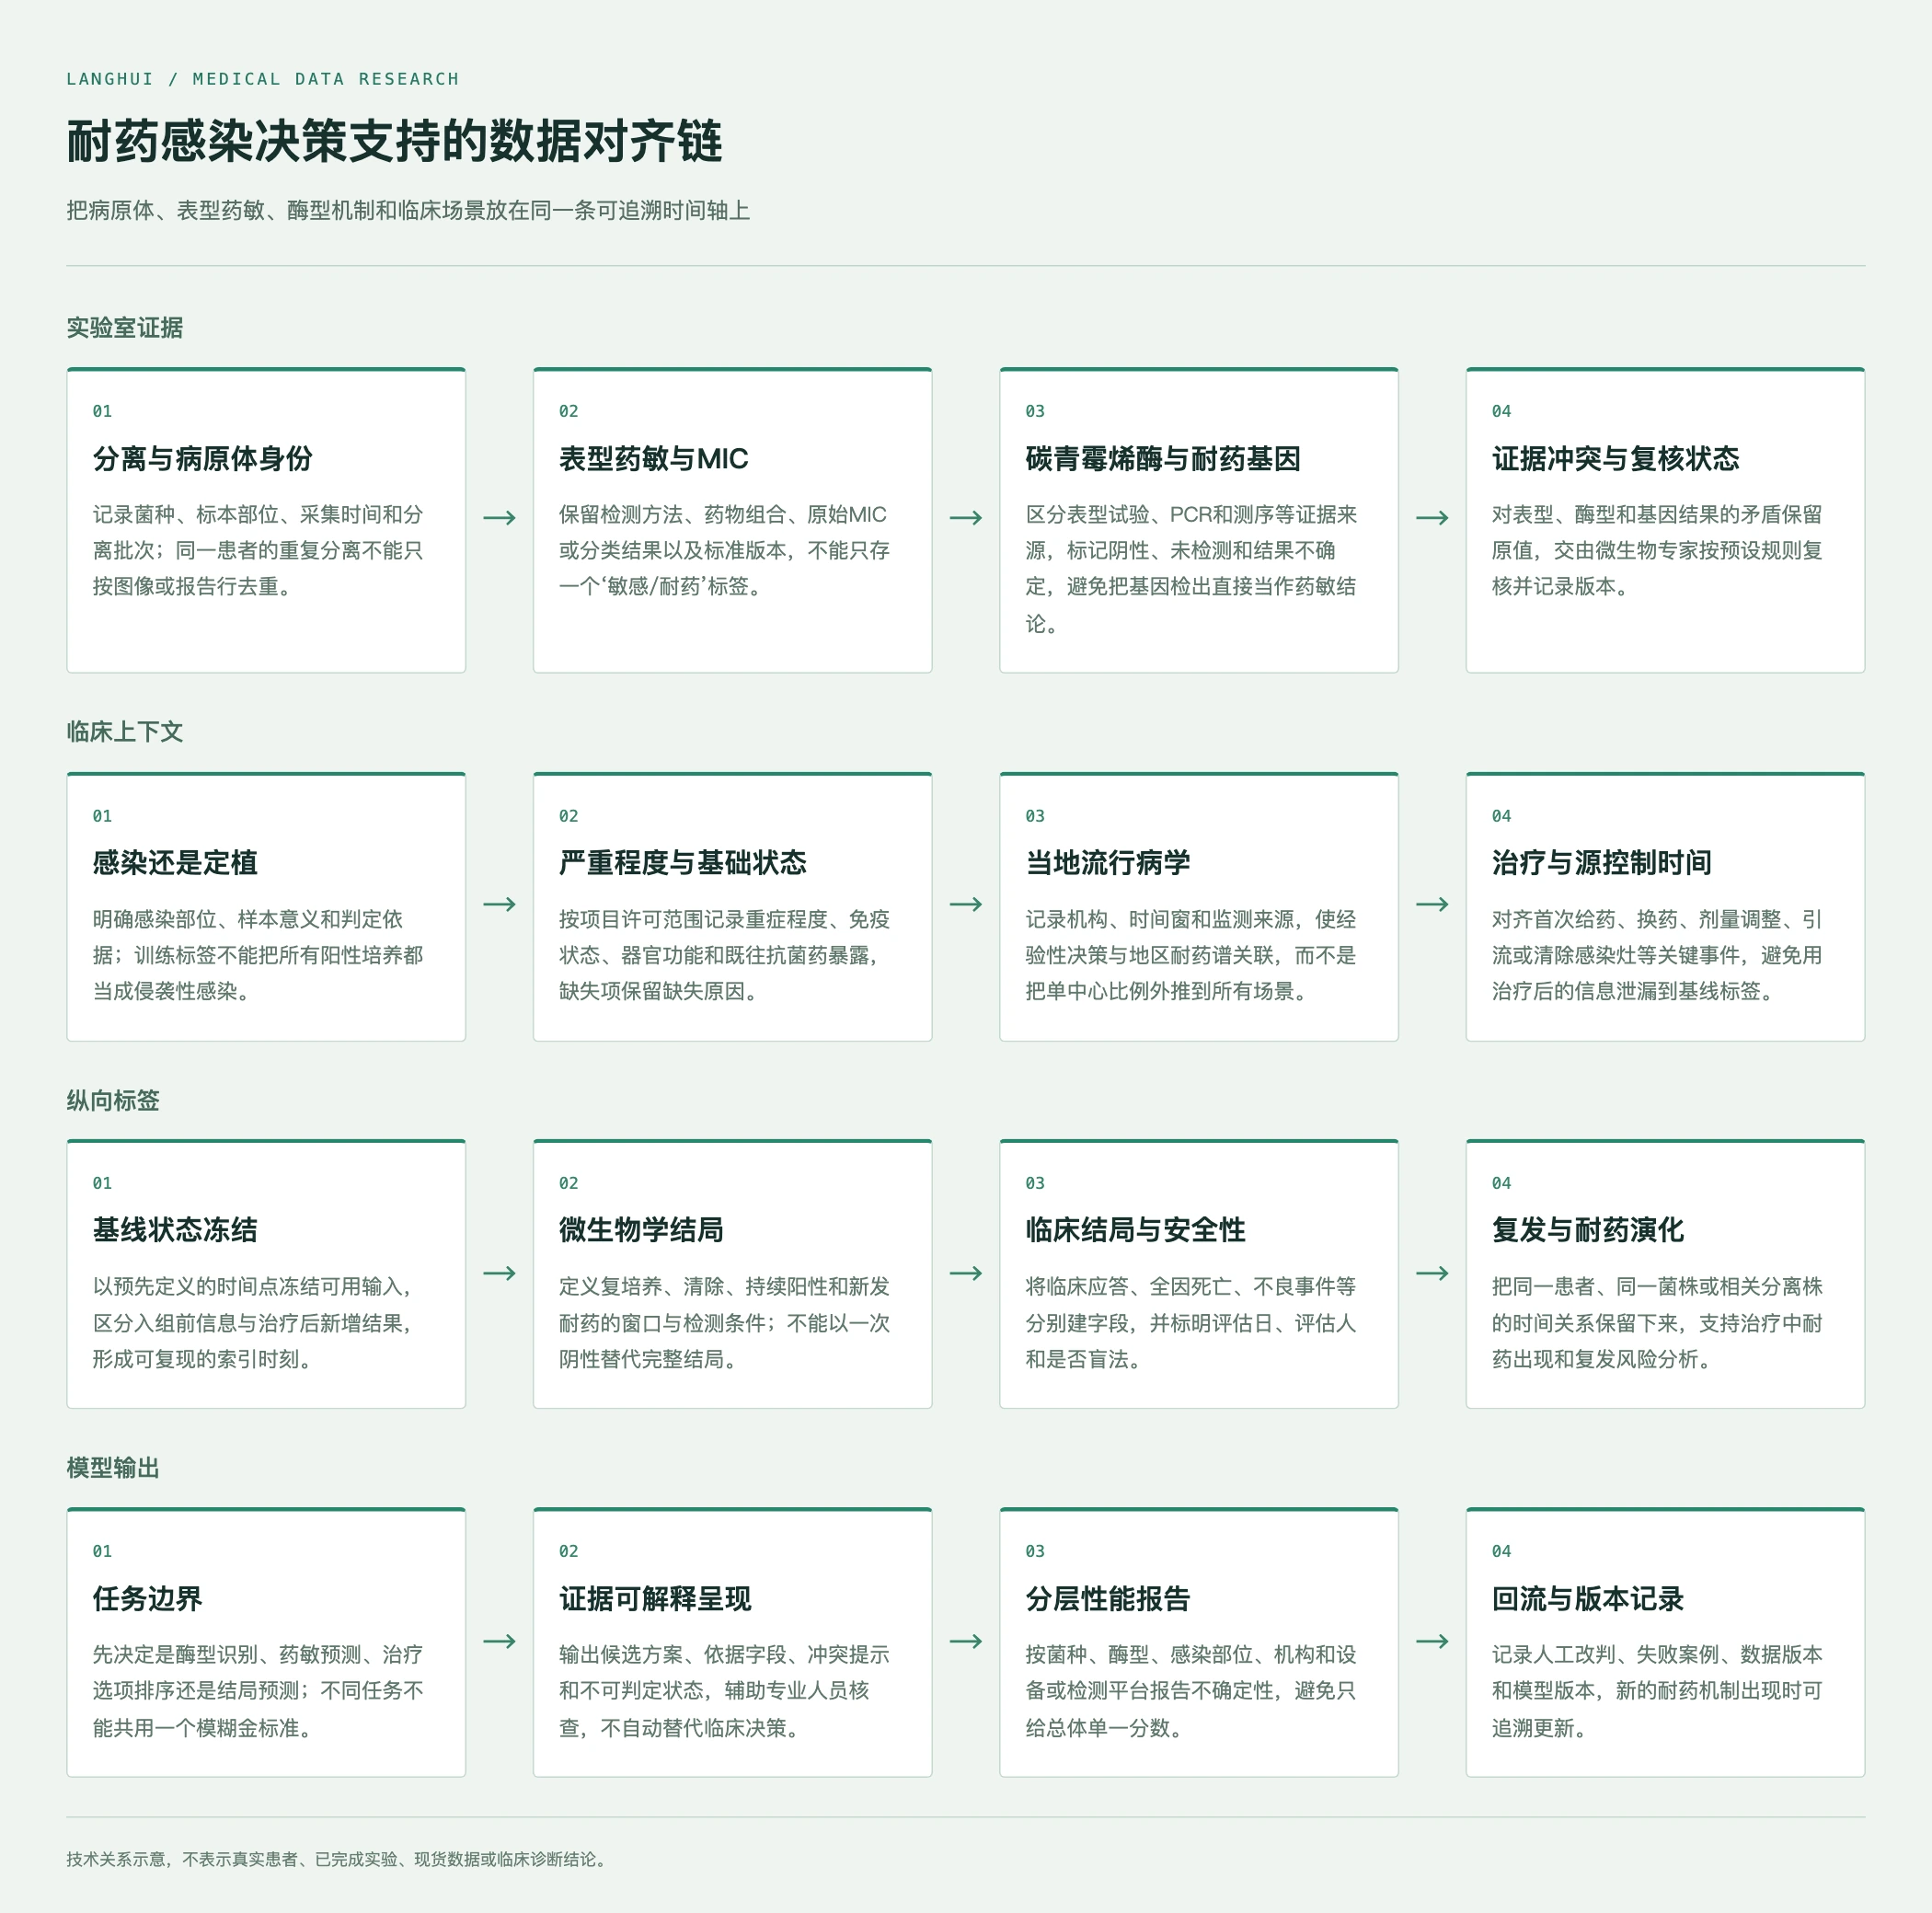
图1 病原学到决策支持的数据对齐链。技术示意,不表示真实患者、已完成实验、现货数据或临床诊断结论。
输入不是一张表,而是一条有时间的证据链
病原体和标本要能回到原始事件
每一次分离都应有唯一事件标识,并记录菌种、标本类型、采集时间、送检时间、培养或鉴定方法以及与患者或住院事件的关联。对于同一患者的多次培养,不能简单按患者ID去重;它们可能代表初始感染、治疗中复查、复发或新发感染。若项目需要菌株层面的演化分析,还要区分同一分离株的重复检测和真正的新分离株。
感染和定植也不能靠关键词推断。阳性培养本身不等于侵袭性感染,标本部位、临床表现、影像或其他检验、污染可能性及医生判定都可能影响标签。数据交付可以保存“感染判定”“定植/污染可能”“无法判定”等状态,并保留判定依据;不应把不确定样本强行归入阳性类来提高样本量。
药敏字段要保留方法、原值和版本
药敏数据至少要包含检测方法、药物名称与组合、原始MIC或抑菌圈、重复检测关系、结果分类、检测时间和解释标准版本。对于β-内酰胺酶抑制剂复方制剂,还要明确药物组合对应的检测条件,不把单药与复方的结果放在同一个字段中。
数据卡应把“未检测”“检测失败”“不可判读”“结果缺失”和“真正阴性”分开。尤其是碳青霉烯酶未检测,不等同于未产酶;分子检测阴性,也不能自动推导出所有相关药物均敏感。共识特别强调,耐药基因检测需要与病原体关联并谨慎解释,不能直接替代表型药敏作为用药依据。1 这一点在数据设计中对应的是证据来源分层,而不是再增加一个看似完整的标签。
酶型与基因需要区分“检出”与“作用机制解释”
碳青霉烯酶表型检测、PCR、数字PCR和测序回答的问题不完全相同。表型试验可以提供酶活性层面的证据,分子检测可识别目标基因,但基因是否位于目标病原体、是否表达、是否与表型耐药一致,都需要结合样本和方法解释。数据模型应分别记录检测技术、靶标、结果、阈值或判读规则、实验批次和复核状态。
对机制标签,推荐使用分层结构而不是单列字符串。第一层是“证据类型”,第二层是“酶类或基因类别”,第三层是“具体变体或检测靶标”,第四层是“与表型结果的一致性”。这样既能支持按KPC、MBL、OXA-48样等组别分析,也能把不确定和矛盾样本保留下来。若后续研究要识别治疗压力下的机制变化,还必须把同一患者的不同时间点放回纵向关系中。
临床上下文决定输入何时可用
模型开发时应先冻结索引时刻。例如,做经验性治疗支持时只能使用首次给药前已经可获得的信息;做治疗中耐药预警时,才可以使用随访培养和用药暴露。首次给药时间、培养采样时间、药敏结果可报告时间和换药时间不能只保存日期,最好保留精确到项目实际可用粒度的时间戳及其来源。
感染部位、重症程度、免疫状态、器官功能、既往抗菌药物暴露、源控制和当地流行病学应作为结构化字段或可审计的受控文本。缺失时记录“尚不可得”比填入默认值更诚实。经验性治疗的输入空间与靶向治疗的输入空间不同,二者若混在一起训练,模型可能偷偷依赖治疗后信息,离线表现很好,真实使用却无法复现。
标签要由证据和专家协作产生
先定义参考标准,再讨论标注人选
耐药机制、感染判定、药敏结果和治疗结局的参考标准不同。药敏可依赖规定方法和标准版本;酶型可由表型与分子证据组合判定;感染标签需要结合临床上下文;结局则需要预先规定观察窗口和判定规则。一个项目不能用“资深专家看过”替代所有参考标准的定义。
标注规范应写出阳性、阴性、未知、不可判定、冲突和不适用的具体含义,并给出难例示例。标注者应分别说明学科背景、培训方式、使用的标注软件或数据界面,以及是否能看到预测结局。对于治疗决策相关标签,感染病、微生物、临床药学和重症等角色可能关注不同风险,应预先写明谁负责初判、谁处理分歧、谁批准最终版本,而不是在交付后临时讨论。
盲审和冲突处理应留下原始轨迹
如果标注者知道患者后来使用了哪一种药或是否死亡,可能产生回顾性偏倚。对需要预测的标签,宜在可行时采用时间顺序冻结输入,并让结局判定与预测特征分离。独立标注后,保留每位标注者的原始结果、分歧字段、讨论结论、复核人、时间和规则版本。最终标签应能回溯到证据,而不是只保留一个覆盖原值的“正确答案”。
一致性也不能只报一个总体比例。不同酶型、不同标本、不同感染部位和不同检测平台的分歧可能很不均匀。应分别报告难例来源,必要时把“需要专家复核”作为正式输出类别。这样做会减少可用样本,但能避免把专家不确定性伪装成确定标签。
STARD-AI强调,AI诊断研究应明确数据来源、数据集与受试者纳排、标注、采集设备和软件版本、预处理、训练验证测试分区以及测试集是否代表目标条件。8 对耐药感染数据而言,这些要求同样适用于实验室检测设备、药敏平台、分子检测流程和临床记录的时间关系。
算法路径要服从临床任务,而不是反过来改标签
机制识别与药敏预测不是同一个模型
机制识别可以做多标签或层级分类,但要处理共存机制和检测缺失;药敏预测通常需要面对MIC分布、检测平台差异、类别不平衡和解释标准变化。治疗选项排序则不是纯粹的分类问题,它还涉及禁忌、可及性、感染部位、源控制和证据强度。将三者合并为一个“推荐药物”标签,会遮蔽模型到底学到了什么,也让验收无法对应临床工作流。
更稳妥的路线是先建立结构化证据层,再建立任务层。证据层只保存可回溯的病原、药敏、酶型、时间和上下文;任务层依据预先定义的输入截止时间生成特征。对于输出,除了概率或排序,还可以返回使用了哪些字段、哪些字段缺失、哪些证据冲突以及是否超出适用范围。若输出需要供专业人员审阅,界面应允许查看原始MIC、检测标准版本和专家复核记录。
纵向数据最容易造成隐性泄漏
将同一患者不同时间点随机分到训练集和测试集,会让模型在测试时见过高度相似的个体、菌株或治疗过程。对纵向分离株,还要考虑同一菌株或近缘菌株跨分区的问题。切分单位应在项目开始前决定,是患者级、感染事件级、分离株级,还是中心和时间双重留出,并写入数据卡。
治疗后的药敏、换药、结局和复培养结果只能在与任务匹配的时间点进入特征。做首次治疗选择预测时,不能把后来获得的酶型或治疗应答作为输入;做治疗中耐药预警时,才可按滚动时间窗使用新增信息。每个预测时刻都应有可用字段清单,开发集和外部测试集采用同一套规则。
TRIPOD+AI要求报告开发与评价数据的来源、收集时间、中心和纳排条件,明确预测结局及时间范围,说明缺失值处理、分区、模型开发、校准、临床效用、群组异质性和外部评价。7 这些不是发表后的形式工作,而是数据采购前就应写进项目规格的验收条目。
性能要按机制和场景拆开
总体AUROC或总体准确率不能说明模型对少见酶型、CRAB或DTR铜绿假单胞菌是否有用。至少要按菌种、酶型类别、感染部位、样本类型、检测平台和中心报告结果,并给出置信区间、缺失处理和类别不平衡策略。治疗结局研究还需要说明比较基线、治疗暴露定义、时间窗、是否调整混杂以及哪些分析属于探索性。
对于排序或决策支持任务,可以验收候选选项的覆盖率、不可判定率、证据字段完整率和专家复核后一致性;对于药敏预测,可以验收原始MIC重现、分类一致性和难例召回;对于结局预测,除了区分度,还要看校准和不同中心的性能漂移。具体阈值应由项目书面约定,不把论文中的结果或建议阈值移植成朗慧的统一指标,也不把一次研究结果说成公司已有临床效果。
研究证据要保留适用人群和终点
新型β-内酰胺酶抑制剂复方制剂的研究不能只按“新药有效”概括。WHO 2024重点病原体清单把耐最后线抗菌药物的革兰阴性菌列为需要研发与防控投入的重点对象,但它的定位是公共卫生和研发优先级,不是某个患者的处方建议。2
ATTACK研究比较舒巴坦-度洛巴坦与多黏菌素时,目标是严重的鲍曼不动杆菌复合体感染,研究人群、对照方案、疗程、临床结局、微生物学清除和肾毒性都属于结果解释的一部分。4 因此,数据集若要支持CRAB相关模型,应把病原体、感染部位、联合用药和安全性终点分开采集,而不是只留一个“治疗成功”。
CERTAIN-1针对复杂尿路感染和急性肾盂肾炎,主要分析人群以符合微生物学条件的受试者为基础,复合终点同时要求微生物学和临床成功。5 这说明研究结局与适用人群紧密相连,不能把该研究结果直接外推到血流感染、肺炎或其他感染部位。
REVISIT是多国、开放标签、描述性III期随机研究,涉及严重革兰阴性菌感染,并对复杂腹腔感染、医院获得性肺炎、呼吸机相关肺炎和血流感染等场景进行描述。6 其研究设计本身就提示:当特定酶型样本较少时,文章应明确证据稀疏和外推限制,而不能用一个总体结论覆盖所有感染部位。
从数据交付到可复核验收
一个可用的数据项目,验收对象不应只是文件数量或一个总体准确率,而应围绕临床任务建立四本账。
第一本是来源账。要能说明数据授权和去标识化边界、样本来源类型、纳排条件、采集与检测时间、检测平台和标准版本。涉及患者或机构的原始身份信息不能进入公开稿,也不能为了讲案例而复述。
第二本是标签账。要能回放病原体身份、感染或定植判定、药敏原值、酶型证据、专家分歧、参考标准和最终标签版本。对于“未检测”“缺失”和“阴性”的区别,应有字段级规则和抽检样例。
第三本是算法账。要能复现预处理、切分、特征截止时间、模型版本、阈值或排序规则、训练和外部测试过程。测试集应在模型定稿前锁定,后续改判需要有审批和原因。外部验证若不存在,应在交付说明中明确,而不是用内部留出集替代。
第四本是业务账。算法工程师关注指标与失败回流,医学专家关注标签逻辑与证据,采购或信息部门关注权限、格式、交付版本和合同边界。三本技术账与业务账要互相对照,但任何一方都不能替代另一方。适合公开讨论的价值,是把这些可复核的条件写清楚,而不是宣称已经拥有某规模的现货样本、某医院合作或某临床产品。
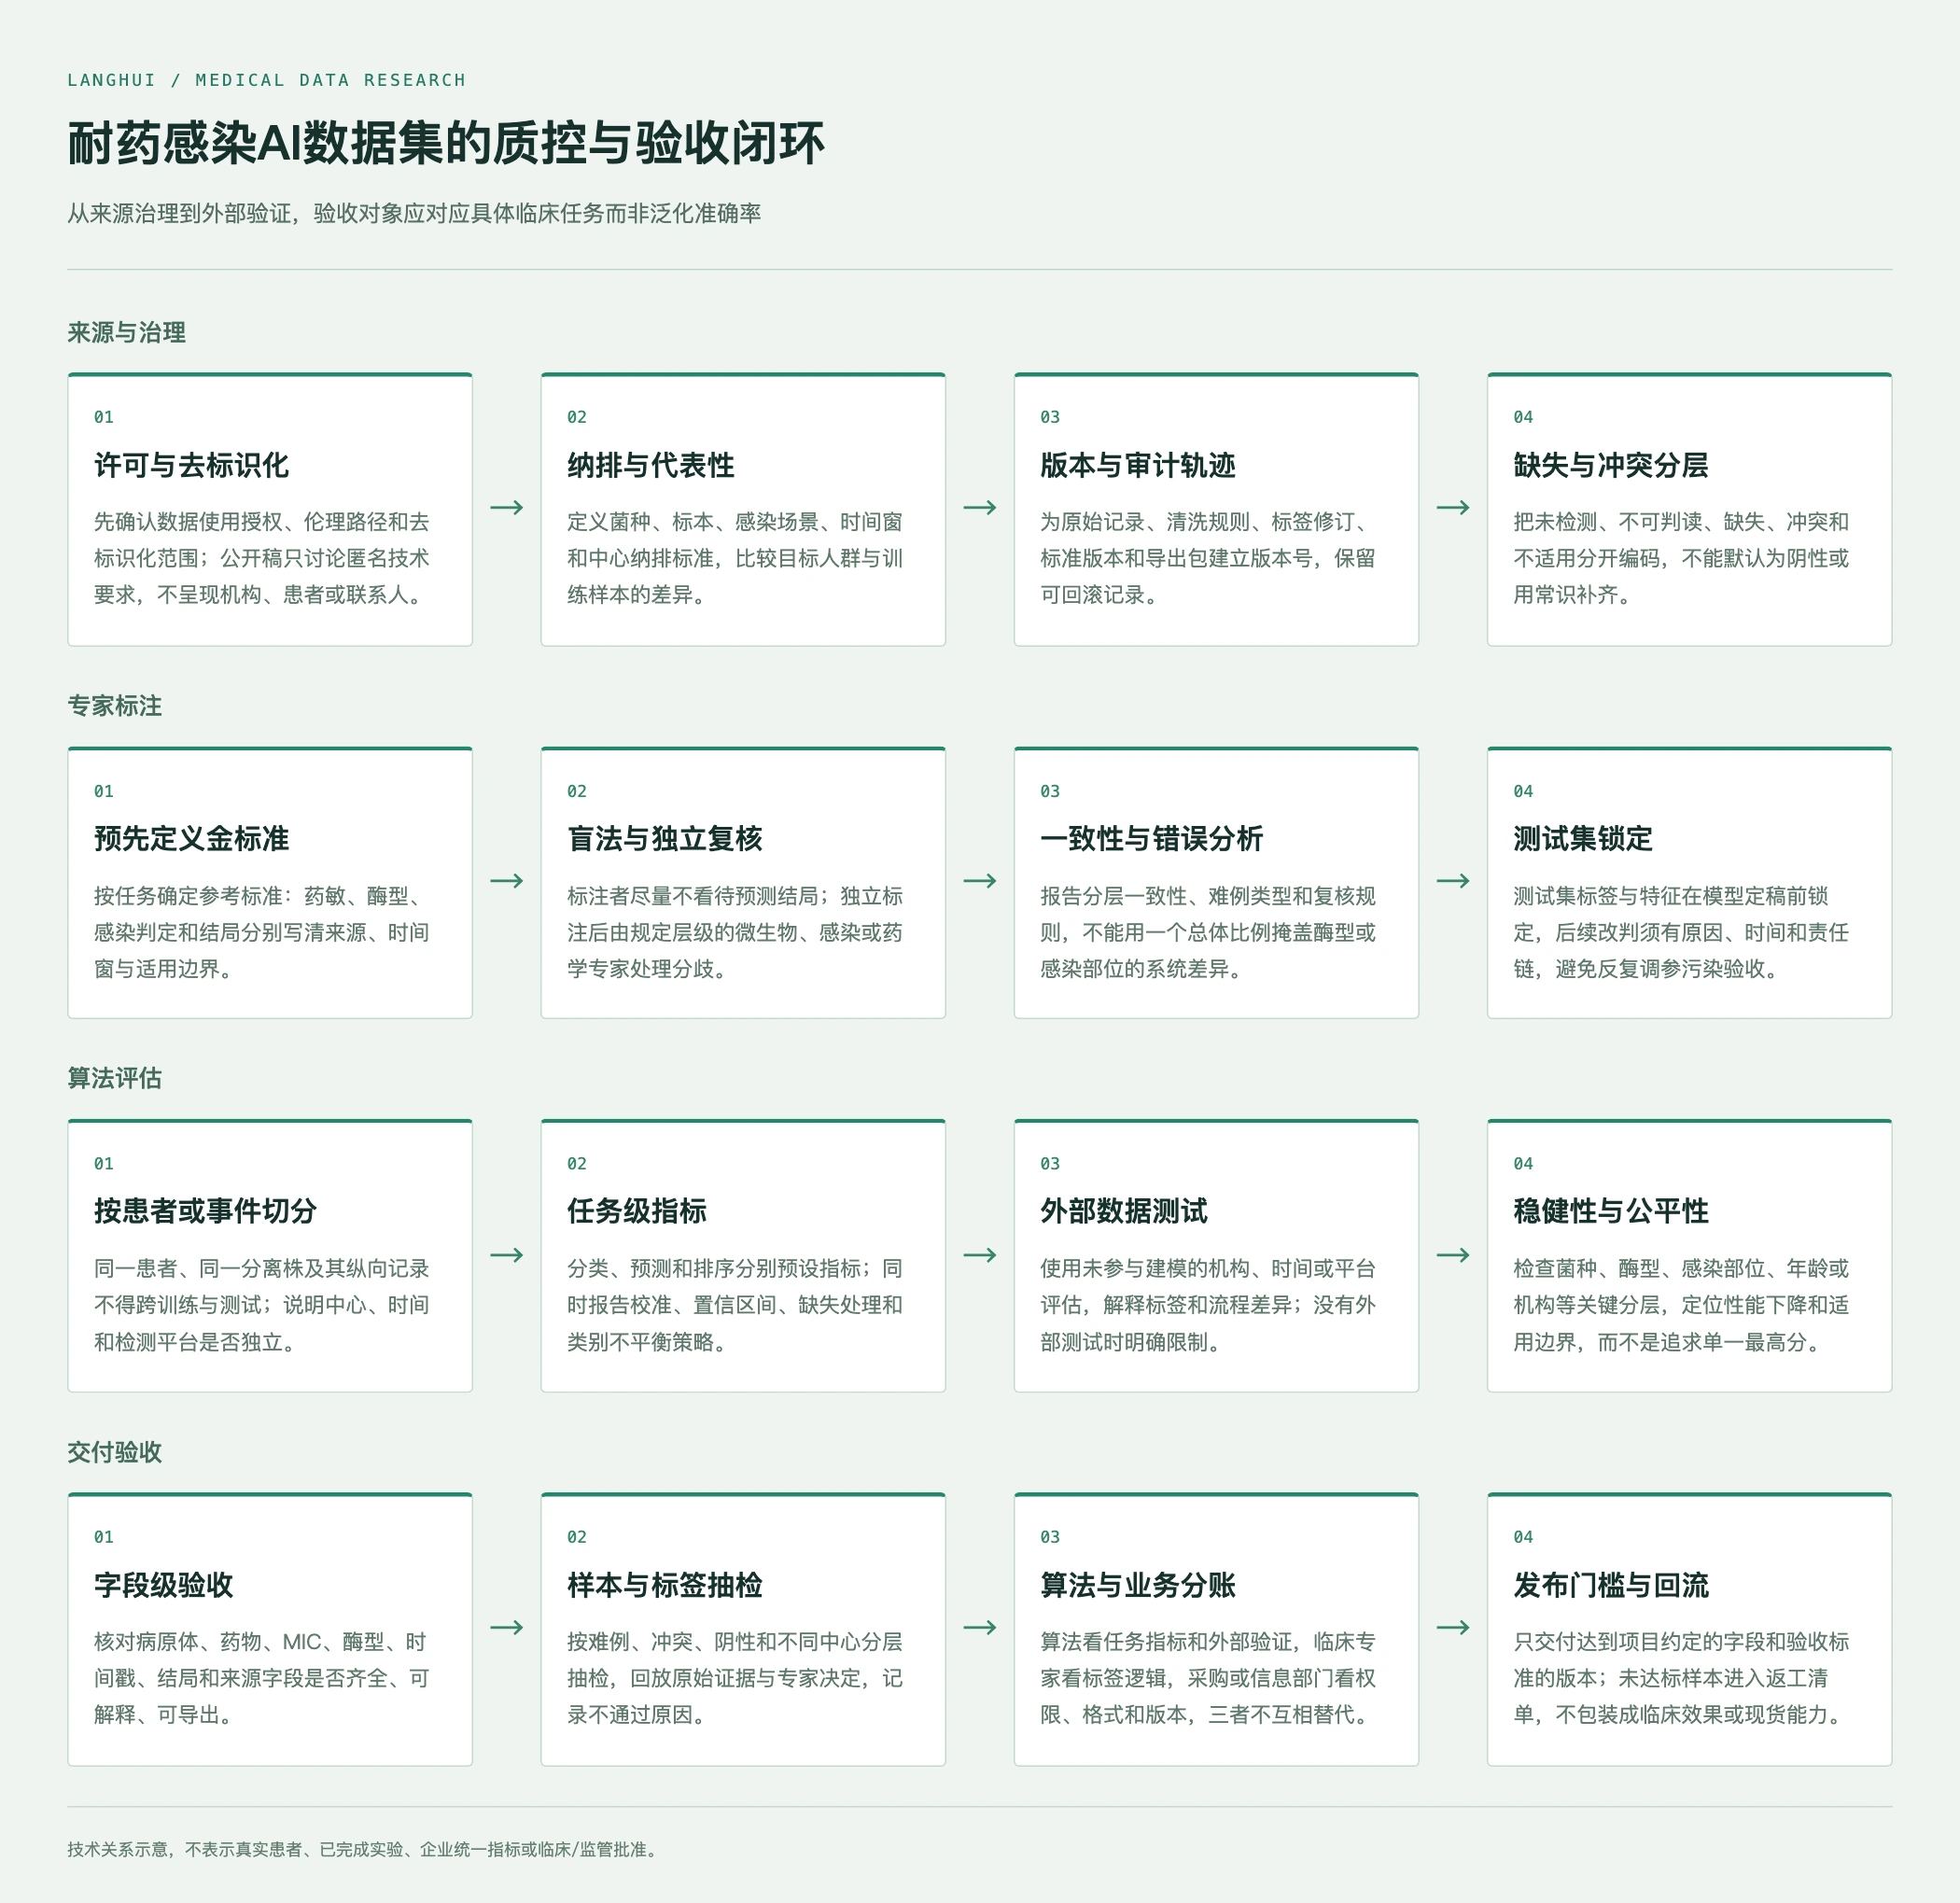
图2 耐药感染AI数据集的质控与独立验收闭环。技术示意,不表示真实患者、已完成实验、企业统一指标或临床/监管批准。
对朗慧而言,公开能力边界应放在项目规格、数据卡、样例评估、标注质检记录、版本化交付和研发支持上。战略材料将LangData定位为覆盖采集、处理、标注、质检和数据交付的AI数据基础设施与流程服务;这可以支撑面向医疗AI团队的需求拆解和交付讨论,但不等于公司拥有某种抗菌药物现货数据库、已经完成临床验证,或能够替代医院和专业人员作出治疗决定。实际授权、规格、周期和交付状态仍应以书面项目确认与合同为准。
把医学共识转成研发资产
这份共识最适合转化为“证据结构和验收规则”,而不是被压缩成一张药物对照表。研发团队可以先从明确的菌种、标本、药敏、酶型和时间轴开始,再逐步加入感染场景和结局;数据供应方则应在项目开始时说明哪些字段能够提供、哪些字段需要专项采集、哪些结局需要额外授权或专家判定。
如果一个项目无法说明标签的参考标准、输入的截止时间、同一患者的切分关系、专家分歧如何处理和外部验证如何完成,就不应以“模型能识别耐药”作为验收结论。相反,一个能够回溯原始证据、保留不确定性、按场景报告结果并在版本变更时可重现的数据资产,即使不承诺临床效果,也更接近真实研发需求。
医疗AI的专业价值不在于把复杂临床问题包装成一个漂亮分数,而在于让每一个输入、标签、输出和限制都能被复核。对耐药感染这一高风险领域,先把证据链对齐,再谈算法和业务落地,是比堆叠规模、指标或营销术语更可靠的起点。
参考来源
- 新型β-内酰胺酶抑制剂复方制剂临床应用专家共识(在线优先/In Press,未同行评审)
- WHO bacterial priority pathogens list, 2024: Bacterial pathogens of public health importance to guide research, development and strategies to prevent and control antimicrobial resistance
- IDSA 2026 Guidance on the Treatment of Antimicrobial Resistant Gram-Negative Infections
- Efficacy and safety of sulbactam-durlobactam versus colistin for the treatment of patients with serious infections caused by Acinetobacter baumannii-calcoaceticus complex
- Cefepime–Taniborbactam in Complicated Urinary Tract Infection
- Aztreonam–avibactam versus meropenem for the treatment of serious infections caused by Gram-negative bacteria REVISIT
- TRIPOD+AI statement: updated guidance for reporting clinical prediction models that use regression or machine learning methods
- The STARD-AI reporting guideline for diagnostic accuracy studies using artificial intelligence