
数据拿不出来
HIS、EMR、PACS、LIS 各自为政,数据出院有合规风险,跨科室调取流程长。
接入引擎:对生产系统只读、限流、错峰接入,数据留在院内。
Solution · 朗慧医数 MedData 一体机
朗慧医数一体机把医疗数据治理、医学影像标注和科研平台装进同一台院内设备。原始临床数据在本地完成接入、清洗与脱敏,自动进入标注平台,经 AI 预标注和专家终审,按规则生成可训练、可科研、可评测的数据集。
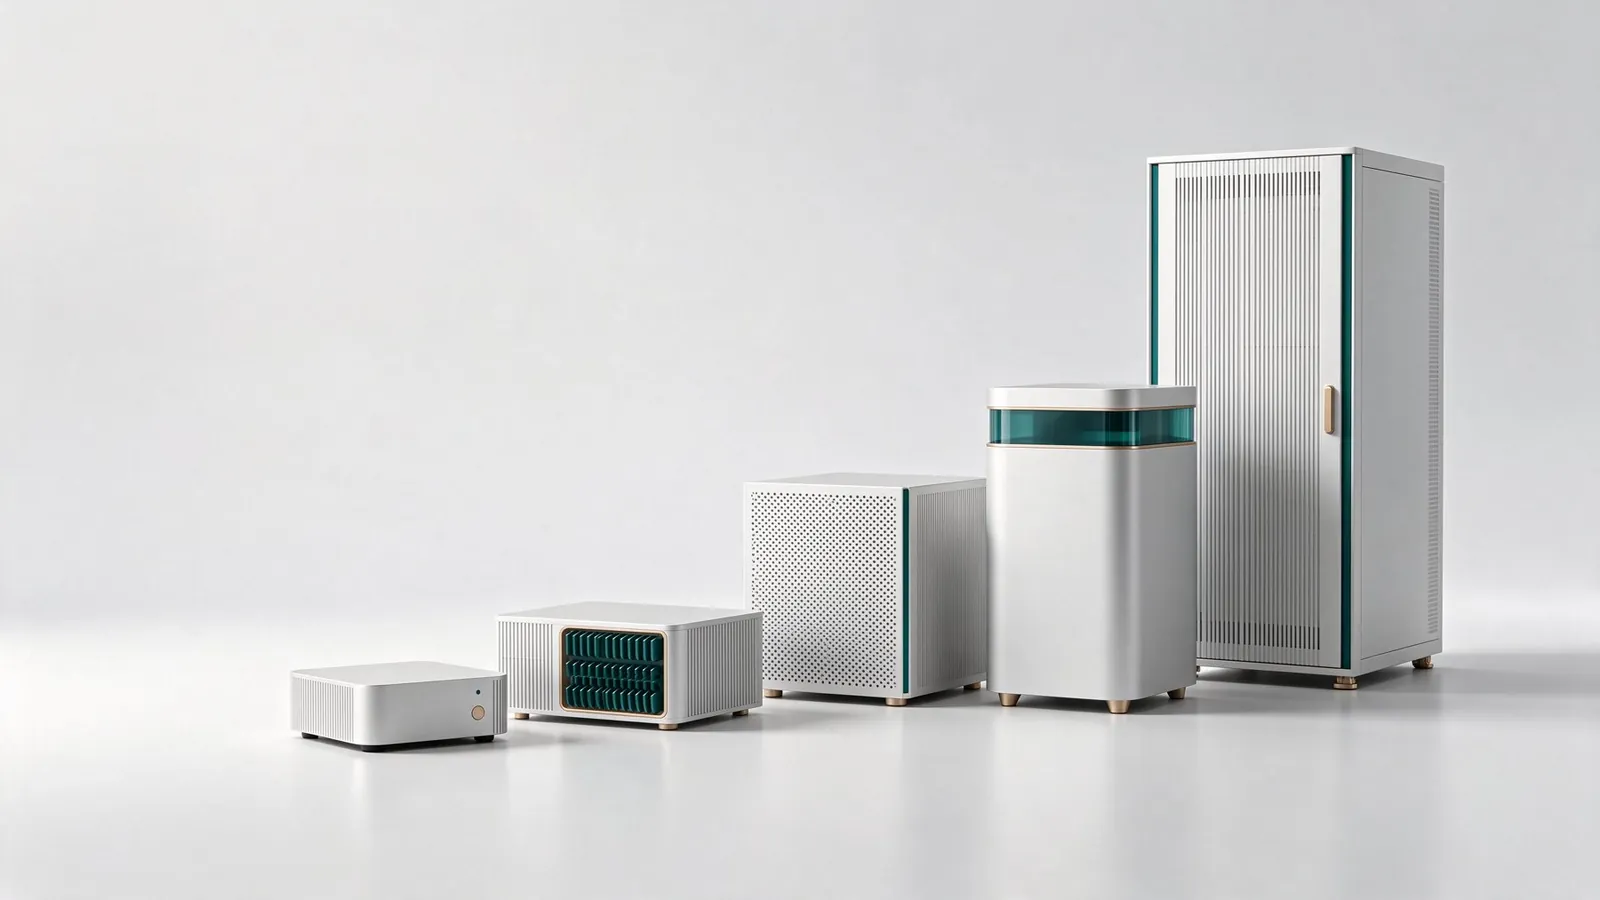
原始数据、脱敏数据和标注结果都留在院内。默认断外网,导出须审批、带水印、留审计。
GPU 内置于一体机,预标注、训练和评测在本地完成,不依赖公有云排队。
每份数据集附数据卡、版本号、抽检记录和审计日志,便于复核与验收。
Why now
医疗 AI 与临床科研的瓶颈,往往不在算法,而在数据准备。我们把这条链路上最常见的四个卡点,逐一变成一体机里的标准能力。
HIS、EMR、PACS、LIS 各自为政,数据出院有合规风险,跨科室调取流程长。
接入引擎:对生产系统只读、限流、错峰接入,数据留在院内。
字段不统一、缺失与异常多、隐私信息混杂,清洗工作反复做、无人沉淀。
治理引擎:可视化配置清洗与脱敏规则,保存为“治理配方”自动运行。
依赖研究生和外包逐例勾画,口径不一、难以复核,专家时间被大量消耗。
标注平台:AI 出初稿、专家修订终审,只导出已审核数据。
专病库建好没人维护,PI 拿数据难,长时序、多模态研究数据搭不起来。
科研工作台:按数据结构自助建队列,成果与数据一起沉淀。
One closed loop
“接入 → 治理 → 标注 → 数据集 → 科研 → 评测”六个环节运行在同一台设备、同一套权限和同一条审计链上,环节之间自动流转。
数据工程师在“数据结构配置器”里选择源表与字段,映射到医数通用数据模型(CDM),配置清洗与脱敏规则,保存为治理配方。
私有算力池按标注规则包自动调度预标注任务。高置信结果进入抽检,低置信结果交专家精标,难例回流用于模型迭代。
科研人员在工作台按需调用已授权数据集,用横断面、纵向队列、高频时序、事件序列、多模态配对五种数据结构搭建研究数据。
Device line-up
全系设备运行同一套 MedData OS,按机构规模、数据量、并发和部署位置选择形态。标准版与信创版采用独立 BOM。
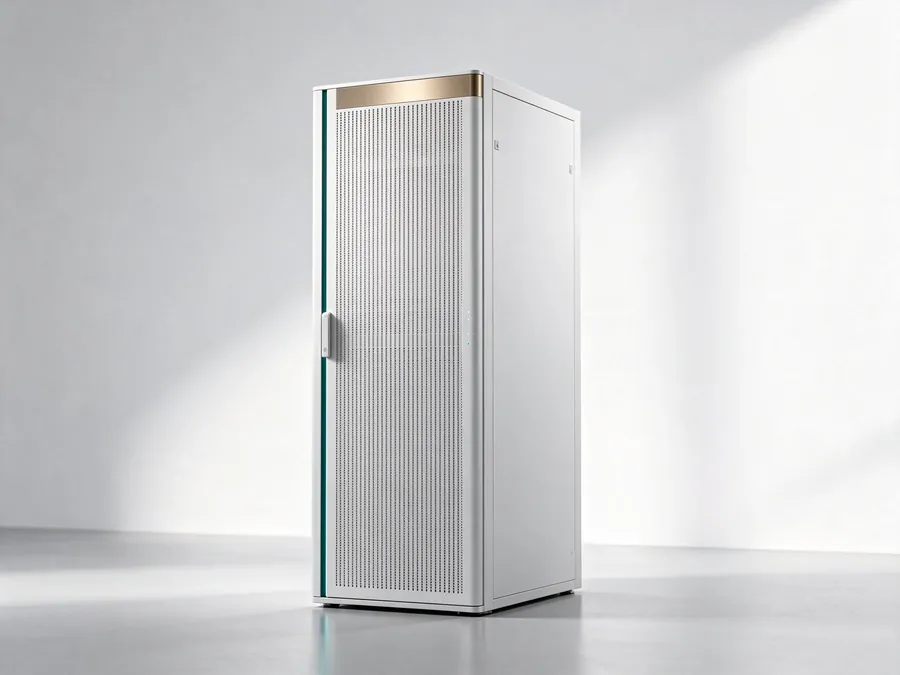
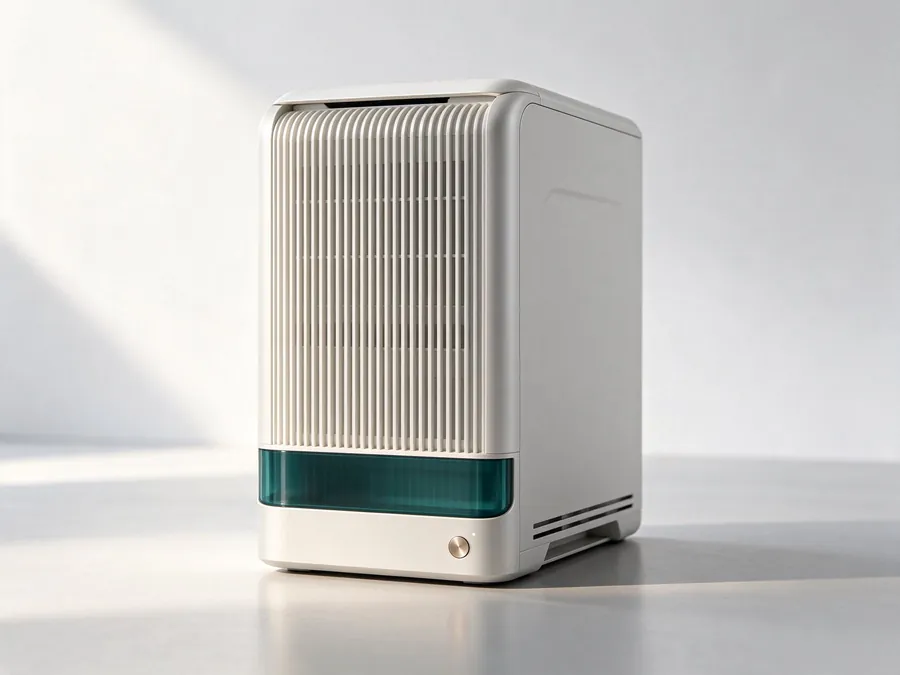
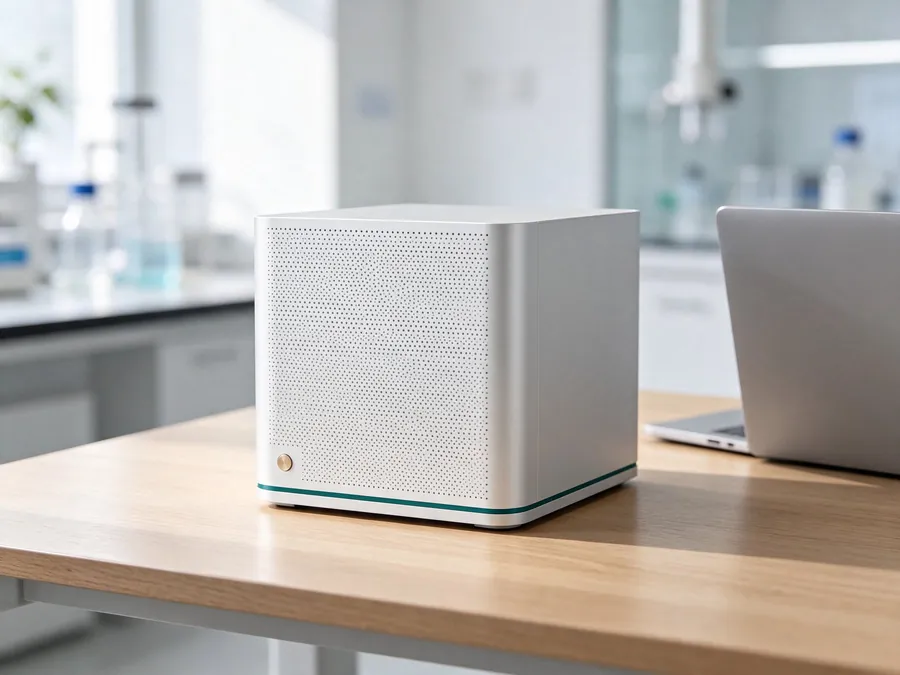
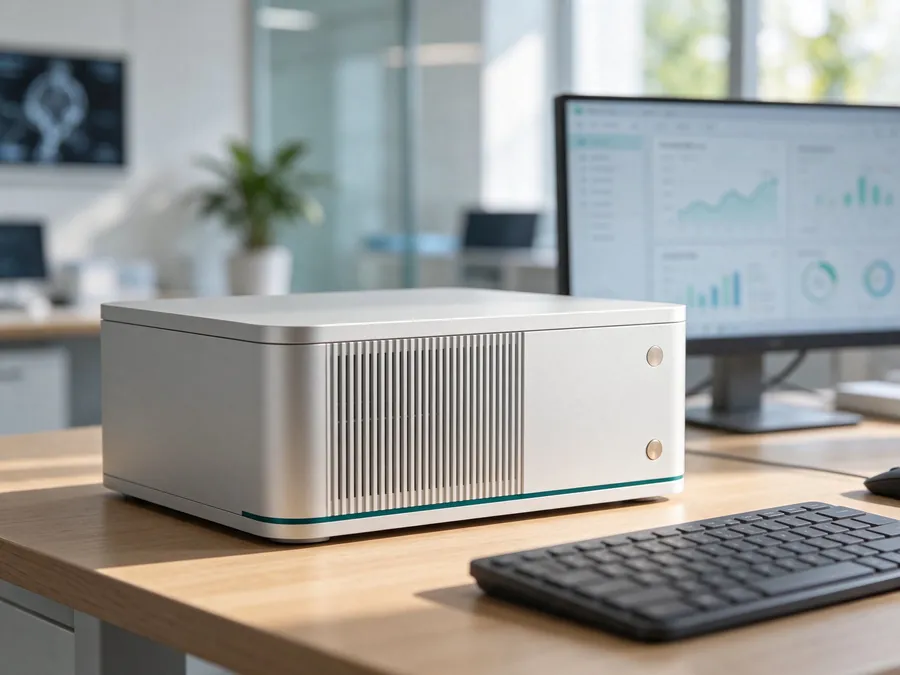
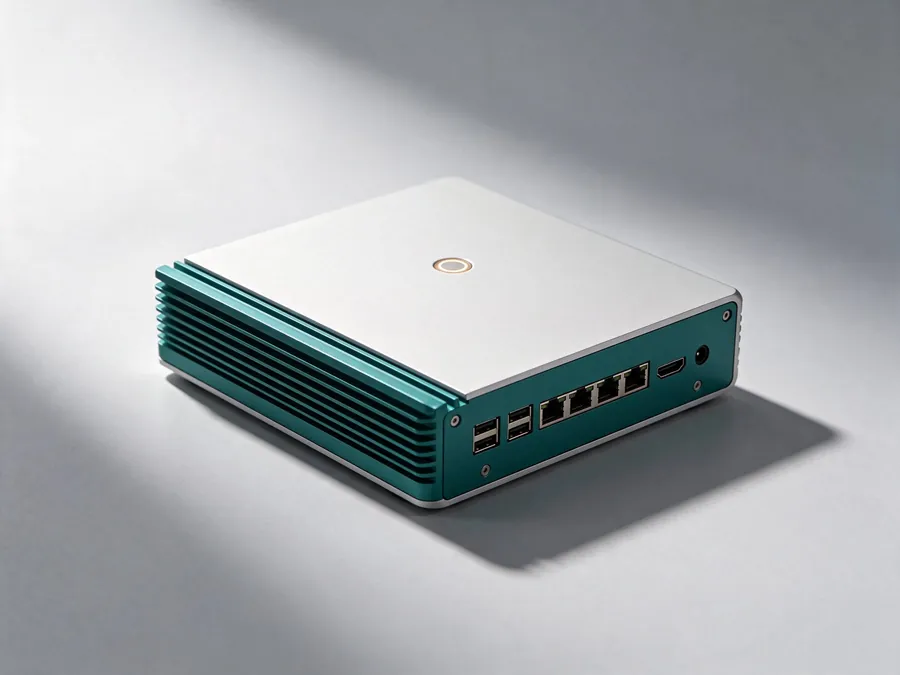
图片为产品概念渲染图。具体配置、算力与存储规格按项目核定,以合同技术附件为准。GPU 数量不等同于数据产出速度,交付效率还取决于接口开放度、专家排期与标注规则。
MedData OS
MedData OS 医数操作系统覆盖数据生产全链路,并以三类能力包(专病包、规则包、模型包)把专家经验产品化,做到开箱可用、按需扩展。
解决:数据拿不出来
DICOMweb、DICOM C-FIND/C-MOVE、HL7 v2、FHIR R4、JDBC/ODBC、CDC 增量;全量、增量与定时同步,对生产系统只读。
解决:拿到了不能用
数据结构配置器、DICOM 去标识、文本隐私识别、日期偏移、术语标准化(ICD、SNOMED CT、LOINC 等)、质量六维评分与数据血缘。
解决:数据散、找不到
资产目录、患者时间轴、专病库(纳排规则、CRF 字段、随访节点)、标签体系与元数据检索。
解决:标注贵、质量不稳
即朗慧医疗标注平台:186 个预置模型出初稿,专家修订与单盲/多盲审核,状态机全程可追溯。
解决:数据集不是“产品”
数据集配方 = 队列 + 标签 + 切分 + 格式;防泄漏分层切分,版本、校验和与数据卡自动生成。
解决:科研人员用不起来
拖拽式队列构建、五种数据结构视图、基线表与生存分析、Notebook、低代码训练与实验跟踪。
解决:模型在本院数据上是否有效
冻结题集、隔离评测、分层指标与失败分桶;企业模型进院评测,数据不出院。医标榜即运行于此。
解决:算力分散、合规焦虑
GPU 池化与配额、按课题计量;RBAC/ABAC、三权分立、导出审批、水印、全链路审计、国密算法支持。
院内本地部署的医学大模型智能体:用自然语言写治理规则、建研究队列、起草标注规范和数据卡。所有输出可追溯到规则与数据,经人工确认后生效。
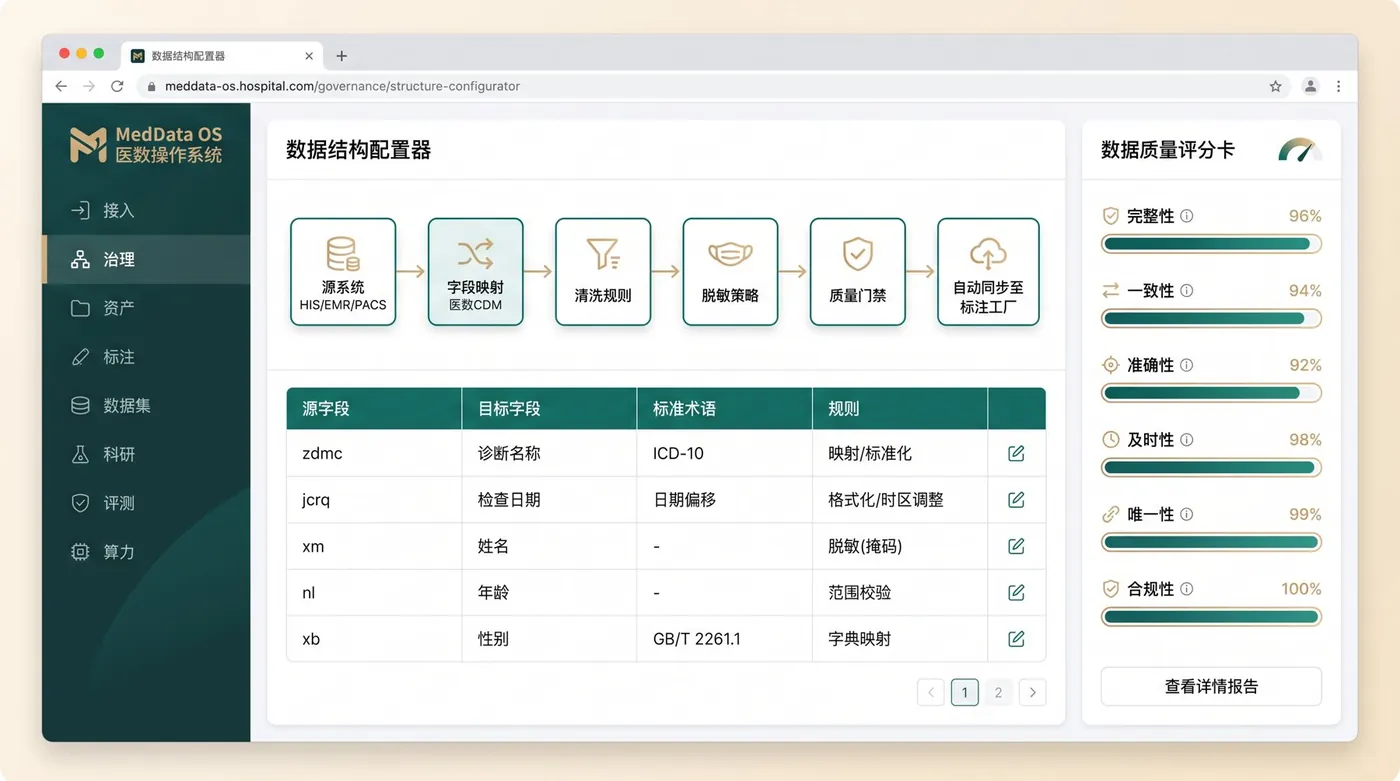
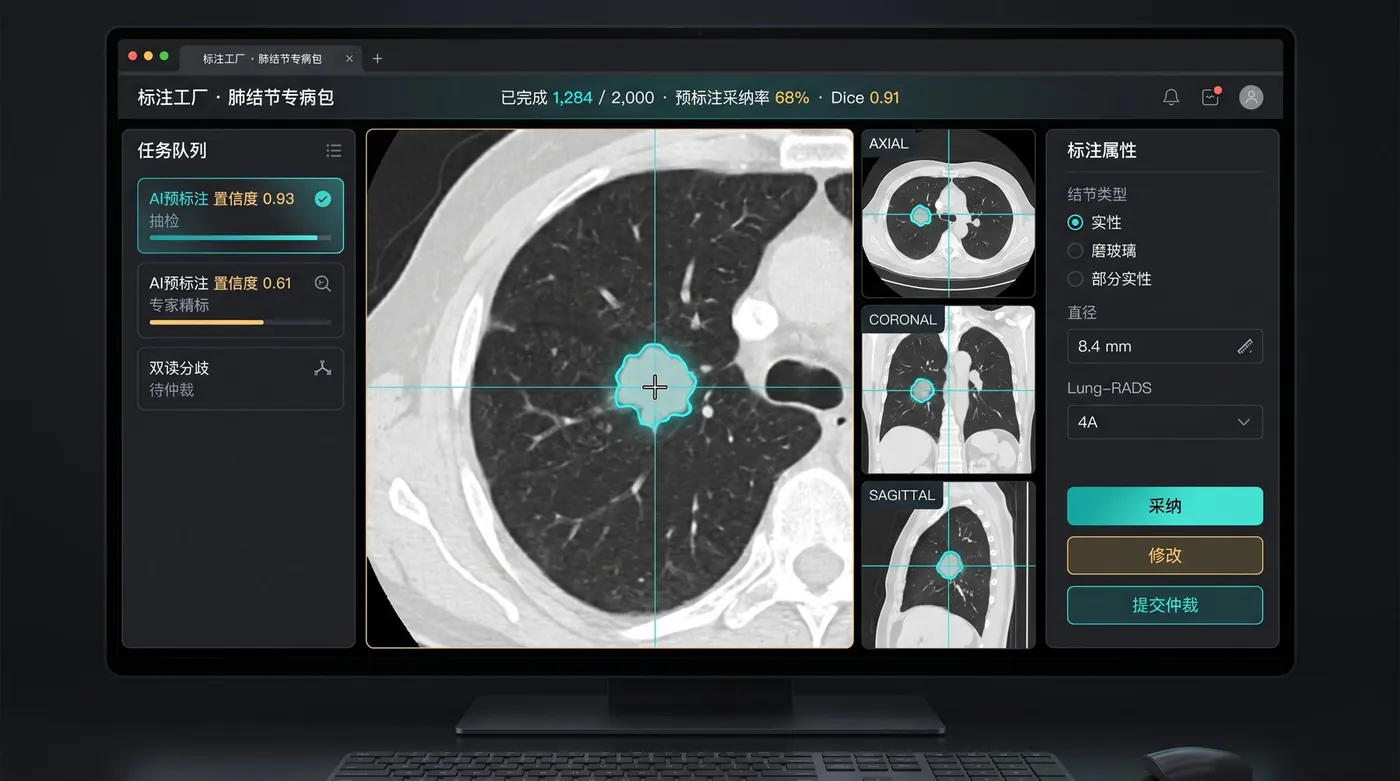
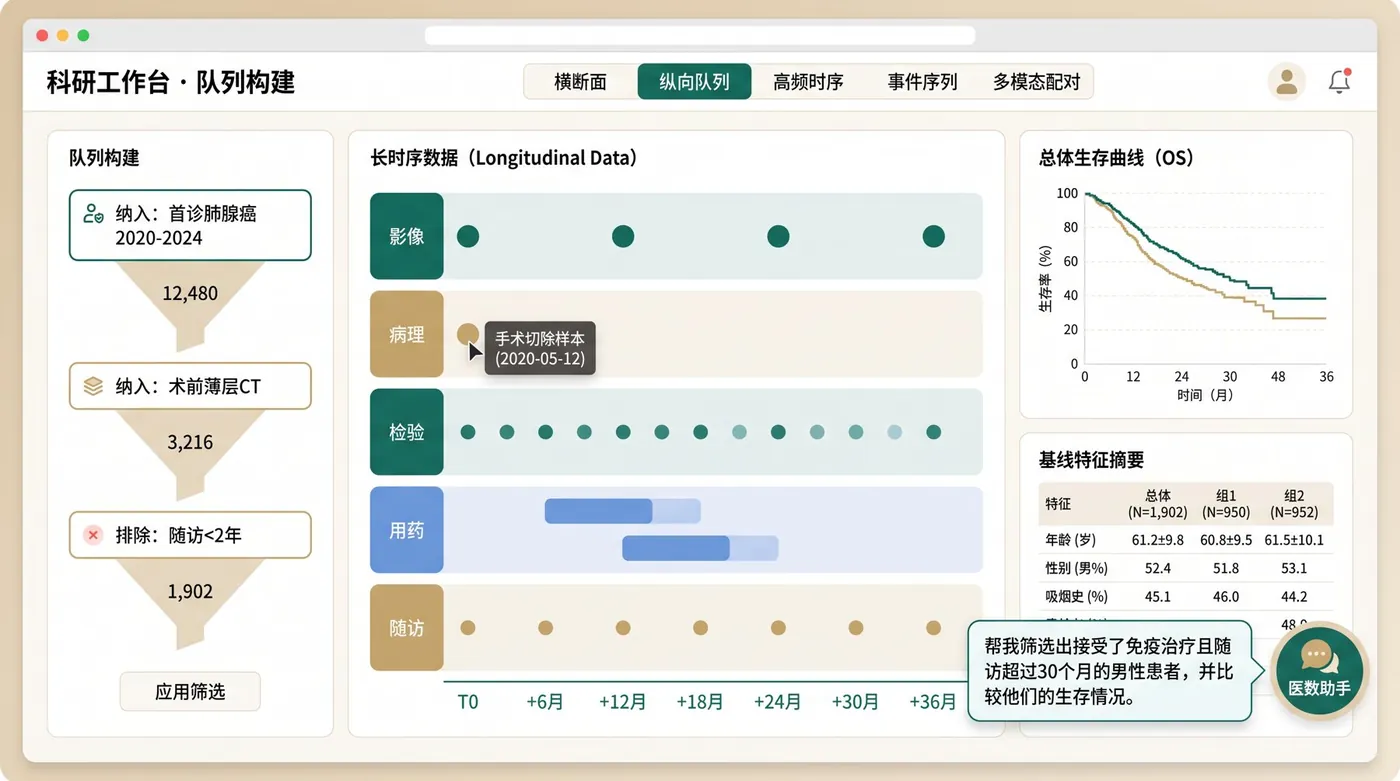
界面为设计示意,具体功能以交付版本为准。
| 版本 | 定位 | 包含能力 | 典型搭配 |
|---|---|---|---|
| 基础版 Essential | 先把数据治理好、标注起来 | 接入 + 治理 + 资产(基础)+ 标注平台 + 安全底座 | LAB / EDGE |
| 专业版 Professional | 数据集工厂与专病科研闭环 | 基础版 + 数据集工厂 + 科研工作台 + 专病库 + 3 个专病包 | LAB / STUDIO |
| 旗舰版 Enterprise | 全院 / 多中心数据工厂 | 专业版 + 私有评测 + 医数助手 + 多中心 / 联邦 + 可信数据空间连接器 | STUDIO / STATION |
一个专病的纳排规则、CRF 字段、标注规范、预标注模型、数据集配方与统计模板。首批规划覆盖肺结节/肺癌、脑卒中、肝癌、乳腺癌、甲状腺结节等方向。
主流 HIS / EMR / LIS / PACS 字段映射模板、脱敏策略模板、质量规则库,以及分割、检测、分类等标注规范模板。
器官与病灶分割预标注模型、医学影像与医学语言基础模型适配。可替换、可微调,模型留存在院内。
Built-in · 朗慧医疗标注平台
治理完成的影像自动进入标注队列。DICOM 入库、AI 自动标注、人工修订、单盲/多盲审核与版本化导出运行在同一条状态机上。
按官网模型清单统计。平台支持 CT / MR / PET · DICOM;US、MG 清单条目需按项目评估。
病灶类 10 个:肺结节、肺炎、肝肿瘤、胰腺肿块、结肠癌、胃癌、乳腺癌、左/右肾囊肿等。完整名称见 模型索引。
DICOM 自动识别,对接 PACS,上传即脱敏
批量推理,按结构点名,输出 Mask / Contour 草稿
像素级修订、MPR、PET-CT 融合;单盲/多盲
DICOM、DICOM-SEG、NIfTI、NRRD、Excel
草稿与终稿分开存储;失败样本回写精标,不覆盖已冻结批次。
MedLabel-Bench · 朗慧医标榜
公开榜单多考问答与报告生成,回答不了“模型能否完成像素级、三维、多序列的肿瘤标注”。医标榜用临床专家金标准评测标注能力:不比谁会聊天,比谁能画准、找全、标对。榜单评测运行于 MedData OS 的评测引擎,医院可在一体机上运行院内版医标榜。
影像模态:CT、MRI、X 线(DR 胸片、乳腺钼靶、骨关节平片)
癌种 / 部位,覆盖头颈与神经、胸部、腹部、盆腔、骨骼肌肉
“癌种 × 模态”子赛道,按样本量加权合成总分
T1T2T3T4T5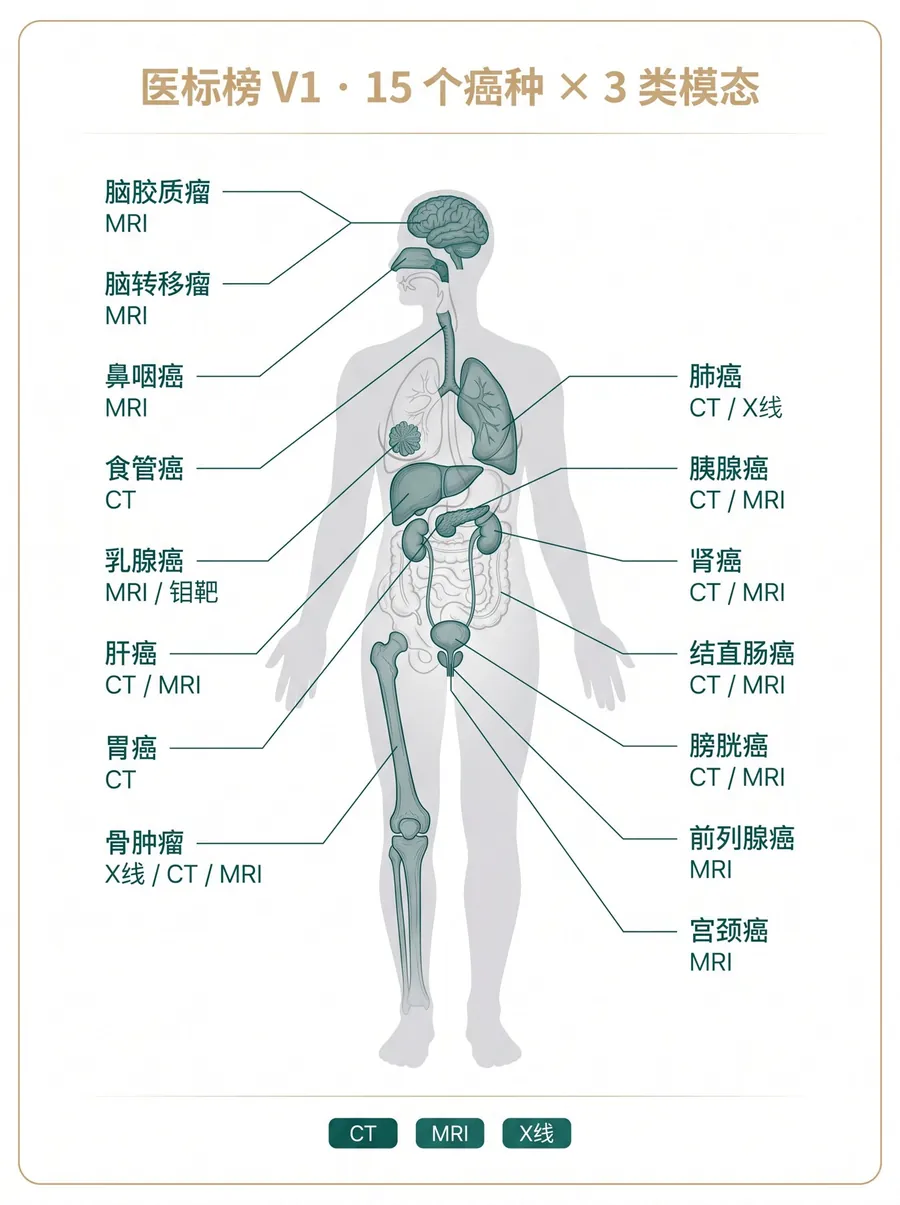
| 参评模型 | 机构 | 参评版本 | 发布时间 | 综合得分 | 95% 置信区间 |
|---|---|---|---|---|---|
| LumeLabel 医标模型 主办方模型 | LUMESAGE 朗慧 | V1 | 2026-11 | 公示中 | — |
| GPT-6.2 Astra | OpenAI | gpt-6.2-astra | 2026-11-17 | 公示中 | — |
| Claude Fable 5.2 | Anthropic | Claude Fable 5.2 | 2026-11-09 | 公示中 | — |
| Gemini 4 Carbon | Gemini 4 Carbon | 2026-11 | 公示中 | — |
参评版本为各家截至评测日的当期最强公开版本。主办方模型单独标注,与第三方模型使用同一协议、同一题集、同一时间评测;结果经学术委员会复核后公示,差异不显著的名次并列。境外闭源模型仅在已获授权可外部调用的评测子集上通过 API 评测,院内私有数据不出境。国产通用与医学大模型、开源医学影像基线(nnU-Net、MedSAM 类)于第二期纳入。
三维分割/检测骨干 + 多序列 MRI 融合 + 结构化属性头 + 面向工作流的置信度输出,在合规授权的多中心数据与专病包规则上做领域微调,并持续用专家复核结果主动学习。
通用多模态大模型擅长“看图说话”;标注任务需要三维体数据处理、像素级轮廓、多序列配准与稳定的结构化输出,检出与分割两项合计占 50% 权重。通用模型在判别与属性的文本推理部分仍有竞争力。
学术委员会负责题集保管与结果复核;评测代码、评分脚本、提示词与输出协议公开,结果可复算;测试集冻结、每期轮换 20% 题目并做训练集重叠检查;每半年一期。
Scenario solutions
每个方案统一按“客户画像 → 痛点 → 方案组成 → 业务流程 → 交付物 → 交付周期”组织,首单从一个专病或一个数据集开始。
专病库建了没人维护,PI 拿数据难,成果沉淀不下来。
推荐:STUDIO + 专业版 / 旗舰版 + 专病包 + DESK
影像量大但不能直接训练,标注靠研究生,口径不一。
推荐:LAB / STUDIO + 标注平台 186 个预置模型 + 影像模型包
病理全切片单张数 GB,存储与标注难度高。
推荐:LAB(大容量存储)+ WSI 定制模块(项目制,不属于标准标注平台)
ICU 波形与随访数据分散,长时序研究搭不起来。
推荐:LAB + 高频时序 / 纵向队列结构模板(按项目接入治理)
多中心数据标准不一,又不能集中汇聚。
推荐:STATION + EDGE × N + 旗舰版 + 联邦学习
算法团队缺合规临床数据,教学缺真实数据实训环境。
推荐:STUDIO + DESK × N(教学实训)
企业要数据、医院不能给;注册检验需要高质量测试集。
推荐:LAB / STUDIO(部署于合作医院)+ 评测引擎
缺少高质量中文临床语料、指令与偏好数据。
推荐:STUDIO + 语料工厂模块
回顾性队列构建慢,数据可溯源性不足。
推荐:LAB / STUDIO + OMOP 映射 + 统计模板
Delivery & compliance
先用一个任务验证数据能否在院内跑通,再扩展到专病包、院级底座和多中心网络。交付周期的前提是授权与伦理完成、接口开放、专家可排期。
入库、试标、盲审、导出跑通一个小样本任务,确认部署与网络边界、脱敏规则。
治理配方、标注规范、数据集配方与科研模板在真实数据上运行。
按任务书约定的验收指标逐项核对,交付数据卡、质控报告与审计记录。
单科室专病包 → 院级数据底座 → 多中心专病网络 → 数据产品与运营。
具体指标阈值以双方签署的任务书为准。
Start here
手机或邮箱至少留一项,机构信息可以后补。顾问在工作时段确认任务是否匹配,再安排 PoC 范围。
FAQ
标注平台解决“标得准、审得清”。一体机在此之前补上数据接入与治理,在此之后补上数据集工厂、科研工作台与评测引擎,并内置 GPU 算力与安全底座,让整条链路在院内同一台设备上自动流转。
不是。186 是预置 AI 自动标注模型的数量,不是病种数,也不是可立即交付的病例库存。其中器官与结构 176 个、病灶类 10 个;按清单模态为 CT 128、MR 56、US 1、MG 1。
标准标注平台支持 CT / MR / PET 等多模态 DICOM,US、MG 清单条目需按项目评估,非 DICOM 不入库。内镜视频、病理全切片和病历 NLP 不在标准标注平台范围内,病理全切片可按项目评估定制模块。
不可以。AI 输出为待审核草稿(Mask / Contour),须经专家修订与单盲/多盲审核,只有已审核数据才能导出进训练集或课题分析。预标注不能代替诊断。
一体机部署在院内机房或科室,默认断外网。原始数据、脱敏数据与标注结果均留在院内;数据导出须审批、带水印并全程审计。研究者工作台只获取已审批数据集的加密副本。
医标榜成绩在本页“医标榜”板块公示,经学术委员会复核后发布。榜单动态更新:主流模型发布新版本后滚动加测,每半年发布一期完整报告。
支持。院级旗舰 STUDIO 提供信创版(MDS-S600X),适配国产 CPU、AI 加速卡、操作系统与数据库,与标准版独立 BOM、参数不混用,具体适配清单按项目确认。
建议从两周院内 PoC 开始:选一个具体任务,跑通入库、试标、盲审与导出。点击页面中的“申请院内两周 PoC”,或直接致电 137-5502-0164、发邮件至 lk@langhuiai.com。
从院内原始数据,到可验收的科研资产。