
MEDICAL DATA RESEARCH
腮腺及主要唾液腺 MRI 数据建设:从检查级索引到可审计的 AI 研究证据
腮腺及主要唾液腺MRI数据建设如何把Study计数、DICOM元数据、解剖覆盖、报告不确定性、影像与病理证据、专家复核、患者级划分和外部验证转成可追溯的AI研究交付规范?本文给出数据工程、质量门控与版本管理的实操框架。
如果把同一次腮腺 MRI 中的 T1、T2、DWI、ADC 和增强期相拆成多个“病例”,模型可能学到的是重复导出而不是新的临床证据;如果把影像报告中的“考虑”“不能除外”直接改成明确疾病,训练集又会把不确定性误当成真值。腮腺及主要唾液腺 MRI 数据建设真正要解决的问题,不是把更多文件放进一个目录,而是让一次检查的来源、解剖覆盖、序列关系、报告语义和外部证据能够被逐层核验,并且在研究划分、模型训练和交付复查时保持同一条血缘。
本文以一类腮腺及主要唾液腺 MRI 数据需求为例,讨论如何将临床任务转成可执行的数据对象、标签字典、标注流程和验收逻辑。文中讨论的是研究数据工程和 AI 研发设计,不构成个体诊断、筛查、治疗或医疗器械性能承诺。
先把临床问题拆成可验收的数据对象
腮腺 MRI 的研究问题并不只有一个。对算法团队而言,可能需要先判断检查是否覆盖双侧腮腺、颌下腺、咽旁间隙和面神经相关通路,再定位病灶,最后开展良恶性或具体病种的分类。对影像组学团队而言,重点可能是病灶三径、信号、扩散、强化和空间关系。对纵向研究而言,同一匿名患者的基线、术后或放疗后检查还要按时间排序。对数据治理团队而言,最先要确认的却是:这是不是一项独立的 MRI Study,文件是否可读,正式报告是否对应,主键能否去重,授权和去标识化记录是否存在。
因此,建议把交付对象至少拆成五层。第一层是匿名患者和检查关系,只保存满足项目目的所需的相对时间及稳定关联键。第二层是 MRI Study,作为计数和去重的基本单位;同一次检查内的多序列、多期相、多视图和重复导出不能被拆成多个独立样本。第三层是 Series 与 Instance,保留序列名称、方向、空间几何、层厚、磁场强度、线圈和关键采集参数。第四层是报告和结构化字段,分别保存检查所见、印象、主要诊断、否定语义及不确定语义。第五层是标本、病理、手术、超声、CT、面神经功能或随访等外部证据,并明确它们究竟与患者、检查还是病灶发生了哪一级关联。
这种分层能阻止两个常见错误。其一,把多序列当成多病例,造成样本数虚高和训练集泄漏。其二,把患者级关联写成病灶级或像素级真值,使研究者误以为每一张图都具有病理确认的轮廓。若源系统没有提供稳定的病灶 ID 或证据链,就应保留“不可得”“未做”或“无法建立”的状态,而不是用工程推断填空。
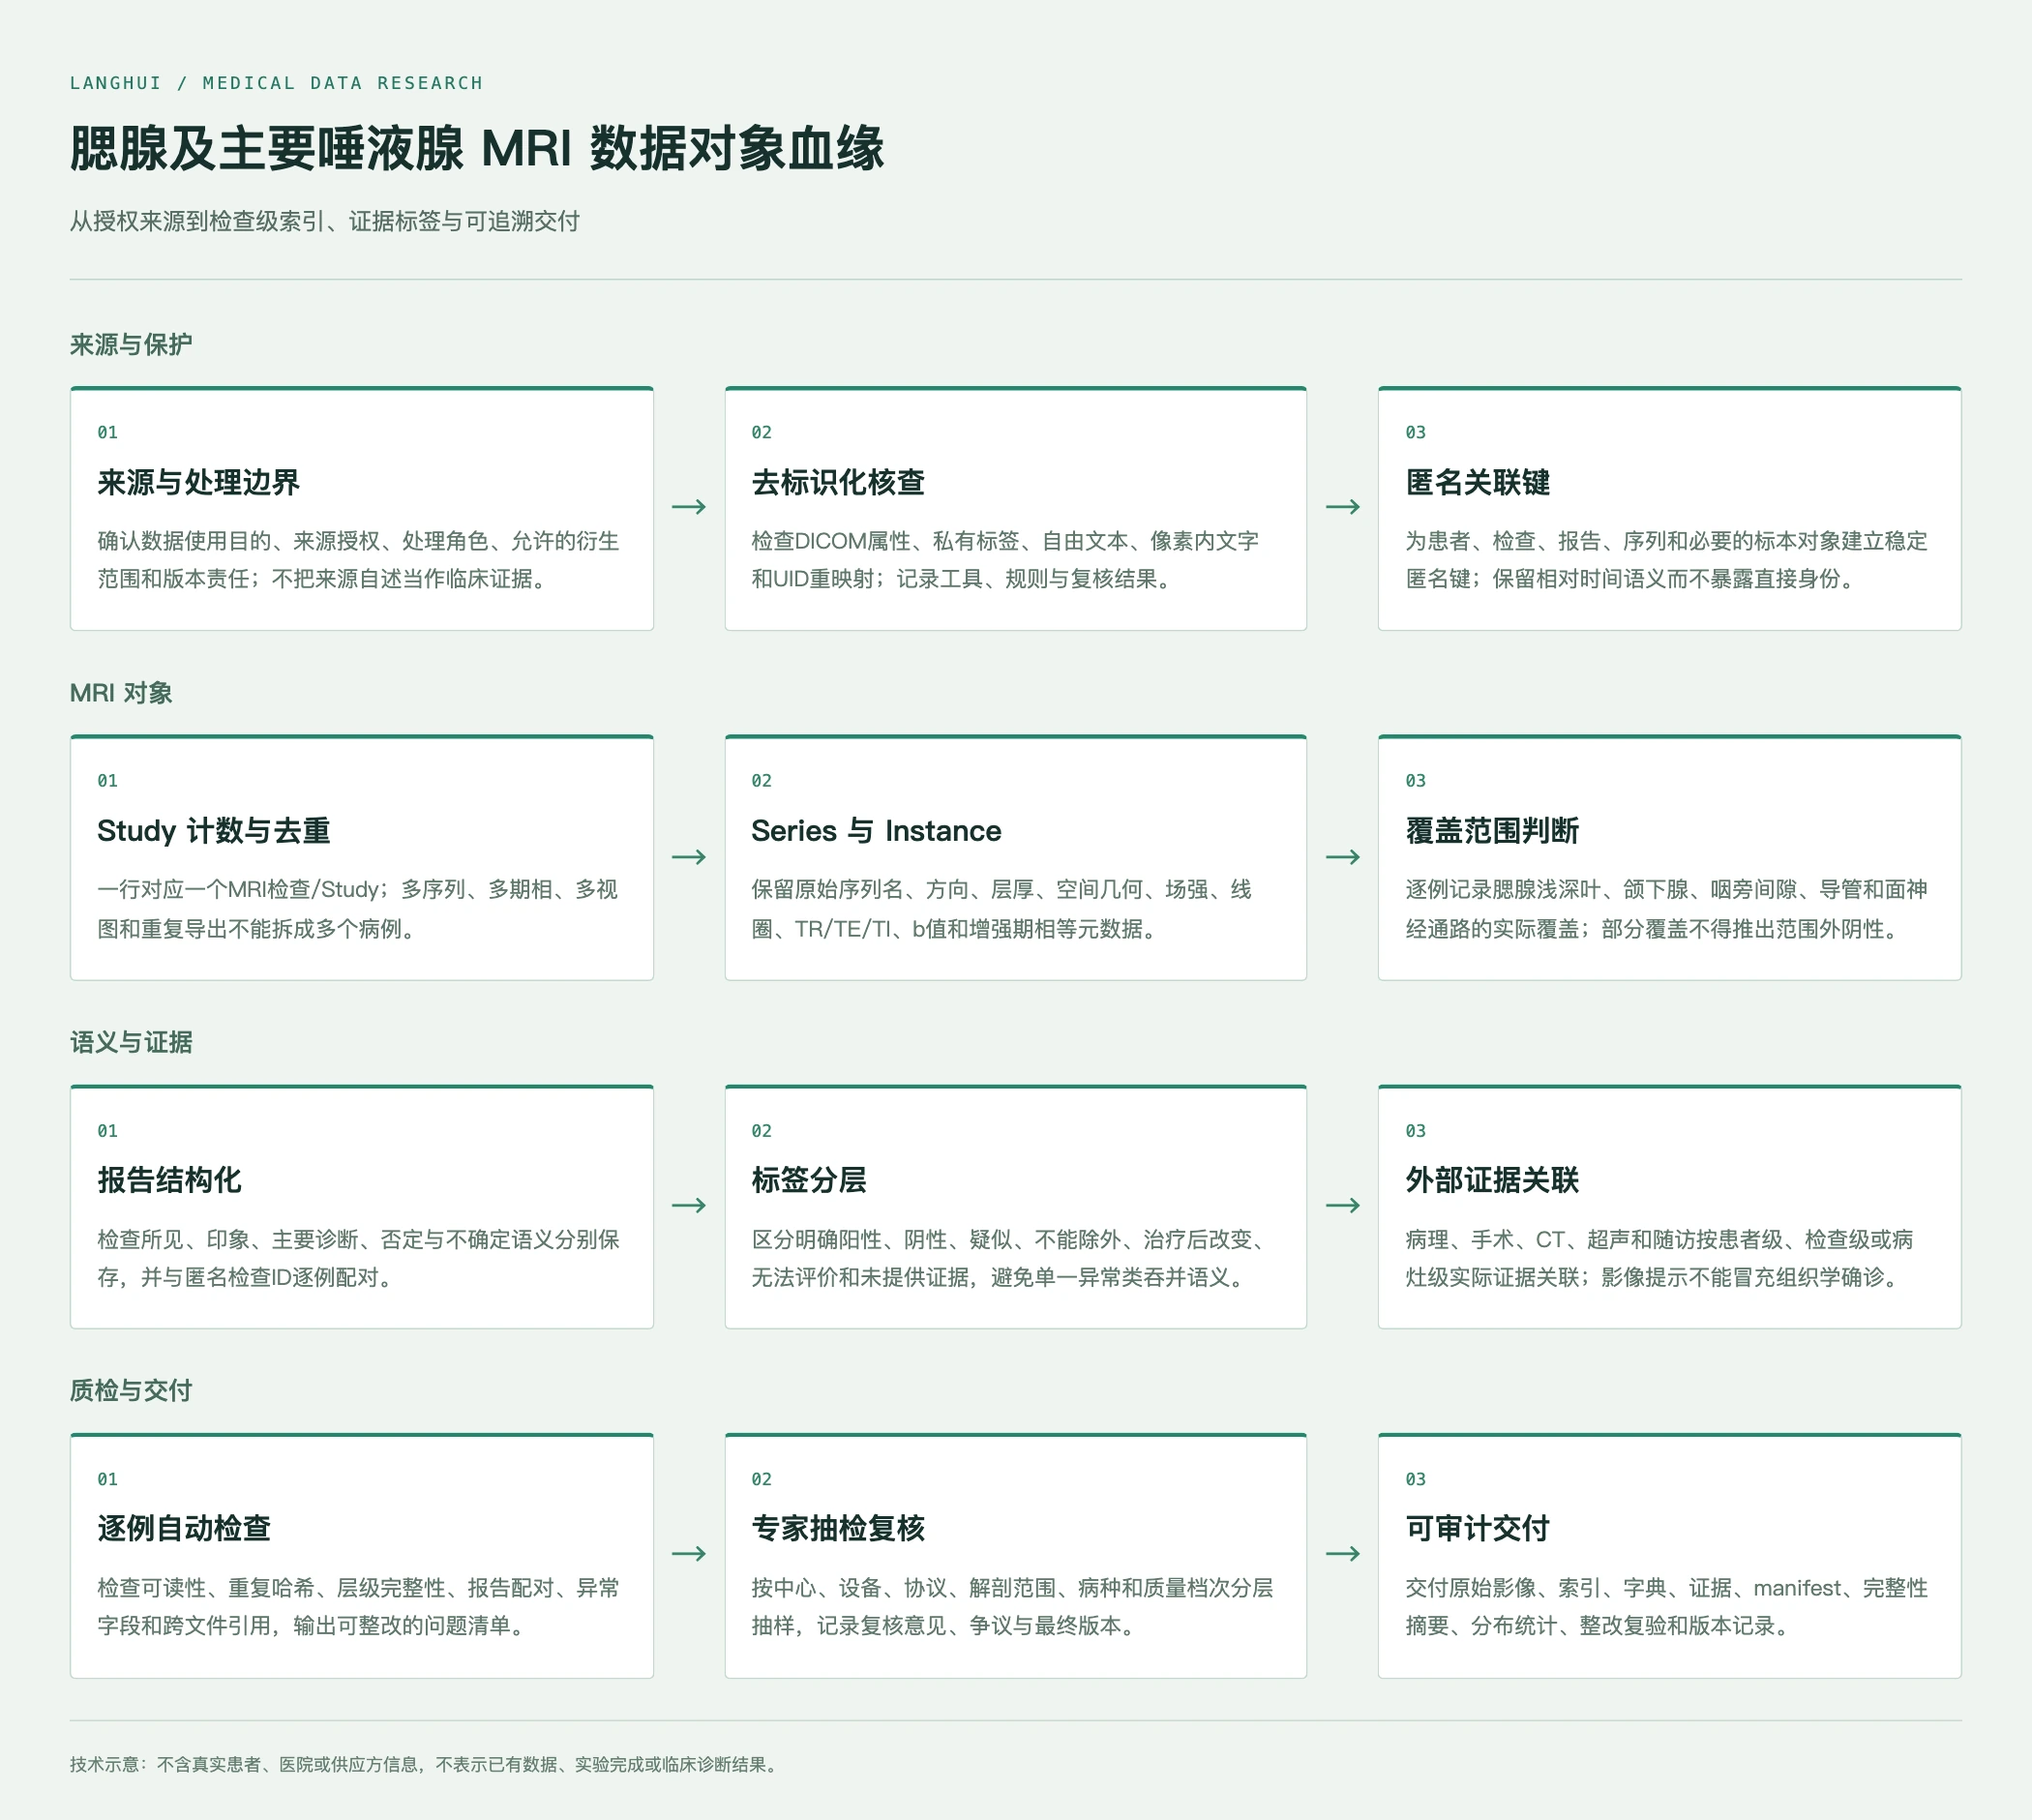
图1 腮腺及主要唾液腺 MRI 数据对象的分层与核验关系。技术示意,不表示真实患者数据、已完成实验或临床诊断。
模态与解剖边界决定标签能否成立
这类需求的输入不是一张泛称的“腮腺 MRI”,而是可追溯的多序列 DICOM 对象。常见主体序列包括轴位或冠状位 T1WI、脂肪抑制 T2WI 或 STIR、DWI 及 ADC,以及常规或动态增强 T1WI。重 T2 的 MR 唾液管成像应作为专项协议单列,不能因为同样使用 MRI 就与常规腮腺检查混为一类。每个序列都应同时记录标准化名称和原始名称;名称归一化便于统计,但不能覆盖原始值。
解剖字段也要与实际视野绑定。双侧腮腺的浅叶、深叶和腮腺尾部,颌下腺,咽旁间隙,导管,面神经通路和颈部淋巴结并不一定在每次检查中完整出现。只有结构真正进入诊断视野且影像质量支持评价,才可以形成阳性、阴性或疾病相关标签。部分覆盖不能推出范围外的阴性结论;序列缺失也不能被默认成“未见异常”。ACR、ASNR 和 SPR 的头颈 MRI 实践参数把患者选择、检查技术、文档记录、设备和质量改进分开规定,这提醒数据项目不能只验收图像文件,还要保留协议与解释语境。1
腮腺病变标签应按照证据强度拆开。多形性腺瘤、Warthin 瘤、腮腺恶性肿瘤、颌下腺或小唾液腺肿瘤、唾液腺炎、导管扩张或结石相关改变、自身免疫或淋巴上皮病变倾向、面神经周围侵犯、术后或放疗后改变,以及其他良性或长尾病变,可以作为任务字典中的报告级条目。它们并不具有同样的证据条件:影像能够描述形态、边界、信号和强化倾向,但组织学类型、分级和恶性确认通常要依赖穿刺、手术或病理;结石等问题还可能需要 CT 或超声作为高阶证据。
对每个条目,至少应区分“明确阳性”“明确阴性”“疑似或考虑”“不能除外”“治疗后改变”“无法评价”和“未提供证据”。治疗后改变与复发倾向不能在一个类别中静默合并。影像提示也不能改写为病理确诊。这样的字典看似比单一的“异常/正常”更复杂,却能让研究者选择合适的纳入标准,并在模型误差分析时知道错误究竟发生在影像观察、证据关联还是标签转换。
把多参数 MRI 变成可复用的算法输入
算法路线不宜从模型名称开始,而应从任务层级开始。第一阶段可以是技术完整性与解剖覆盖质检:自动解析 DICOM,核对 Study、Series、Instance 层级,检查空间方向、层厚、序列完整性、重复哈希和异常导出;同时用规则或轻量模型判断目标结构是否进入视野。第二阶段才是序列对齐、腺体或病灶定位与分割。第三阶段根据标签证据设计分类、风险分层或影像组学任务,并把“无法评价”和“不确定”作为可见状态,而不是强行转成负类。
已有研究说明,多序列输入的价值必须在具体任务和验证设计中观察。Zhang 等在 2024 年的研究中,分别使用 T1WI 与脂肪抑制 T2WI 训练腮腺肿瘤检出和分割模型,并另设按时间区分的验证集;这类设计至少把“同一批数据内部交叉验证”和“时间上后来的样本验证”分开了。2 但该研究的任务、患者构成和采集条件不能直接外推到所有腮腺或唾液腺数据集。
2025 年一项结合深度学习与影像组学的研究,将病理确认的腮腺肿瘤分为训练、内部验证和外部测试队列,并报告了外部测试中的分割和分类结果。3 它对数据建设的启示不是某一个 AUC 可以复制,而是外部测试应在模型冻结后进行,并且要记录扫描仪类型、中心、病种构成和证据门槛。另一项 2025 年单中心研究将脂肪抑制 T2、增强 T1、DWI 和动态增强信息结合起来,提示 DCE 曲线可能改变分类表现,同时也暴露出单中心、恶性病例较少、设备和采集参数不一致、ROI 由单一专家勾画等外推限制。4
如果采用影像组学,预处理、重采样、强度归一化、ROI 边界和特征选择都必须版本化。2025 年一项基于 T2 和 ADC 的研究对部分病灶重复勾画,并用 ICC 筛选较稳定的特征,再进行降维和模型训练。5 这说明“有一个 Mask”还不够,研究者还要知道它由谁、在什么窗口和什么规则下产生,以及特征是否对边界微小变化敏感。对于腮腺 MRI,序列间几何不一致、层厚差异、动态期相缺失和金属伪影都可能成为模型学到的捷径。
少样本多模态研究也可以作为研发方向,但不能成为忽略证据治理的理由。一页公开的腮腺肿瘤少样本研究介绍了 T1、T2 和 DWI 的多序列输入、患者级划分和病理确认队列。6 即使某个小样本测试集获得较高实验指标,也仍需回答样本是否来自单一机构、设备和人群,病理类别是否平衡,是否存在同一患者的相关影像进入不同集合,以及模型是否在真实工作流中改变了医生决策。研究效果、外部泛化和临床效果必须分开表述。
专家标注不是“看一遍图再填表”
专家参与应被写成可审计的角色和动作。初标人员依据字段字典记录腺体、侧别、浅深叶、腮腺尾部、病灶三径、单发或多发、T2 与 DWI/ADC 表现、动态强化、导管、面神经通路、深部间隙、淋巴结和可获得的临床背景。复核人员在不知道初标结论或尽量减少先验影响的条件下,检查范围覆盖、关键字段、报告语义和证据 ID。对无法按规则解决的分歧,提交具有相应影像或临床经验的终审者,并记录争议点、采用的证据、最终值、处理人和版本。
“阴性”也需要证据。若检查未覆盖某结构,应标记部分覆盖或无法评价,而不是填阴性;若正式报告写明“未见明显异常”,则应保留报告来源和适用的视野范围;若病理只对应一个病灶,就不能把其组织学结果传播到同一 Study 中的其他病灶。跨模态关联应优先建立患者级或检查级对照表,只有在来源系统能够稳定证明病灶级配对时,才进入病灶级任务。没有像素级配准和病灶证据时,不能把“有关联”写成“像素级真值”。
质量基准可以由采购方或研究方另行建立独立医生复核集,覆盖不同序列、解剖范围、病种、中心、设备和质量档次。它的作用是检查标签流程,而不是制造一条脱离临床语境的统一准确率。对少见病变,应保留检索依据和非零覆盖的实际状态;如果某项在常规诊疗中未产生,应记录“未做”或“不可得”,不能跨患者拼接,也不能为了满足数量补造报告或改变既有诊疗流程。
验收要同时检查内容、分布和血缘
一份可用交付不应只有影像压缩包。最低限度的包应包括脱敏原始 DICOM、逐例索引、字段字典、报告关联、标签及证据来源、文件清单、哈希或其他完整性摘要、可读性和重复检查、问题清单、整改复验记录、版本说明与授权边界。计数应从逐例索引重算,而不是接受一个无法追溯的汇总数字。每个批次都要能回答:送检多少、通过多少、整改多少、剔除多少,哪些对象因为报告错配、影像不可读、字段缺失或去标识化风险被阻断。
质量门控可分为四类。第一类是阻断性缺陷,包括直接身份信息泄漏、错患者或错报告关联、授权链无法核验、伪造或静默替换文件。第二类是技术完整性,包括 DICOM 可解码、Study/Series/Instance 层级稳定、空间信息存在、关键序列与范围一致。第三类是临床语义,包括报告所见与结构化标签一致,否定与不确定语义未被抹平,病理证据没有被影像推断替代。第四类是研究适用性,包括患者级划分、中心与设备分布、年份、人群、病种和缺失状态可统计。
多中心和多设备不是装饰性指标。单中心数据可能让模型把机构、线圈、扫描协议或报告习惯当成病种特征。数据建设可以把来源中心、设备厂商与型号、场强、软件版本、序列和年份作为分层变量,在内部训练和外部测试中分别报告。若项目要求中心级独立抽检,抽检对象应与常规交付清单患者去重;若要研究纵向变化,训练、验证和测试的划分必须先按患者而不是按序列或切片完成。
DICOM 的属性保密配置文件可以帮助删除或替换部分可能泄露身份的属性,但 DICOM 官方明确说明,属性处理本身不保证整个信息对象已经完成去标识化;像素内烧录文字、私有属性、关联对象和重映射 UID 仍需纳入专项检查。7 因此,验收不能把“使用了某个脱敏工具”当成授权合法、像素安全和跨文件关联正确的充分证明。对日期偏移、UID 稳定重映射、私有标签白名单、自由文本和图像内文字,都应保留工具版本、规则和复核结果。
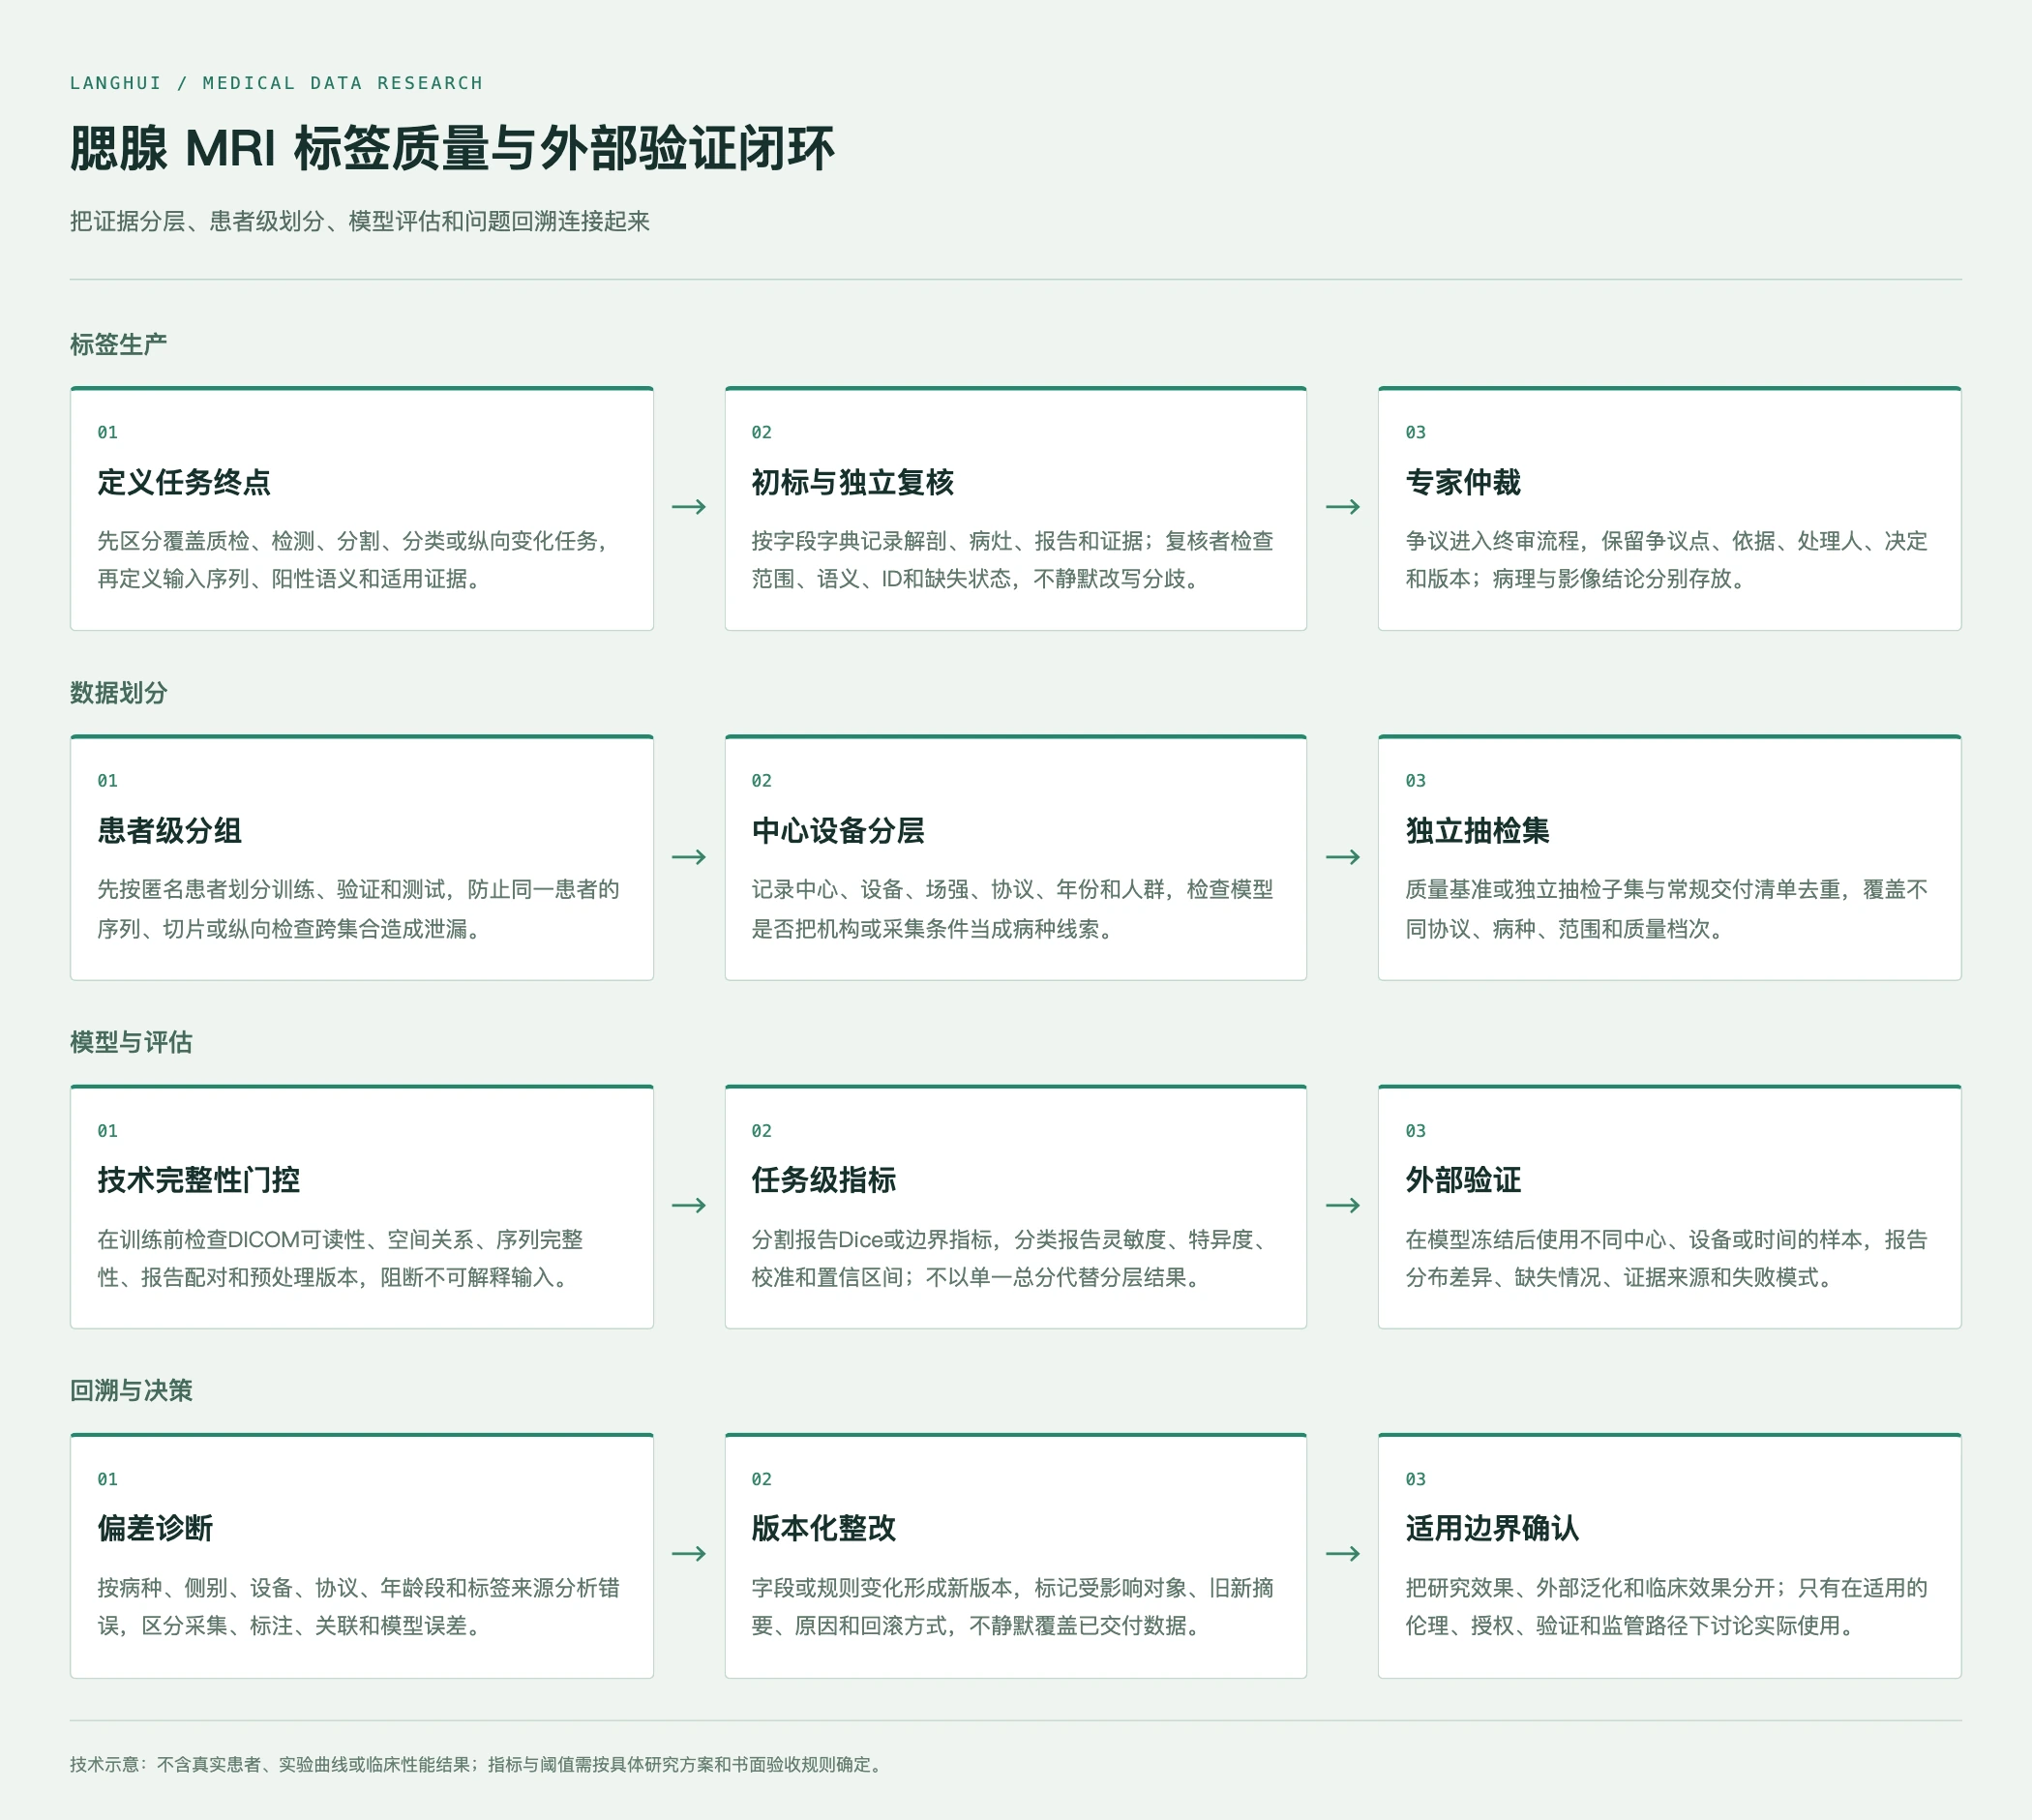
图2 从证据分层到模型验证的质量闭环。技术示意,不表示真实患者数据、实验已完成或任何临床性能结果。
用质量档次连接研发价值与交付边界
数据需求通常同时包含基础可用性和高阶研究价值。可以将项目档次抽象为:L1 保存可读取的原始影像与正式报告;L2 增加结构化报告、设备协议和核心标签;L3 增加来源清晰的病史、主要诊断和临床语境;L4 增加完整序列、期相或同一患者的纵向检查;L5 再在授权和来源证据充分时关联 HIS/EHR、病理、检验、治疗或其他模态。档次越高,关联责任越重;同一对象只能按实际达到的最终档次进入统计,不能在不同档次中重复计算。
对于提供医疗数据基础设施、专业标注和项目交付的团队,这套方法的价值在于把研究问题变成可讨论的规格:先用样例确认解剖范围、序列、报告和标签,再按批次执行、复核、整改和版本冻结,最后交付可回溯的质量报告。朗慧科技已核验的能力边界是以 LangData 为代表的数据采集、处理、标注、质检和交付流程,以及按部位、模态和任务组织医疗数据项目;这可以支持需求拆解和项目化交付,但不等于某一疾病数据集已经现货可用,也不等于已有某项临床模型、监管批准或统一准确率。具体人员资质、数据来源、规模、周期、字段和验收阈值,都应以项目书面确认、合法授权和实际复核结果为准。
当文章、采购规格和模型研发使用同一套字段定义时,业务逻辑才不会把“例数”误当成数据价值。研究方得到的是可解释的输入与证据边界,数据团队有明确的整改对象,算法团队能够复现预处理和划分,质量人员能够沿着匿名 ID、Study、Series、报告和证据记录追溯问题。对于腮腺及主要唾液腺 MRI,这种可审计性比单纯扩大文件数量更接近临床研究真正需要的基础设施。
版本变更和撤回也是研究数据的一部分
医学数据不会因为一次交付而永久稳定。后续可能发现某个 Study 与报告错配、某个序列包含未清除的像素文字、某个病理结果被更新,或者原始来源撤回了对衍生研究的授权。因而版本控制不能只是文件夹改名。每次更正都应形成新版本或增量包,记录受影响的匿名对象、旧摘要与新摘要、变更原因、审核人、日期以及对已训练模型和已发布分析的潜在影响。
撤回尤其需要沿派生关系追踪。若一个对象已经进入预处理缓存、特征表、标注版本或模型评估集,单独删除原文件并不能说明风险已经消失。项目应至少维护对象到派生结果的引用关系,在撤回时提供不可复用对象的清单,并说明哪些统计、模型权重或研究结论需要重新计算。这样做既保护来源方的处理边界,也避免研究者在不知情的情况下继续使用已经失去适用依据的数据。 对于纵向研究,还要保存前后检查的相对时间规则和关联依据。日期修订、匿名键重映射或报告更正都可能改变病程顺序;如果版本记录只更新最新表格而不保留旧值,研究者就无法判断某个结论是由原始数据还是后续修订产生。将对象版本、时间依据和派生结果一起交付,才能让模型复训、敏感性分析和独立复核有可复核、可重复的起点。 本文仅讨论医学影像研究数据建设、标注治理和算法验证设计,不构成对任何患者的医学建议,也不表示某一数据项目已完成或某一模型已经产生临床效果。任何临床使用仍需在适用法律法规、伦理审查、数据授权、产品质量体系和前瞻性或外部验证框架下,由具备相应资质的专业人员独立判断。
参考来源
- ACR–ASNR–SPR Practice Parameter for the Performance of MRI of the Head and Neck
- Deep learning for the automatic detection and segmentation of parotid gland tumors on MRI
- Automated segmentation and diagnosis of parotid tumors using a combined deep learning and radiomics model on T2-weighted MRI: a multi-vendor validation study
- Deep learning–based classification of parotid gland tumors
- The Role of MRI Radiomics Using T2-Weighted Images and the Apparent Diffusion Coefficient in the Differential Diagnosis of Warthin Tumors and Malignant Tumors of the Parotid Gland
- A Few-Shot Multimodal Deep Learning Framework for Precision Diagnosis
- DICOM PS3.15: Attribute Confidentiality Profiles