
MEDICAL DATA RESEARCH
药品说明书 OCR 数据契约:从“识别文字”到“可追溯字段”
面向医疗AI研发与药事数据采购,梳理药品说明书OCR的字段级证据、页码坐标、状态区分、版本差分和双人验收,明确原件、授权与外部验证边界。
药品说明书 OCR 最容易被低估的风险,不是某个字偶尔识别错误,而是系统把错误的字、错误的段落和错误的版本一起包装成一个看似完整的 JSON。对于适应症、用法用量、禁忌、不良反应、相互作用等安全相关内容,一个缺字可能改变语义;而当原文没有某个章节、扫描件缺页或 OCR 根本没有抓到该页时,三者也不能被写成同一个“空值”。因此,真正值得采购和研发的不是“把 PDF 变成文本”,而是一套能把结构化字段、原始证据、版本关系和人工复核同时交付的药品说明书数据契约。
本文讨论的是医疗 AI 研发和药事数据工程中的技术问题,不复述任何具体药品、持证主体、生产企业或联系信息,也不构成用药、诊断或监管申报建议。文章把需求收敛到一个可匿名成立的场景:对经过授权的药品标签、说明书或等价电子文件进行 OCR 与结构化抽取,并让每个字段可以回到原文页、位置和版本。
一、先界定任务:这不是普通文本识别
药品说明书承载的是受监管的产品信息。国际上,HL7 Structured Product Labeling(SPL)把标签内容与机器可读的产品、包装和临床使用信息放进同一套交换标准,字段可以覆盖通用名、成分及规格、剂型、给药途径、适应症、禁忌、相互作用、警示和特殊人群等1。EMA 对产品信息的要求也强调标准标题、固定语句、语言和版式;其电子产品信息(ePI)把产品特征摘要、包装说明和标签作为授权产品信息,转为适合电子传播和版本管理的形式3。这些标准并不等于一套中文 OCR 方案,却清楚说明了任务的本质:标签不是散文,字段之间有角色、顺序、版本和监管语义。
源需求可以拆成五层。第一层是文档级身份,包括文档唯一标识、原件或等价副本、语言、页数、版本日期、来源许可和文件摘要。第二层是产品级字段,例如通用名、商品名、成分、规格、剂型、包装和保存条件。第三层是临床使用段落的结构化角色,例如适应症、用法用量、禁忌、不良反应、注意事项、相互作用、特殊人群、过量处理、药理和药代动力学。第四层是 OCR 证据,每一个结果字段都要保留原始文字片段、置信度、页码、边界框或等价坐标、存在性状态和审核状态。第五层是版本与变更关系,用于证明某个字段来自哪一版文件,哪些改动属于新版本,哪些记录已经被回收或重新审核。
数据颗粒度也必须在工作说明中写清楚。文档级记录回答“这是哪一份说明书”;页面级记录回答“哪一页存在模糊、缺失、旋转或版面异常”;段落级记录回答“这段文字承担什么说明书角色”;字段级记录回答“抽取出的值是什么”;证据级记录回答“这个值在原页哪里、原始 OCR 是什么、是否被人改过”。若只交付最后一个产品 JSON,采购方无法判断错误发生在扫描、版面分割、OCR、字段映射、规范化还是人工审核,后续模型也无法区分事实缺失与系统漏抓。
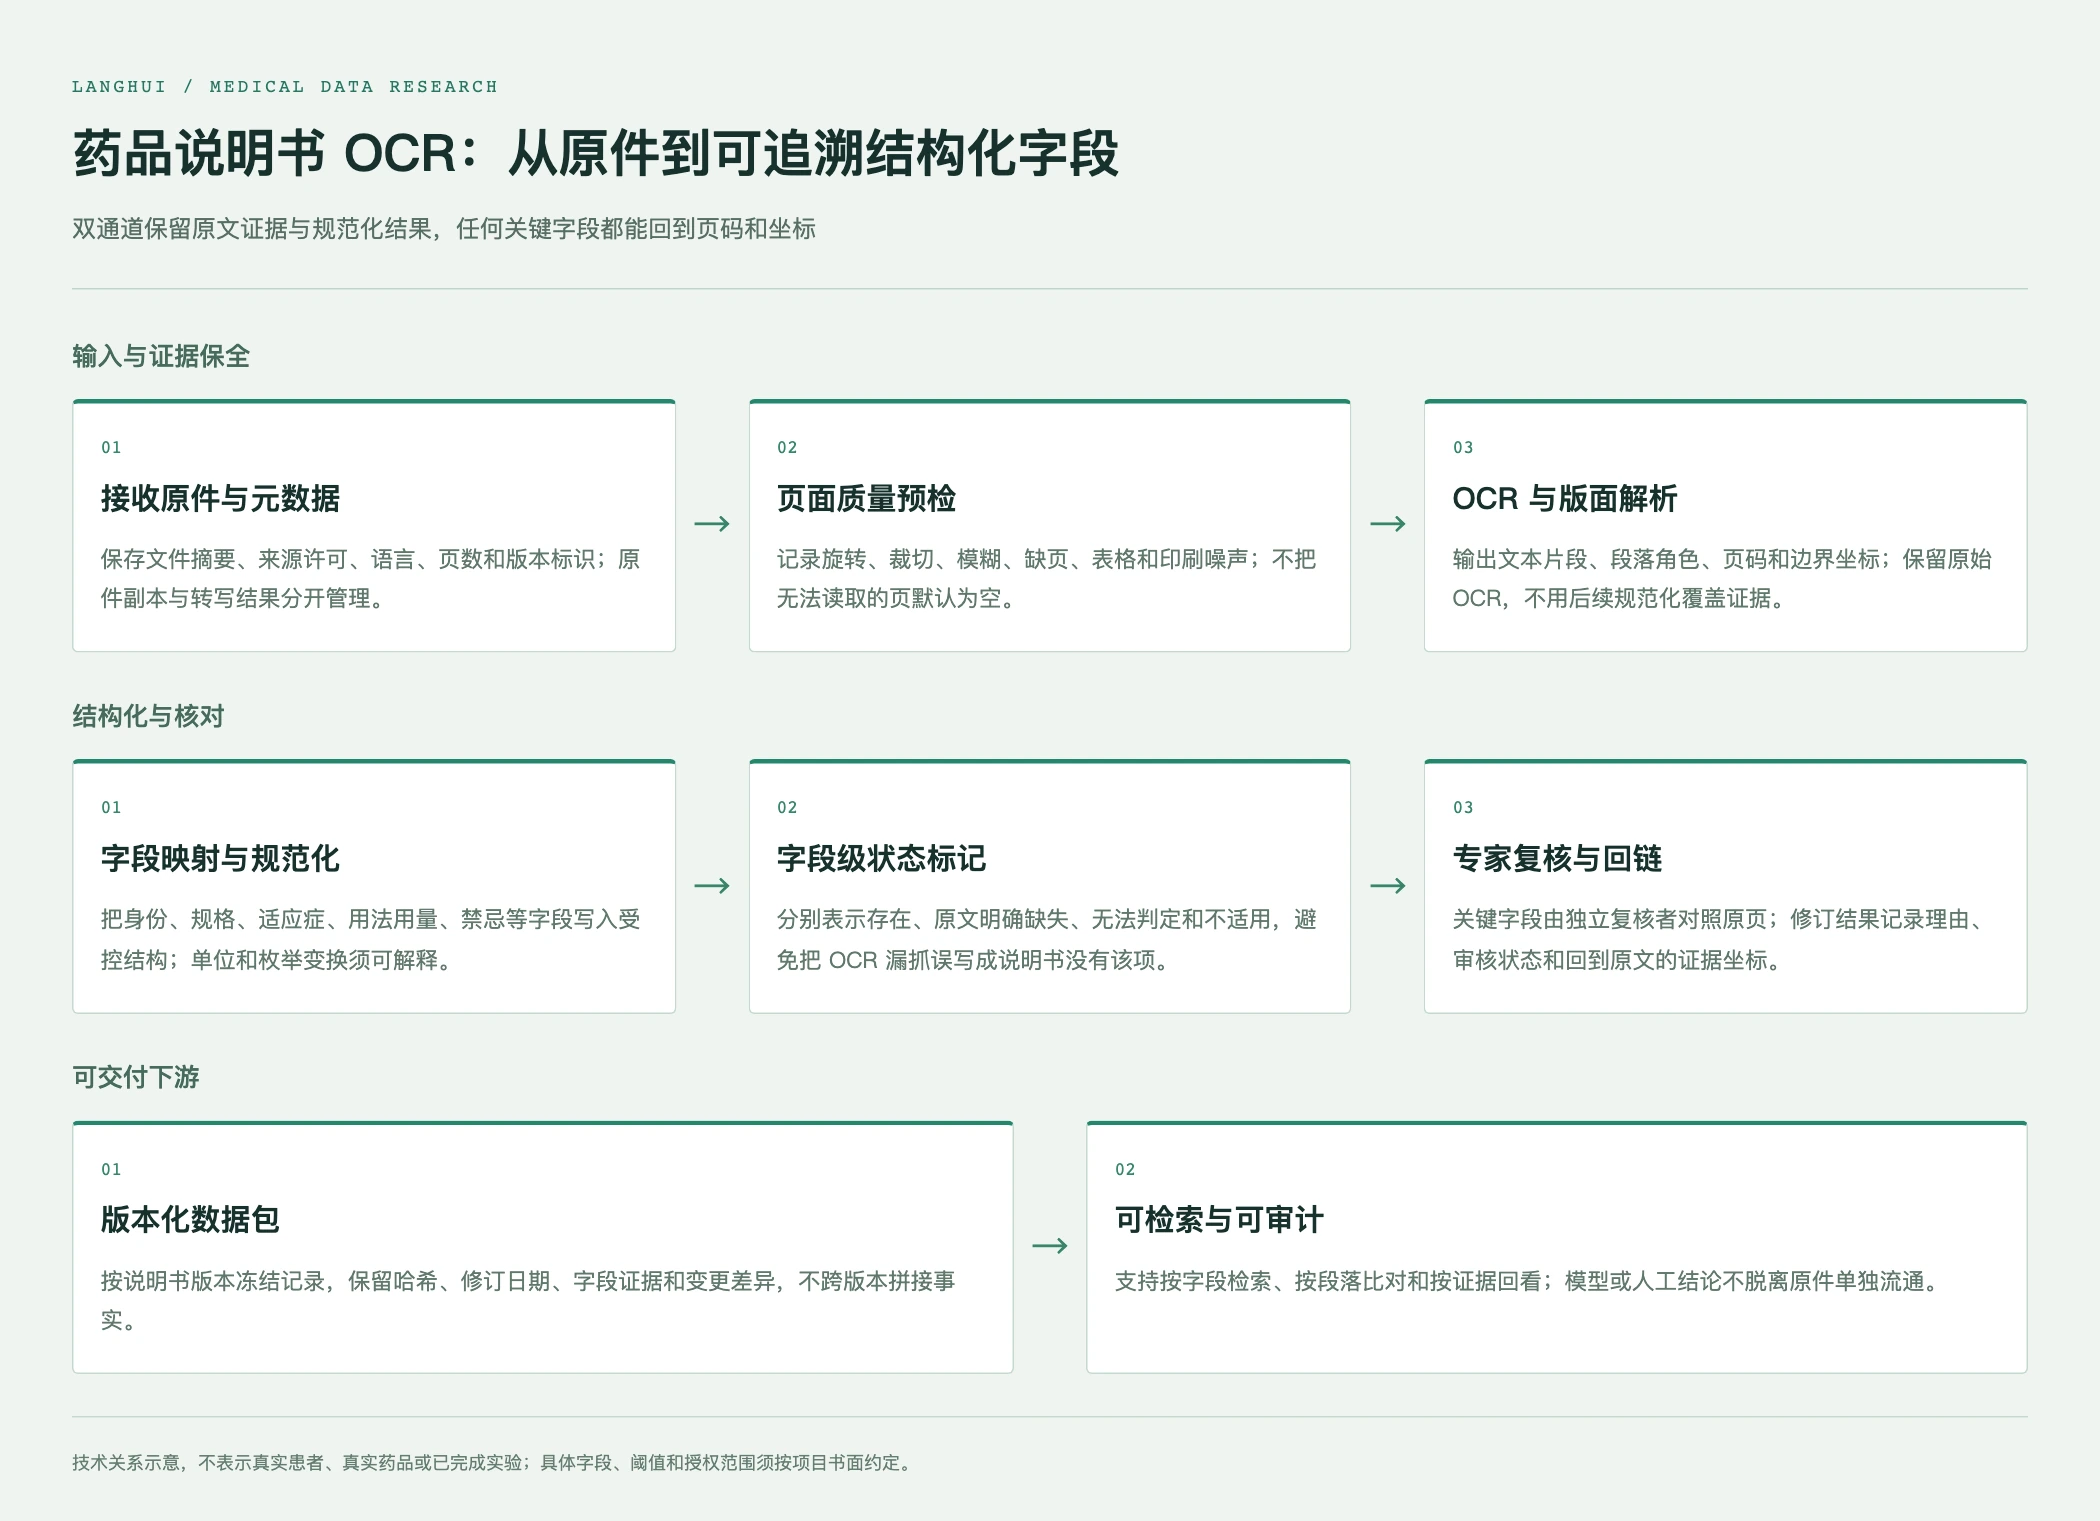
图 1:技术示意。双通道的核心是保留原文证据与结构化结果之间的可回链关系,不表示真实患者、真实药品或已完成实验。
二、数据设计:结构化结果和原始证据必须成对存在
建议把数据契约设计为“产品结果层”和“字段证据层”两张彼此关联的表,而不是让规范化值覆盖 OCR 原文。产品结果层适合检索和下游建模:字段名称统一、日期格式一致、单位有明确枚举,段落角色能用于分段检索。字段证据层适合审计和返工:保留 OCR 原始字符串、原文页码、坐标、模型置信度、证据片段、状态、审核者角色、审核时间和修订理由。两层通过稳定的文档 ID、版本 ID、字段路径和证据 ID 关联;一个规范化字段可以对应多个证据片段,一个字段也可能因为跨页或表格布局而有多个坐标。
“置信度”不能被当作正确率。OCR 引擎给出的数值只是对字符或片段识别不确定性的内部估计,不能替代针对关键字段的人工核对。更稳妥的做法是把它与版面质量、字段类型和规则校验结合起来:低清页、细小字体、复杂表格、上下标、混合语言和剂量单位被列为高风险切片;即使置信度较高,只要数值落在异常格式、单位不匹配或段落角色冲突,也应该进入复核队列。文章可以引用一个指标,但交付不能只给一个“总体准确率”。
状态枚举应至少区分“存在且已抽取”“原文明确缺失”“无法判定”“不适用”以及“待人工复核”。其中,“原文明确缺失”必须有页级或文档级证据支持,例如全文结构明确结束而未出现该章节;“无法判定”则表示页面缺失、严重模糊、遮挡、语言无法处理或 OCR 结果不足以做判断。把二者都写成 null,会导致下游知识库把“没有该风险提示”与“没有读到风险提示”混为一谈。状态还应与审核状态分开:一个字段可以存在但尚未审核,也可以经过专家核对后确认存在;不能用一个布尔值同时承担事实状态和流程状态。
规范化必须遵守“只整理,不创作”的原则。可以按预先冻结的规则统一全角半角、日期表达、计量单位、空白符、项目符号和已批准的编码;可以把同一段落拆成可检索的句子,但不能从上下文补写原件未出现的剂量、适应症、禁忌或人群。翻译件需要指向原文版本并记录语言关系,不能把机器翻译直接当作新的授权标签。若一个说明书同时包含多种语言或附录,语言字段和段落角色应保持可追踪,不应在转写阶段合并为一段摘要。
版本管理是这类数据的另一条主轴。同一通用名在不同持证主体、不同剂型或不同修订日期下,说明内容可能不同。应将修订日期、批准或等价标识、产品身份、原件摘要、页数和版本号作为不可随意拆散的文档身份;不允许为了补齐字段,把旧版本的适应症与新版本的禁忌拼成“综合说明书”。版本之间可以建立字段级差分:新增、删除、文字变更、段落移动、格式变化和无法判断,但差分本身也必须回到两版原文。HL7 SPL 对逐节比较和保留历史标签的强调,正好说明了这种版本化设计的价值2。
三、算法路线:先保全版面,再做受约束抽取
第一阶段是输入治理。系统收到 PDF、扫描图或其他授权电子文件后,先计算文件摘要,检查页数、方向、分辨率、颜色、可搜索文本层、重复页、缺页、黑边、遮挡和异常压缩。页面质量标签不只是工程日志,它决定后续是否能够给字段赋予“明确缺失”。对于没有可读原件的页,系统应输出“无法判定”并进入人工补件或返工,而不是让 OCR 以空字符串替代。
第二阶段是版面感知 OCR。药品说明书常见多栏、表格、项目符号、章节标题、脚注和跨页段落;先把版面分成标题、正文、列表、表格和页眉页脚,再识别文字,通常比把整页当作一段字符串更容易保持语义。OCR 层应输出字符或词片段与几何位置的对应,保留阅读顺序和分栏关系。对高风险字段,可采用多引擎或多配置交叉识别,但交叉结果不应简单多数表决,而应把冲突回传到人工复核。2024 年一项医学报告图像文字提取研究把亮度、清晰度、倾斜、分割区域等图像特征纳入自动处理,并进一步做文本结构化,提醒我们输入图像质量本身就是需要测量的变量,而不是一个无关紧要的预处理细节6。
第三阶段是段落角色识别与字段映射。规则可以先识别稳定的章节标题和编号模式,再用领域语言模型处理标题变体、跨页连接和列表层级。对于标签类文档,模型输出应受到 schema、受控词表和证据门槛约束:没有对应原文片段时不允许生成字段值;一个句子同时命中多个候选段落时,应返回冲突而不是强行选择;剂量、频次、时间窗口、给药途径和特殊人群等高风险字段,需要额外的格式规则和单位校验。大模型可以帮助判断段落角色或提出候选值,但不应成为“补全说明书”的来源。
第四阶段是确定性校验与人工闭环。对日期、单位、包装数量、强度、剂型和给药途径等字段,可设计格式、枚举、范围和相互依赖校验;对禁忌、警示和相互作用等文本字段,则重点校验段落角色、原文完整性、证据回链和版本一致性。研究者在医学文献抽取中采用 schema 约束、受控词表、冲突处理和句子级证据捕获,目标就是把自动化结果变成可以事后审计的结构化记录5。药品说明书 OCR 可以借鉴这一思路,但应将“句子级证据”进一步落到页码、坐标和原件版本。
一项 2025 年的药品说明书结构化提取研究提出了领域适配 OCR、语义相似度索引与结构化人工验证的混合管线,在 72 份葡萄牙语说明书上测试了不同版式,并报告了字段级抽取结果和人工修改需求7。这类结果可以作为方法方向的参考,却不能直接换算为中文说明书项目的交付准确率,更不能替代针对目标语言、字体、厂商版式和版本分布的独立验证。研究有效,不等于临床有效;单一语种、小样本或特定版式上的实验效果,也不等于所有药品标签都能复现。
四、标注主体和复核机制:关键不是“几级审核”,而是分歧可解释
标注指南需要让两名受训人员面对同一页时,能够独立回答同样的问题:字段是否存在,值覆盖到哪里,段落角色是什么,原始 OCR 与规范化值是否分别保存,坐标是否能框住证据,页面不可读时应使用哪个状态。指南中必须同时提供正例、退回例和边界例,尤其要覆盖“章节未出现”“章节标题出现但正文缺失”“跨页列表”“表格中的单位”“旧版字段沿用”和“原件与 OCR 不一致”等情况。
人员角色也应分开。基础标注人员负责按规则定位字段和证据,药事或法规背景的复核人员负责判断段落角色、术语和安全相关内容,质量负责人负责抽检策略、分歧裁决、版本冻结和回归检查。无需把所有审核都包装为同一个“专家级别”,但必须记录每次判定的角色、时间、规则版本和修改理由。对适应症、禁忌、警示、相互作用、特殊人群和剂量等字段,可设置更高的复核优先级;对页眉、页码和装饰性文字,则可以采用较低的自动化门槛。
多人标注不能只输出一个平均一致性分数。应保留字段级分歧的类型,例如字符差异、段落边界差异、状态差异、版本错配、坐标偏移和是否需要回看原件。高频分歧说明指南不够清晰,低频但高风险的分歧则可能需要增加专项规则。对分歧采用裁决时,裁决结果必须保留双方初始意见,避免最终答案遮盖模型或标注流程的系统性偏差。任何人工改写都应能解释“改了什么、为什么改、依据哪一页、是否影响其他字段”。
五、质量、偏差与外部验证:验收要针对字段而不是口号
质量验收至少应有四类指标。第一类是文字和字段准确性,包括字符错误率、字段精确匹配、规范化值准确率、关键数字与单位的联合准确率。第二类是结构准确性,包括段落角色识别、列表层级、跨页连接和表格关系。第三类是证据完整性,包括页码、坐标、原始片段、版本 ID 和审核状态的填写率。第四类是状态安全性,包括把“明确缺失”误判为“无法判定”、把 OCR 漏抓误判为“原文没有”、把版本差异误判为同一事实的错误率。不同字段和错误类型要分别报告,不能用一个总体数字掩盖安全相关字段的尾部风险。
抽样不能只从清晰、单栏、近期和同一来源的文件中抽取。应按语言、年份、版本、来源、版式、页型、分辨率、扫描质量、文本层有无、关键字段类型和是否包含表格分层。训练、调参和验收应按文档或产品版本划分,避免同一说明书的相邻版本、重复扫描件或同源模板同时出现在训练和测试中。若只做随机页面切分,模型可能记住版式和词语,却没有真正学会处理新的说明书。
外部验证至少要包含未参与指南编写和模型调参的来源、未见过的版式以及不同清晰度的文件。若项目声称支持多语言,应把语言拆开评估;若项目声称支持历史版本,应按修订时间和结构变更评估;若项目面向药物警戒或检索,还要验证下游是否能沿证据回到原文,而不只是看抽取字符串。2026 年一项将 OCR 与大语言模型结合处理多报告医疗 PDF 的研究,在特定肿瘤专科流程中报告了文档分割、分类和日期抽取结果,并通过原始扫描与生成元数据并列的界面让临床人员复核8。该研究的任务、语料和临床流程与药品标签不同,结果不能迁移为本项目保证,但它说明外部来源、原始图像并列展示和工作流评估比脱离场景的单页准确率更接近实际使用。
偏差分析还应关注错误的业务后果。一个商品名的错字可能影响检索合并,一个单位的错字可能改变剂量,一个章节标题的错位可能把禁忌送入适应症字段,一个旧版本被当作最新版本可能让下游问答输出不适用的说明。验收记录中应区分“技术不通过”和“需要补充授权或原件”,因为没有许可、缺少原件或无法证明来源的问题,不应被技术团队用返工掩盖。
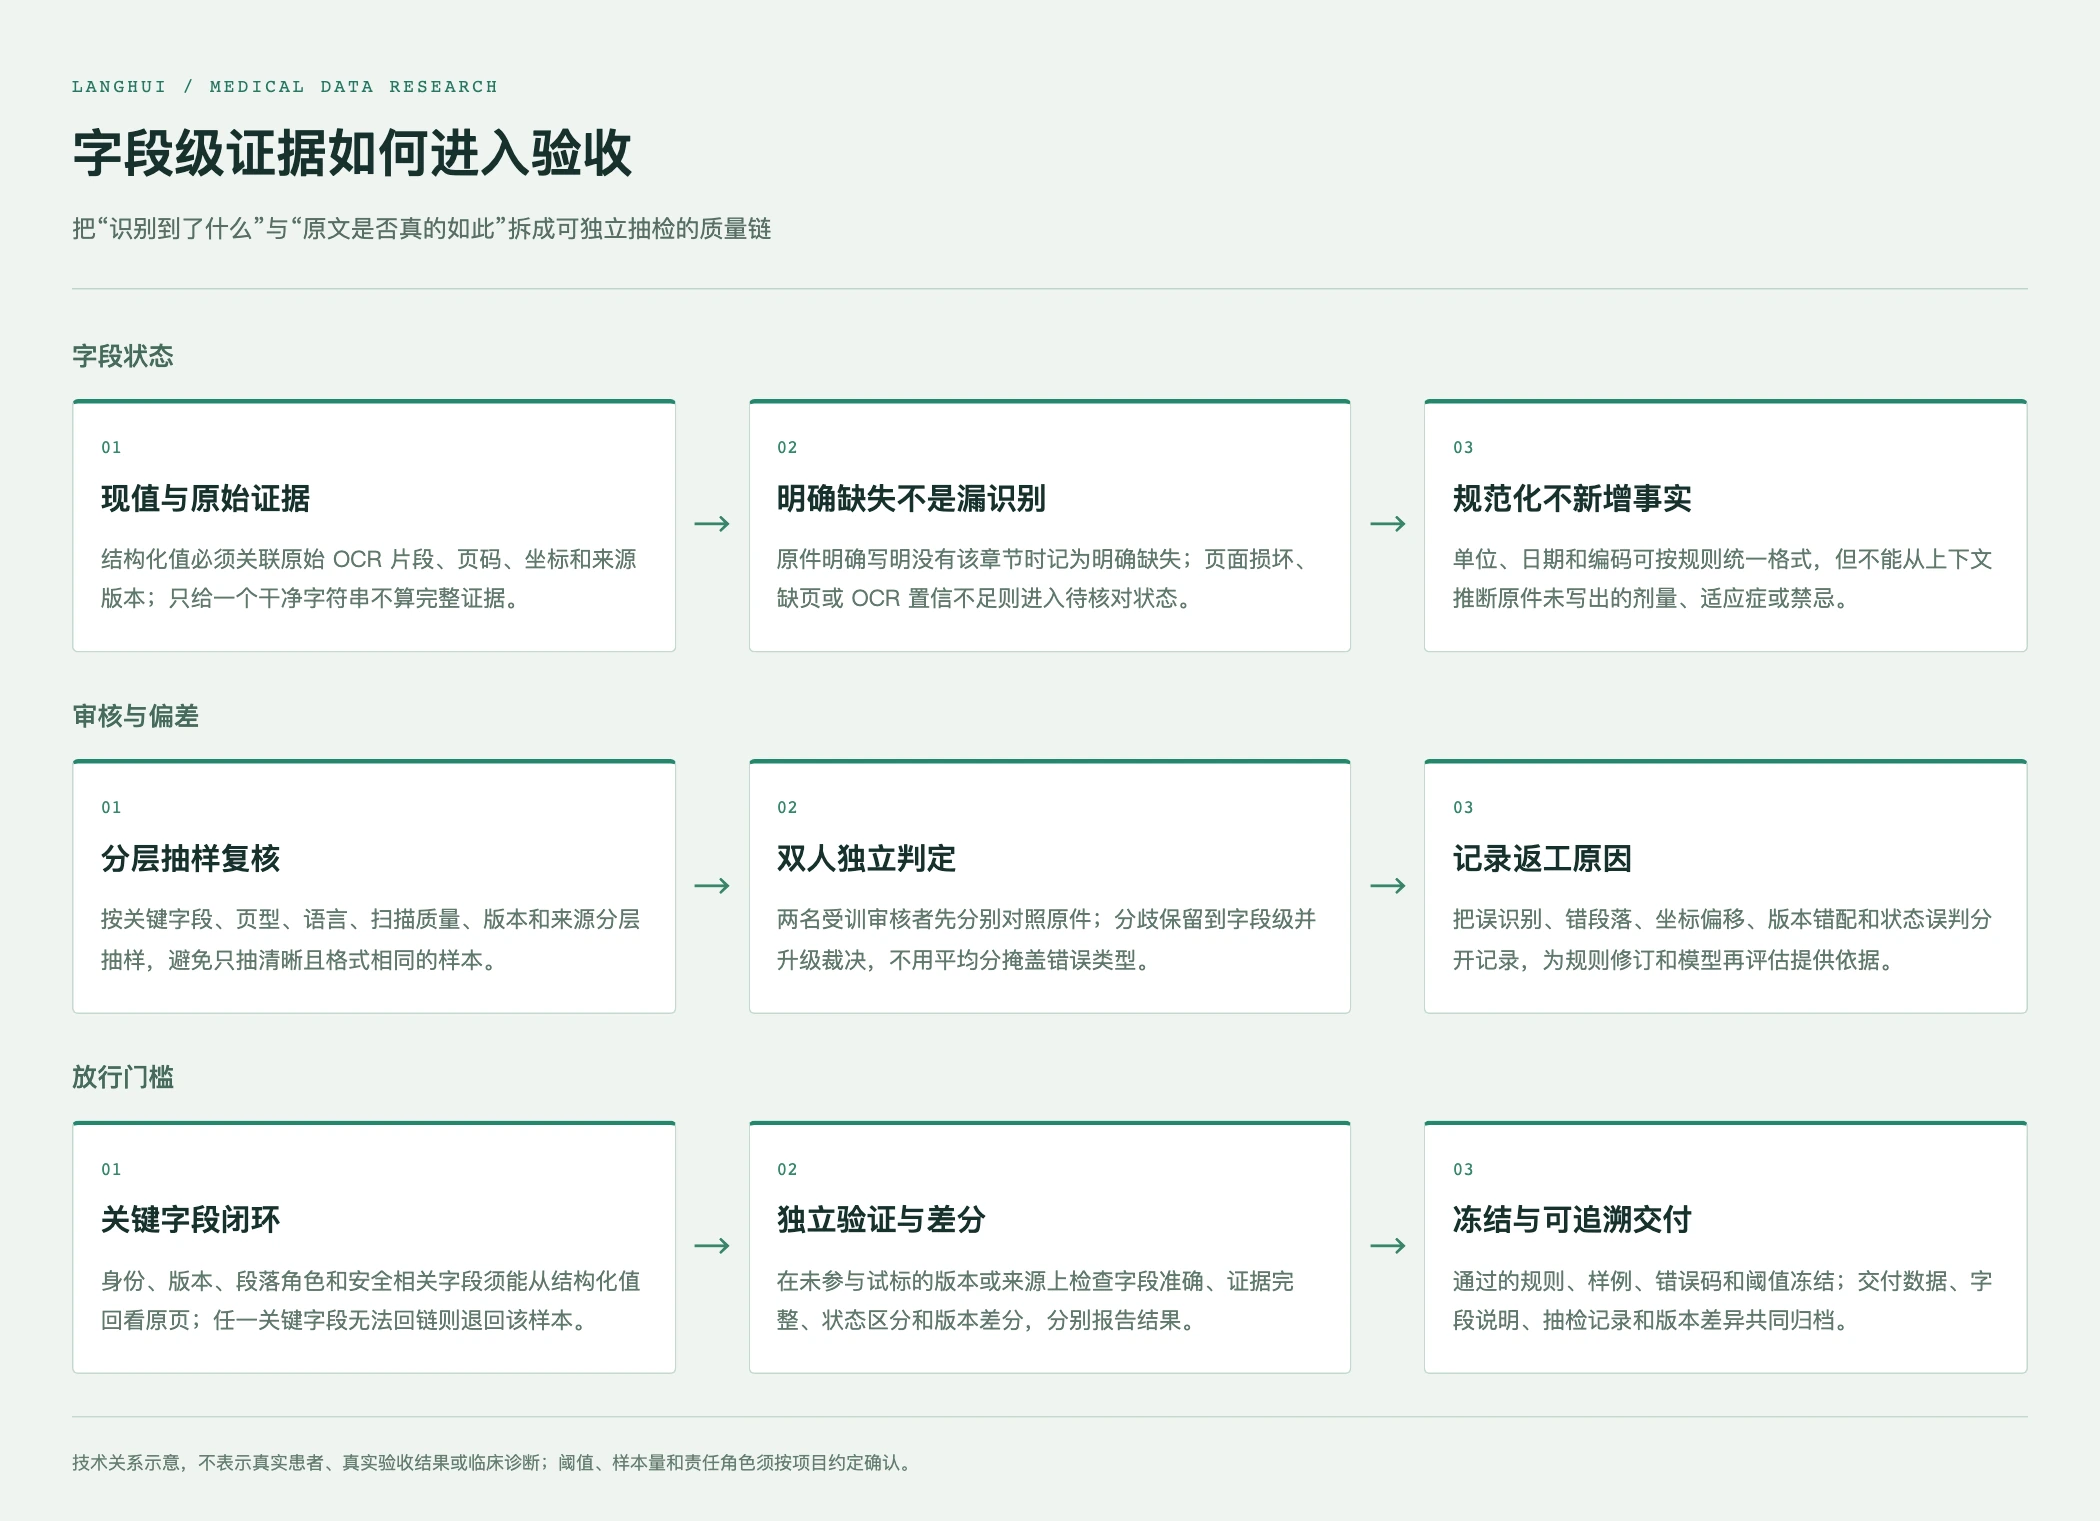
图 2:技术示意。验收围绕字段证据闭环和错误类型展开,不表示真实患者、真实验收结果或临床诊断结论。
六、从试标到交付:把业务逻辑写成可复盘的门槛
一个可实施的试标可以分三段。第一段是小规模定义验证:冻结字段表、状态枚举、来源要求、正反例和审核角色,交付少量覆盖不同页型的样例。第二段是规则和模型验证:双人盲做,记录字段级分歧,修订指南后对同一批样例回归;任何新增规则要进入版本差异表,不能靠口头通知。第三段是扩量前验收:使用未参与试标的来源或新版本,按照预先写明的抽样单位、失败阈值和停线条件复核,合格后再冻结本批生产规则。
以下条件应作为明确的退回或停线信号:关键字段没有原始证据回链;文档缺页或模糊页被标为完整;结构化值覆盖了原始 OCR,无法还原人工修改;“明确缺失”和“无法判定”未区分;同一记录拼接了不同版本;剂量或单位被模型推断却没有原文;分歧只保留最终答案而没有裁决理由;数据包没有字段字典、版本号、抽检记录和错误码。阈值的具体数值应由项目双方根据样本、风险和法规环境书面确定,而不是套用公司统一准确率。
交付包不应只有 CSV、JSON 或数据库表。至少要同时包含字段说明、枚举定义、原件或等价副本的引用关系、OCR 证据、版本差异、抽检记录、返工状态、导出说明和数据卡。对不允许交付原始影像的项目,可在授权范围内交付受控访问指针、哈希、页面索引和脱敏证据摘要,但不能把没有原件可核对的数据包装成“原版库”。如果来源许可、版本维护责任、原文定位方式和旧批次处理规则尚未确定,合理的业务动作是停留在样例评估,不是直接承诺整库交付。
七、研发价值与能力边界:让数据支持模型,而不是替模型做判断
字段级证据契约可以支撑多种研发用途。检索系统能够返回字段和原文位置,减少“只给答案不说明出处”的问题;版本差分可以辅助发现标签变化;药物警戒研究可以把标签中的安全段落与其他合规数据建立可核查关联;知识图谱或检索增强生成系统可以将回答限定在有证据的字段上;模型训练则可以按文档、页面、段落和字段分别采样,分析错误究竟来自视觉识别、布局理解还是术语规范化。上述用途仍需要各自的合法授权、任务定义和独立评估,不意味着 OCR 数据本身能够直接用于临床决策。
按照已核验的公司能力边界,朗慧科技对外定位是 AI 数据基础设施和流程服务商,LangData 覆盖采集、处理、标注、质检和数据交付;医疗栏目提供按模态、部位和任务组织的数据目录与项目沟通入口。将这类能力用于药品说明书 OCR 项目时,适合表达为:围绕项目规格设计字段、样例、复核和质量记录,并按确认范围组织交付。不能把需求文档推导为现成库存,也不能把官网自述转换成药品监管认证、临床诊断能力、固定专家规模或任何效果保证。具体来源、授权、规模、周期、阈值和返工责任,必须在项目书面文件中逐项确认。
最终,说明书 OCR 的研发价值不在于制造一个看似“懂药”的黑箱,而在于把每一次识别、规范化、缺失判断和人工修订都变成可回看、可比较、可复盘的数据事实。对医疗 AI 团队而言,这种设计同时提升训练数据的可用性和失败分析的可操作性;对数据采购方而言,它把验收从“文本读起来像不像”推进到“字段是否正确、证据是否在、版本是否对、错误是否可追责”。在这一层面,结构化不是抹平原文,而是让结构化结果始终带着原文的来路。
参考来源
- Structured Product Labeling Resources
- HL7 Version 3 Standard: Structured Product Labeling, Release 5
- Product-information requirements
- Electronic product information (ePI)
- From chaos to clarity: schema-constrained AI for auditable biomedical evidence extraction from full-text PDFs
- Image Text Extraction and Natural Language Processing of Unstructured Data from Medical Reports
- A Machine Learning-Driven Pipeline for Structured Data Extraction from Pharmaceutical Package Inserts Using OCR and Semantic Hashing
- Automating the segmentation, date extraction, and classification of multi-report PDFs in outside medical records using optical character recognition and generative artificial intelligence