
MEDICAL DATA RESEARCH
药品说明书 OCR 不只是识字:从字段契约到可回溯验收
药品说明书 OCR 不应只看识字率。本文从版本锚点、字段级证据、缺失状态机、版面与章节识别、人工复核、外部验证和版本化验收,梳理如何把 PDF 或扫描页转成可回溯的结构化医学数据,并明确研究结果与项目承诺的边界。
当一张药品说明书被扫描成 PDF,真正难的往往不是把字“读出来”,而是回答四个会影响后续使用的问题:这段文字属于哪一个章节,来自哪一页哪一个坐标,它是说明书明确写了“无”,还是 OCR 漏掉了,规范化后的字段是否仍能回到原始证据?如果商品名、规格、修订日期和不良反应被塞进一张宽表,任何一个错字都可能失去定位,任何一个空白也可能在下游被误解为“说明书没有这一项”。因此,药品说明书 OCR 的工程目标不应停在字符识别率,而应转向一份可核对、可修正、可复用的数据契约。
这类契约服务的是药品信息结构化、监管信息检索、药物警戒研究和训练数据治理,不是对患者进行诊断,也不替代药师、医生或监管部门判断。下文将一项面向药品说明书 PDF 或页面影像的 OCR 数据标准,拆成医学数据任务、输入输出、字段颗粒度、算法路径、审核分工和验收逻辑,并将其与截至 2026 年 11 月可核验的公开研究和官方结构化标签资源对照。
先界定任务:把说明书作为强版本医学文档
药品说明书不是一段脱离上下文的药品百科。它至少同时包含产品身份、批准信息、规格、适应症或功能主治、用法用量、不良反应、禁忌、注意事项、药物相互作用、特殊人群用药、药理毒理、药代动力学、贮藏和有效期等不同语义角色。相同通用名在不同剂型、企业或修订版本中,段落内容和适用边界可能不同。因而实际任务是“按版本对一份药品说明书进行证据保留的结构化转写”,而不是把所有来源文本合并成一个药品摘要。
输入模态通常是 PDF、扫描页或拍摄的页面影像,必要时还包括包装或条码影像、来源链接、文件哈希、页数和许可状态。影像质量本身属于任务的一部分:缺页、模糊、倾斜、折痕、双栏错序、中文与英文混排、小字号和表格线都可能改变 OCR 候选。输入还必须携带版本锚点,例如修订日期、批准信息或来源文档标识;没有版本的文本不能安全地参与跨批次合并。
输出应拆成两个互相对齐的层。第一层是便于检索、比对和下游应用的业务结果,例如药品名称与别名、批准文号、剂型、规格数值与单位、有效期、适应症、用法用量、禁忌、不良反应、特殊人群用药和企业对象。第二层是 OCR 证据与质量治理信息,包括原始识别字符串、规范化字符串、页码、原图坐标、模型置信度、规则校验、人工复核状态和修订理由。业务字段不是证据的替代物,证据字段也不能被宽表中的备注列吞掉。
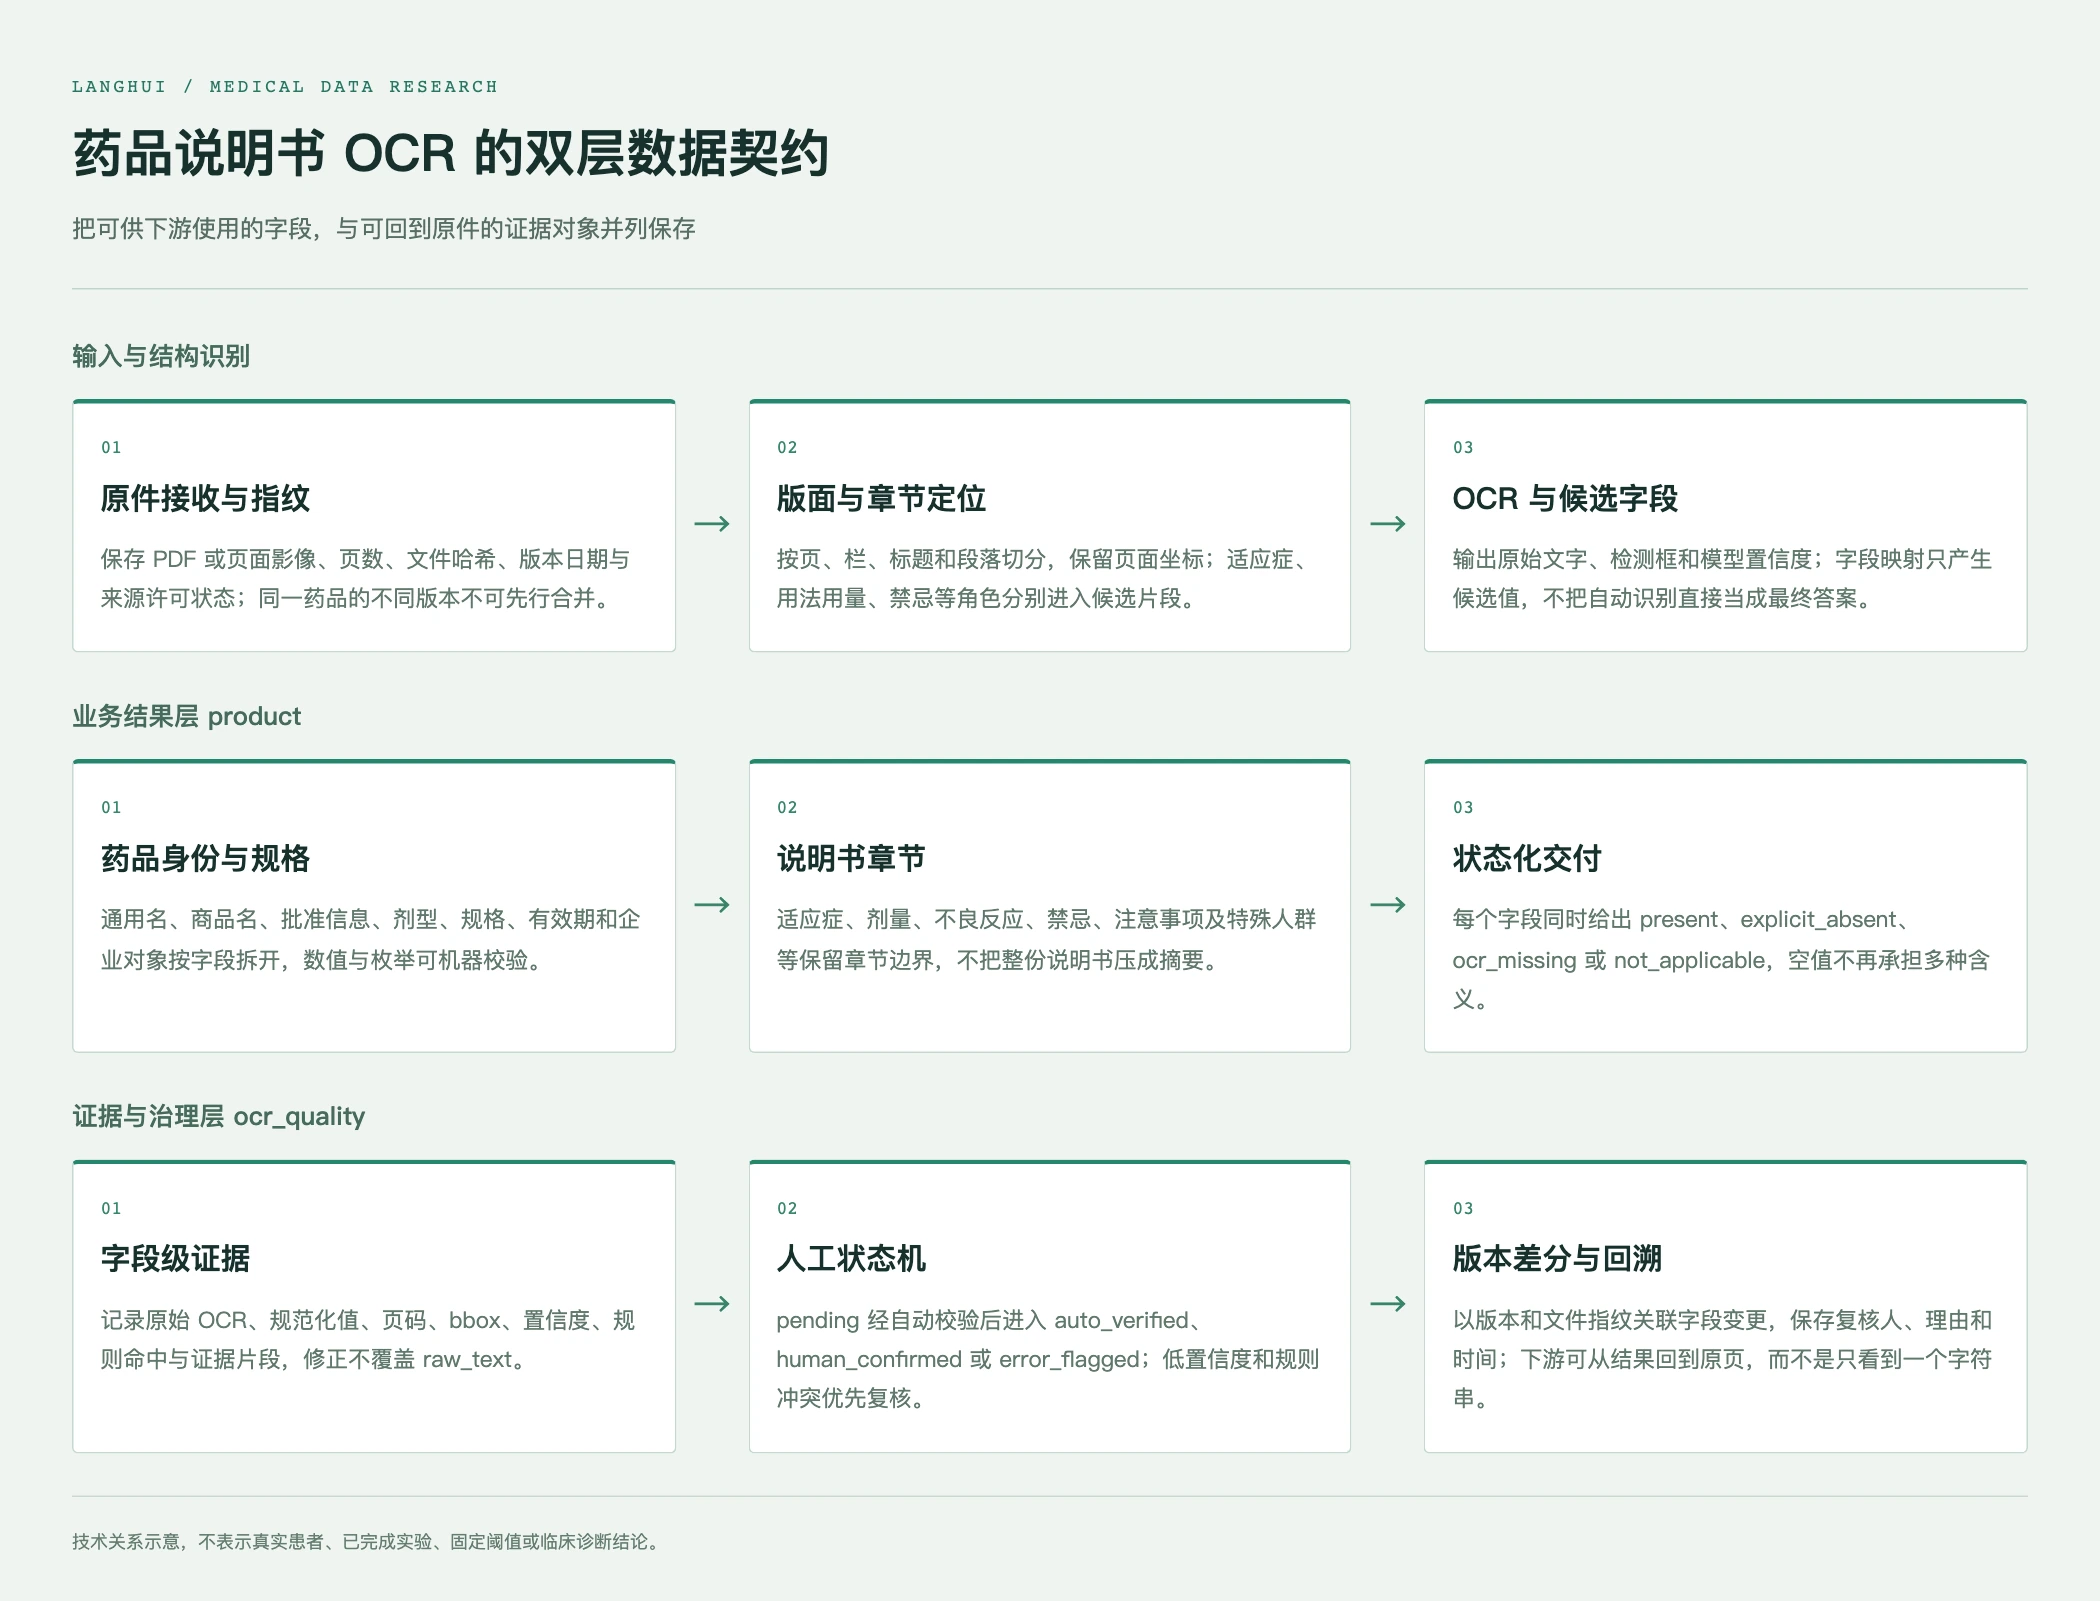
图 1|技术示意。 业务层便于使用,证据层负责回溯;图中关系不表示真实患者、已完成实验或临床诊断结论。
为什么“空白”必须有语义
说明书结构化最容易被忽略的设计,是对字段存在性单独建模。一个空字符串至少可能代表四种完全不同的事实:说明书明确写明“尚不明确”或“无”;这个章节确实存在但 OCR 没有抓到;该药品类别不适用这个章节;或者原件本身缺页、模糊、尚未人工补录。如果它们都落成空值,下游系统便无法知道应当停止使用、回看原页还是接受“没有该章节”的结论。
更稳健的做法是给每个字段配置状态机。present 表示章节存在且已识别,explicit_absent 表示原文明确表达不存在或无相关信息,ocr_missing 表示原件有该内容但 OCR 未抓到,not_applicable 表示依据适用范围该字段不适用。实际项目还可以加上 source_unreadable 或 pending_review,但必须在契约中明确它们与四种核心状态的关系,禁止用自由文本备注代替枚举。
状态化设计直接影响训练和验收。模型的“未预测到”不应被自动转换成真实世界的“没有”;人工复核也不应只改最终值而丢掉原始识别。对于 ocr_missing,系统应能生成待补录任务,并记录页面、原因和关闭时间;对于 explicit_absent,应保留支撑该判断的原文片段;对于 not_applicable,需要记录采用的分类或适用规则。这样,数据质量问题才会从不可见的空格变成可统计、可返工的对象。
字段颗粒度:从整页文本降到字段与证据片段
字段设计需要同时满足人能读、机器能校验和审核能回到原件。药品身份不宜只保留一条长字符串,而应拆开通用名、商品名、英文名、拼音名、批准信息、剂型、处方类型和药品类别。规格也不应只有“10 mg”这样的文本值,还可以拆出数值、单位、含量计和原文表达。有效期则可保留原文,并在允许时生成机器可比较的月数或日期字段。上市许可持有人、生产企业和受托生产企业需要分对象记录,避免把名称、地址、电话混成一个无法检索的段落。
章节字段要保持角色边界。适应症不能与用法用量合并为摘要,禁忌与注意事项不能因为关键词相近而互换,不良反应也不能在归一化时被改写成“常见风险列表”。对于孕妇及哺乳期、儿童、老年患者、药物过量、药理毒理和药代动力学等容易被旧表遗漏的章节,契约应显式保留字段和存在状态,而不是继续把“请补齐”写进备注。
证据对象至少应回答五个问题:模型当时读到了什么,最终采用了什么,来自哪一页哪一个框,是否经过规则或人确认,出现分歧时由谁以什么理由裁决。raw_text 应一次落库且不可被后续修正覆盖;normalized_text 负责保存规范化或人工修订后的值;source_page 和 source_bbox 使审核者能打开原图;ocr_confidence 是模型信号而不是最终正确性;review_status 则记录从待处理到自动通过、人工确认或错误标记的状态。W3C 对数据溯源的概括强调,溯源要描述产生数据的实体、活动和参与者,以支持质量、可靠性和可信度判断;这一思想适合转译到字段级对象,而不应只停留在文件夹名称上。7
算法路线:规则、版面模型与人审的组合
第一步是建立原件接收和影像质检层。系统先登记文件指纹、页数、版本标识和来源许可,再检查缺页、方向、分辨率、模糊、遮挡、双栏结构和语言混排。不能读取的页面先进入问题清单,而不能以空结果直接生成 explicit_absent。对于有明显版式变化的说明书,版面检测应识别标题、栏、段落、表格和页眉页脚,避免按整页纯文本切分导致章节跨栏或表格行错位。
第二步是 OCR 与结构识别。通用 OCR 可以提供文本和候选框,但药品说明书的关键难点在字段边界和语义角色。近年的药品标签 OCR 研究将图像预处理、双引擎识别、字段分区和结构化存储组合起来,并以字符准确率、字段级 F1 和编辑距离观察不同误差面;该研究还明确指出混合语言、小字号、拍摄角度和不规则排版会造成字段丢失或错配。5 这支持“识别与字段映射分层”的工程选择,但其数据集和实验设置不能直接代表某一项目的说明书质量,更不能被换算成临床效果或交付承诺。
第三步是章节切分与字段映射。规则适合处理批准文号、条码位数、日期格式、单位和受控枚举等高确定性结构;版面与语言模型适合处理标题变化、跨行段落和同一章节中的语义边界;领域模型可在规则无法覆盖时生成候选,但候选必须带置信度和证据。早期结构化产品标签研究已显示,SPL 能把说明书分成章节,但章节内部仍可能是自由叙述,需要继续做段落或短片段级 NLP;该研究通过把片段拆小、过滤否定和语义类型来抽取适应症,说明“有 XML 或有标题”并不等于“已经有可直接计算的字段”。4
第四步是规范化与外部比对。原文值与规范化值要并存,系统才有机会发现模型把相似字、单位、日期或数字读错。可对批准文号、条码校验位、日期合法性和规格数值做格式检查,也可在允许且版本匹配时,与适用的官方药品信息源逐字段核对。FDA 的 SPL 资源页将 SPL 描述为经 HL7 批准、被 FDA 采用的产品和机构信息交换标准,并列出实施指南、模式、样式表和验证术语;这说明结构化标签应当具有明确的字段和验证边界,而不是凭经验建立一张不可演进的宽表。1
但外部来源本身也需要被当作证据而不是绝对真值。FDA 的 FDALabel 说明,其数据来自 SPL 归档并持续更新,可按章节、标识符和日期查询,但 SPL 内容不一定与最新批准标签完全一致,部分数据元素也未由 FDA 逐项核验。2 因而跨源比对的输出应分成“相符”“源版本不同”“字段表达不同”“待人工核对”几类,不能只给一个绿色或红色结论。对于中文业务,采用何种监管数据库、如何处理版本时点和授权边界,应在项目书面范围中明确。
第五步是人工复核和可解释修正。低置信度字段、规则冲突字段、重要章节漏抓和规范化前后不一致的字段优先进入队列。研究工作流可以使用领域预训练模型辅助段落分类或命名实体识别,但不应把模型置信度当成医学事实。RxBERT 研究以美国人用处方药标签语料进行领域预训练,并在标签章节分类和命名实体识别等任务上评估;这说明领域语料能帮助模型贴近特定标签语言,同时也提醒我们,模型效果依赖具体任务、标注集、语言和标签范围,不自动迁移到中文扫描件或所有药品章节。6
标注主体与争议处理:谁能改哪个字段
标注主体应按风险和工作内容分层,而不是笼统写“专家审核”。基础标注员可以负责页面框、文字转写、章节候选和低风险格式字段;具备药学或医学背景的审核者应复核适应症、禁忌、不良反应、特殊人群、剂量和药理相关章节;对版本差异、规范化争议和跨来源不一致,需要由规则负责人或项目指定的高级审核者裁决。这里的角色安排是建议性设计,不等同于任何现有团队的人员证明。
审核应尽量双人独立,先盲审再看对方意见;分歧不通过平均分抹平。每个争议需要有原件片段、双方判断、采用理由和最终状态。常见争议至少包括:章节标题被识别成正文,页眉页脚被并入药品名称,换行造成单位与数值分离,否定词被漏读,企业名称被误拆,ocr_missing 被误标为 explicit_absent,以及不同版本的段落被错误拼接。把错误编码到这些类别,回修时才能判断应该改预处理、版面模型、字段规则还是审核指南。
双人复核也不能只做随机抽样。抽样需要按版式、影像质量、语言混排、药品类别、版本时间、高风险章节和模型置信度分层;一个很清晰的主流版式占多数时,随机样本可能掩盖小字号、旧版本或稀有章节的系统性失败。源方案提出可把低于 0.85 的置信度作为人工队列起点、将缺失字段在 48 小时内补录、每批抽取 5% 由第二人交叉复核,但这些都是待在样例集上校准的项目候选,不是跨项目统一标准,更不能在没有误差预算和人力评估时直接写成保证。
质量与外部验证:不要让覆盖率掩盖错配
验收至少要有五个层面。第一是影像与文档完整性,包括页数、文件指纹、版本标识和不可读页面。第二是文字层质量,包括字符或文本编辑差异、数字与单位错误。第三是字段层质量,包括字段是否完整匹配、规范化值是否正确、章节角色是否归类正确。第四是状态层质量,重点检查明确缺失、OCR 漏抓和不适用是否被正确区分。第五是证据层质量,包括页码、坐标、原始文本、复核状态和版本关联是否完整。任何一层不合格,都不宜用另一层的平均分掩盖。
独立验证必须防止版本泄漏。来自同一份说明书的不同导出、相邻修订版、近似页面或同一模板的重复影像,不能不加区分地同时进入训练和测试。更有意义的切分方式是按来源、版式、时间或产品版本留出未见组合,并单独报告对旧版、模糊版、双语版和少见章节的表现。对于生成式或大模型组件,还应检查是否复制了训练语料中的原文片段,防止看似正确的输出其实是文档记忆或数据泄漏。
指标也要与业务目的对应。字符准确率能够观察 OCR 基础错误,但无法判断一整条不良反应是否漏掉;字段级精确率、召回率和 F1 能观察提取,却仍可能把“无此章节”当成成功空值;证据可回溯率反映审核能否回到原页;状态混淆矩阵则能揭示漏抓与明确缺失的互换。2026 年一项以 FDA 结构化产品标签为对象的适应症抽取比较研究,选取 20 种常用药物,并以 1,838 条人工整理的适应症陈述作参考标准,发现不同药物和适应症范围之间表现差异明显,字典匹配还会产生较多假阳性。3 这类结果只说明该英文标签任务的异质性,不应为另一个中文扫描数据集预先承诺某个准确率。
业务验收应将失败样例、规则版本、模型版本、审核记录和版本差分一起交付。源方案中的“低置信度入队”“第二人抽检”“缺失补录”和“影响范围重验”可以作为流程骨架,但正式通过阈值、抽样比例、返工时限和是否停线,必须由数据范围、风险等级和书面规格共同决定。改动字段定义后,不应只重跑新样本;需要根据差分表识别受影响的在制与已验收批次,再决定复核或重做范围。
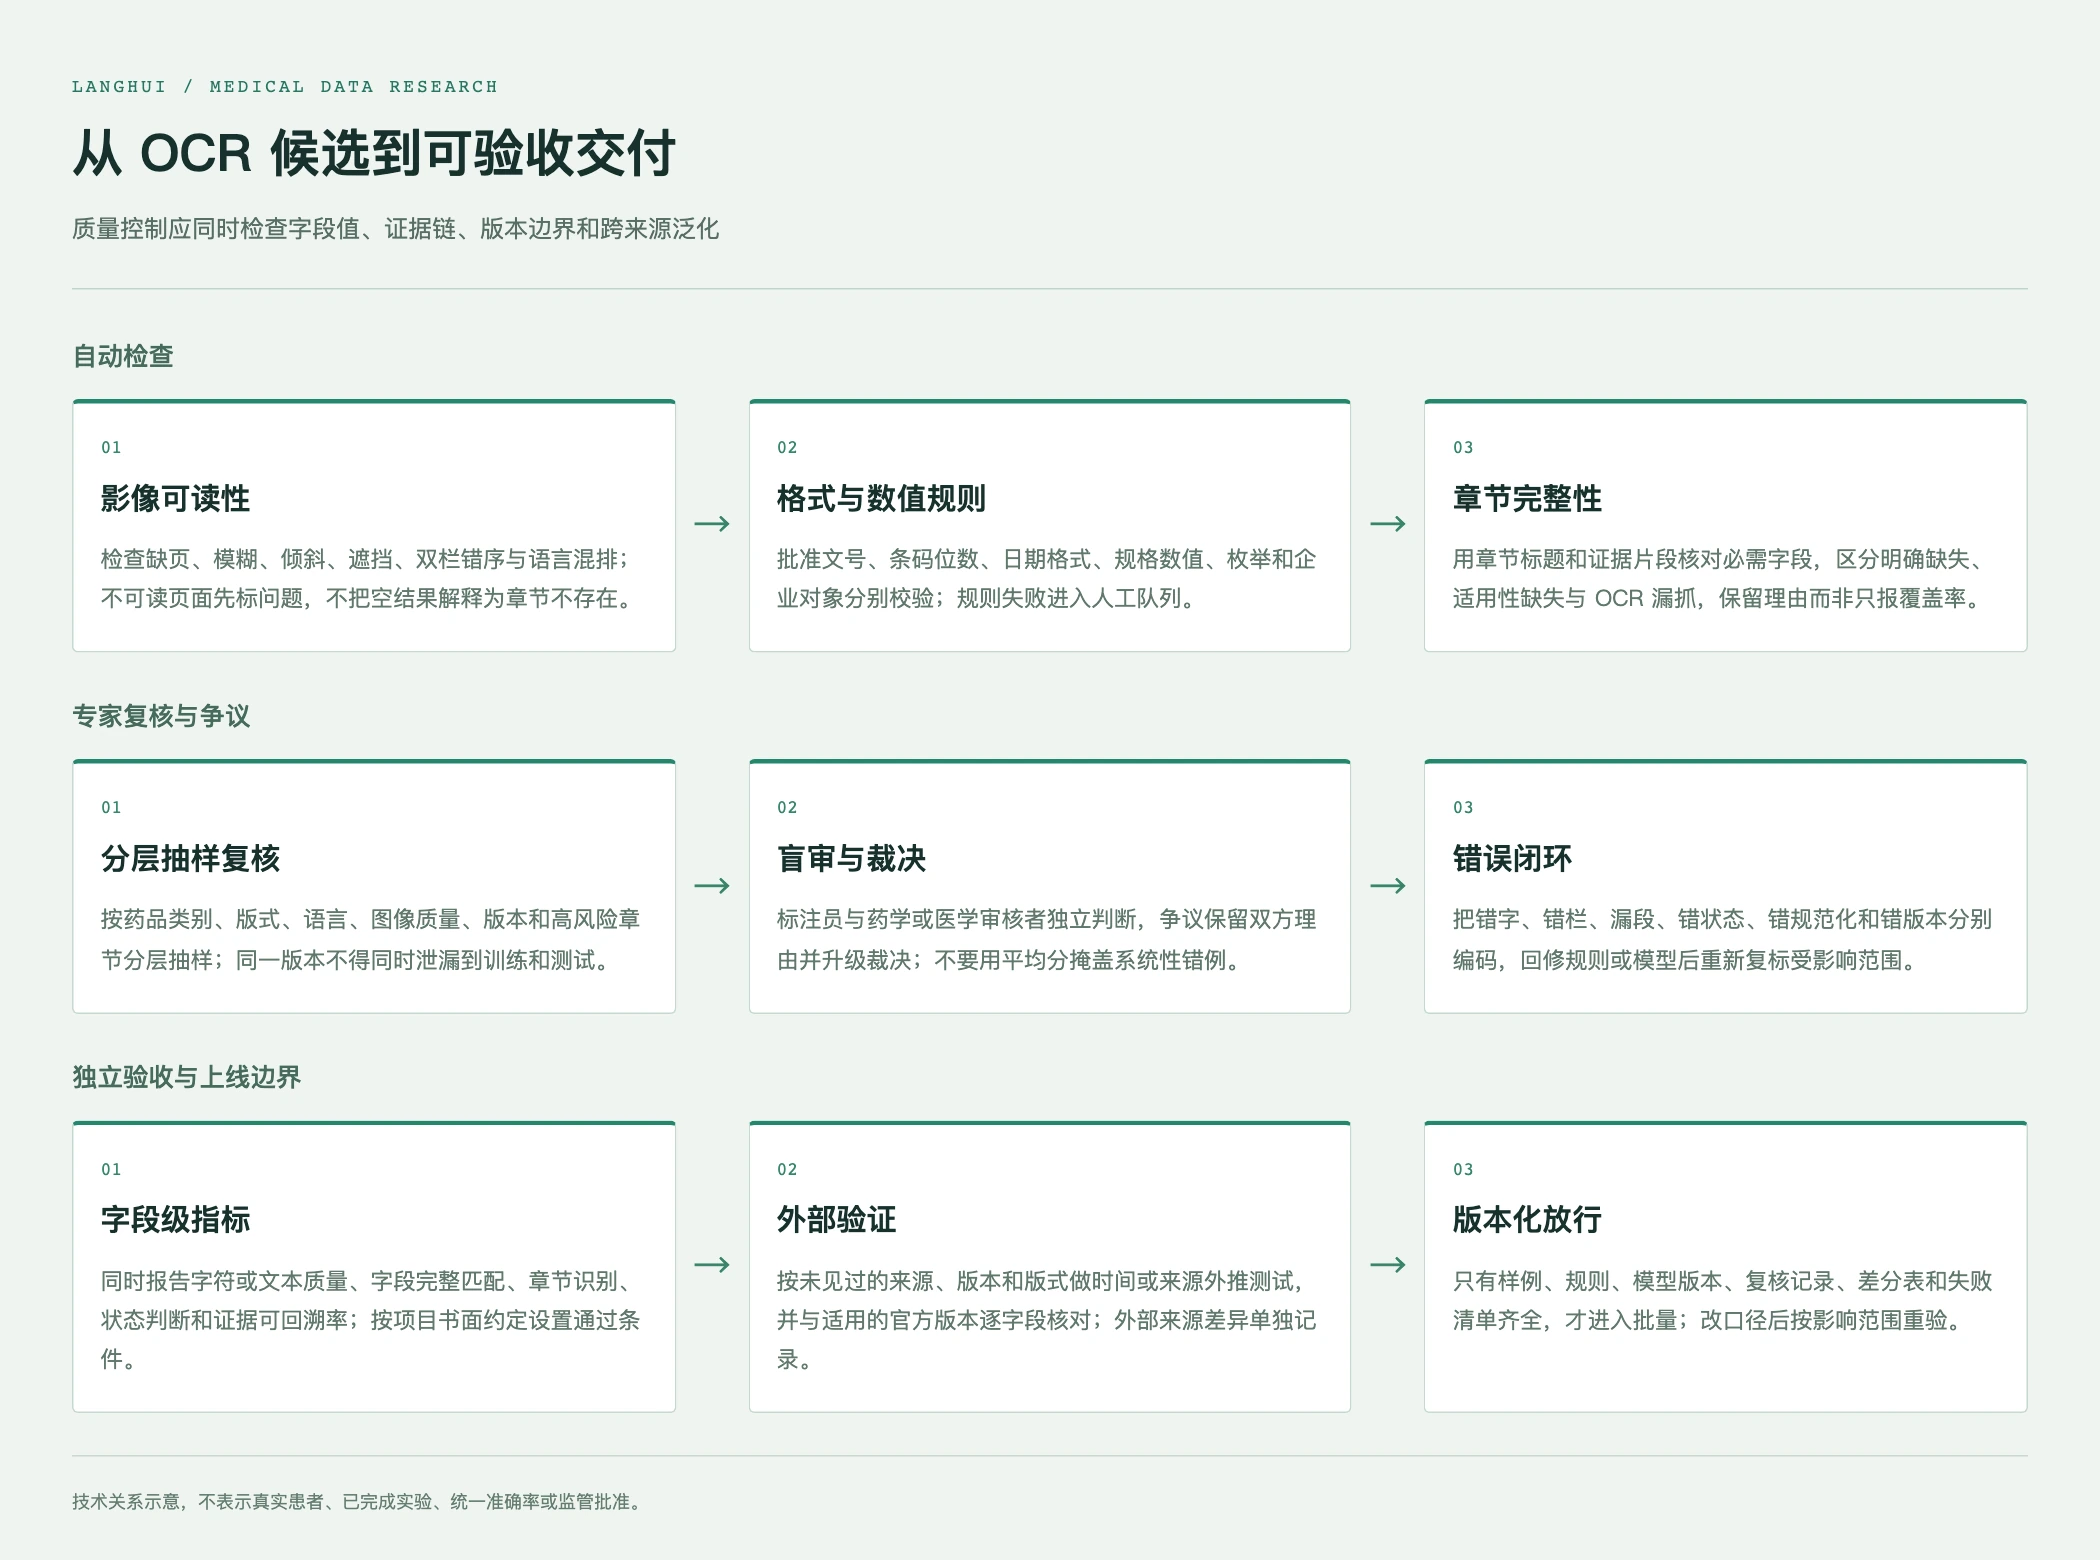
图 2|技术示意。 质量控制同时检查字段、证据、版本和外推边界,不表示真实患者、已完成实验、统一准确率或监管批准。
研究和业务逻辑:把结构化结果放在正确位置
一份具有字段证据和版本边界的说明书数据,可以支撑药品信息检索、章节级问答的证据定位、药物警戒语料建设、药品知识库同步、监管文本差异分析和 OCR 模型的错误诊断。它的价值不在于把说明书改写成更“好懂”的宣传摘要,而在于让下游系统知道每一个值的来源、状态、适用版本和人工确认情况。对需要训练或评估模型的团队,字段级质量记录还可以把“模型错了”进一步拆成版面错、字符错、章节错、状态错或版本错。
这类数据不能直接承担用药建议。适应症、禁忌和剂量字段的结构化,只说明某版本文档中记录了什么,不等于对个体患者是否适用作出判断;当官方版本、来源标签和本地转写不一致时,系统应提示核对,而不是自动选择一个看似最新的值。对外输出还需排除未授权原件、患者信息、内部项目名和不可公开的运营记录,保留匿名的技术要求与质量方法即可。
在公司能力适配上,更稳妥的表达是:具备 AI 数据基础设施和流程服务定位的平台,可以在项目规格明确后承接采集、处理、标注、质检和数据交付的流程设计;是否有某种语言、版式、药品范围或专家配置的现货能力,必须通过样例评估和书面确认,不能从需求说明或网站自述推导。先冻结字段和反例,再以小规模样例验证 OCR、版面识别、人工复核和导出格式,最后才讨论批量化,是比直接承诺“高准确率”更可复盘的业务路径。
结语:把“识别文本”升级为“可审计数据”
药品说明书 OCR 的核心难题,不是再换一个模型就能自动消失。模型可以改善字符和语义识别,但只有契约把业务值、原始值、页码坐标、缺失状态、审核责任和版本差分连起来,错误才有机会被定位、修正和验证。把 present 与 ocr_missing 分开,把原始 OCR 与规范化值分开,把字段指标与证据完整性分开,等于把人工兜底变成可观察的数据治理。
因此,一份可生产的药品说明书数据标准应当同时回答:输入是哪一版原件,输出拆到什么字段,哪些值可以自动校验,哪些章节必须由药学或医学审核者复核,失败达到什么条件要停线,如何证明模型没有从同版本泄漏,改规则后哪些批次需要重验。做到这些,结构化数据才不仅能被机器消费,也能在数月后被另一位审核者独立复盘。
参考来源
- Structured Product Labeling Resources
- FDALabel: Full-Text Search of Drug Product Labeling
- Evaluating NLP Approaches to Extract Drug Indications
- Extracting drug indication information from structured product labels using natural language processing
- A dual-engine fusion optical character recognition method for fast identification and key information extraction of drug labels
- RxBERT: Enhancing drug labeling text mining and analysis with AI
- PROV-Overview: An Overview of the PROV Family of Documents